
【论文阅读|CVPR|DeblurGAN: Blind Motion Deblurring Using Conditional Adversarial Networks】

题目:DeblurGAN
目录
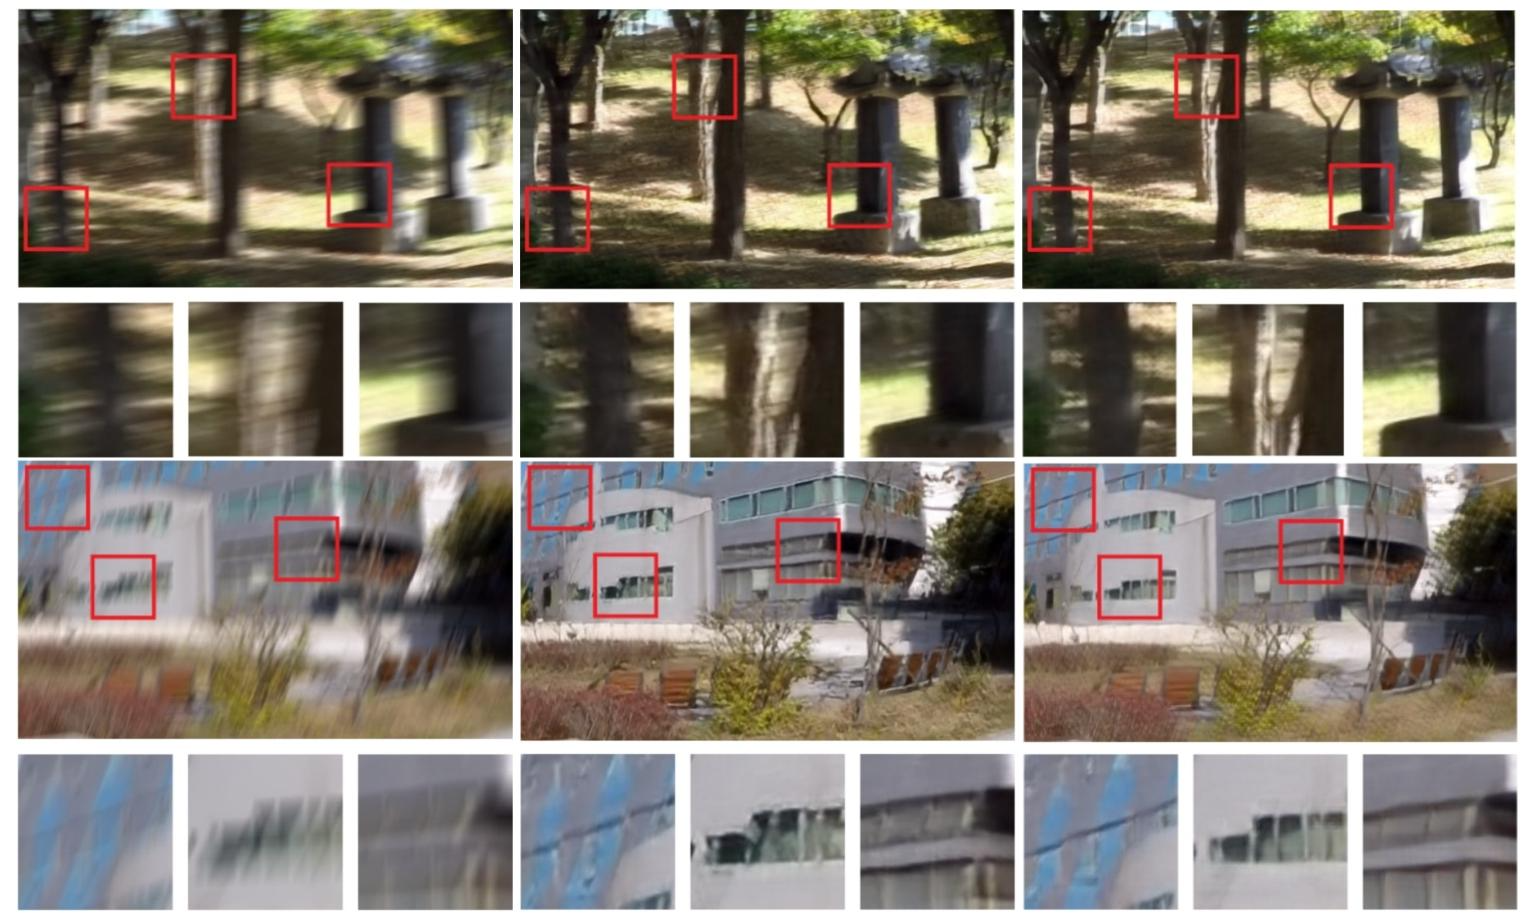
图像去模糊的通用模型
I B = k ( M ) ∗ I S + N I_B = k(M) \ast I_S + N IB=k(M)∗IS+N
-
含义:
- I B I_B IB:模糊图像(Blurred Image)。
- I S I_S IS:清晰的潜在图像(Latent Sharp Image)。
- k ( M ) k(M) k(M):模糊核(Blur Kernel),它依赖于运动场 M M M。
- ∗ \ast ∗:卷积运算符,表示模糊过程为卷积。
- N N N:加性噪声(Additive Noise)。
-
解释:
- 图像去模糊的基本模型是 模糊图像 = 清晰图像和运动模糊核的卷积 + 噪声。
- 当 k ( M ) k(M) k(M) 未知时,需要同时估计 I S I_S IS 和 k ( M ) k(M) k(M),这是 盲去模糊(blind deblurring) 问题。
GAN 目标函数
(a) 标准 GAN 目标函数
min G max D ( E x ∼ P r [ log D ( x ) ] + E x ~ ∼ P g [ log ( 1 − D ( x ~ ) ) ] ) \min_G \max_D \Big( \mathbb{E}_{x \sim P_r}[\log D(x)] + \mathbb{E}_{\tilde{x} \sim P_g}[\log(1 - D(\tilde{x}))] \Big) GminDmax(Ex∼Pr[logD(x)]+Ex~∼Pg[log(1−D(x~))])
-
符号说明:
- G G G:生成器,接受随机噪声 z z z 并生成假样本 x ~ = G ( z ) \tilde{x} = G(z) x~=G(z)。
- D D D:判别器,判别样本是真实的 x ∼ P r x \sim P_r x∼Pr 还是生成的 x ~ ∼ P g \tilde{x} \sim P_g x~∼Pg。
- P r P_r Pr:真实数据分布。
- P g P_g Pg:生成数据分布。
- x ~ = G ( z ) \tilde{x} = G(z) x~=G(z),其中 z ∼ P ( z ) z \sim P(z) z∼P(z)。
-
解释:
- 判别器最大化:尽可能区分真实样本和生成样本。
- 生成器最小化:生成看起来尽可能真实的样本,骗过判别器。
- 本质上是在最小化 Jensen-Shannon 散度,表示 P r P_r Pr 和 P g P_g Pg 之间的相似度。
(b) Wasserstein GAN (WGAN)
为克服标准 GAN 的训练不稳定问题(JS 散度导致梯度消失),Arjovsky 等引入 Wasserstein-1 距离:
min G max D ∈ D ( E x ∼ P r [ D ( x ) ] − E x ~ ∼ P g [ D ( x ~ ) ] ) \min_G \max_{D \in \mathcal{D}} \Big( \mathbb{E}_{x \sim P_r}[D(x)] - \mathbb{E}_{\tilde{x} \sim P_g}[D(\tilde{x})] \Big) GminD∈Dmax(Ex∼Pr[D(x)]−Ex~∼Pg[D(x~)])
-
符号说明:
- D \mathcal{D} D:所有 1-Lipschitz 函数的集合(保证平滑性)。
-
解释:
- 这里,判别器(称为“critic”)输出的值直接用于估计 Wasserstein 距离(又称 Earth Mover 距离):
W ( P r , P g ) = inf γ ∈ Π ( P r , P g ) E ( x , y ) ∼ γ [ ∥ x − y ∥ ] W(P_r, P_g) = \inf_{\gamma \in \Pi(P_r, P_g)} \mathbb{E}_{(x,y) \sim \gamma} [ \| x - y \| ] W(Pr,Pg)=γ∈Π(Pr,Pg)infE(x,y)∼γ[∥x−y∥] - Wasserstein 距离具有更好的梯度性质,不易出现梯度消失。
- 这里,判别器(称为“critic”)输出的值直接用于估计 Wasserstein 距离(又称 Earth Mover 距离):
© WGAN-GP 梯度惩罚
为解决 WGAN 中“权重裁剪(weight clipping)”过于简单导致的性能问题,Gulrajani 等提出了梯度惩罚(GP):
λ E x ^ ∼ P x ^ ( ∥ ∇ x ^ D ( x ^ ) ∥ 2 − 1 ) 2 \lambda \, \mathbb{E}_{\hat{x} \sim P_{\hat{x}}} \Big( \| \nabla_{\hat{x}} D(\hat{x}) \|_2 - 1 \Big)^2 λEx^∼Px^(∥∇x^D(x^)∥2−1)2
- 含义:
-
x
^
\hat{x}
x^ 是真实样本和生成样本之间的随机插值:
x ^ = ϵ x + ( 1 − ϵ ) x ~ , ϵ ∼ Uniform ( 0 , 1 ) \hat{x} = \epsilon x + (1-\epsilon)\tilde{x}, \quad \epsilon \sim \text{Uniform}(0,1) x^=ϵx+(1−ϵ)x~,ϵ∼Uniform(0,1) - 这项惩罚保证判别器的梯度范数接近 1,满足 1-Lipschitz 条件。
- λ \lambda λ 为权重系数。
-
x
^
\hat{x}
x^ 是真实样本和生成样本之间的随机插值:
条件 GAN (cGAN)
-
定义:
- cGAN 不是从随机噪声生成样本,而是 条件生成:
G : ( x , z ) → y G: (x, z) \rightarrow y G:(x,z)→y - 输入:条件输入 x x x + 随机噪声 z z z。
- 输出:条件生成的样本 y y y。
- cGAN 不是从随机噪声生成样本,而是 条件生成:
-
目标函数(与 GAN 类似,但条件输入参与):
- 判别器也接收条件输入,判别 ( x , y ) (x, y) (x,y) 是否匹配。
在图像去模糊中的意义
这对于图像去模糊尤为关键,因为它允许使用轻量神经网络架构,而不需要之前去模糊中常用的深度 ResNet。
意味着:
通过 WGAN-GP 的梯度惩罚,去模糊网络可以训练更稳定,兼容更多小型网络架构,如 DeblurGAN 使用了 pix2pix 类似的条件 GAN 框架。
盲去模糊(
k
(
M
)
k(M)
k(M) 未知)问题里,条件 GAN 有助于直接从模糊图像到清晰图像的 端到端映射,跳过显式的核估计步骤。
结论
- 图像去模糊问题 = 退卷积问题,盲去模糊是困难的逆问题。
- GAN 框架引入对抗式训练,解决非凸优化问题。
- Wasserstein 距离改善 GAN 的数值稳定性。
- 条件 GAN(cGAN)为图像翻译类任务(如 DeblurGAN)提供了理论基础和数学保证。
提出的方法
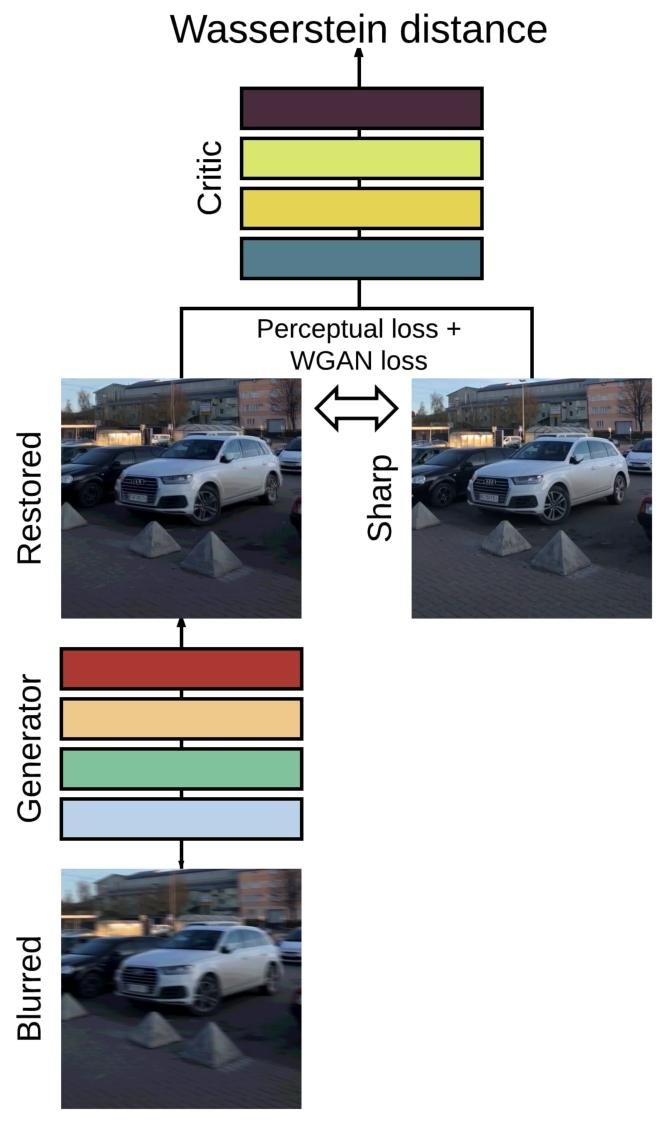
目标:给定模糊图像
I
B
I_B
IB,在没有任何模糊核信息的情况下,恢复清晰图像
I
S
I_S
IS。
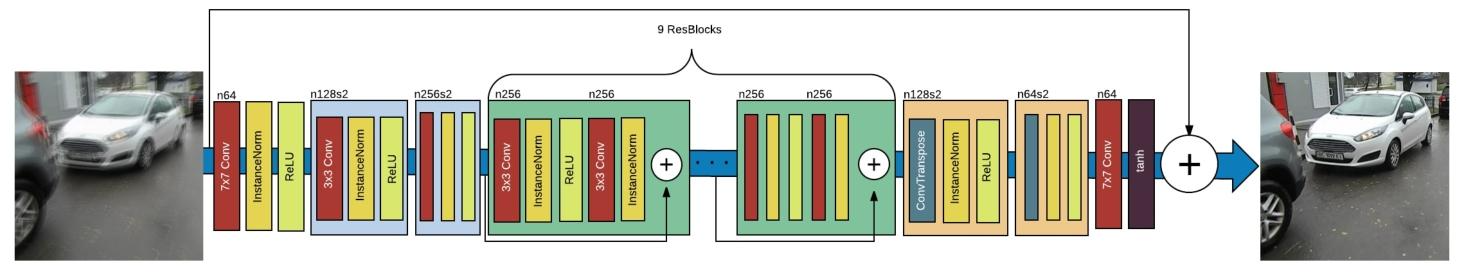
生成器网络
G
θ
G
G_{\theta_G}
GθG(称为 Generator)负责去模糊,每个
I
B
I_B
IB 生成一个对应的
I
S
I_S
IS。
在训练阶段,引入判别器网络
D
θ
D
D_{\theta_D}
DθD(称为 Critic),二者进行 对抗性训练。
损失函数
总损失公式:
L = L GAN ⏟ 对抗损失 + λ ⋅ L X ⏟ 内容损失 \mathcal{L} = \underbrace{\mathcal{L}_{\text{GAN}}}_{\text{对抗损失}} + \lambda \cdot \underbrace{\mathcal{L}_X}_{\text{内容损失}} L=对抗损失 LGAN+λ⋅内容损失 LX
其中, λ = 100 \lambda=100 λ=100。
对抗性损失
- 常用 Vanilla GAN 目标
- 也有 Least Squares GAN (LSGAN),更稳定、生成质量更高
- 本文使用 WGAN-GP [11],已在多种生成器架构上证明鲁棒性
对抗损失公式:
L GAN = ∑ n = 1 N − D θ D ( G θ G ( I B ( n ) ) ) \mathcal{L}_{\text{GAN}} = \sum_{n=1}^N -D_{\theta_D} \left( G_{\theta_G} (I_B^{(n)}) \right) LGAN=n=1∑N−DθD(GθG(IB(n)))
内容损失(感知损失)
常见内容损失:
L1(MAE,平均绝对误差)
L2(MSE,均方误差)
但单独使用像素损失容易产生模糊伪影
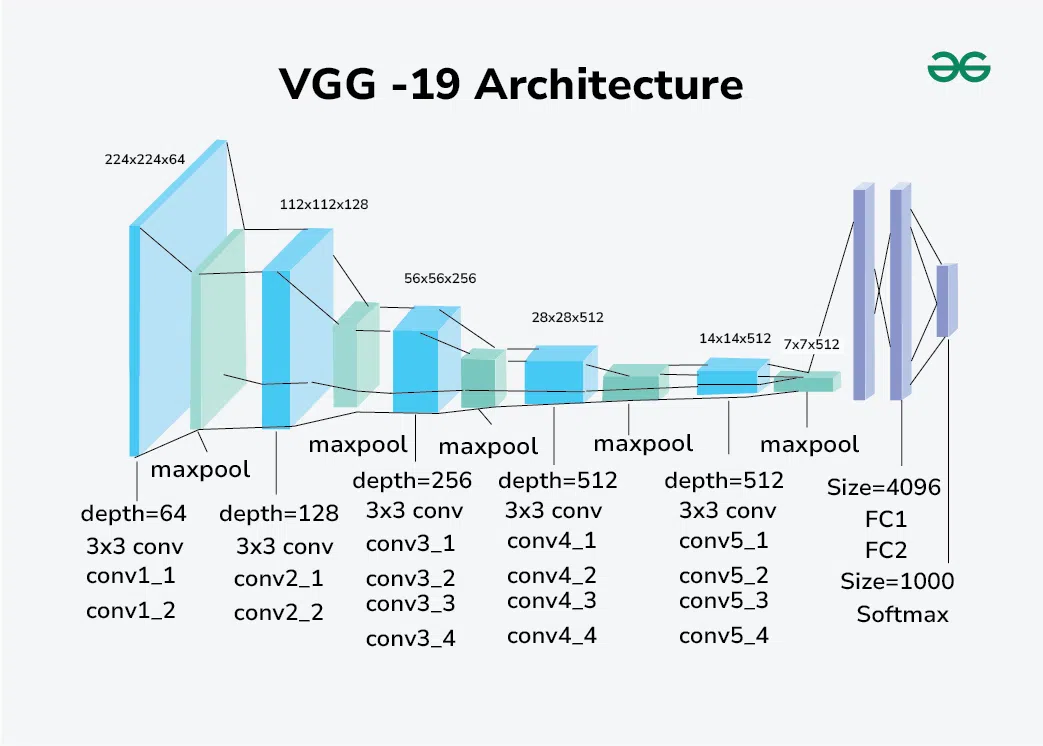
因此,采用 感知损失 (Perceptual Loss) ,基于 CNN 特征图差异而非像素差异。
感知损失公式:
m a t h c a l L X = 1 W i , j H i , j ∑ x = 1 W i , j ∑ y = 1 H i , j ( ϕ i , j ( I S ) x , y − ϕ i , j ( G θ G ( I B ) ) x , y ) 2 mathcal{L}_X = \frac{1}{W_{i,j} H_{i,j}} \sum_{x=1}^{W_{i,j}} \sum_{y=1}^{H_{i,j}} \left( \phi_{i,j} (I_S)_{x,y} - \phi_{i,j} \left( G_{\theta_G}(I_B) \right)_{x,y} \right)^2 mathcalLX=Wi,jHi,j1x=1∑Wi,jy=1∑Hi,j(ϕi,j(IS)x,y−ϕi,j(GθG(IB))x,y)2
- W i , j , H i , j W_{i,j}, H_{i,j} Wi,j,Hi,j:特征图尺寸
- 本文使用 VGG19 的 conv3.3 层
感知损失专注于整体内容恢复;对抗损失专注于纹理细节。
去掉感知损失或仅用像素 MSE,模型难以收敛到有意义的结果。
网络架构
生成器
- 两个 stride=2 的卷积块(下采样)
- 9 个残差块(ResBlocks)
- 两个转置卷积(上采样)
每个 ResBlock:
- 卷积层
- InstanceNorm
- ReLU
- Dropout(p=0.5)
判别器
-
使用 WGAN-GP 框架
-
卷积层后接:
- InstanceNorm
- LeakyReLU
判别器计算清晰图像与生成图像的 Wasserstein 距离。
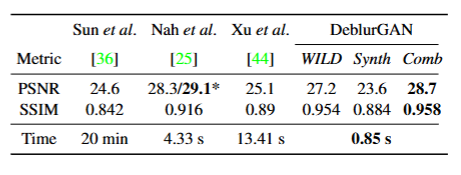
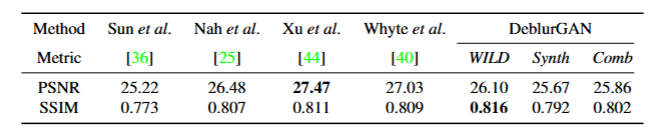
实验
- 训练阶段:生成器 + 判别器 对抗性训练
- 测试阶段:仅保留生成器,输入模糊图像 I B I_B IB,输出去模糊结果 I S I_S IS。
参考文献
- Isola et al. “Image-to-Image Translation with Conditional Adversarial Networks”
- Johnson et al. “Perceptual Losses for Real-Time Style Transfer and Super-Resolution”
- Gulrajani et al. “Improved Training of Wasserstein GANs”
- Arjovsky et al. “Wasserstein GAN”
- Ledig et al. “Photo-Realistic Single Image Super-Resolution Using a Generative Adversarial Network”
更多推荐

 23
 0
- 0


 已为社区贡献1条内容

所有评论(0)