
2025年AGI大模型面试指南:常见问题与答案,附AI大模型算法面试必考100题!
前言
在这个人工智能飞速发展的时代,AI大模型已经成为各行各业创新与变革的重要驱动力。从自动驾驶、医疗诊断到金融分析,AI大模型的应用场景日益广泛,为我们的生活带来了前所未有的便捷。作为一名程序员,了解并掌握AI大模型的相关知识,无疑将大大提升我们的竞争力。
在这个充满机遇的赛道季,众多企业纷纷抛出橄榄枝,发布了大量招聘岗位,面试机会接踵而至。我们更要抓住这个时机,充分准备,迎接挑战。以下分享一些与AI大模型相关的面试题,希望能助大家在求职道路上更进一步。
1、目前主流的开源模型体系有哪些?
Transformer体系:由Google提出的Transformer 模型及其变体,如BERT、GPT 等。
PyTorch Lightning:一个基于PyTorch的轻量级深度学习框架,用于快速原型设计和实验。
TensorFlow Model Garden:TensorFlow官方提供的一系列预训练模型和模型架构。
Hugging Face Transformers:一个流行的开源库,提供了大量预训练模型和工具,用于NLP 任务。
2、prefix LM 和 causal LM 区别是什么?
prefix LM(前缀语言模型):在输入序列的开头添加一个可学习的任务相关的前缀,然后使用这个前缀和输入序列一起生成输出。这种方法可以引导模型生成适应特定任务的输出。
causal LM (因果语言模型):也称为自回归语言模型,它根据之前生成的 token
预测下一个token。在生成文本时,模型只能根据已经生成的部分生成后续部分,不能访问未来的信息。
3、为什么会出现LLMs复读机问题?
LLMs复读机问题可能由多种因素引起,包括模型训练数据中的重复模式、模型在处理长序列时的注意力机制失效、或者模型在生成文本时对过去信息的过度依赖等。
4、如何缓解LLMs复读机问题?
数据增强:通过增加训练数据的多样性和复杂性,减少重复模式的出现。
模型改进:改进模型的结构和注意力机制,使其更好地处理长序列和避免过度依赖过去信息。
生成策略:在生成文本时采用多样化的策略,如抽样生成或引入随机性,以增加生成文本的多样性。
5、什么情况用Bert模型,什么情况用LLaMA、ChatGLM类大模型?
BERT模型通常用于需要理解文本深层语义的任务,如文本分类、命名实体识别等。
LLaMA和
ChatGLM类大模型则适用于需要生成文本或进行更复杂语言理解的任务,如对话系统、文本生成等。选择哪种模型取决于任务的需求和可用资源。
6、什么是 LangChain model?
LangChain
model指的是在LangChain框架中使用的大型语言模型,如GPT-3或类似的模型。这些模型通常用于生成文本、回答问题或执行特定的语言任务。
7、大模型进行训练,用的是什么框架?
TensorFlow是一个由Google开发的开源机器学习框架,它提供了强大的分布式训练功能。
TensorFlow支持数据并行、模型并行和分布式策略等多种分布式训练方法。PyTorch是一个由Facebook的Al研究团队开发的流行的开源机器学习库。它提供了分布式包(torch.distributed),支持分布式训练,并且可以通过使用torch.nn.parallel.DistributedDataParallel(DDP)或torch.nn.DataParallel来实现数据并行。
Horovod是由Uber开源的分布式训练框架,它基于MPI(Message Passing Interface)并提供了一种简单的方法来并行化TensorFlow 、Keras 、PyTorch和Apache
MXNet等框架的训练。Horovod特别适合于大规模的深度学习模型训练。
Ray是一个开源的分布式框架,用于构建和运行分布式应用程序。Ray提供了Ray Tune(用于超参数调优)和RayServe(用于模型服务),并且可以与TensorFlow、PyTorch和MXNet等深度学习库集成。
HuggingFace的Accelerate库是为了简化PyTorch模型的分布式训练而设计的。它提供了一个简单的API来启动分布式训练,并支持使用单个或多个GPU以及TPU。
DeepSpeed是微软开发的一个开源库,用于加速PyTorch模型的训练。它提供了各种优化技术,如ZeRO(Zero Redundancy Optimizer)和模型并行性,以支持大规模模型的训练。
8、为什么大模型推理时显存涨的那么多还一直占着?
模型大小:大模型本身具有更多的参数和计算需求,这直接导致了显存的增加。推理过程中的激活和梯度:在推理时,模型的前向传播会产生激活,这些激活需要存储在显存中,尤其是在执行动态计算或需要中间结果的情况下。
优化器状态:即使是在推理模式下,某些框架可能会默认加载优化器状态,这也会占用显存空间。
内存泄漏:有时代码中的内存泄漏会导致显存一直被占用,而不是在推理完成后释放。
要解决显存占用问题,可以采用的技术包括使用内存分析工具来检测泄漏,优化模型结构,或者使用如TensorFlow
的内存管理功能来显式释放不再需要的内存。
9、大模型在GPU和CPU上推理速度如何?
大模型在GPU 上的推理速度通常远快于CPU, 因为GPU 专门为并行计算设计,具有更多的计算
核心和更高的浮点运算能力。例如,NVIDIA的GPU使用CUDA核心,可以同时处理多个任务,这使得它们在执行深度学习推理时非常高效。CPU虽然也可以执行深度学习推理任务,但由于其核心数量和浮点运算能力通常不及GPU, 因 此速度会慢得多。然而, CPU
在处理单线程任务时可能更高效,且在某些特定场景下,如边缘计算设备上,CPU 可能是唯一可用的计算资源。
10、推理速度上, int8和fp16比起来怎么样?
INT8(8位整数)和FP16(16 位浮点数)都是低精度格式,用于减少模型的大小和提高推理速度。
INT8 提供更高的压缩比,可以显著减少模型的内存占用和带宽需求,但由于量化过程中的
信息损失,可能会对模型的准确性产生一定影响。FP16提供比INT8 更高的精度,通常对模型的准确性影响较小,但相比INT16或FP32,
它的速度和内存效率仍然有所提高。在实际应用中, INT8和FP16的推理速度取决于具体的模型和硬件。一般来说,INT8可能会提供
更高的吞吐量,但FP16可能会提供更好的延迟和准确性。例如,NVIDIA 的Tensor Cores支持FP16和INT8
运算,可以显著提高这两种格式的推理性能。
《AI大模型算法面试大厂必考100题》
每逢招聘旺季,都是程序员跳槽涨薪的好时机,金三银四没赶上,即将到来的金九银十可不能再错过了。获得想要获得更多机会,让你的人生更上一步台阶,就要充分准备。对于面试者而言,掌握一定的复习方法和面试技巧会让你的复习事半功倍,也能极大地提高通过前两轮技术面试的几率。
以下这份最新版《AI大模型算法面试大厂必考100题 》包含各个大厂的高频面题及行业最新技术,是由阿里P6的大佬花两月时间整理和完善而出,资料内容全面、结构清晰,非常适合想要求职/跳槽的伙伴!!
由于文章篇幅有限,不能将100多道面试题+答案解析展示出来,不过不用担心,我已经整理成PDF文档了,有需要的朋友可以扫描下方二维码免费领取!!!
一、大模型风口已至:月薪30K+的AI岗正在批量诞生
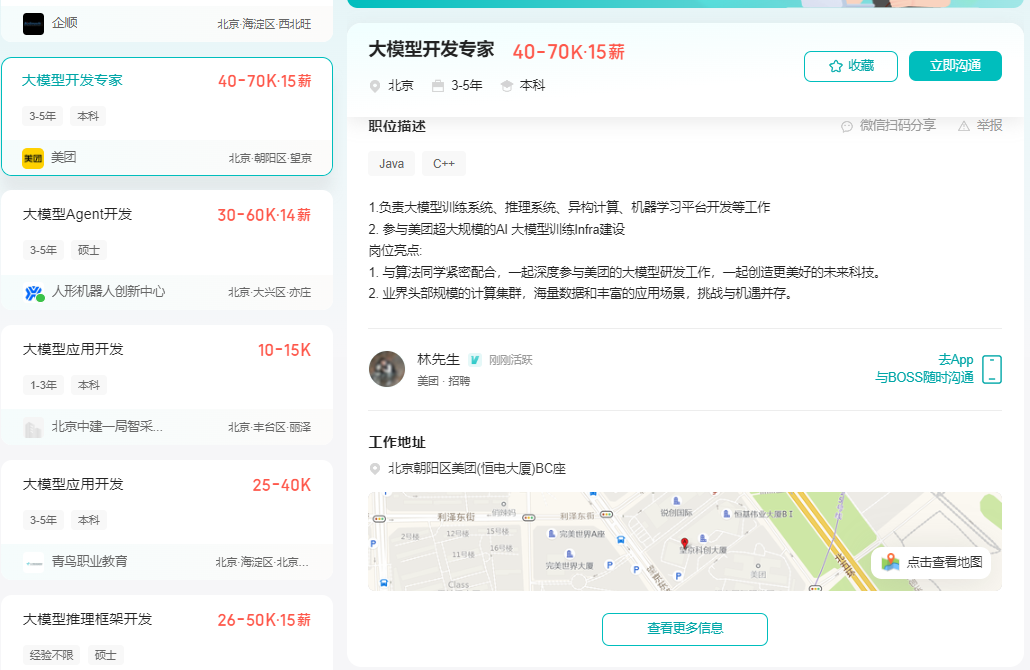
2025年大模型应用呈现爆发式增长,根据工信部最新数据:
国内大模型相关岗位缺口达47万
初级工程师平均薪资28K(数据来源:BOSS直聘报告)
70%企业存在"能用模型不会调优"的痛点
真实案例:某二本机械专业学员,通过4个月系统学习,成功拿到某AI医疗公司大模型优化岗offer,薪资直接翻3倍!

二、如何学习大模型 AI ?
🔥AI取代的不是人类,而是不会用AI的人!麦肯锡最新报告显示:掌握AI工具的从业者生产效率提升47%,薪资溢价达34%!🚀
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
1️⃣ 提示词工程:把ChatGPT从玩具变成生产工具
2️⃣ RAG系统:让大模型精准输出行业知识
3️⃣ 智能体开发:用AutoGPT打造24小时数字员工
📦熬了三个大夜整理的《AI进化工具包》送你:
✔️ 大厂内部LLM落地手册(含58个真实案例)
✔️ 提示词设计模板库(覆盖12大应用场景)
✔️ 私藏学习路径图(0基础到项目实战仅需90天)

第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。
如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】
更多推荐



 25
 0
- 0


 已为社区贡献11条内容

所有评论(0)