
Apache Paimon大厂面试题必备-进阶篇(一)
Paimon面试必备系列参考:
本篇属于进阶篇。
这是一个系列文章,包含基础篇、原理篇、进阶篇、实践篇等至少4+个系列。欢迎收藏、追更。
本系列内容在知识星球持续更新,同步答疑。冲刺中大公司、高阶岗位的同学随时在知识星球提问。
Paimon的时效性和一致性是如何保证的?
提到Paimon的时效性与一致性,就必须要提到Paimon的快照文件,快照(snapshot)文件是读取Paimon表数据的入口。消费者可以通过快照文件,查询在该快照文件产生时刻的Paimon表中的具体数据。因此,通过读取不同的快照文件,消费者可以查询Paimon表在不同时间点的状态,在流作业中实现消费位点的修改,以及在批作业中实现time travel功能。
如何保证时效性?
数据写入Paimon表时,Paimon writer算子会首先将数据缓存在内存以及临时文件中。在Flink作业创建检查点(Checkpoint)后,才会将临时文件进行提交(Commit),并产生快照(Snapshot)文件。下游的流式消费者将监听Paimon表的快照文件列表,发现新的快照文件后,才会读取该快照文件对应的变更数据。
因此,Paimon的时效性受快照文件产生频率的影响,而在Flink作业没有反压的情况下,产生快照文件的时间间隔等同于Flink作业创建检查点的时间间隔(checkpoint interval)。也就是说,Paimon表的时效性等同于Flink作业创建检查点的时间间隔。然而,创建检查点的时间间隔过小,可能会对Flink作业的运行效率产生负面影响。在使用Paimon表时,我们建议将Flink作业创建检查点的时间间隔设置为1分钟至10分钟。且根据业务的接受程度,应尽可能提高这一时间间隔,以进一步提高Paimon表的读写效率。
如何保证一致性?
Paimon使用两阶段提交协议将数据进行原子化的提交。对于同时写入同一张Paimon表的两个Flink作业:
不修改同一个分桶内的数据时,两个作业中的提交操作可同时进行,并保证sequential级别的一致性。
(强烈不推荐),如果两个作业同时修改同一个分桶内的数据,Paimon将通过作业失败重启(Failover)的方式解决数据冲突,且只能保证Snapshot Isolation级别的一致性。也就是说,Paimon表的最终状态可能是两个作业结果数据的混合,不会有数据丢失。
详细解释一下Paimon的Snapshots系统表
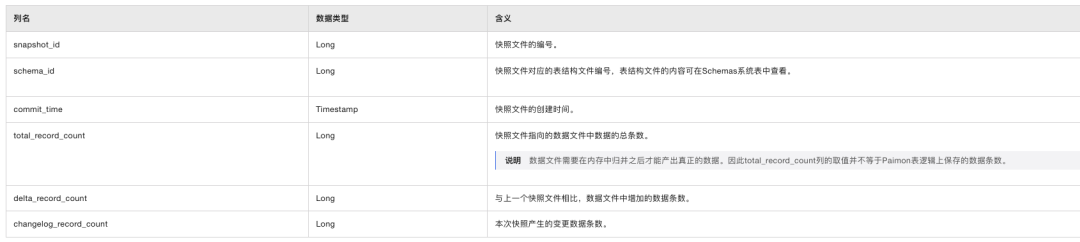
Paimon 的 Snapshots 系统表主要用于记录表的快照信息。快照是数据在某个特定时间点的状态表示,对数据的版本控制、时间旅行(Time - Travel)以及流处理中的状态管理等功能都非常关键。
我们可以通过sql直接查询snapshots表:
SELECT * FROM mycatalog.mydb.`mytbl$snapshots`;Snapshots系统表常用的列:
Paimon如何清理过期数据?为什么要清理过期数据?
首先,大量的数据写Paimon会产生大量的快照和旧版本数据,这些数据占用了大量的存储空间,在增加存储成本的同时会影响查询性能。
Paimon本身提供了以下几种方式控制数据的过期。
通过调整快照文件的过期时间
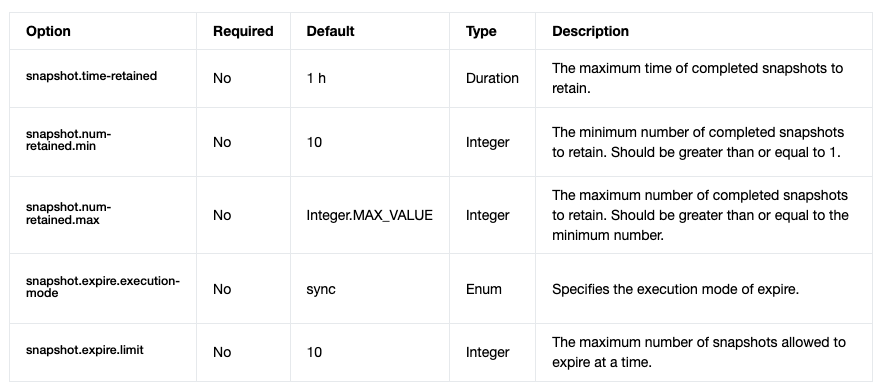
我们简单用一句话总结:要么保留我指定的快照个数,要么保留我指定的时间。这里要注意,这个时间不能太短,否则数据很快失效,影响查询。
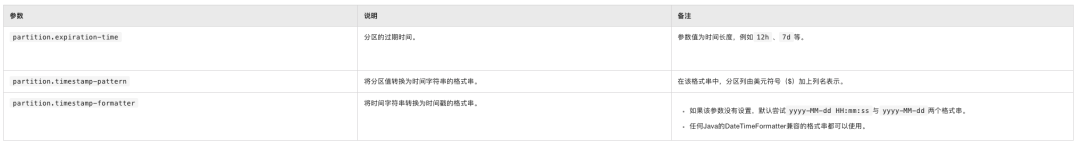
设置分区过去时间
如果你用的是分区表,那么可以参考Hive的数据过期方式,指定分区的过去时间即可。
分区过期行为由下表三个表参数共同决定:
手动清理孤儿文件
Paimon在更新和删除的过程中,在系统中失去关联属性,会产生部分「孤儿文件」,这些废弃文件无法通过快照过期删除,可以通过手动执行命令的方式清理。例如下面的命令:
CALL `<catalog-name>`.sys.remove_orphan_files('<database-name>.<table-name>');事实上,我们在部署Paimon集群的过程中可以加入一些定时清理的策略,删除这些垃圾文件。
Paimon常见的优化策略有哪些?
直接参考:Paimon性能优化小总结。

更多推荐


 13
 0
- 0


 已为社区贡献2条内容

所有评论(0)