
openEuler 安装 hive4
openEuler 安装 hive4
准备
HDFS配置
vim $HADOOP_HOME/etc/hadoop/core-site.xml
  <!--配置所有节点的root用户都可作为代理用户-->
  <property>
    <name>hadoop.proxyuser.root.hosts</name>
    <value>*</value>
  </property>

  <!--配置root用户能够代理的用户组为任意组-->
  <property>
    <name>hadoop.proxyuser.root.groups</name>
    <value>*</value>
  </property>

  <!--配置root用户能够代理的用户为任意用户-->
  <property>
    <name>hadoop.proxyuser.root.users</name>
    <value>*</value>
  </property>
启动Hadoop
# 启动hadoop
start-all.sh
# 检查hadoop进程
jps
# 检查各端口
netstat -aplnt | grep java
检查MySQL是否启动成功
ps -aux | grep mysql
netstat -aplnt | grep 3306
安装hive
| 节点 | 服务 |
|---|---|
| lihaozhe01 | hive |
| lihaozhe02 | hive |
| lihaozhe03 | mysql hive |
# 将软件上传到 /opt/soft 目录
wget https://dlcdn.apache.org/hive/hive-4.0.1/apache-hive-4.0.1-bin.tar.gz
# 解压hive
tar -zxvf apache-hive-4.0.1-bin.tar.gz
# 目录改名
mv apache-hive-4.0.1-bin hive-4
# 进入配置文件目录
cd /opt/soft/hive-4/conf
# 编辑环境配置文件
vim hive-env.sh
# 编辑配置文件
vim hive-site.xml
hive-env.sh
hadoop 安装路径 export HADOOP_HOME=/opt/soft/hadoop-3/
hive 配置文件路径 export HIVE_CONF_DIR=/opt/soft/hive-4/conf/****
export HADOOP_HOME=/opt/soft/hadoop-3/
export HIVE_CONF_DIR=/opt/soft/hive-4/conf/
hive-site.xml
需要修改的位置提炼如下:
<configuration>
<!-- 记录HIve中的元数据信息 记录在mysql中 -->
<property>
<name>javax.jdo.option.ConnectionURL</name>
<value>jdbc:mysql://lihaozhe03:3306/hive?allowPublicKeyRetrieval=true&useUnicode=true&createDatabaseIfNotExist=true&characterEncoding=UTF8&useSSL=false&useServerPrepStmts=false&rewriteBatchedStatements=true&cachePrepStmts=true&allowMultiQueries=true&serverTimeZone=Asia/Shanghai&sslMode=DISABLED</value>
</property>
<!-- jdbc mysql驱动 -->
<property>
<name>javax.jdo.option.ConnectionDriverName</name>
<value>com.mysql.cj.jdbc.Driver</value>
</property>
<!-- mysql的用户名和密码 -->
<property>
<name>javax.jdo.option.ConnectionUserName</name>
<value>root</value>
</property>
<property>
<name>javax.jdo.option.ConnectionPassword</name>
<value>Lihaozhe!!@@1122</value>
</property>
<property>
<name>hive.metastore.warehouse.dir</name>
<value>/user/hive/warehouse</value>
</property>
<property>
<name>hive.exec.scratchdir</name>
<value>/user/hive/tmp</value>
</property>
<property>
<name>hive.exec.local.scratchdir</name>
<value>/home/hive/local</value>
<description>Local scratch space for Hive jobs</description>
</property>
<property>
<name>hive.downloaded.resources.dir</name>
<value>/home/hive/resources</value>
<description>Temporary local directory for added resources in the remote file system.</description>
</property>
<!-- 日志目录 -->
<property>
<name>hive.querylog.location</name>
<value>/user/hive/log</value>
</property>
<!-- 设置metastore的节点信息 -->
<property>
<name>hive.metastore.uris</name>
<!--<value>thrift://lihaozhe03:9083</value>-->
<value/>
</property>
<!-- 客户端远程连接的端口 -->
<property>
<name>hive.server2.thrift.port</name>
<value>10000</value>
</property>
<property>
<name>hive.server2.thrift.bind.host</name>
<value>0.0.0.0</value>
</property>
<property>
<name>hive.server2.webui.host</name>
<value>0.0.0.0</value>
</property>
<!-- hive服务的页面的端口 -->
<property>
<name>hive.server2.webui.port</name>
<value>10002</value>
</property>
<property>
<name>hive.server2.long.polling.timeout</name>
<value>5000ms</value>
</property>
<property>
<name>hive.server2.enable.doAs</name>
<value>true</value>
</property>
<!--
<property>
<name>datanucleus.autoCreateSchema</name>
<value>false</value>
</property>
<property>
<name>datanucleus.fixedDatastore</name>
<value>true</value>
</property>
-->
<property>
<name>hive.execution.engine</name>
<value>mr</value>
</property>
<property>
<name>hive.metastore.schema.verification</name>
<value>false</value>
</property>
<property>
<name>hive.server2.logging.operation.log.location</name>
<value>/home/hive/tmp/operation_logs</value>
</property>
</configuration>
注意:上面配置文件中的路径在 vi 编辑器下 全局替换 本案例已经替换过了无需执行
:%s@\${system:java.io.tmpdir}@/tmp/hive-log@g不要使用图形化 不然每次保存后3215行都会有个  特殊字符 如果产生删除即可 具体报错信息 后面有单独的描述
配置环境变量
vim /etc/profile
export HIVE_HOME=/opt/soft/hive-4
export HCATALOG_HOME=/opt/soft/hive-4/hcatalog

export PATH=$PATH:$HIVE_HOME/bin:$HCATALOG_HOME/bin:$HCATALOG_HOME/sbin
完整
export JAVA_HOME=/opt/soft/jdk-8

export ZOOKEEPER_HOME=/opt/soft/zookeeper-3

export HDFS_NAMENODE_USER=root
export HDFS_SECONDARYNAMENODE_USER=root
export HDFS_DATANODE_USER=root
export HDFS_ZKFC_USER=root
export HDFS_JOURNALNODE_USER=root
export HADOOP_SHELL_EXECNAME=root

export YARN_RESOURCEMANAGER_USER=root
export YARN_NODEMANAGER_USER=root

export HADOOP_HOME=/opt/soft/hadoop-3
export HADOOP_INSTALL=$HADOOP_HOME
export HADOOP_MAPRED_HOME=$HADOOP_HOME
export HADOOP_COMMON_HOME=$HADOOP_HOME
export HADOOP_HDFS_HOME=$HADOOP_HOME
export YARN_HOME=$HADOOP_HOME
export HADOOP_CONF_DIR=$HADOOP_HOME/etc/hadoop
export JAVA_LIBRARY_PATH=$HADOOP_HOME/lib/native

export HBASE_HOME=/opt/soft/hbase-2

export PHOENIX_HOME=/opt/soft/phoenix

export HIVE_HOME=/opt/soft/hive-4
export HCATALOG_HOME=/opt/soft/hive-4/hcatalog

export PATH=$PATH:$JAVA_HOME/bin:$ZOOKEEPER_HOME/bin:$HADOOP_HOME/bin:$HADOOP_HOME/sbin:$HBASE_HOME/bin:$PHOENIX_HOME/bin:$HIVE_HOME/bin:$HCATALOG_HOME/bin:$HCATALOG_HOME/sbin
source /etc/profile
上传 MySQL 连接驱动 jar 包到 hive 安装目录的lib目录下:
$HIVE_HOME/lib
删除原有的 protobuf-java-3.24.4.jar 文件
上传 jar 包有两个 分别为:
- mysql-connector-j-9.1.0.jar
- protobuf-java-4.28.3.jar
rm -f $HIVE_HOME/lib/protobuf-java-3.24.4.jar
guava版本冲突
删除 hive/lib目录中的 guava-22.0.jar
拷贝hadoop/share/hadoop/common/lib目录中的 guava-27.0-jre.jar 到 hive/lib 目录
rm -f $HIVE_HOME/lib/guava-22.0.jar
cp -v $HADOOP_HOME/share/hadoop/common/lib/guava-27.0-jre.jar $HIVE_HOME/lib
初始化hive的元数据库
注意:初始初始元数据库之前 保证 hadoop 和 mysql 正常启动
推荐现在mysql 手动创建 hive 元数据库
create database hive default character set utf8;
Linux控制台执行以下命令初始化 hive 元数据库
schematool -initSchema -dbType mysql -verbose
中文乱码
mysql -uroot -p
use hive;
alter table COLUMNS_V2 modify column COMMENT varchar(256) character set utf8;
alter table TABLE_PARAMS modify column PARAM_VALUE varchar(4000) character set utf8;
alter table PARTITION_PARAMS modify column PARAM_VALUE varchar(4000) character set utf8;
alter table PARTITION_KEYS modify column PKEY_COMMENT varchar(4000) character set utf8;
flush privileges;
log日志
分发软件和环境变量
scp -r /opt/soft/hive-4 root@lihaozhe01:/opt/soft/
scp -r /opt/soft/hive-4 root@lihaozhe02:/opt/soft/
scp /etc/profile root@lihaozhe01:/etc
scp /etc/profile root@lihaozhe02:/etc
在各节点使新的环境变量生效
source /etc/profile
远程模式
lihaozhe03
# 启动服务端
hive --service metastore
hive --service hiveserver2
# hive --service hiveserver2 与 hiveserver2 start 作用相同

# 启动服务端 后台运行
hive --service metastore &
hive --service hiveserver2 &

# 启动服务端 后台运行
nohup hive --service metastore > /dev/null 2>&1 &
nohup hive --service hiveserver2 > /dev/null 2>&1 &
bash 中 0、1、2 三个数字分别代表 STDIN_FILENO 、 STDOUT_FILENO 、STDERR_FILENO ,
即标准输入(一般是键盘),
标准输出(一般是显示屏,准确的说是用户终端控制台),
标准错误(输出错信息输出)。
| 数字 | 含义 |
|---|---|
| 0 | 标准输入(一般是键盘) |
| 1 | 标准输出(一般是显示屏,准确的说是用户终端控制台) |
| 2 | 标准错误(输出错信息输出) |
/dev/null看作"黑洞". 它等价于一个只写文件.
所有写入它的内容都会永远丢失.
而尝试从它那儿读取内容则什么也读不到
启动hive脚本
start-hive.sh
nohup hive --service metastore > /dev/null 2>&1 &
nohup hive --service hiveserver2 > /dev/null 2>&1 &
为脚本添加可执行权限
chmod +x start-hive.sh
分发启动脚本
scp start-hive.sh root@lihaozhe01:/opt/soft/hive-4/bin/
scp start-hive.sh root@lihaozhe02:/opt/soft/hive-4/bin/
scp start-hive.sh root@lihaozhe03:/opt/soft/hive-4/bin/
客户端连接
beeline 连接
beeline -u jdbc:hive2://lihaozhe03:10000 -n root
beeline 连接参数
Option Description
--autoCommit=[true/false] ---进入一个自动提交模式:beeline --autoCommit=true
--autosave=[true/false]   ---进入一个自动保存模式:beeline --autosave=true
--color=[true/false]    ---显示用到的颜色:beeline --color=true
--delimiterForDSV= DELIMITER ---分隔值输出格式的分隔符。默认是“|”字符。
--fastConnect=[true/false]  ---在连接时,跳过组建表等对象:beeline --fastConnect=false
--force=[true/false]    ---是否强制运行脚本:beeline--force=true
--headerInterval=ROWS   ---输出的表间隔格式,默认是100: beeline --headerInterval=50
--help ---帮助  beeline --help
--hiveconf property=value  ---设置属性值,以防被hive.conf.restricted.list重置:beeline --hiveconf prop1=value1
--hivevar name=value   ---设置变量名:beeline --hivevar var1=value1
--incremental=[true/false]  ---输出增量
--isolation=LEVEL  ---设置事务隔离级别:beeline --isolation=TRANSACTION_SERIALIZABLE
--maxColumnWidth=MAXCOLWIDTH ---设置字符串列的最大宽度:beeline --maxColumnWidth=25
--maxWidth=MAXWIDTH ---设置截断数据的最大宽度:beeline --maxWidth=150
--nullemptystring=[true/false]  ---打印空字符串:beeline --nullemptystring=false
--numberFormat=[pattern]     ---数字使用DecimalFormat:beeline --numberFormat="#,###,##0.00"
--outputformat=[table/vertical/csv/tsv/dsv/csv2/tsv2] ---输出格式:beeline --outputformat=tsv
--showHeader=[true/false]   ---显示查询结果的列名:beeline --showHeader=false
--showNestedErrs=[true/false] ---显示嵌套错误:beeline --showNestedErrs=true
--showWarnings=[true/false] ---显示警告:beeline --showWarnings=true
--silent=[true/false]  ---静默方式执行,不显示执行过程信息:beeline --silent=true
--truncateTable=[true/false] ---是否在客户端截断表的列
--verbose=[true/false]  ---显示详细错误信息和调试信息:beeline --verbose=true
-d <driver class>  ---使用一个驱动类:beeline -d driver_class
-e <query>  ---使用一个查询语句:beeline -e "query_string"
-f <file>  ---加载一个文件:beeline -f filepath  多个文件用-e file1 -e file2
-n <username>  ---加载一个用户名:beeline -n valid_user
-p <password>  ---加载一个密码:beeline -p valid_password
-u <database URL> ---加载一个JDBC连接字符串:beeline -u db_URL
hive 连接
hive
启动客户端后连接
!connect jdbc:hive2://lihaozhe03:10000 -n root
浏览器访问
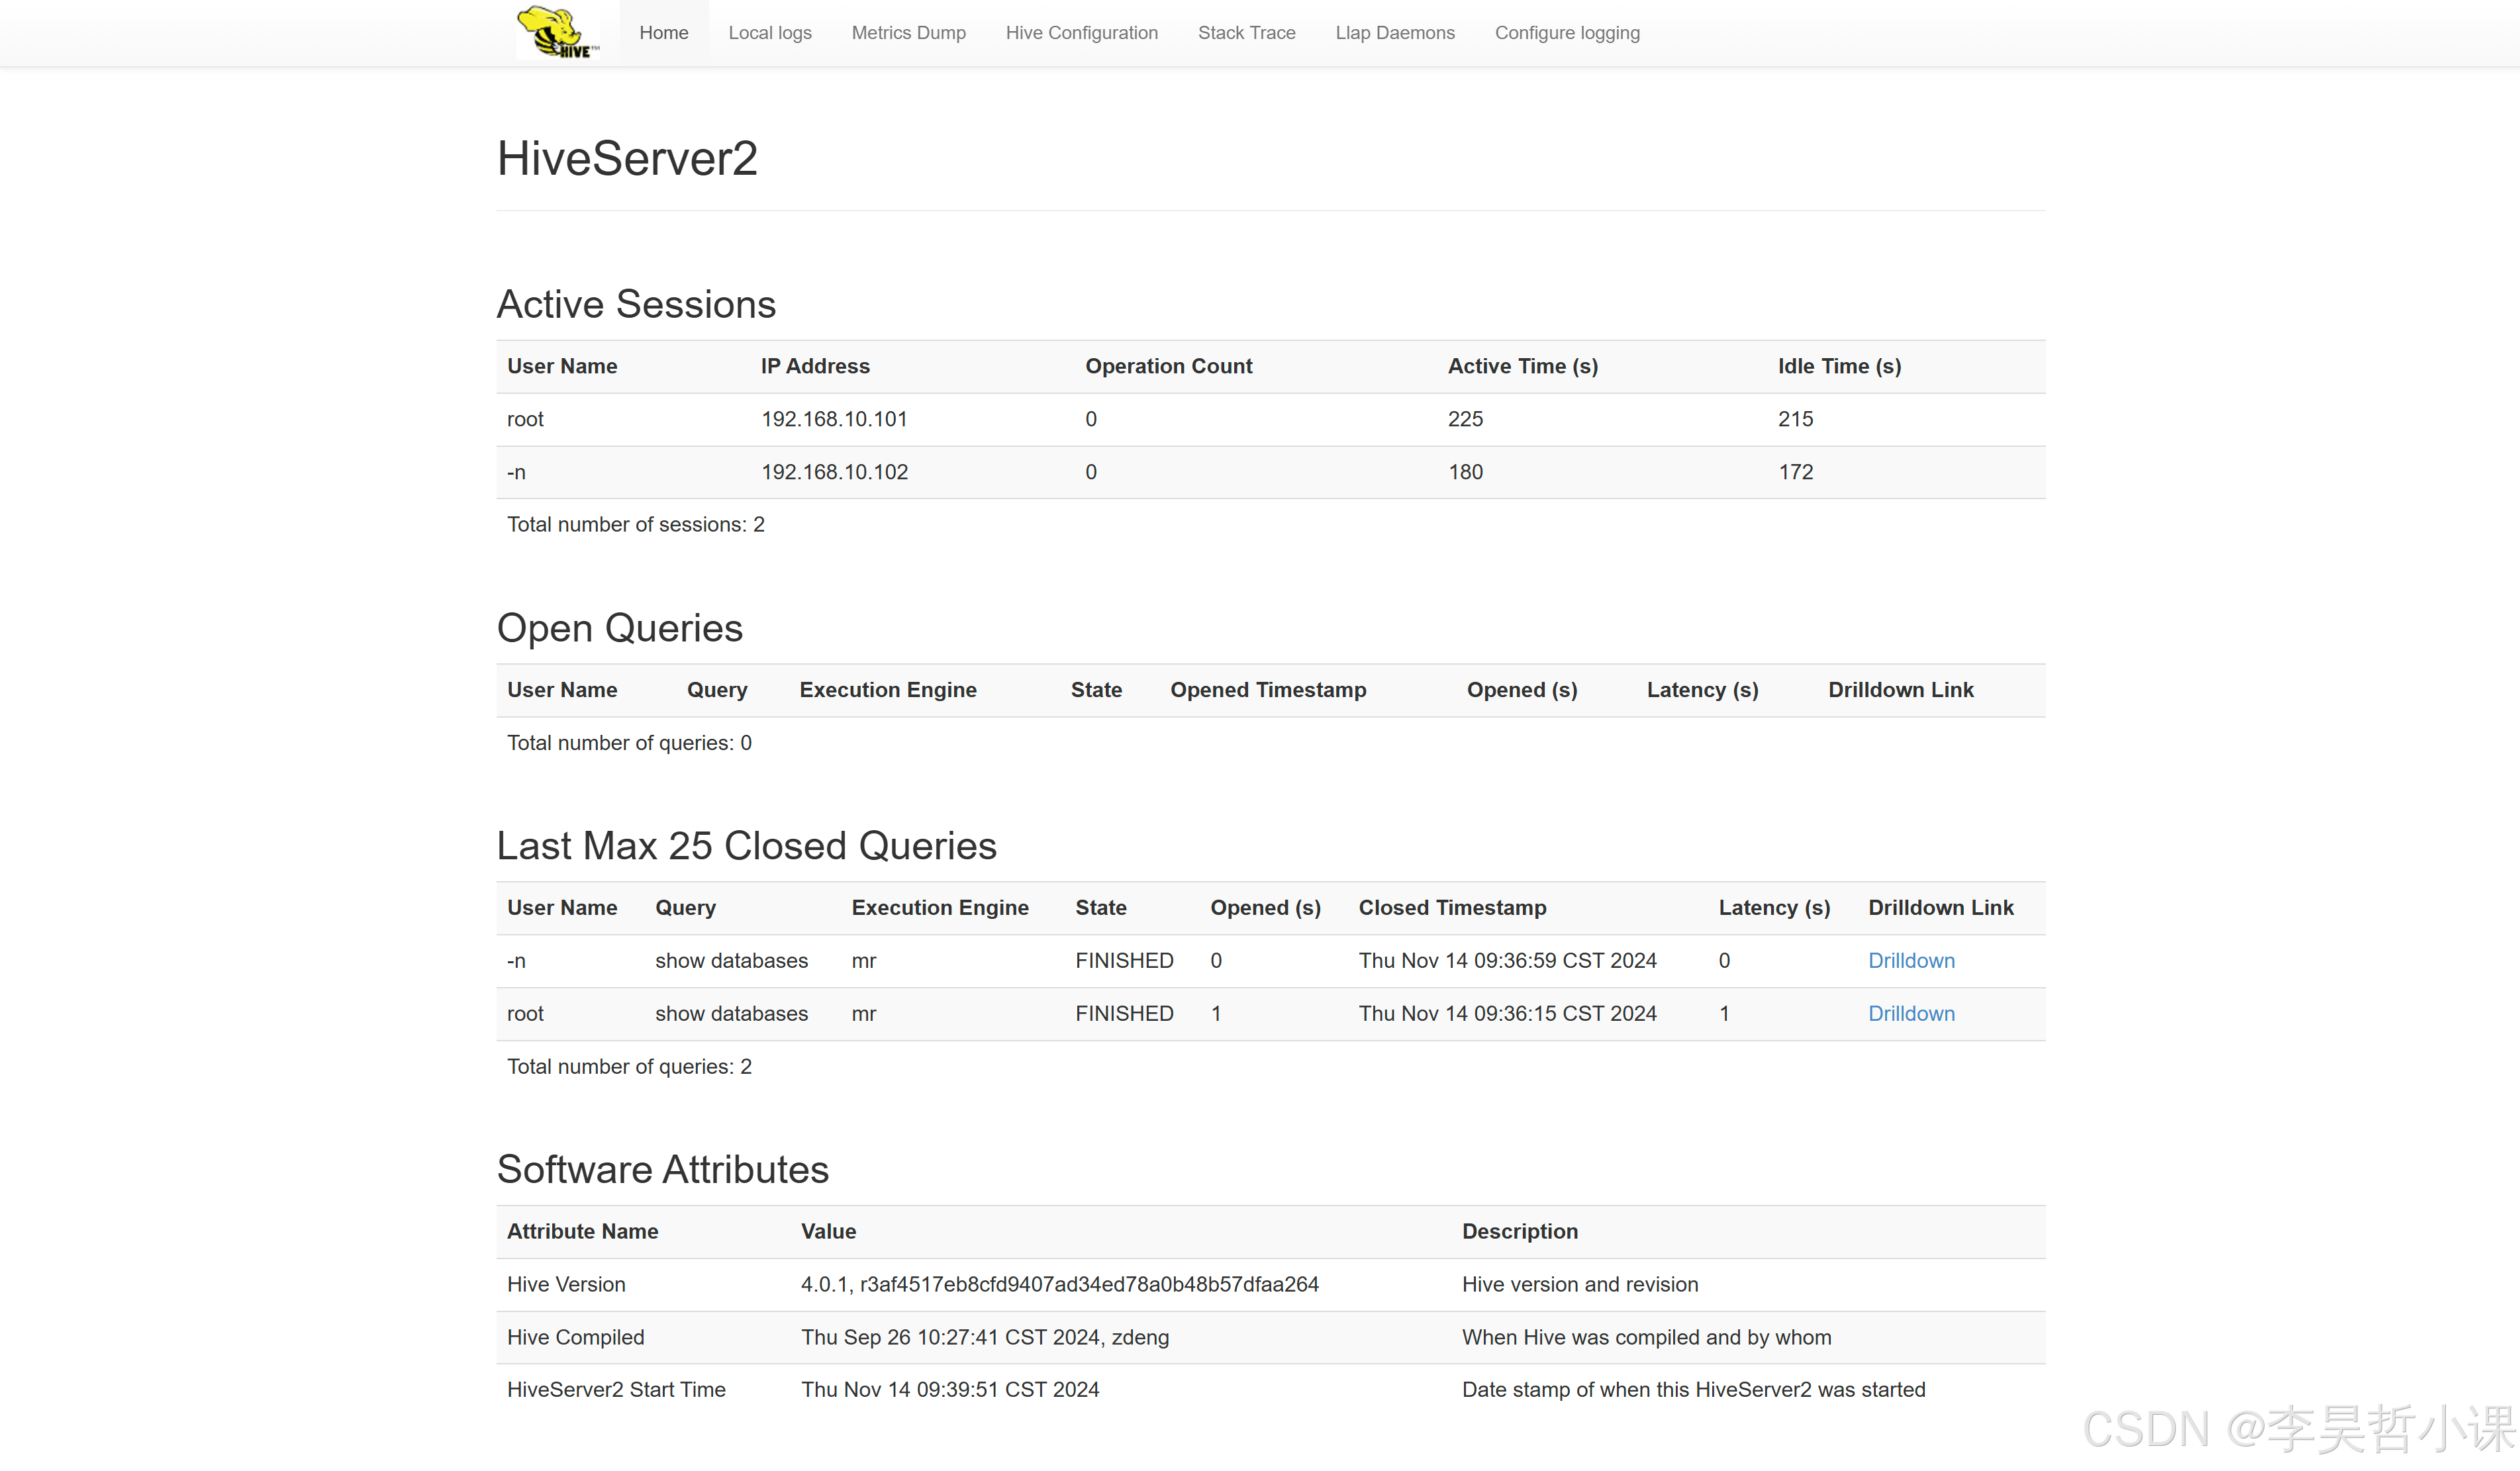
http://lihaozhe03:10002/
体验
use default;
create table person (
	id int,
    phonenum bigint,
    salary dicimal,
    name string
);
show tables;
insert into person values (1001,13966668888,9999.99,"张三");
songsong,bingbing_lili,xiao song:18_xiaoxiao song:19
longlong,pingping_liuliu,xiao long:8_xiaoxiao long:9
drop table person;
create table person (
    name string,
    friends array<string>,
    childrens map<string,int>
)
 row format delimited fields terminated by ','
 collection items terminated by '_'
 map keys terminated by ':'
 lines terminated by '\n';
load data local inpath '/root/person.txt' into table person;
drop table data;
create table data (
    name string,
   	amount int
)
 row format delimited fields terminated by ','
 lines terminated by '\n';
 load data local inpath  '/root/data.txt' into table data;
select count(*) from data;
select count(*) from data group by name;
select name,max(t) from data group by name;
select name,max(t) from data group by name order by max(t) ;
# 本地
set mapreduce.framework.name=local;
set hive.exec.mode.local.auto=true;
# yarn
set mapreduce.framework.name=yarn;
set hive.exec.mode.local.auto=false;

# 向量模式
set hive.vectorized.execution.enabled=true;
set hive.vectorized.execution.enabled=false;

set mapreduce.framework.name=local;
set hive.exec.mode.local.auto=true;
set hive.vectorized.execution.enabled=true;
kill hive
编写 kill_runjar.sh 脚本 kill 掉后台 RunJar 进程
#!/bin/bash

# 查找并杀死所有 RunJar 进程
pids=$(ps -ef | grep RunJar | grep -v grep | awk '{print $2}')

# 检查是否有找到任何 PID
if [ -n "$pids" ]; then
    # 按行kill并输出
    for pid in $pids; do
    	echo "Killing the following RunJar processes PID: $pid"
        kill -9 $pid
    done
else
    echo "No RunJar processes found."
fi
脚本添加可执行权限
chmod +x kill_runjar.sh
分发脚本到所有节点
scp kill_runjar.sh root@lihaozhe01:/opt/soft/hive-4/bin/
scp kill_runjar.sh root@lihaozhe02:/opt/soft/hive-4/bin/
scp kill_runjar.sh root@lihaozhe03:/opt/soft/hive-4/bin/
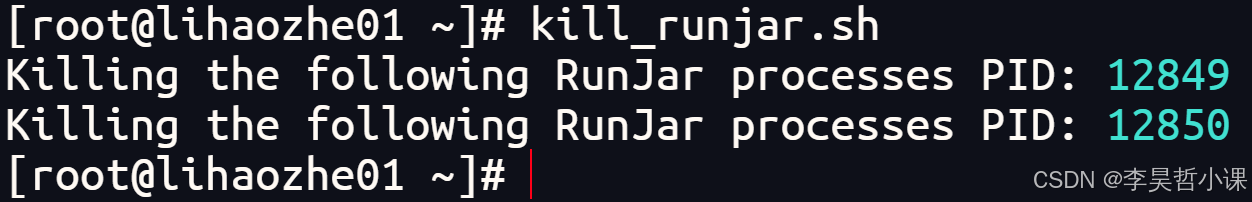
执行脚本 关闭 hive
kill_runjar.sh
更多推荐


 15
 0
- 0


 已为社区贡献5条内容

所有评论(0)