
【线性结构】哈希表 {基本概念;哈希函数;哈希冲突解决方案:闭散列:线性探测法,二次探测法,双散列法;开散列(链地址法);Hash算法}
一、哈希表的概念
顺序结构以及平衡树
顺序结构以及平衡树中,元素关键码与其存储位置之间没有对应的关系。因此在查找一个元素时,必须要经过关键码的多次比较。顺序查找时间复杂度为O(N);平衡树中为树的高度,即O(log_2 N),搜索的效率取决于搜索过程中元素的比较次数。
哈希表
如果构造一种存储结构,通过某种转换函数(hashFunc)使元素的存储位置与它的关键码之间能够建立一一映射的关系。那么在查找时可以不经过任何比较,通过该函数一次直接从表中得到要搜索的元素:
-
当向该结构中插入元素时:根据待插入元素的关键码,通过转换函数计算出该元素的存储位置并按此位置进行存放。
-
当从该结构中搜索元素时:对元素的关键码进行同样的计算,获得元素的存储位置。
该方式即为哈希(散列)方法,哈希方法中使用的转换函数称为哈希(散列)函数,构造出来的结构称为哈希表(Hash Table或者称散列表)
哈希究竟代表什么?哈希表和哈希函数的核心原理_哔哩哔哩_bilibili
二、哈希函数
哈希函数的设计原则
- 哈希函数的定义域必须包括需要存储的全部关键码,而如果散列表允许有m个地址时,其值域必须在0到m-1之间
- 哈希函数计算出来的地址能均匀分布在整个空间中
- 哈希函数应该比较简单
常见的哈希函数
-
直接定址法
取关键字的某个线性函数为散列地址:Hash(Key)= A*Key + B
优点:简单、均匀、不存在哈希冲突
缺点:需要事先知道关键字的分布情况,只适合查找分布相对集中的情况。
举例:1.编程题:字符串中第一个只出现一次字符 2.排序算法:计数排序 -
除留余数法
设散列表中允许的地址数为m,取一个不大于m,但最接近或者等于m的质数p作为除数;且p也应避免取2的幂,10的幂,防止得到的地址分布太集中,导致冲突增多。
按照哈希函数:Hash(key) = key% p(p<=m),将关键码转换成哈希地址
-
其他哈希函数:数字分析法,平方取中法,折叠法等
例如:数据集合{1,7,6,4,5,9};
哈希函数采用除留余数法:hash(key) = key % capacity; capacity为存储元素底层空间的总大小。
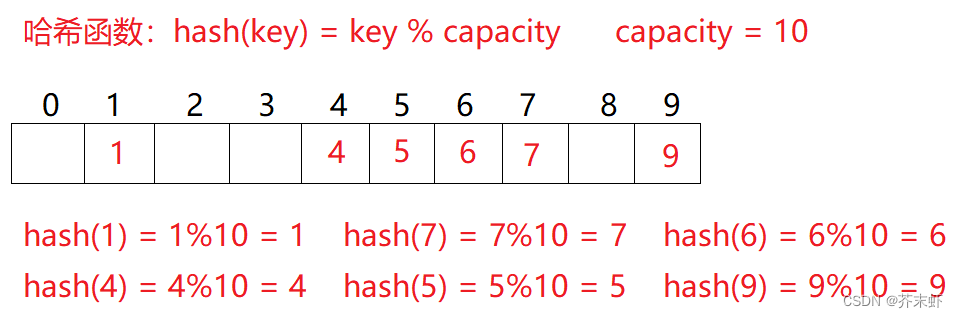
问:按照上述哈希方式,向集合中插入元素44,会出现什么问题?
三、哈希冲突
3.1 什么是哈希冲突
对于两个数据元素的关键字k_i和 k_j,有k_i != k_j,但有:Hash(k_i) ==Hash(k_j);即不同关键字通过哈希函数计算出相同的哈希地址,这种现象称为哈希冲突或哈希碰撞。
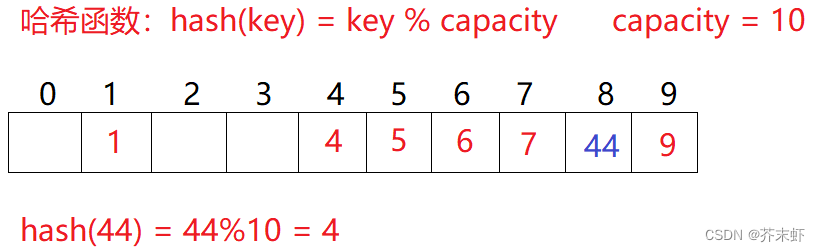
比如2.2中的场景,现在需要插入元素44,先通过哈希函数计算哈希地址为4,因此44理论上应该插在该位置,但是该位置已经放了值为4的元素,即发生哈希冲突。
把关键码不同而具有相同哈希地址的数据元素称为“同义词”。
发生哈希冲突该如何处理呢?解决哈希冲突两种常见的方法是:闭散列和开散列
3.1 闭散列
闭散列:当发生哈希冲突时,如果哈希表未被装满,说明在哈希表中必然还有空位置,那么可以把key存放到冲突位置中的下一个空位置中去。那如何寻找下一个空位置呢?
3.1.1 线性探测法
线性探测:从发生冲突的位置开始,依次向后探测,直到寻找到下一个空位置为止。
插入
通过哈希函数获取待插入元素在哈希表中的位置
如果该位置中没有元素则直接插入新元素,如果该位置中有元素发生哈希冲突,使用线性探测找到下一个空位置,插入新元素
删除
采用闭散列处理哈希冲突时,不能随便物理删除哈希表中已有的元素,若直接删除元素会影响其他元素的搜索。
比如删除元素4,如果直接删除掉,44查找起来可能会受影响。因此线性探测采用标记的伪删除法来删除一个元素。
哈希表每个空间给个标记:EMPTY此位置为空, EXIST此位置已经有元素, DELETE元素已经删除
- 插入时:对于EMPTY和DELETE标记的位置可以进行插入,EXIST不能插入。
- 搜索时:遇到EXIST和DELETE标记的位置继续向后搜索,遇到EMPTY结束。
提示:使用删除标记delete进行逻辑删除,这样做的副作用是在执行多次删除后,由于搜索在遇到delete标记时仍然继续,因此不成功的搜索长度将会增加,降低搜索效率。因此,当散列表经常变动时,最好不用闭散列方法处理冲突,可改用开散列方法。
扩容
思考:哈希表什么情况下进行扩容?如何扩容?
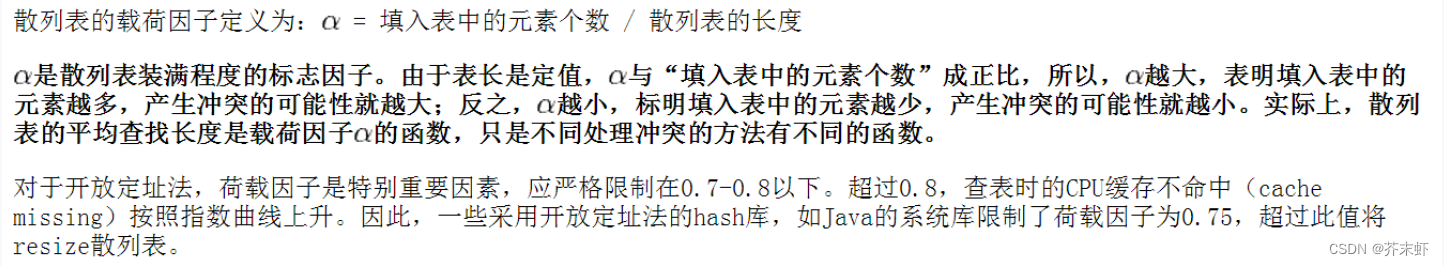
载荷因子(空间占用率)达到基准值(0.7~0.8)就扩容。
-
基准值越大,哈希冲突的概率越大,查找效率越低,但空间利用率越高。
-
基准值越小,哈希冲突的概率越小,查找效率越高,但空间利用率越低。
再次强调:线性探测方法下的散列表,其载荷因子应该控制在0.7~0.8范围内。
线性探测的实现
        enum State{
          EMPTY,
          DELETE,
          EXIST
        };

        template <class K, class V>
        struct HashData{
          pair<K,V> _kv;
          State _state = EMPTY;
        };

        //HashKey用于将不匹配或复杂的key值转化为size_t类型,然后才能通过除留余数法计算哈希地址。
        //对于不匹配的内置类型做强转:
        template <class K>
        struct HashKey{
          size_t operator()(const K& k)
          {
            return (size_t)k;
          }
        };

        //对于常见复杂类型提供模版的特化:
        template <>
        struct HashKey<string>{
          size_t operator()(const string& str)
          {
            size_t ret = 0;
            for(auto ch : str)
            {
              ret += ch;
              ret *= 131; //BKDR算法
            }
            return ret;
          }
        };

        template <class K, class V, class Hash = HashKey<K>>
        class HashTable{
          vector<HashData<K,V>> _table;
          size_t _size= 0; //哈希表中的实际有效数据

        public:
          bool insert(const pair<K,V>& kv){
            //不允许键值冗余
            if(find(kv.first) != nullptr)
              return false;
            //检查载荷因子,进行扩容,复用下面的插入逻辑
            if(_table.size() == 0 || _size*10/_table.size() >= 7)
            {
              int newsize = _table.size()==0? 10 : _table.size()*2;
              HashTable newHT; //创建新的哈希表对象
              newHT._table.resize(newsize);
              for(auto &e : _table)
              {
                if(e._state == EXIST)
                newHT.insert(e._kv); //调用成员函数insert重新计算元素的映射位置
              }
              //交换两个哈希表的vector
              //函数返回前newHT包含扩容前的vector会被析构
              _table.swap(newHT._table);
            }

            Hash hash; //hash算法会将不匹配或复杂的key值转化为size_t类型
            int hashi = hash(kv.first)%_table.size();
            //线性探测
            //遇到EMPTY或DELETE位置停下
            while(_table[hashi]._state == EXIST)
            {
              ++hashi;
              hashi %= _table.size(); //如果超出范围需折返到开头继续探测
            }
            _table[hashi]._kv = kv;
            _table[hashi]._state = EXIST;
            ++_size;
            return true;
          }

          HashData<K,V>* find(const K& k)
          {
            if(_table.size() == 0)
              return nullptr; //空表返回nullptr
            Hash hash;
            int hashi = hash(k)%_table.size();
            int start = hashi;
            //线性探测
            //遍历到EMPTY位置表示对应key值的元素不存在。
            //注意:遇到DELETE位置不能停,要继续向后查找。
            while(_table[hashi]._state != EMPTY)
            {
              if(_table[hashi]._state == EXIST && _table[hashi]._kv.first == k)
              {
                return &_table[hashi]; //找到返回数据地址
              }
              ++hashi;
              hashi%=_table.size();
              //处理极端情况:表中元素的状态全是DELETE
              if(hashi == start)
                break;
            }
            return nullptr; //找不到返回nullptr
          }

          bool erase(const K& k)
          {
            HashData<K,V>* ret = find(k);
            if(ret == nullptr)
              return false;
            else
            {
              //线性探测采用标记的伪删除法来删除一个元素
              ret->_state = DELETE; //所谓删除就是将对应key值的元素状态改为DELETE
              --_size; //记得修改大小哦
              return true;
            }
          }

          void printHT(){ //打印哈希表
            for(int i=0; i<_table.size(); ++i)
            {
              if(_table[i]._state == EXIST)
              {
                printf("[%d]:%d ", i, _table[i]._kv.first);
                //cout << _table[i]._kv.first << ":" << _table[i]._kv.second << endl;
              }
              else
              {
                printf("[%d]:* ", i);
              }
            }
          }
        };
3.1.2 二次探测法
线性探测的优点是实现非常简单,但其缺陷是元素之间相互占用位置导致产生冲突的数据堆积在一块,这与其找下一个空位置有关系,因为找空位置的方式就是挨着往后逐个去找:H_i = (H_0 + i )% m 或 H_i = (H_0 - i )% m
因此二次探测为了避免该问题,找下一个空位置的方法为:H_i = (H_0 + i^2 )% m, 或者 H_i = (H_0 - i^2 )% m或双向二次探测(一正一负)。其中:i =1,2,3…。 H_0是通过散列函数Hashfunc(key)对元素的关键码 key 进行计算得到的位置。m是表的大小。
注意:
- 散列表的大小m必须满足4k+3的质数,否则可能出现周期性的重复,导致散列地址分布集中。
- 采用二次探测法处理冲突的散列表,其载荷因子应该不超过0.5。可以证明,当表的长度m为4k+3的质数且表的载荷因子不超过0.5时,新的表项e一定能够插入,而且任何一个位置不会被探查两次。
将线性探测改为二次探测
    bool insert(const pair<K,V>& kv){
      if(find(kv.first) != nullptr)
        return false;
      //检查载荷因子,进行扩容
      //......
      Hash hash;
      int i = 1;
      int hashi = hash(kv.first)%_table.size();
      //二次探测
      while(_table[hashi]._state == EXIST)
      {
        hashi += i*i; //加i的平方
        hashi %= _table.size();
        ++i;
      }
      _table[hashi]._kv = kv;
      _table[hashi]._state = EXIST;
      ++_size;
      return true;
    }
提示:对应的find函数也应该改为二次探测才能正确运行!
二次探测只能在一定程度上缓解线性探测带来的“洪水效应”,但其终归是占用式的,没有从根源上解决因占用而导致的冲突问题。
3.1.3 双散列法
使用双散列法时,需要两个散列函数。散列函数Hash()按元素的关键码key计算元素所在的桶号H0=Hash(key)。一旦发生冲突,利用再散列函数ReHash()计算该元素到达下一个桶的位移量。它的取值与Key的值有关,要求听他的取值应当是小于地址空间大小m,且与m互质的正整数。
双散列法的探查序列也可以写成:H_i = (Hash(key) + i * ReHash(key)) % m, i = 1, 2, …, m-1
提示:双散列法又被称为伪随机探查法,再散列函数又被称为伪随机数产生器
ReHash()的取法有很多,例如当m是质数时,可定义:
- ReHash(key) = key % (m-1)+1;
- ReHash(key) = (key/m) % (m-2)+1;
当m时2的方幂时,ReHash(key)可取0~m-1中的任意一个奇数。
3.2 开散列
开散列又称链地址法,首先对关键码集合用散列函数计算散列地址,具有相同地址的关键码归于同一子集合,每一个子集合称为一个桶,各个桶中的元素通过一个单链表链接起来,各链表的头结点存储在哈希表中。
仍以2.2中的场景为例:
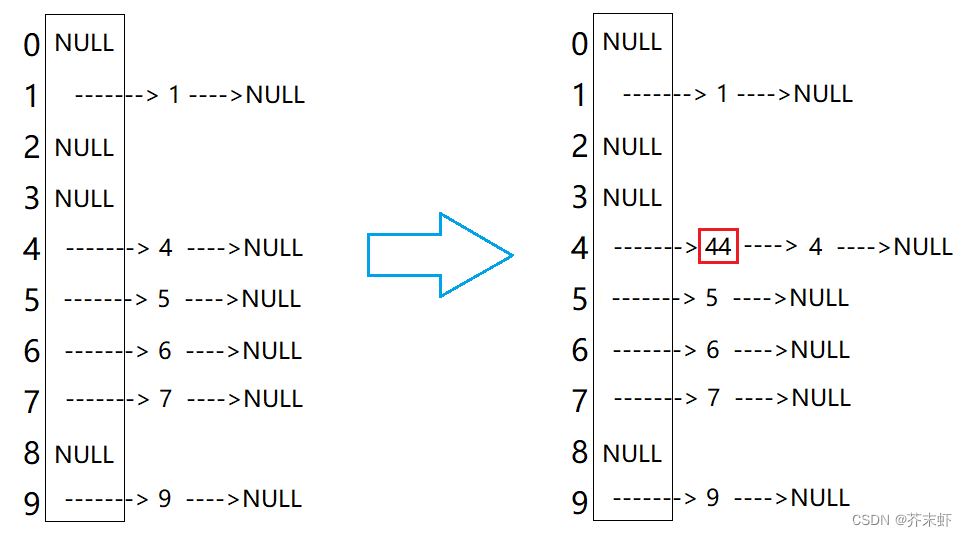
从上图可以看出,开散列中每个桶中放的都是发生哈希冲突的元素。
开散列法的实现
【STL】哈希表 {unordered系列容器的介绍和使用;模拟实现unordered_set和unordered_map}_stl容器unordered的优缺点-CSDN博客
提示:
- C++STL中的std::unordered_map和std::unordered_set底层的哈希结构采用的就是开散列法。
- 有实验统计结果显示:开散列法优于闭散列法;在散列函数中,用除流余数法作散列函数优于其他类型的散列函数。
对比哈希表和红黑树
-
查找
哈希表的查找更快:O(1);红黑树的查找:O(log_2N)
如果某个哈希桶过长(一般不会),可以考虑挂红黑树,以提高该哈希桶的搜索速度。
-
插入
红黑树的插入:消耗主要在查找空位置O(log_2N)+变色O(log_2N)+旋转O(1) ==> O(log_2N)。
哈希表的插入:消耗主要在扩容,不仅要开空间拷贝数据,还要重新计算每个元素的哈希地址。扩容的时间复杂度O(N)
使用rehash/reserve提前开空间,提高哈希表的插入效率。
四、Hash算法
Hash,一般翻译做散列、杂凑,或音译为哈希,是把任意长度的输入通过散列算法变换成固定长度的输出,该输出就是散列值。这种转换是一种压缩映射,也就是,散列值的空间通常远小于输入的空间。
区分哈希函数和哈希算法:
- 哈希函数:哈希函数指将哈希表中元素的关键键(无符号整型)值映射为元素存储位置的函数,其中最典型的就是除留余数法。
- 哈希算法:是一种将任意类型,任意长度的数据压缩到某一固定长度的数据摘要(数据指纹)的算法。
Hash算法的设计原则
- 尽量避免出现key值不同但转换后的无符号整型相同的情况。使不同的key值转换成唯一、独特的无符号整型数据。降低哈希冲突的概率。
Hash算法的特点
- 哈希算法是单向的:不同的输入可能会散列成相同的输出,所以通常不能从散列值来确定唯一的输入值。(但也有特例,逆向Hash技术)
- 哈希值是唯一的:哈希值是一段数据唯一且极其紧凑的数值表示形式。如果散列一段明文而且哪怕只更改该段落的一个字母,随后的哈希都将产生不同的值。出现散列为同一个值的两个不同的输入,概率是极低的。所以数据的哈希值又被称为数据指纹,用于唯一标识数据,检验数据的完整性。一般用于快速查找和加密算法。
Hash算法的用途
- 快速查找:对于类型不匹配或者复杂类型的key值,不能直接求余计算哈希地址。这时我们需要一种算法,将不匹配或复杂类型的key转化为无符号整型,然后才能通过除留余数法计算哈希地址。我们将这样的算法称为Hash算法。
- 数据完整性校验:可以事先对原始数据通过Hash算法计算得到数据指纹,在校验文件时,再对数据进行Hash运算,对比两次运算得到的指纹,如果不相等则数据不完整或是被篡改。
- 网络安全领域:用于数字签名、数字证书(https)等方面,提高数据的安全性和防篡改能力
字符串Hash算法
为什么不选字符串首字母的assic码做key?
- 答:字符的assic码共有128个,而字符串有无数种组合方式。单靠首字母的assic码区分字符串,违背了Hash算法的设计原则。会使哈希冲突的概率变大,所以我们取字符串所有字符的assic码和做key。
仍然无法解决的问题:abcd, acbd, aadd三个字符串的assic码和相同
- 最终方案:BKDR算法,在每次加和时累乘131,能使哈希冲突的概率大大降低。也是Java目前采用的字符串Hash算法。
更多推荐

 10
 0
- 0


 已为社区贡献3条内容

所有评论(0)