
7.10周报 对抗攻击综述阅读笔记 adversarial attacks
论文题目:Advances in Adversarial Attacks and Defenses in Computer Vision: A Survey

一.第一代攻击方法:
1.L-BFGS
L-BFGS是一种拟牛顿算法,用于求解无约束优化问题。它利用梯度信息来逐步逼近目 标函数的极小值点。与传统的梯度下降方法相比,L-BFGS算法在计算逆Hessian矩阵的 过程中利用了有限的内存,从而减少了计算复杂性。
L-BFGS攻击的核心思想是将优化问题转化为一个无约束优化问题,然后使用L-BFGS算 法来近似求解。具体而言,通过引入拉格朗日乘子c,并寻找最小的正数c,使得问题 的最小化器ρ满足约束条件。

2.FGSM攻击
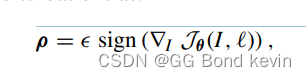
FGSM通过计算输入图像I对损失函数的梯度,然后将梯度的符号函数应用于每个元素,得到一个扰动的方向。符号函数的作用是将梯度的正负信息转换为扰动的方向信息。然后,通过将扰动乘以标量值ε来控制扰动的幅度,生成对抗性扰动ρ。
3.BIM攻击
BIM攻击是迭代的FGSM,通过重复计算来生成对抗图像
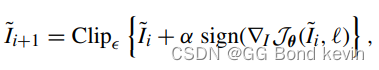
4.PGD攻击
迭代FGSM视为∞范数有界的PGD,模型的对抗训练定义为以下极大极小优化问题
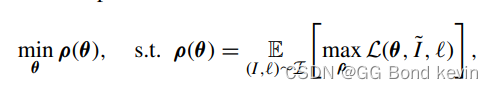
PGD生成的对抗样本更具挑战性,更接近于真实世界中的对抗情况,PGD具有更强的通用性和迁移性,PGD还可以通过调整迭代次数和扰动大小来平衡攻击的效果和可察觉性。
5.JSMA & ONE-PIXEL 攻击
与上面的方法不同,基于雅可比矩阵的攻击和单像素攻击将扰动限制在较小的区域内。
JSMA计算网络的正向梯度来估计扰动,计算公式如下:
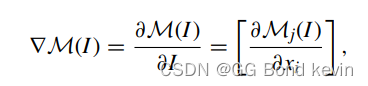
对于单像素攻击,在较小的图像尺寸,比如64*64上更有效。使用了差分进化(DE)来估计要修改的像素在图像中的位置和RGB值,来创建对抗图像。
6.Deepfool攻击
通过求解以下问题来最小化对抗扰动的范数
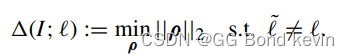
计算具有最小范数的扰动的主要动机是有效地量化目标模型的对抗鲁棒性,其中鲁棒性度量定义为: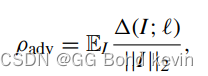
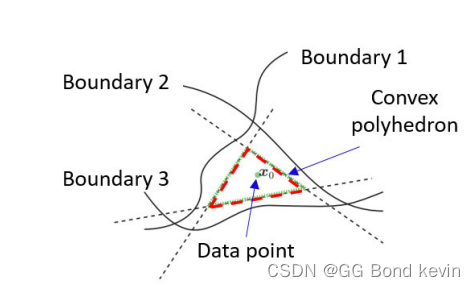
迭代算法在当前图像周围线性化类边界,形成一个凸多面体,并将图像推向最接近的超平面以改变类别标签
7.C&W攻击
C&W攻击是一种基于优化的方法,通过解决一个优化问题,寻找最小的扰动向量,使得扰动图像被误分类为特定的目标类别。C&W攻击通过多次迭代和优化算法来生成对抗样本。C&W攻击采用了不同的范数限制,包括L2、L∞和L0伪范数
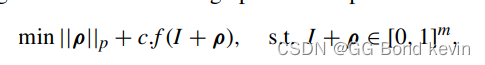
8.UNIVERSAL ADVERSARIAL PERTURBATIONS
上面的方法都是针对特定图像的,通用对抗扰动计算图像无关的扰动,在不同的图像间有迁移性,并旨在满足以下约束条件
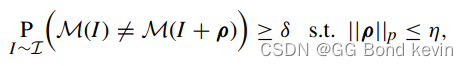
其中P(.)表示概率,I表示干净图像的分布,δ ∈ (0, 1]是预定义的标量,决定了对扰动的可接受欺骗比率。
二.近期对于分类器的攻击
1.高级梯度攻击
2.黑盒攻击
(1)查询式攻击
这些攻击通过查询目标模型并利用其输出来构造对抗性图像。一般来说,它们的目标是在保持模型欺骗的同时实现对抗性样本的最小扭曲。
(2)基于迁移的攻击
在黑盒攻击中,基于迁移的攻击比基于查询的攻击更受欢迎。这是因为基于迁移的攻击不需要查询黑盒模型,因此完全避免了引起怀疑。基于迁移的攻击的核心思想是在本地替代模型上计算扰动,使得这些扰动也能有效地欺骗远程目标模型。
(3)无限制攻击
通过操作图像的颜色和纹理来引入无限制的扰动,使其成为对抗性。据称,这种无限制 的扰动通常对特征压缩、JPEG压缩和对抗性训练等防御手段具有鲁棒性,而特征压缩 和对抗性训练有时对于像FGSM这样的范数约束攻击是有效的。
论文题目:A survey on adversarial attacks and defences
一.根据不同的攻击阶段进行分类
逃避攻击(Evasion attack):这是对抗性环境中最常见的攻击类型。攻击者试图通过在测试阶段调整恶意样本来逃避系统的检测。这种情况下不假设对训练数据有任何影响。
污染攻击(Poisoning attack):这种类型的攻击,也称为训练数据的污染,是在机器学习模型的训练阶段进行的。攻击者试图注入精心设计的样本来污染系统,以破坏整个学习过程。
探索性攻击(Exploratory attack):这些攻击不会对训练数据产生影响。在对模型具有黑盒访问权限的情况下,攻击者试图尽可能多地了解底层系统的学习算法和训练数据中的模式。
二.在训练阶段可以进行的攻击分类
数据注入(Data injection):攻击者既无法访问训练数据,也无法访问学习算法,但可以将新数据添加到训练集中。他可以通过在训练数据集中插入对抗样本来破坏目标模型。
数据修改(Data modification):攻击者无法访问学习算法,但可以完全访问训练数据。他通过在用于训练目标模型的数据之前修改数据来直接污染训练数据。
逻辑破坏(Logic corruption):攻击者可以干扰学习算法的运行。显然,设计针对这些攻击者的对策变得非常困难,因为他们可以更改学习算法的逻辑,从而控制模型本身。
二.测试阶段的攻击
在测试阶段进行的对抗攻击不会干扰目标模型,而是迫使其产生错误的输出。
白盒攻击
在对机器学习模型进行白盒攻击时,攻击者对用于分类的模型拥有完全的知识。
黑盒攻击
黑盒攻击假设对模型没有任何了解。
非自适应黑盒攻击:对于目标模型 f,非自适应黑盒攻击者只能访问模型的训练数据分布。攻击者选择一个模型结构 f0 的训练过程 train0,并使用来自数据分布 μ 的样本训练一个本地模型,以近似目标分类器所学到的模型。
自适应黑盒攻击:攻击者向目标模型发出自适应预言查询,并标记一组精心选择的数据集,即对于任意选择的 x,攻击者通过查询目标模型 f 获取其标签 y。然后,攻击者选择一个过程 train0 和模型结构 f0,使用从查询目标模型获得的元组 (x, y) 训练一个代理模型。代理模型通过使用白盒攻击技术生成对抗样本,迫使目标模型错误分类恶意数据。
严格的黑盒攻击:黑盒攻击者有时可能没有训练数据分布 μ 的信息,但有能力收集目标分类器的输入-输出对 (x, y)。然而,他无法更改输入以观察输出的变化,就像自适应攻击过程那样。这种策略类似于密码学中的已知明文攻击,并且很可能对大量的输入-输出对成功。
三.对抗攻击目标
1.置信度降低:攻击者试图降低目标模型的预测置信度。
2.误分类:攻击者试图将输入示例的输出分类更改为其他类别。
3.有针对性的误分类:攻击者试图以某种方式生成输入,使模型产生特定目标类别的输出。
4.源/目标误分类:攻击者试图将特定输入源分类为预定义的目标类别。
四.探索攻击
1.模型逆推攻击
2.使用API的模型提取
3.推断攻击
五.逃避和中毒攻击
逃避攻击是通过恶意输入迫使模型做出错误的预测并逃避检测。中毒攻击与之不同,输入在训练过程中被修改,并且模型在受污染的输入上进行训练,以获得所需的输出。
六.对抗性示例生成
1 .训练阶段的修改
标签操纵:如果攻击者只能修改训练标签,那么他必须在完全或部分了解学习模型的情况下获取最易受攻击的标签。一种基本的方法是随机扰动标签,即从随机分布中选择新标签作为一部分训练数据的标签。
输入操纵
2.测试阶段生成 白盒攻击:提出了一个通用框架,该框架分为两个阶段:(a) 方向敏感度估计和(b) 扰动选择
更多推荐



 2
 0
- 0


 已为社区贡献2条内容

所有评论(0)