
【Deep learning】房价预测_飞桨_源码_解析
·
目录
运用线性网络结构
0.代码架构
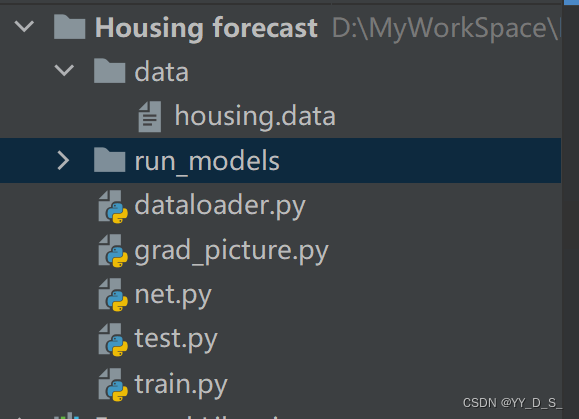
1.数据集dataloader.py
import paddle
from paddle.nn import Linear
import paddle.nn.functional as F
import numpy as np
import os
import random


def load_data():

    ## 从文件导入数据
    datafile = './data/housing.data'
    # np.fromfile(frame, dtype = float, count=-1, sep=’’):
    # frame:文件、字符串;dtype:读取的数据以此类型存储;count:读入元素个数,-1表示读入整个文件;sep: 数据分割字符串,如果是空串,写入文件为二进制
    data = np.fromfile(datafile, sep=' ', dtype=np.float32)

    ## 数据形状变换
    # 每条数据包括14项,其中前面13项是影响因素,第14项是相应的房屋价格中位数
    feature_names = ['CRIM', 'ZN', 'INDUS', 'CHAS', 'NOX', 'RM', 'AGE',
                     'DIS', 'RAD', 'TAX', 'PTRATIO', 'B', 'LSTAT', 'MEDV']
    feature_num = len(feature_names)
    # 将原始数据进行Reshape,变成[N, 14]这样的形状
    data = data.reshape([data.shape[0] // feature_num, feature_num])

    ## 数据划分
    # 将原数据集拆分成训练集和测试集
    # 这里使用80%的数据做训练,20%的数据做测试
    # 测试集和训练集必须是没有交集的
    ratio = 0.8
    offset = int(data.shape[0] * ratio)
    training_data = data[:offset]

    ## 数据归一化
    # 计算train数据集的最大值,最小值,平均值
    maximums, minimums, avgs = training_data.max(axis=0), training_data.min(axis=0), \
                               training_data.sum(axis=0) / training_data.shape[0]

    # 记录数据的归一化参数,在预测时对数据做归一化
    global max_values # global 相当于定义一个全局变量,在函数中可以改变值
    global min_values
    global avg_values
    max_values = maximums
    min_values = minimums
    avg_values = avgs

    # 对数据进行归一化处理
    for i in range(feature_num):
        data[:, i] = (data[:, i] - avgs[i]) / (maximums[i] - minimums[i])

    # 训练集和测试集的划分比例
    training_data = data[:offset]
    test_data = data[offset:]
    return training_data, test_data,max_values,min_values,avg_values

# 验证数据集读取程序的正确性
training_data, test_data,max_values,min_values,avg_values = load_data()
print('The shape of training data:')
print(training_data.shape)
print('Training data:')
print(training_data[1,:])
2.模型 net.py
import paddle
from paddle.nn import Linear
import paddle.nn.functional as F
import numpy as np
import os
import random
import dataloader

# 线性回归网络结构,继承paddle.nn.Layer父类
class Regressor(paddle.nn.Layer):

    # self代表类的实例自身
    def __init__(self):
        # 初始化父类中的一些参数
        super(Regressor, self).__init__()
        # 定义一层全连接层,输入维度是13,输出维度是1
        self.fc = Linear(in_features=13, out_features=1)

    # 网络的前向计算
    # 框架指定,在调用模型实例时会自动执行
    def forward(self, inputs):
        x = self.fc(inputs)
        return x

# # 具体模型结构
# class Network(object):
#     def __init__(self, num_of_weights):
#         # 随机产生w的初始值
#         # 为了保持程序每次运行结果的一致性,此处设置固定的随机数种子
#         np.random.seed(0)
#         self.w = np.random.randn(num_of_weights, 1) # randn产生[0,1),参数为不同维度,返回指定维度的array
#         self.b = 0.
#
#     # 前向传播
#     def forward(self, x):
#         z = np.dot(x, self.w) + self.b # 线性模型
#         return z
#
#     #均方损失函数
#     def loss(self, z, y):
#         error = z - y
#         cost = error * error
#         cost = np.mean(cost) # mean求取均值
#         return cost
#
#     # 梯度计算
#     def gradient(self, x, y):
#         z = self.forward(x) # 线性模型
#         N = x.shape[0]
#         gradient_w = 1. / N * np.sum((z - y) * x, axis=0) # w的梯度计算,即gradient_w = (z-y)*x &= np.mean(gradient_w, axis=0)
#         gradient_w = gradient_w[:, np.newaxis] # gradient_w和w保持一致的形状(13,1)。np.newaxis:插入新维度
#         gradient_b = 1. / N * np.sum(z - y) # b的梯度计算
#         return gradient_w, gradient_b
#
#     # 梯度更新
#     # eta:移动步长
#     def update(self, gradient_w, gradient_b, eta=0.01):
#         self.w = self.w - eta * gradient_w # 更新参数
#         self.b = self.b - eta * gradient_b
#
#     def train(self, training_data, num_epochs, batch_size=10, eta=0.01):
#         n = len(training_data)
#         losses = [] # 存放每次训练的损失
#         for epoch_id in range(num_epochs): # 遍历每个小批量数据
#             # 在每轮迭代开始之前,将训练数据的顺序随机打乱
#             # 然后再按每次取batch_size条数据的方式取出
#             np.random.shuffle(training_data) # 随机打乱顺序
#             # 将训练数据进行拆分,每个mini_batch包含batch_size条的数据
#             mini_batches = [training_data[k:k + batch_size] for k in range(0, n, batch_size)]
#             for iter_id, mini_batch in enumerate(mini_batches): # 小批量中循环数据
#                 x = mini_batch[:, :-1]
#                 y = mini_batch[:, -1:]
#                 z = self.forward(x)
#                 loss = self.loss(z, y)
#                 gradient_w, gradient_b = self.gradient(x, y) # 计算梯度
#                 self.update(gradient_w, gradient_b, eta) # 更新梯度
#                 losses.append(loss)
#                 print('Epoch {:3d} / iter {:3d}, loss = {:.4f}'.
#                       format(epoch_id, iter_id, loss))
#
#         return losses
#
#
# ## 测试模型
# # 获取数据
# training_data, test_data = dataloader.load_data()
# x = training_data[:, :-1]
# y = training_data[:, -1:]
# # 调用模型
# print('\nTest model:')
# net = Network(13)
# # 此处可以一次性计算多个样本的预测值和损失函数
# x1 = x[0:3]
# y1 = y[0:3]
# z = net.forward(x1)
# print('predict: ', z)
# loss = net.loss(z, y1)
# print('loss:', loss)
4.训练train.py
import numpy as np
import paddle
from paddle.nn import Linear
import paddle.nn.functional as F
import os
import random

import dataloader
import net

# 声明定义好的线性回归模型
model = net.Regressor()
# 开启模型训练模式
model.train()
# 加载数据
training_data, test_data,max_values,min_values,avg_values = dataloader.load_data()
# 定义优化算法,使用随机梯度下降SGD
# 学习率设置为0.01
opt = paddle.optimizer.SGD(learning_rate=0.01, parameters=model.parameters())

EPOCH_NUM = 10  # 设置外层循环次数
BATCH_SIZE = 10  # 设置batch大小

# 定义外层循环
for epoch_id in range(EPOCH_NUM): # 遍历所有划分的小块
    # 在每轮迭代开始之前,将训练数据的顺序随机的打乱
    np.random.shuffle(training_data)
    # 将训练数据进行拆分,每个batch包含10条数据
    mini_batches = [training_data[k:k + BATCH_SIZE] for k in range(0, len(training_data), BATCH_SIZE)]
    # 定义内层循环
    for iter_id, mini_batch in enumerate(mini_batches): # 遍历每个小块里的数据
        x = np.array(mini_batch[:, :-1])  # 获得当前批次训练数据
        y = np.array(mini_batch[:, -1:])  # 获得当前批次训练标签(真实房价)
        # 将numpy数据转为tensor格式
        house_features = paddle.to_tensor(x)
        prices = paddle.to_tensor(y)

        # 前向计算
        predicts = model(house_features)

        # 计算损失
        loss = F.square_error_cost(predicts, label=prices)
        avg_loss = paddle.mean(loss)
        if iter_id % 20 == 0:
            print("epoch: {}, iter: {}, loss is: {}".format(epoch_id, iter_id, avg_loss.numpy()))

        # 反向传播,计算每层参数的梯度值
        avg_loss.backward()
        # 更新参数,根据设置好的学习率迭代一步
        opt.step()
        # 清空梯度变量,以备下一轮计算
        opt.clear_grad()

# 保存模型参数,文件名为LR_model.pdparams
# .state_dict()保存模型中训练出的所有参数
paddle.save(model.state_dict(), './run_models/LR_model.pdparams')
print("Save model at LR_model.pdparams!")
5.测试test.py
import numpy as np
import paddle
from paddle.nn import Linear
import paddle.nn.functional as F
import os
import random

import dataloader
import net

# 从dataloader中已加载的测试集中,随机选择一条作为测试数据
def test_all():
    # 遍历每个测试数据
    for idx in range(test_data.shape[0]):
        print(f"The {idx} test:")
        one_data, label = test_data[idx, :-1], test_data[idx, -1]
        # 修改该条数据shape为[1,13]
        one_data =  one_data.reshape([1,-1])
        # 将数据转为tensor格式
        one_data = paddle.to_tensor(one_data)
        predict = model(one_data)

        # 对结果做反归一化处理
        predict = predict * (max_values[-1] - min_values[-1]) + avg_values[-1]
        # 对label数据做反归一化处理
        label = label * (max_values[-1] - min_values[-1]) + avg_values[-1]

        print("Inference result is {}, the corresponding label is {}".format(predict.numpy(), label))


model = net.Regressor()
training_data, test_data,max_values,min_values,avg_values = dataloader.load_data()


# 参数为保存模型参数的文件地址
model_dict = paddle.load('./run_models/LR_model.pdparams')
model.load_dict(model_dict)
model.eval() # 模型的状态调整为eval()(校验)

print('/nStart test!')
# 参数为数据集的文件地址
test_all()
6.可视化结果
# 训练目标:到一个参数解w和b,使得损失函数取得极小值
import paddle
from paddle.nn import Linear
import paddle.nn.functional as F
import numpy as np
import os
import random
import dataloader
import net

training_data, test_data = dataloader.load_data()
x = training_data[:, :-1]
y = training_data[:, -1:]
net = model.Network(13)
losses = []
#只画出参数w5和w9在区间[-160, 160]的曲线部分,以及包含损失函数的极值
w5 = np.arange(-160.0, 160.0, 1.0)
w9 = np.arange(-160.0, 160.0, 1.0)
losses = np.zeros([len(w5), len(w9)])

#计算设定区域内每个参数取值所对应的Loss
for i in range(len(w5)):
    for j in range(len(w9)):
        net.w[5] = w5[i]
        net.w[9] = w9[j]
        z = net.forward(x)
        loss = net.loss(z, y)
        losses[i, j] = loss

#使用matplotlib将两个变量和对应的Loss作3D图
import matplotlib.pyplot as plt
from mpl_toolkits.mplot3d import Axes3D
# figure(num=None, figsize=None, dpi=None, facecolor=None, edgecolor=None, frameon=True)
# num:图像名称。figsize:宽和高。dpi:分辨率。facecolor:背景颜色。edgecolor:边框颜色。frameon:是否显示边框。
fig = plt.figure()# 自定义图像
ax = Axes3D(fig) # 3D图
w5, w9 = np.meshgrid(w5, w9) # 从坐标向量中返回坐标矩阵
ax.plot_surface(w5, w9, losses, rstride=1, cstride=1, cmap='rainbow') # 设计图像
plt.show()更多推荐


 1
 0
- 0


 已为社区贡献4条内容

所有评论(0)