
leetcode:存在重复元素
存在重复元素
leetcode链接:217. 存在重复元素
给定一个整数数组,判断是否存在重复元素。
如果任意一值在数组中出现至少两次,函数返回 true 。如果数组中每个元素都不相同,则返回 false 。
示例1:
输入: [1,2,3,1]
输出: true
示例2:
输入: [1,2,3,4]
输出: false
示例3:
输入: [1,1,1,3,3,4,3,2,4,2]
输出: true
这题的思路很简单,利用set函数即可去重代码也非常简单这里举两个版本
    # 代码1
    def containsDuplicate(self, nums: List[int]) -> bool:
        a = set()
        for i in nums:
            if i not in a:
                a.add(i)
            else:
                return True
        return False
    # 代码2
    def containsDuplicate(self, nums: List[int]) -> bool:
        return len(nums) != len(set(nums))
这里不说这个题目,而是跳出这个题目来说说下面几个问题:
1.用list与set来分别存储元素,然后利用内置函数in的查找时间复杂度相同么?
2.set函数与list相互转化后是咋样的?
1.List与set的速度比拼
对于一个小白来说,存储元素首先想到的是list,但是别忘了,python中还有许多数据结构可以用来线型或者非线性的存储元素,比如链表和set集合。这里不说其他的,就来单单比较一下list和set函数他们的内置函数in速度之差别。
我们利用time函数来记录时间。
# -*- coding: utf-8 -*-
import time
import random

l = [random.randrange(0, 1000000) for x in range(0, 1000000)]
s = {x for x in range(0, 1000000)}

print('set size=', len(s))
# 测试 list,搜索 1000次,看花费时间
start_time = time.time()
for i in range(0, 1000):
    x = random.randrange(0, 1000000)
    b = x in l
print('list index of time:', time.time() - start_time)

# 测试 list,搜索 1000次,看花费时间
start_time = time.time()
for i in range(0, 1000):
    x = random.randrange(0, 1000000)
    b = x in s
print('set index of time:', time.time() - start_time)
下面是在我电脑上运行的结果,测试环境和条件:windows7+py3.7+pycharm2020.1,list和set都是随机的填写100万条数据,搜索一千次,记录各自的损耗时间:
set size= 1000000
list index of time: 58.220329999923706
set index of time: 0.014000892639160156
从上面我们可以看出,一个1000000量数据的list与set对比,set的查找速度是list的4158倍,可想而知如果我们将上面代码中的set换成list程序可能会耗死。而实际也是如此,下面两张图是分别用list和set的提交结果。
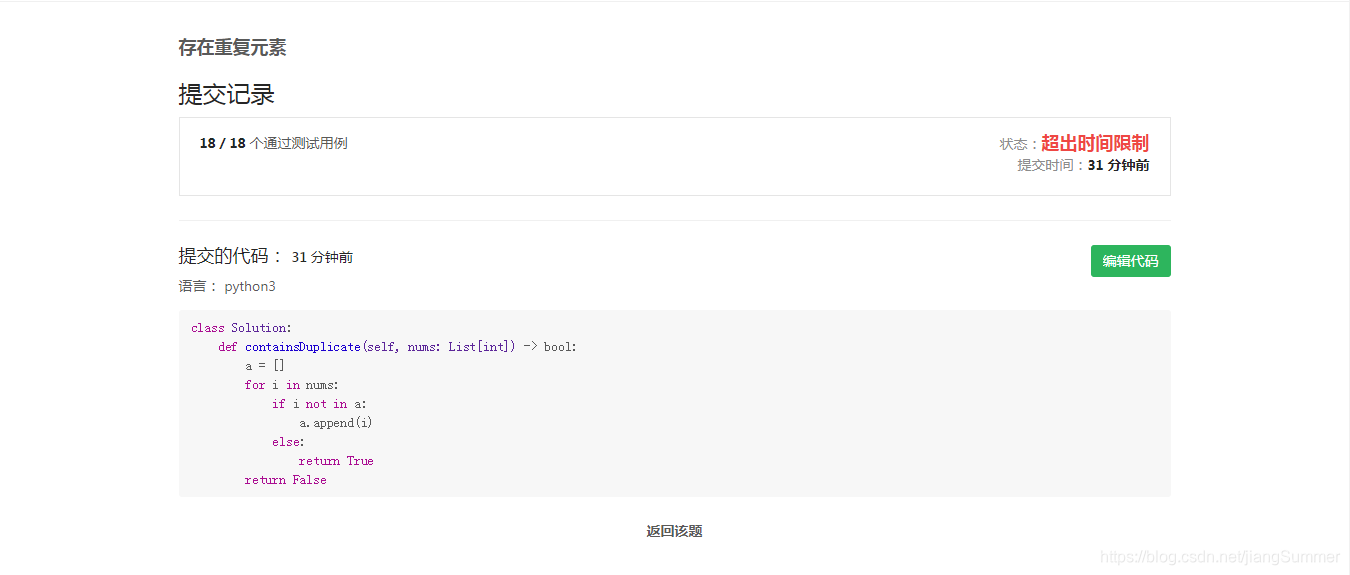
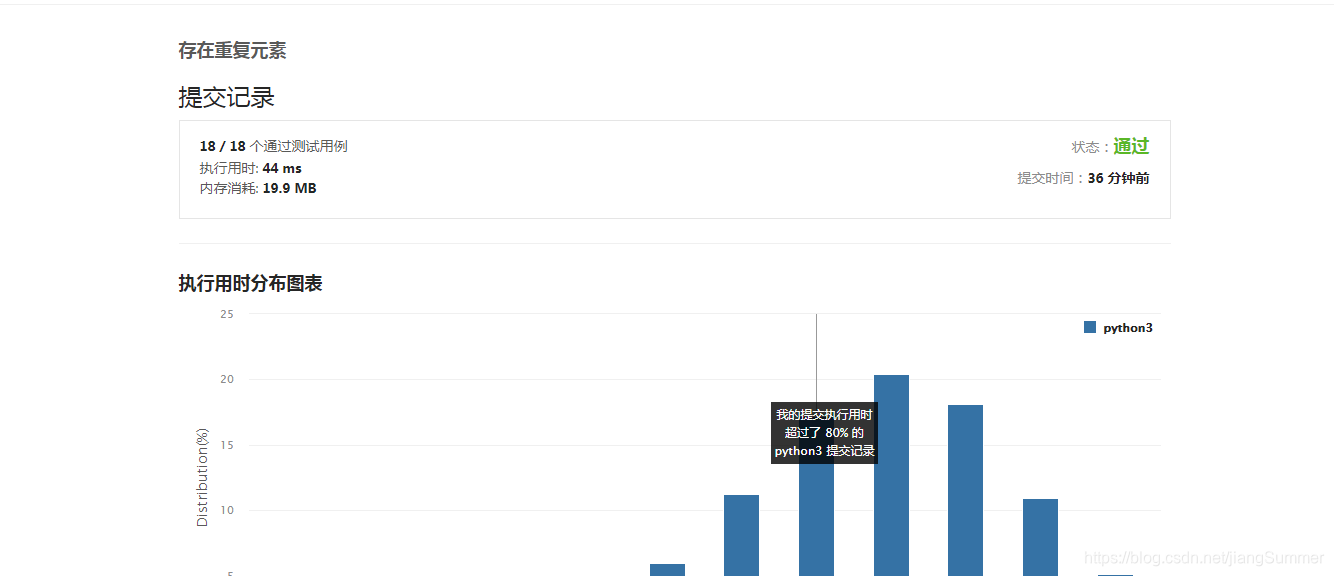
其实python中的set我们称之为哈希集合,即他的存储方式是利用特定的函数来实现的(类似字典)因此查找速度可以达到O(1)。
2.set函数与list相互转化
我们知道list可以通过set函数变成集合类型,同时集合也可以通过list函数变成列表类型那么列表经过set之后再转回list会变么?
a1 = [1, 2, 3, 4, 5, 6, 7, 8]
b1 = set(a1)
c1 = list(b1)
print(a1)
print(b1)
print(c1)
print(a1 == c1)
a2 = [1, 5, 2, 7, 5, 2, 5, 9, 7, 4, 2, 4, 7, 9, 6, 4, 32]
b2 = set(a2)
c2 = list(b2)
print(a2)
print(b2)
print(c2)
print(a2 == c2)
a3 = {1, 6, 3, 21, 3, 84, 2, 23, 8, 8545, 3, 1, 3, 427, 344, 23, 13, 125}
b3 = list(a3)
c3 = set(b3)
print(a3)
print(b3)
print(c3)
print(a3 == c3)
a4 = {1, 2, 3, 4, 5, 6, 7, 7, 7, 8, 9, 9, 1, 2, 3, 4, 5, 6}
b4 = list(a4)
c4 = set(b4)
print(a4)
print(b4)
print(c4)
print(a4 == c4)
运行结果:
[1, 2, 3, 4, 5, 6, 7, 8]
{1, 2, 3, 4, 5, 6, 7, 8}
[1, 2, 3, 4, 5, 6, 7, 8]
True
[1, 5, 2, 7, 5, 2, 5, 9, 7, 4, 2, 4, 7, 9, 6, 4, 32]
{32, 1, 2, 4, 5, 6, 7, 9}
[32, 1, 2, 4, 5, 6, 7, 9]
False
{1, 2, 3, 8545, 6, 8, 427, 13, 84, 21, 23, 344, 125}
[1, 2, 3, 8545, 6, 8, 427, 13, 84, 21, 23, 344, 125]
{1, 2, 3, 8545, 6, 8, 427, 13, 84, 21, 23, 344, 125}
True
{1, 2, 3, 4, 5, 6, 7, 8, 9}
[1, 2, 3, 4, 5, 6, 7, 8, 9]
{1, 2, 3, 4, 5, 6, 7, 8, 9}
True
从上面可以得出,对于一个升序列表,在set转化之后,他会保持原样的状态转化为set类型,然后在通过list转回来之后,该列表的顺序是不变的。但是如果该列表是一个打乱的顺序,那么在经过set函数之后,他会重新进行调整顺序,在经过list之后的列表已经和原来的列表不一样了。因此如果上面的函数变成下面这样,就会在一定条件下不能完成:
    def containsDuplicate(self, nums: List[int]) -> bool:
        new_num = list(set(nums))
        return new_num != nums
以上是写这题得到的一些经验,希望对大家有用。
更多推荐

 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)