
使用Ragas为RAG生成测试集,评估RAG系统在特定文档的表现_ragas 图谱
测试集是用于评估模型性能的数据集,它不参与模型的训练过程,而是用于在模型训练完成后测试其准确性和泛化能力。
这篇文章介绍如何使用Ragas框架创建一个测试集,以便可以评估自己的RAG系统在处理特定文档时的表现。通过使用自己的文档生成测试集,可以确保测试集与RAG具体应用场景紧密相关,从而更准确地评估RAG系统的效果。
使用方法
Ragas提供了从加载文档、选择语言模型(LLM)、生成测试集到导出结果的全链路支持。

安装依赖包
文章首先指导用户如何安装必要的包,并提供了一个快速示例,展示如何为RAG流水线生成测试集。
pip install langchain-openai
pip install langchain-aws
pip install ragas
加载样本文档
通过git克隆样本文档,并使用DirectoryLoader加载文档,用户可以替换为自己的文档。
git clone https://huggingface.co/datasets/explodinggradients/Sample_Docs_Markdown
使用langchain_community的DirectoryLoader加载器从样本数据集中加载文档。
from langchain_community.document_loaders import DirectoryLoader

path = "Sample_Docs_Markdown/"
loader = DirectoryLoader(path, glob="**/*.md")
docs = loader.load()
你也可以使用llama_index中的任何加载器加载文档,例如使用SimpleDirectoryReader:
from llama_index.core import SimpleDirectoryReader
path = "Sample_Docs_Markdown/"
docs = SimpleDirectoryReader(path).load_data()
选择LLM
Ragas需要利用大型语言模型(LLM)和嵌入模型来合成测试数据。可以选择OpenAI、Amazon Bedrock、Azure OpenAI等LLM供应商提供的模型。Ragas集成了Langchain和Llamaindex框架。可以通过他们更好的和模型交互。
如果使用OpenAI的模型,并且使用Langchain框架进行调用,则需要安装langchain-openai包,这是一个通过Langchain框架与OpenAI模型进行交互的包。
pip install langchain-openai
接着,配置OpenAI密钥。
import os
os.environ["OPENAI_API_KEY"] = "your-openai-key"
将大型语言模型(LLMs)封装在LangchainLLMWrapper这个包装器中,以便它们可以与ragas集成。
from ragas.llms import LangchainLLMWrapper
from langchain_openai import ChatOpenAI
from langchain_openai import OpenAIEmbeddings
generator_llm = LangchainLLMWrapper(ChatOpenAI(model="gpt-4o"))
generator_embeddings = LangchainEmbeddingsWrapper(OpenAIEmbeddings())
如果使用其他模型供应商的模型,将ChatOpenAI(model="gpt-4o")换成你的模型实例即可。例如使用通义千问大模型:
import os
os.environ["DASHSCOPE_API_KEY"] = "sk-"

from langchain_community.llms import Tongyi
llm = Tongyi(
    model="qwen-max",
    # top_p="...",
    # api_key="...",
    # other params...
)
generator_llm = LangchainLLMWrapper(llm)
这里需要安装pip install dashscope。
如果你使用LlamaIndex框架而不是Langchain与大模型交互,将LangchainLLMWrapper替换成LlamaIndexLLMWrapper 即可。
生成测试集
使用加载的文档和设置好的LLM运生成测试数据集
from ragas.testset import TestsetGenerator

generator = TestsetGenerator(llm=generator_llm,
                            embedding_model=generator_embeddings)
dataset = generator.generate_with_langchain_docs(docs, testset_size=10)
testset_size指定生成的测试集的大小为10。
如果你前面使用的是llama_index的工具来加载文档,那么你应该使用generate_with_llama_index_docs这个方法来代替generate_with_langchain_docs。
dataset = generator.generate_with_llama_index_docs(docs, testset_size=10)
导出测试集
生成的测试集可以导出并进行检查。
dataset.to_pandas()
工作原理
在生成测试集的过程中,Ragas有两个主要的操作:
- \1. 知识图谱创建(KnowledgeGraph Creation):使用你提供的文档创建一个知识图谱,并使用各种转换(Transformations)来丰富知识图谱,添加额外的信息,这些信息将用于生成测试集。
- \2. 测试集生成(Testset Generation):使用知识图谱生成一组场景(scenarios),这些场景将被用来生成测试集。
下面详细介绍一下这两个过程的实现。
知识图谱创建
通过提供文档创建知识图谱,并使用Transformations丰富知识图谱。
from ragas.testset.graph import KnowledgeGraph
kg = KnowledgeGraph()
初始时,这个知识图谱没有任何节点(nodes)和关系(relationships)。
- \1. 添加文档到知识图谱:
遍历之前加载的文档(docs),为每个文档创建一个Node实例,并将其添加到知识图谱的节点列表中。
from ragas.testset.graph import Node, NodeType
for doc in docs:
    kg.nodes.append(
        Node(
            type=NodeType.DOCUMENT,
            properties={"page_content": doc.page_content, "document_metadata": doc.metadata}
        )
    )
每个节点都被标记为NodeType.DOCUMENT类型,并包含两个属性:page_content(文档的内容)和document_metadata(文档的元数据)。在添加文档后,知识图谱的状态更新为包含多个节点(nodes)和0个关系(relationships),因为目前只是简单地将文档作为节点添加到图中,还没有定义任何节点之间的关系。
- \2. 使用变换丰富知识图谱
通过变换(Transformations)丰富知识图谱(KnowledgeGraph)的信息。
from ragas.testset.transforms import default_transforms, apply_transforms


# define your LLM and Embedding Model
# here we are using the same LLM and Embedding Model that we used to generate the testset
transformer_llm = generator_llm
embedding_model = generator_embeddings

trans = default_transforms(llm=transformer_llm, embedding_model=embedding_model)
apply_transforms(kg, trans)
通过调用default_transforms函数并传入LLM和嵌入模型,创建了一个变换集合trans。然后,使用apply_transforms函数将这些变换应用到知识图谱kg上。
- \3. 保存和加载知识图谱
知识图谱丰富完成后,将知识图谱保存为JSON文件。
kg.save("knowledge_graph.json")
使用kg.save("knowledge_graph.json")将知识图谱保存为JSON文件。
随后,可以使用KnowledgeGraph.load()来加载这个保存的知识图谱。
loaded_kg = KnowledgeGraph.load("knowledge_graph.json")
loaded_kg
查看加载之后知识图谱的状态,会包含多个节点和多个关系。这表明知识图谱已经被成功地丰富了。
使用知识图谱生成测试集
- \1. 创建TestsetGenerator实例:
加载之前生成的知识图谱loaded_kg和generator_llm(之前设置的LLM)来创建一个TestsetGenerator实例。这个实例将用于生成测试集。
from ragas.testset import TestsetGenerator
generator = TestsetGenerator(llm=generator_llm, knowledge_graph=loaded_kg)
- \2. 定义查询分布:
查询分布(query distribution)是指在生成测试集时,不同类型的查询按照一定的概率分布被选取的模式。在机器学习和自然语言处理中,特别是在构建测试集时,查询分布可以确保测试集的多样性和代表性,从而更好地评估模型的性能。
from ragas.testset.synthesizers import default_query_distribution
query_distribution = default_query_distribution(generator_llm)
Ragas默认使用default_query_distribution生成查询分布。它包括三种类型的查询合成器,每种都有不同的权重:
- •
SingleHopSpecificQuerySynthesizer:单跳具体查询合成器,权重为0.5。 - •
MultiHopAbstractQuerySynthesizer:多跳抽象查询合成器,权重为0.25。 - •
MultiHopSpecificQuerySynthesizer:多跳具体查询合成器,权重为0.25。
权重表示在生成数据集时,它们被选中的概率。这些查询合成器负责生成不同类型的查询,而它们的概率则决定了在生成测试集时,每种类型的查询被生成的频率。这样做的目的是为了模拟真实世界中查询的多样性,以及确保测试集能够覆盖不同的查询类型。
通过这种方式,query_distribution定义了一个生成测试集时的查询生成策略,确保了测试集中包含了不同类型和难度的查询,从而可以更全面地评估模型的性能。
- \3. 生成测试集:
使用TestsetGenerator实例的generate方法来生成测试集。
testset = generator.generate(testset_size=10, query_distribution=query_distribution)
testset.to_pandas()
这将生成一个包含10个测试案例的测试集,并且将测试集转换为Pandas DataFrame,以便进行进一步的检查和分析。
如何学习AI大模型?
大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。
不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!
想正式转到一些新兴的 AI 行业,不仅需要系统的学习AI大模型。同时也要跟已有的技能结合,辅助编程提效,或上手实操应用,增加自己的职场竞争力。
但是LLM相关的内容很多,现在网上的老课程老教材关于LLM又太少。所以现在小白入门就只能靠自学,学习成本和门槛很高
那么针对所有自学遇到困难的同学们,我帮大家系统梳理大模型学习脉络,将这份 LLM大模型资料 分享出来:包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓
👉[CSDN大礼包🎁:全网最全《LLM大模型入门+进阶学习资源包》免费分享(安全链接,放心点击)]()👈
学习路线
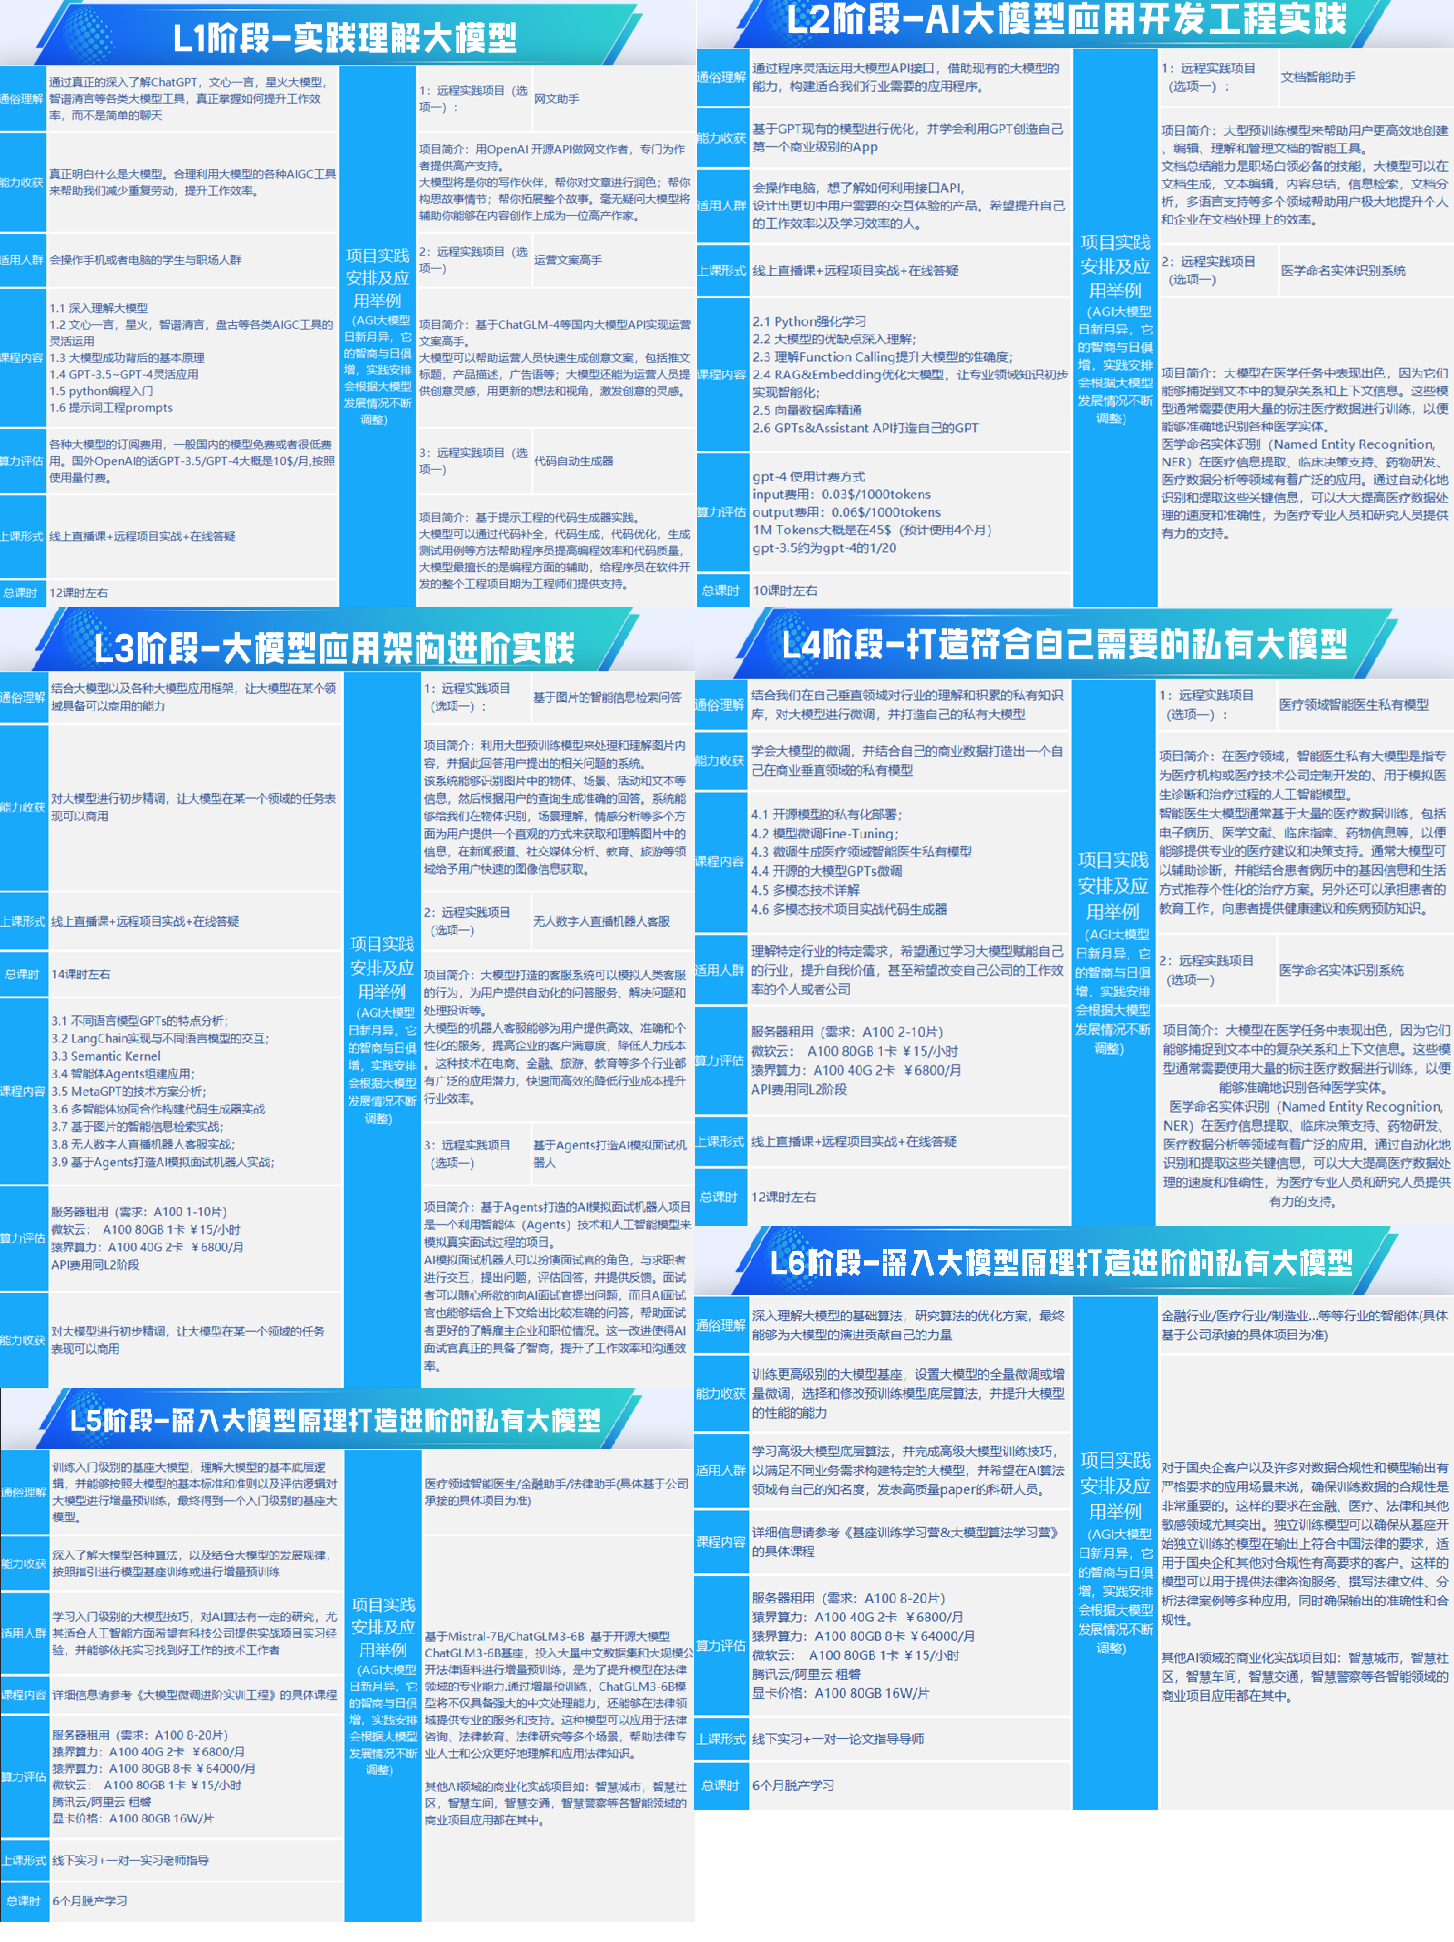
第一阶段: 从大模型系统设计入手,讲解大模型的主要方法;
第二阶段: 在通过大模型提示词工程从Prompts角度入手更好发挥模型的作用;
第三阶段: 大模型平台应用开发借助阿里云PAI平台构建电商领域虚拟试衣系统;
第四阶段: 大模型知识库应用开发以LangChain框架为例,构建物流行业咨询智能问答系统;
第五阶段: 大模型微调开发借助以大健康、新零售、新媒体领域构建适合当前领域大模型;
第六阶段: 以SD多模态大模型为主,搭建了文生图小程序案例;
第七阶段: 以大模型平台应用与开发为主,通过星火大模型,文心大模型等成熟大模型构建大模型行业应用。
👉学会后的收获:👈
• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;
• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;
• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;
• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。
1.AI大模型学习路线图
2.100套AI大模型商业化落地方案
3.100集大模型视频教程
4.200本大模型PDF书籍
5.LLM面试题合集
6.AI产品经理资源合集
👉获取方式:
😝有需要的小伙伴,可以保存图片到wx扫描二v码免费领取【保证100%免费】🆓
更多推荐


 18
 0
- 0


 已为社区贡献4条内容

所有评论(0)