
跟着小土堆学习pytorch(一)
跟着【小土堆】学习pytorch
pytorch的安装
- 首先,安装Anaconda
这个之前已经安装过了,我直接跟着up主安装pytorch - 安装pytorch
-
打开Anaconda Prompt
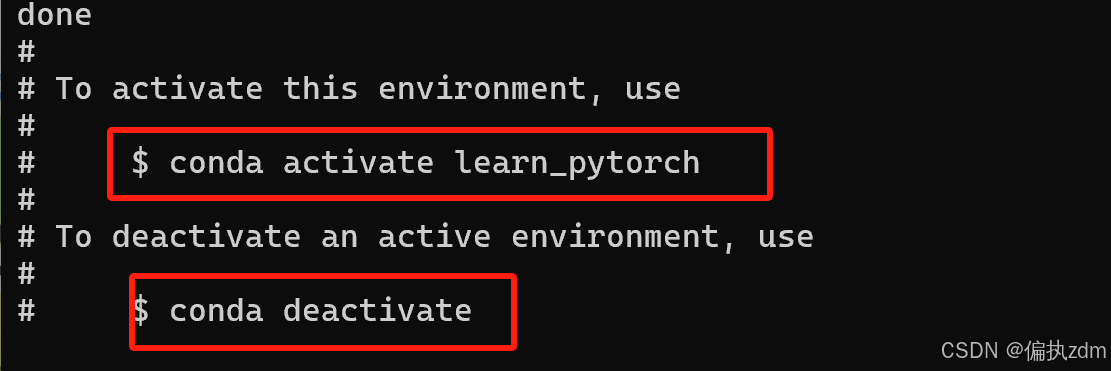
一开始是在base环境,可以使用conda create -n learn_pytorch python=3.6来进行创建一个新的环境。创建完毕之后如下图所示:
-
使用
conda activate learn_pytorch激活环境 -
接下来就是安装pytorch
进入pytorch官网,如下图所示可以通过选择相关版本来生成命令进行安装(很不幸我的电脑并没有英伟达的独显,先用CPU跑着吧)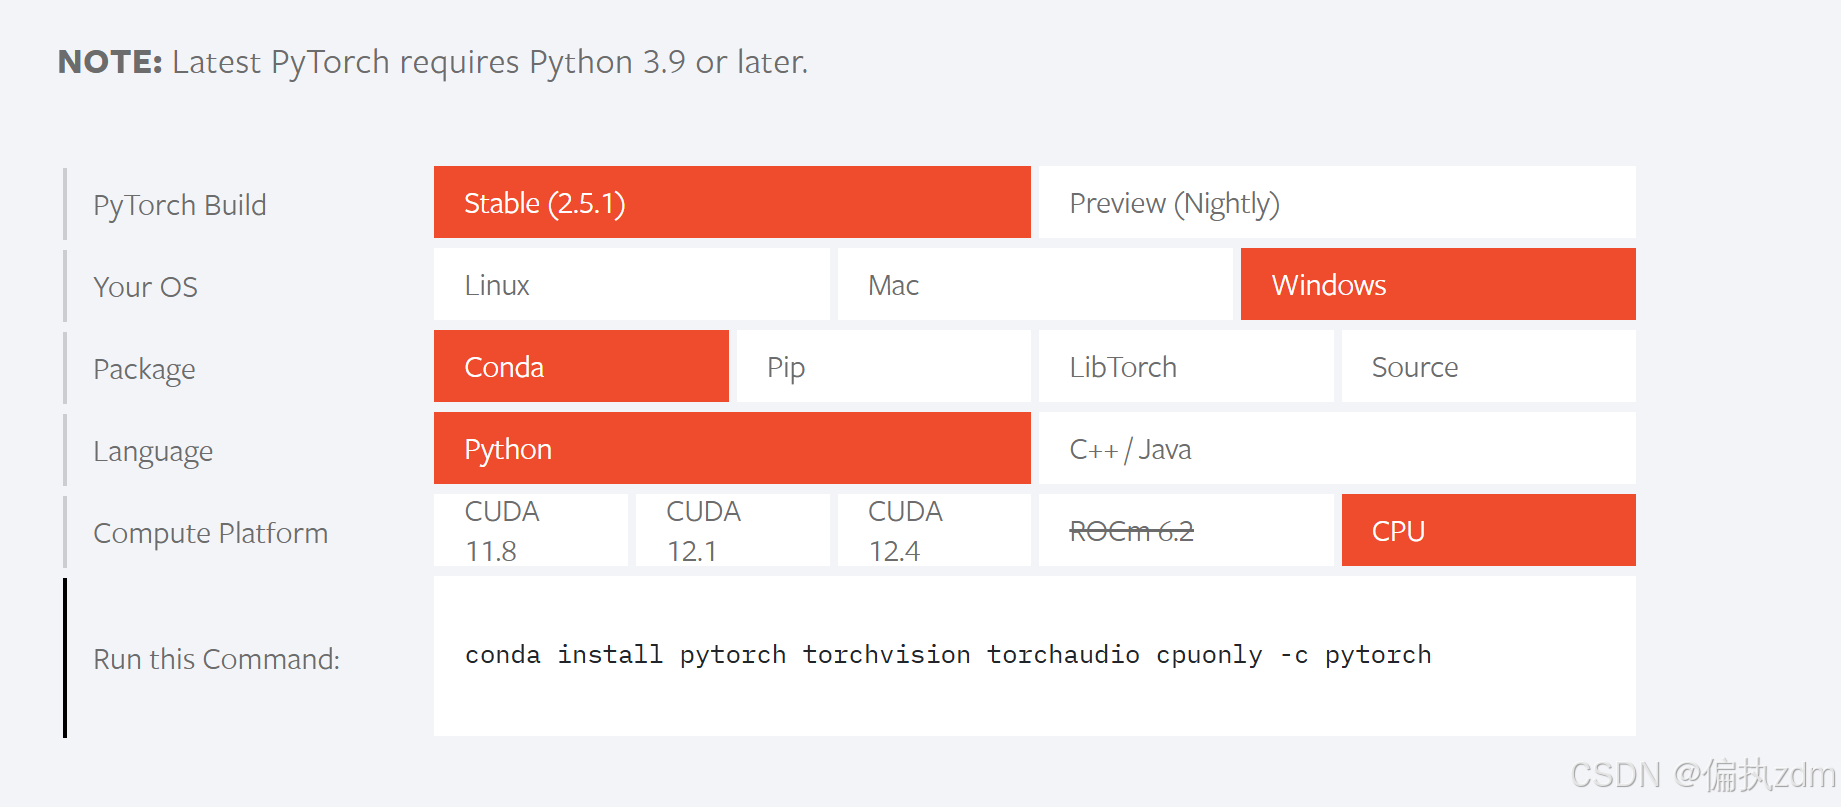
接下来就将刚刚的命令输入进行安装。安装完毕就可以使用pip list来查看安装的包。
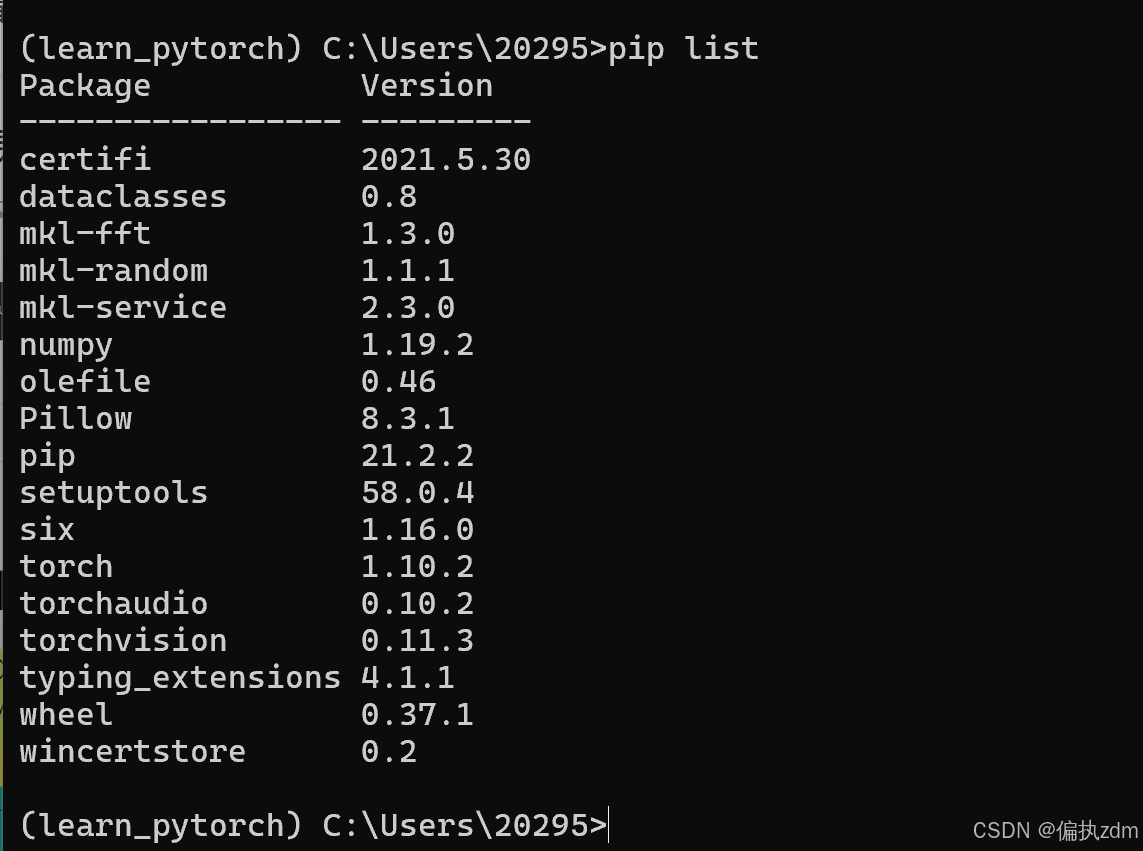
-
到这里pytorch就安装完成了。
PyCharm 的安装
进入官网:https://www.jetbrains.com/pycharm/ 跟着up主下载了19.2.4的版本
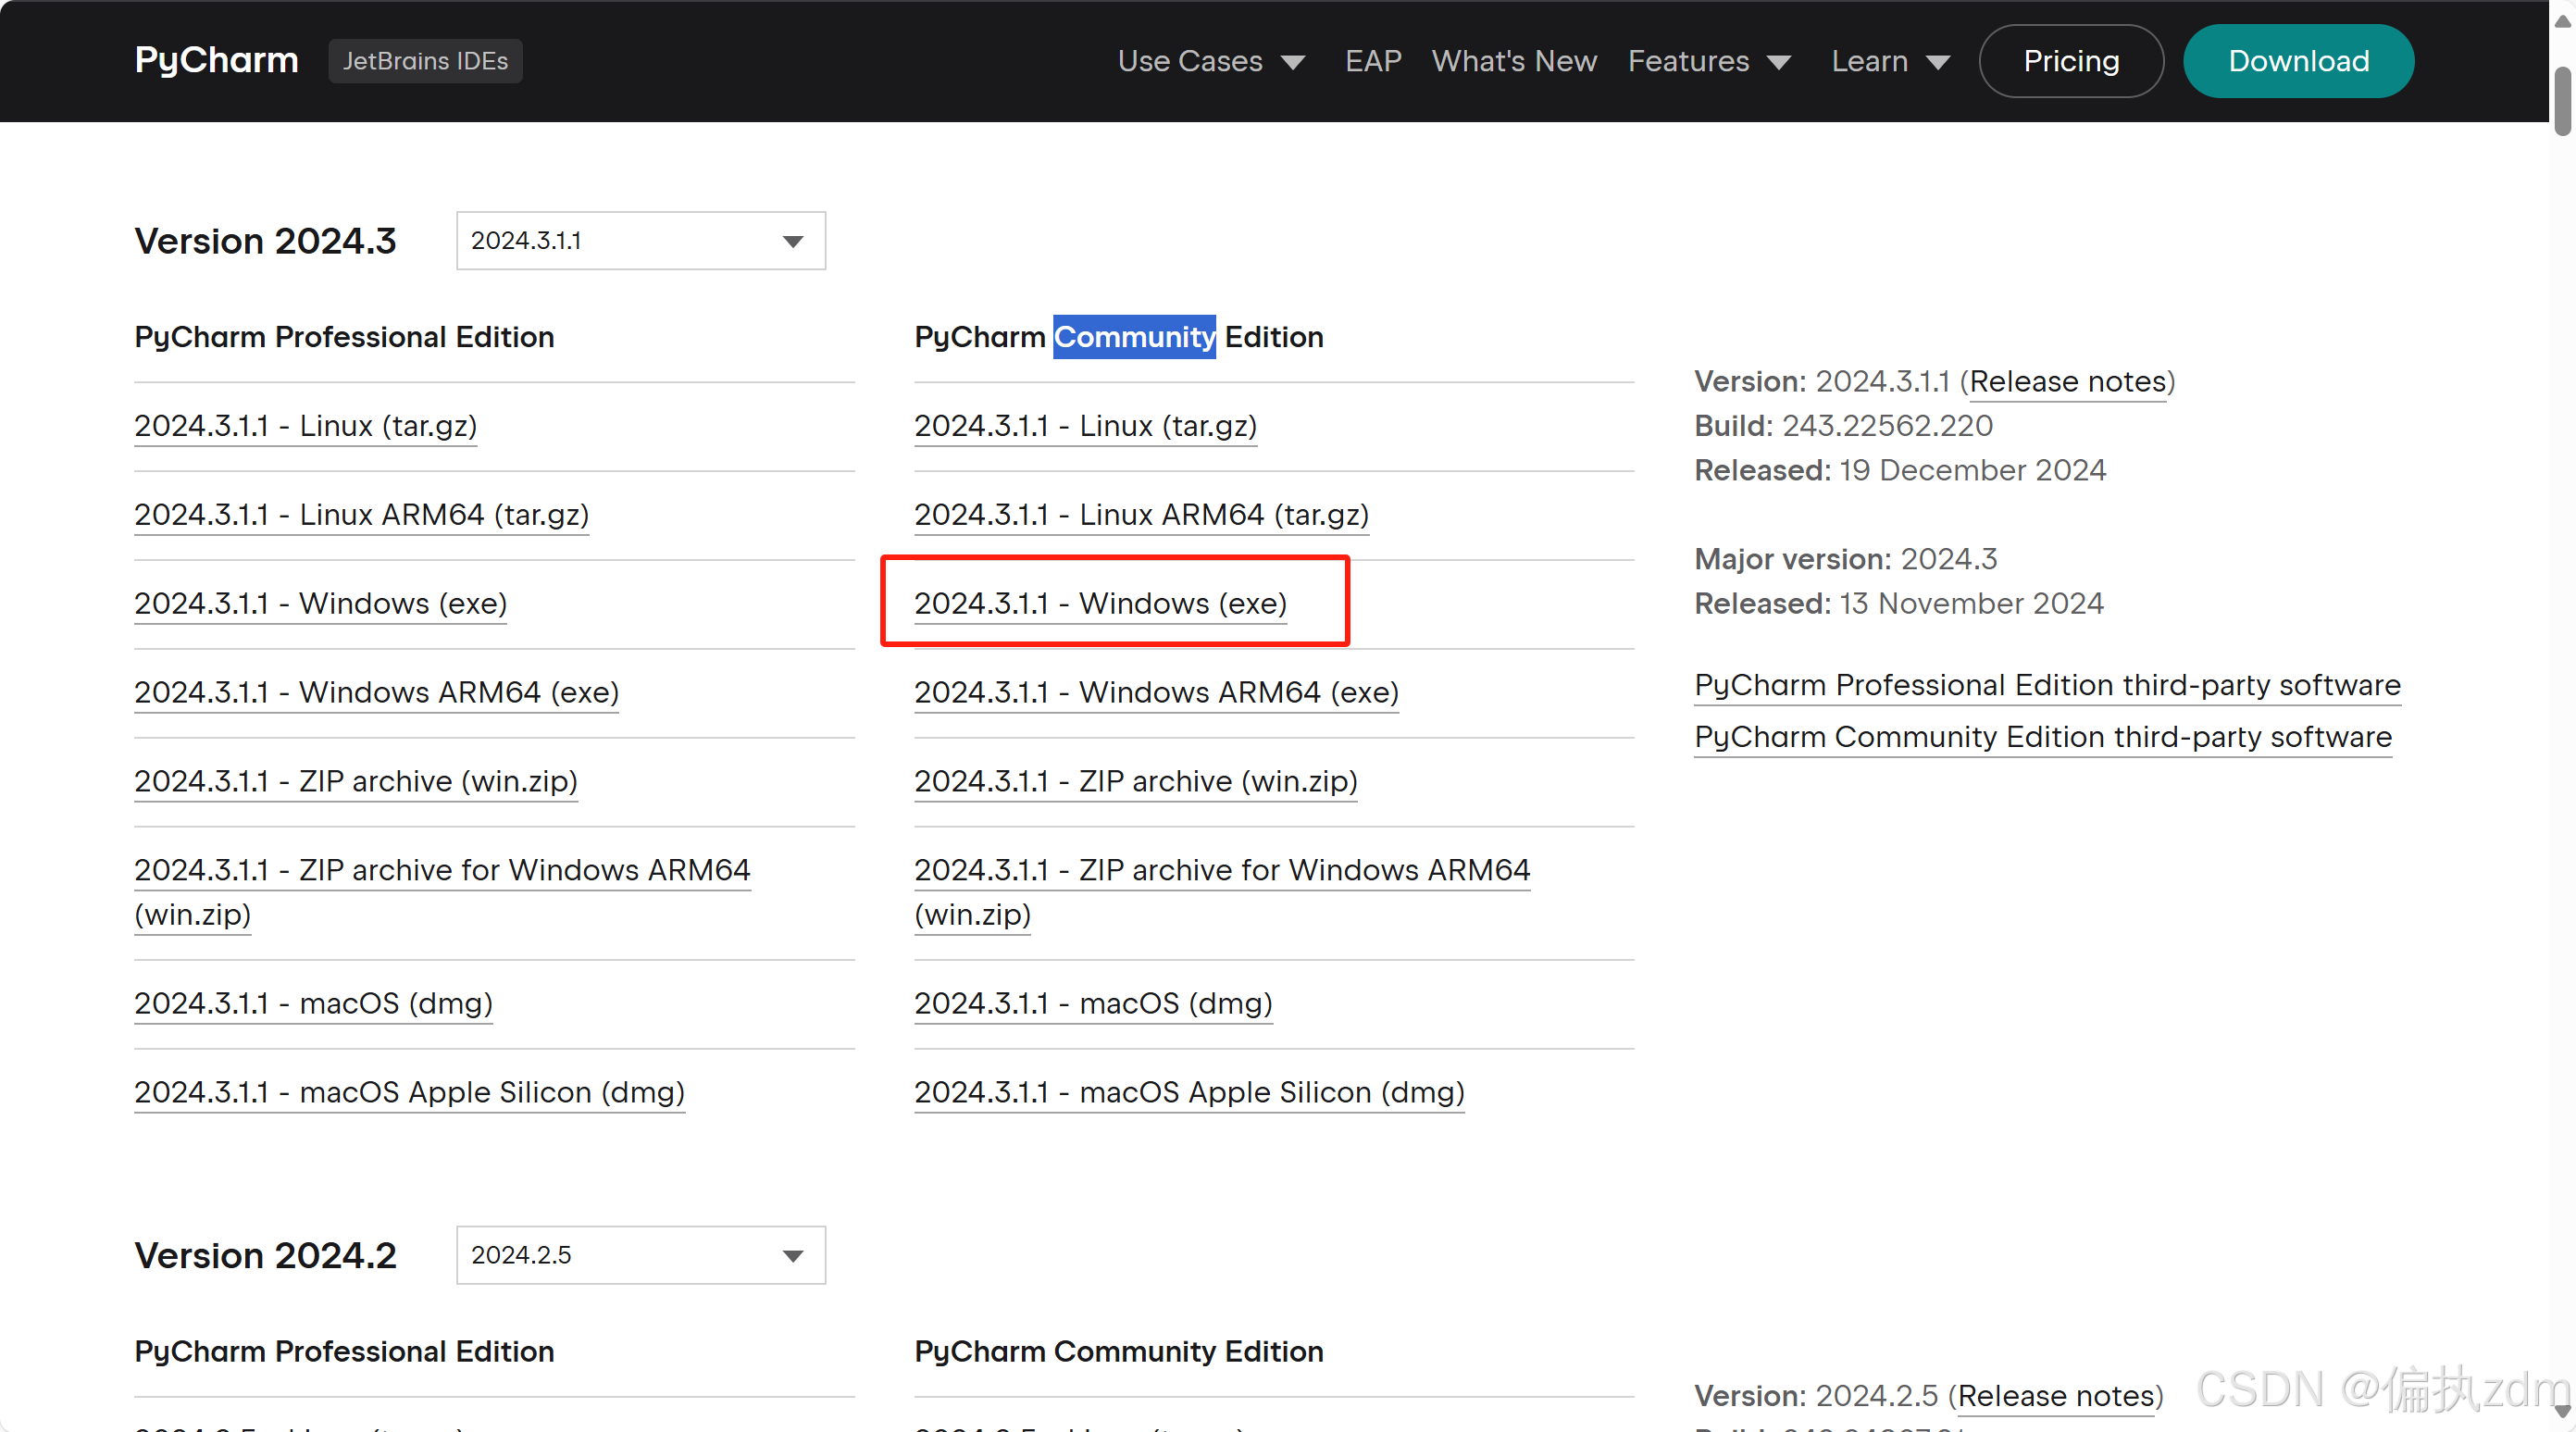
这里就跟着小土堆安装Community版本,跟着一路next即可。
PyCharm创建项目
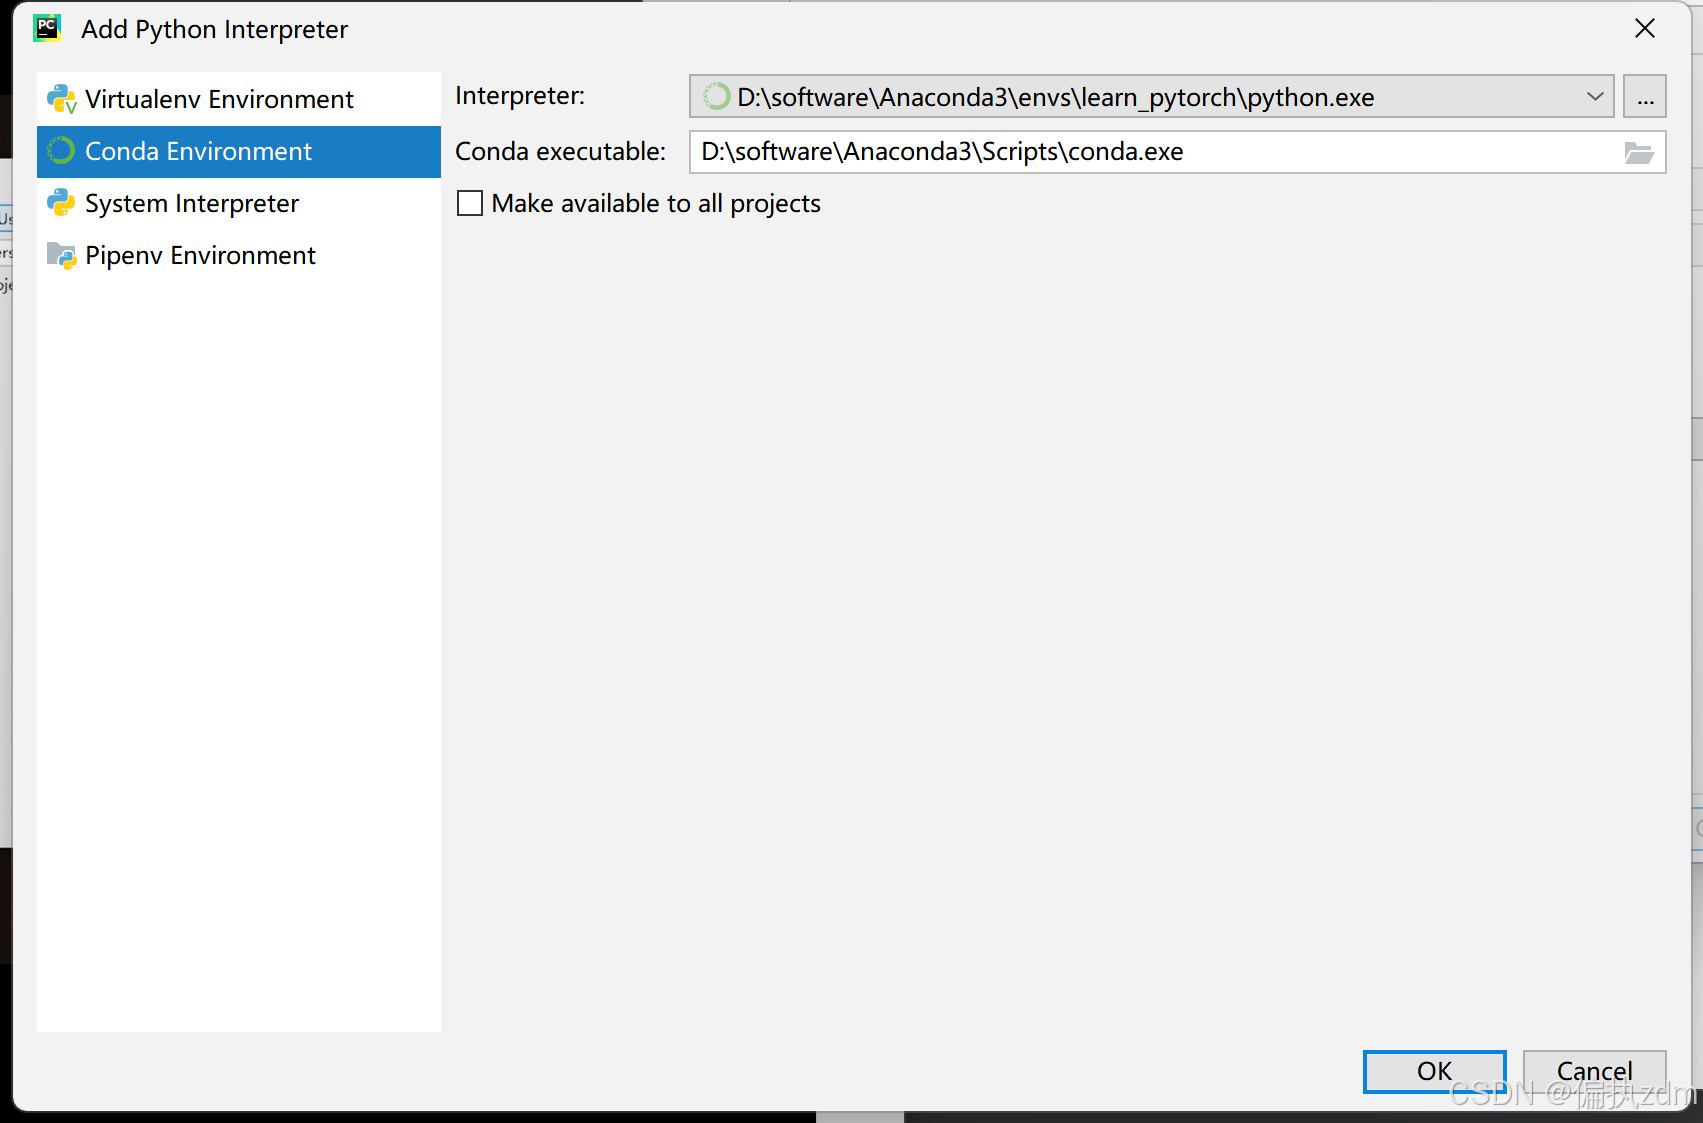
打开pycharm,选择之前安装的conda环境下的python。
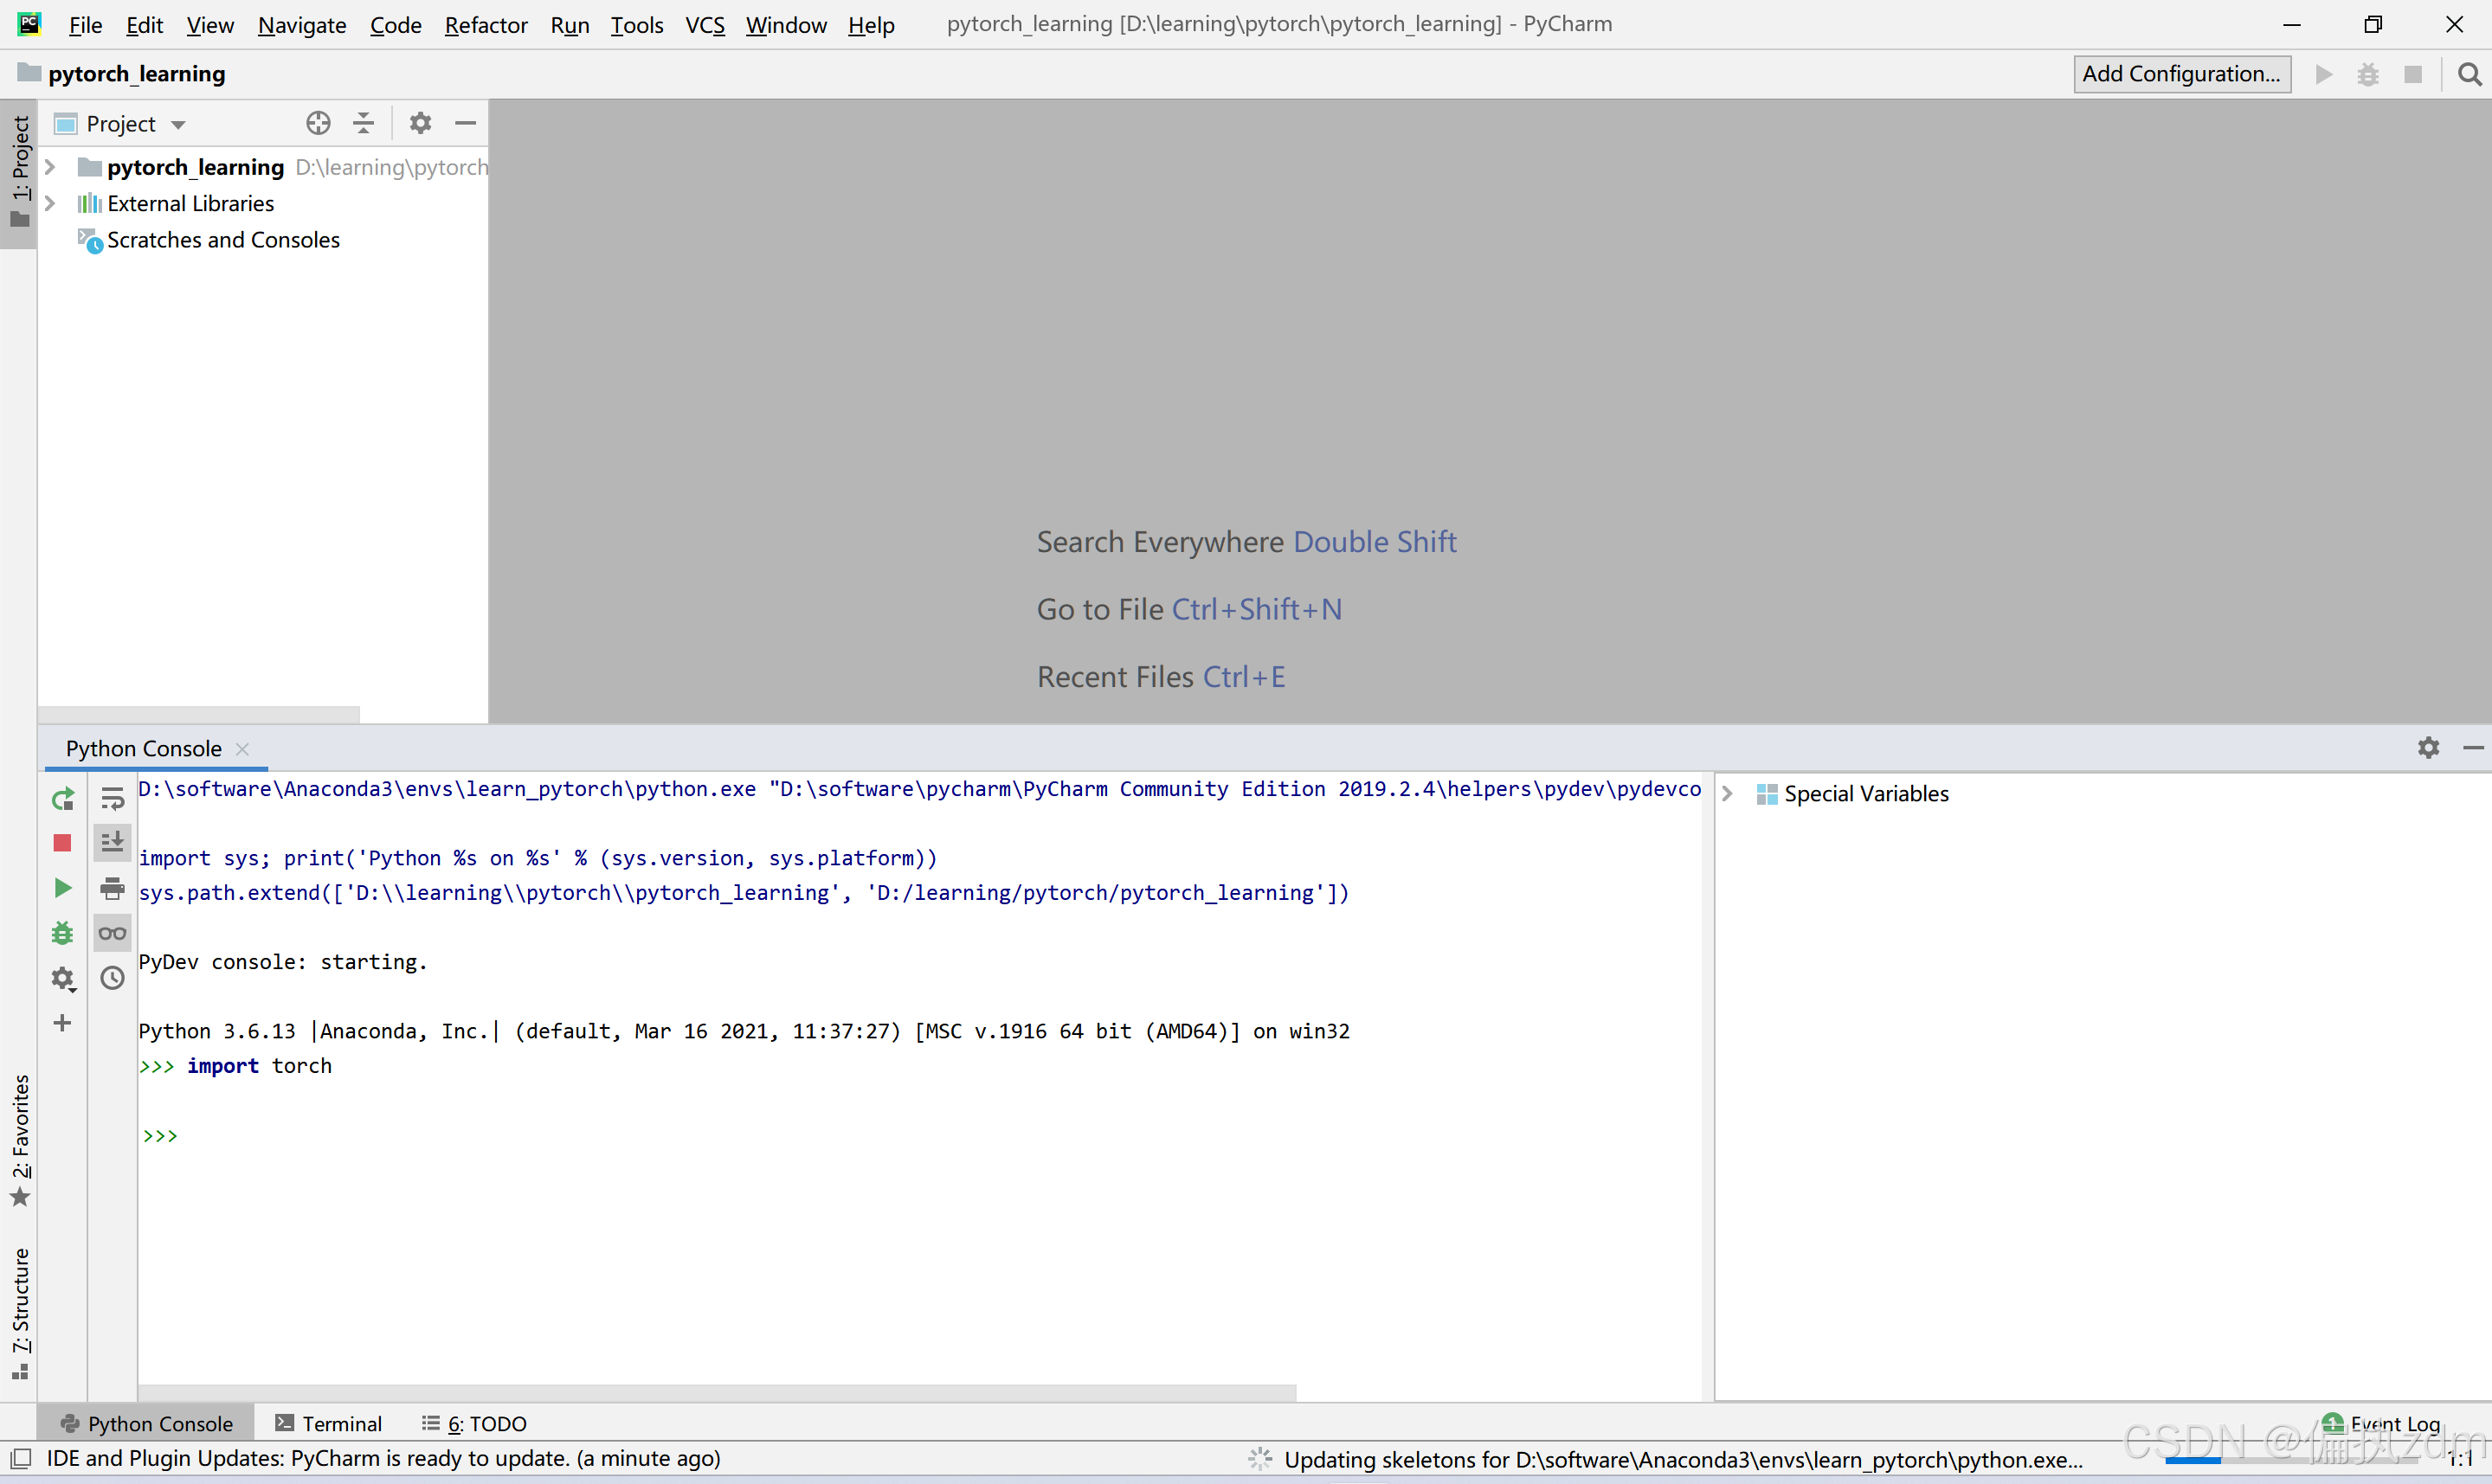
查看是否导入正确:import torch
(这里因为我的电脑没有独显,因此torch.cuda.is_available()返回的是False,先跟着学)
- 跟着小土堆练习语法
range(1, 4)
range(1, 4)
b = range(1, 4)
b = list(range(1, 4))
print(b)
[1, 2, 3]
Jupyter的使用
Jupyter默认是在base环境下的,有两种办法:要么在base环境安装pytorch,要么在刚刚的环境中安装Jupyter。选择后者。
- 打开Anaconda 的命令行
切换到我们的环境中
conda activate learn_pytorch
- 使用如下命令进行安装:
conda install nb_conda
- 最后,进入jupyter
jupyter notebook
- 验证是否可以运行
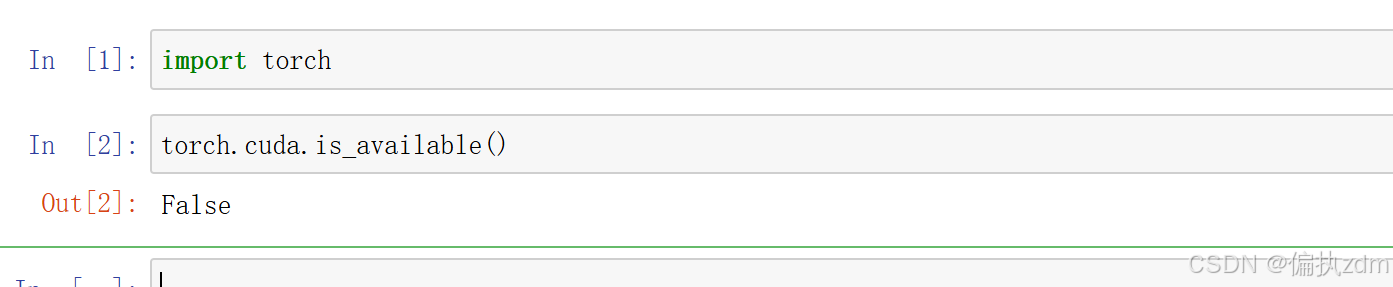
为什么我的torch.cuda.is_available()是false?- 我的GPU不支持cuda
Python 学习中的两大法宝函数
- dir()
提供 打开工具 的作用,让我们能看见相关工具。
例如:
>>>dir(torch.cuda.is_available())
['__abs__', '__add__', '__and__', '__bool__', '__ceil__', '__class__', '__delattr__', '__dir__', '__divmod__', '__doc__', '__eq__', '__float__', '__floor__', '__floordiv__', '__format__', '__ge__', '__getattribute__', '__getnewargs__', '__gt__', '__hash__', '__index__', '__init__', '__init_subclass__', '__int__', '__invert__', '__le__', '__lshift__', '__lt__', '__mod__', '__mul__', '__ne__', '__neg__', '__new__', '__or__', '__pos__', '__pow__', '__radd__', '__rand__', '__rdivmod__', '__reduce__', '__reduce_ex__', '__repr__', '__rfloordiv__', '__rlshift__', '__rmod__', '__rmul__', '__ror__', '__round__', '__rpow__', '__rrshift__', '__rshift__', '__rsub__', '__rtruediv__', '__rxor__', '__setattr__', '__sizeof__', '__str__', '__sub__', '__subclasshook__', '__truediv__', '__trunc__', '__xor__', 'bit_length', 'conjugate', 'denominator', 'from_bytes', 'imag', 'numerator', 'real', 'to_bytes']
- help()
说明书
例如:
>>>help(torch.cuda.is_available)
Help on function is_available in module torch.cuda:
is_available() -> bool
PyCharm 和 Jupyter的区别
PyCharm创建项目及使用
- 创建项目,选择对应的环境
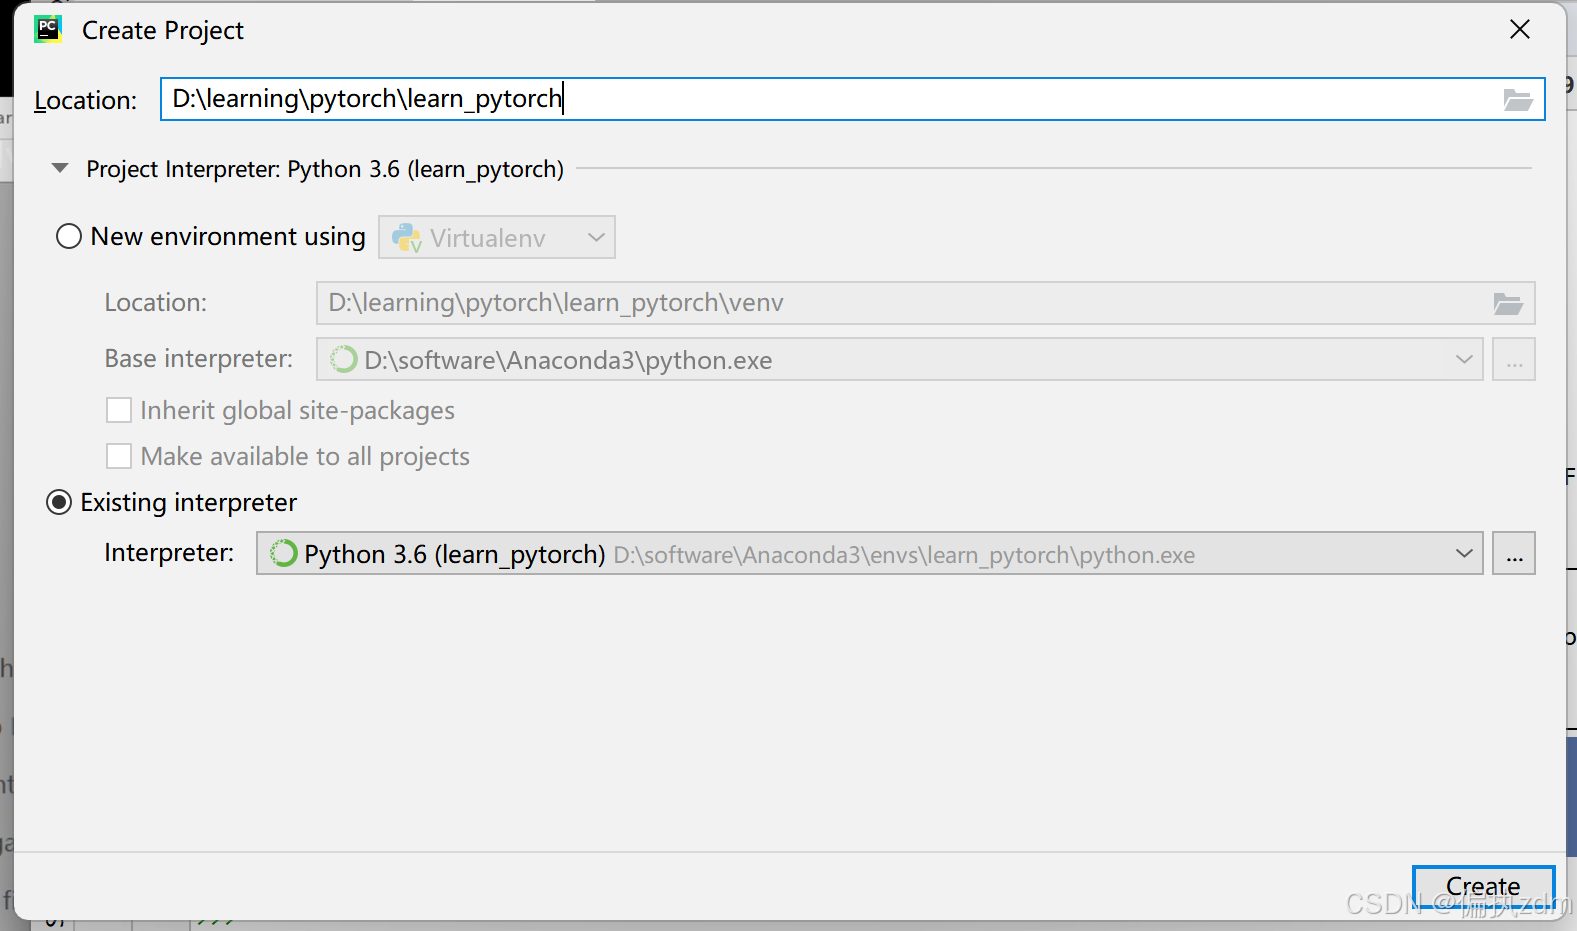
- 新建一个python文件
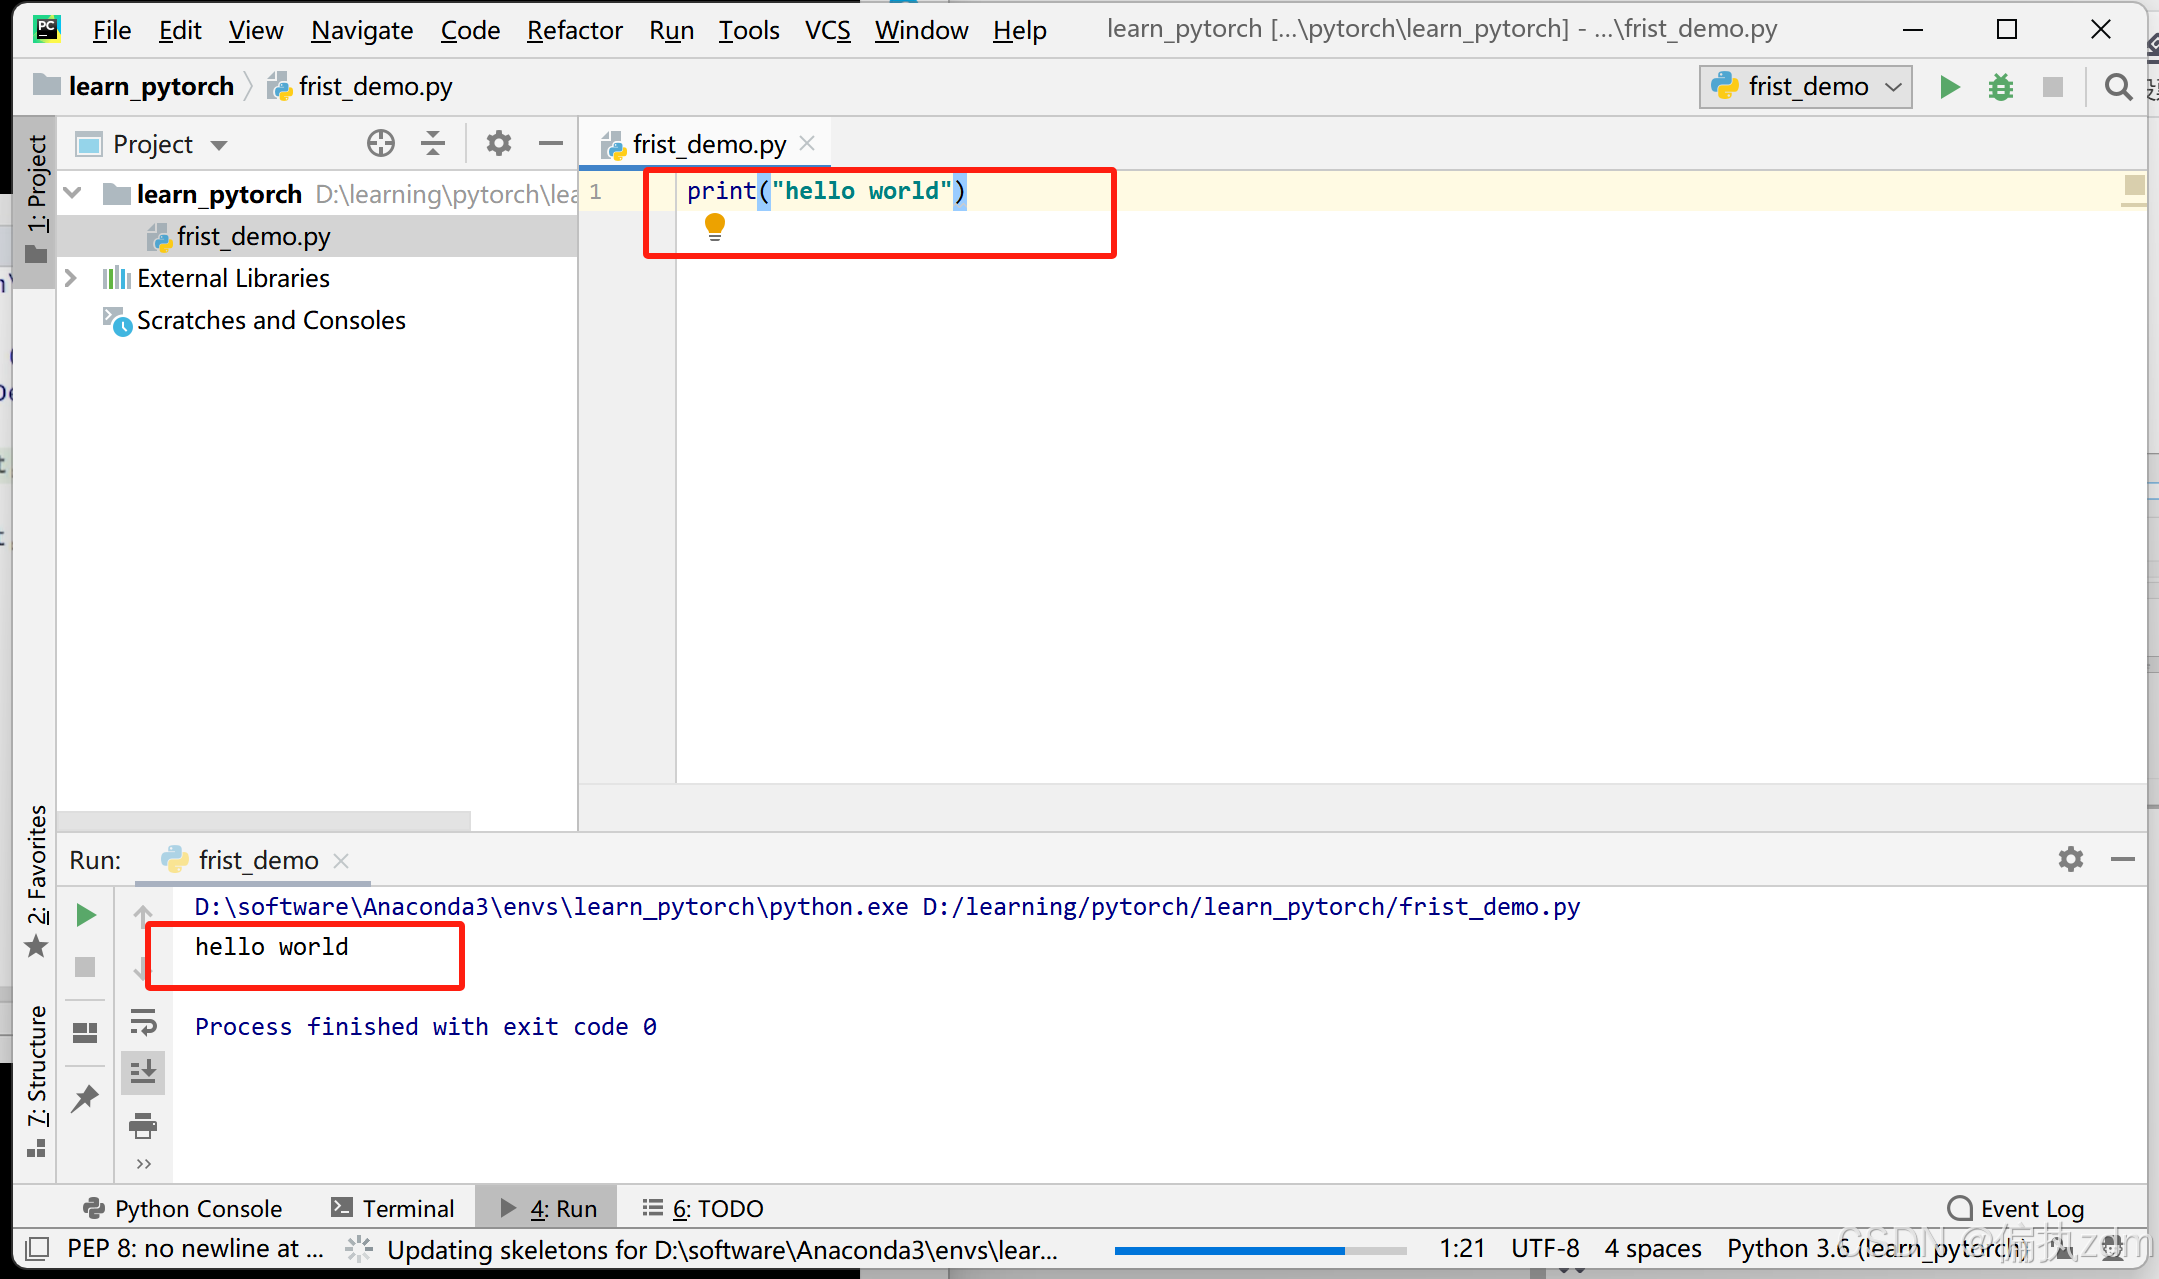
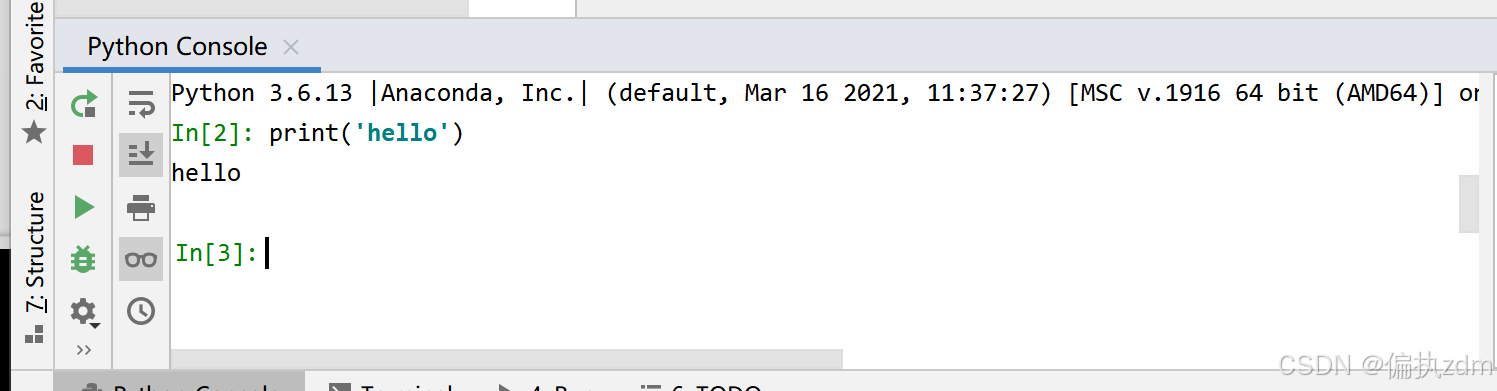
- 也可以在python console中敲命令运行python代码,如下图所示
在jupyter 创建项目及使用
- 首先,打开anaconda命令行
切换环境:conda activate learn_pytorch - 然后,启动jupyter
jupyter notebook
比较创建.py文件、在python console、jupyter中运行代码的区别
在python文件中,代码如果是以块为一个整体运行的话,python文件的块是所有行的代码。
- 优点:通用、传播方便,适用于大型项目;
- 缺点:需要从头运行
在python控制台中,以每一行为一个块进行执行的。(阅读性差)
- 优点:显示每个变量属性
- 缺点:不利于代码阅读和修改
在jupyter中,可以以任意行为块运行的。
- 优点:利于代码阅读及修改
- 缺点:环境需要配置
pytorch 如何加载数据
Dataset
主要作用:提供一种方式去获取数据及其label。
- 如何获取每一个数据及其label
- 告诉我们总共有多少个数据
相关例子:
识别蚂蚁和蜜蜂的二分类问题
- 在python控制台:获取蚂蚁数据集
from PIL import Image
img_path = "D:\\learning\\pytorch\\learn_pytorch\\Dataset\\train\\ants\\0013035.jpg"
img = Image.open(img_path)
img.show()

dir_path = 'Dataset/train/ants'
import os
img_path_list = os.listdir(dir_path)
- 在python文件中
from torch.utils.data import Dataset
from PIL import Image
import os

class MyData(Dataset):

    def __init__(self, root_dir, label_dir):
        self.root_dir = root_dir
        self.label_dir = label_dir
        self.path = os.path.join(self.root_dir, self.label_dir)
        self.img_path = os.listdir((self.path)) # 获取所有地址


    def __getitem__(self, idx):
        # 每个文件名字
        img_name = self.img_path[idx]
        # 程序的相对路径
        img_item_self = os.path.join(self.root_dir, self.label_dir, img_name)
        img = Image.open(img_item_self)
        label = self.label_dir
        return img, label

    def __len__(self):
        return len(self.img_path)

root_dir = "Dataset/train"
ants_label_dir = "ants"
# 获取蚂蚁的数据集
ants_dataset = MyData(root_dir, ants_label_dir)

# 获取蜜蜂的数据集
bees_label_dir = "bees"
bees_dataset = MyData(root_dir, bees_label_dir)

# 整个训练数据集
train_dataset = ants_dataset + bees_dataset
Dataloader
主要作用:为后面的网络提供不同的数据形式
TensorBoader的使用
- add_scalar() :
- tag:
- scalar_value: 对应y轴
- global_step:对应x轴
from torch.utils.tensorboard import SummaryWriter

writer = SummaryWriter("logs")
# y = x
for i in range(100):
    writer.add_scalar("y=x", i, i)
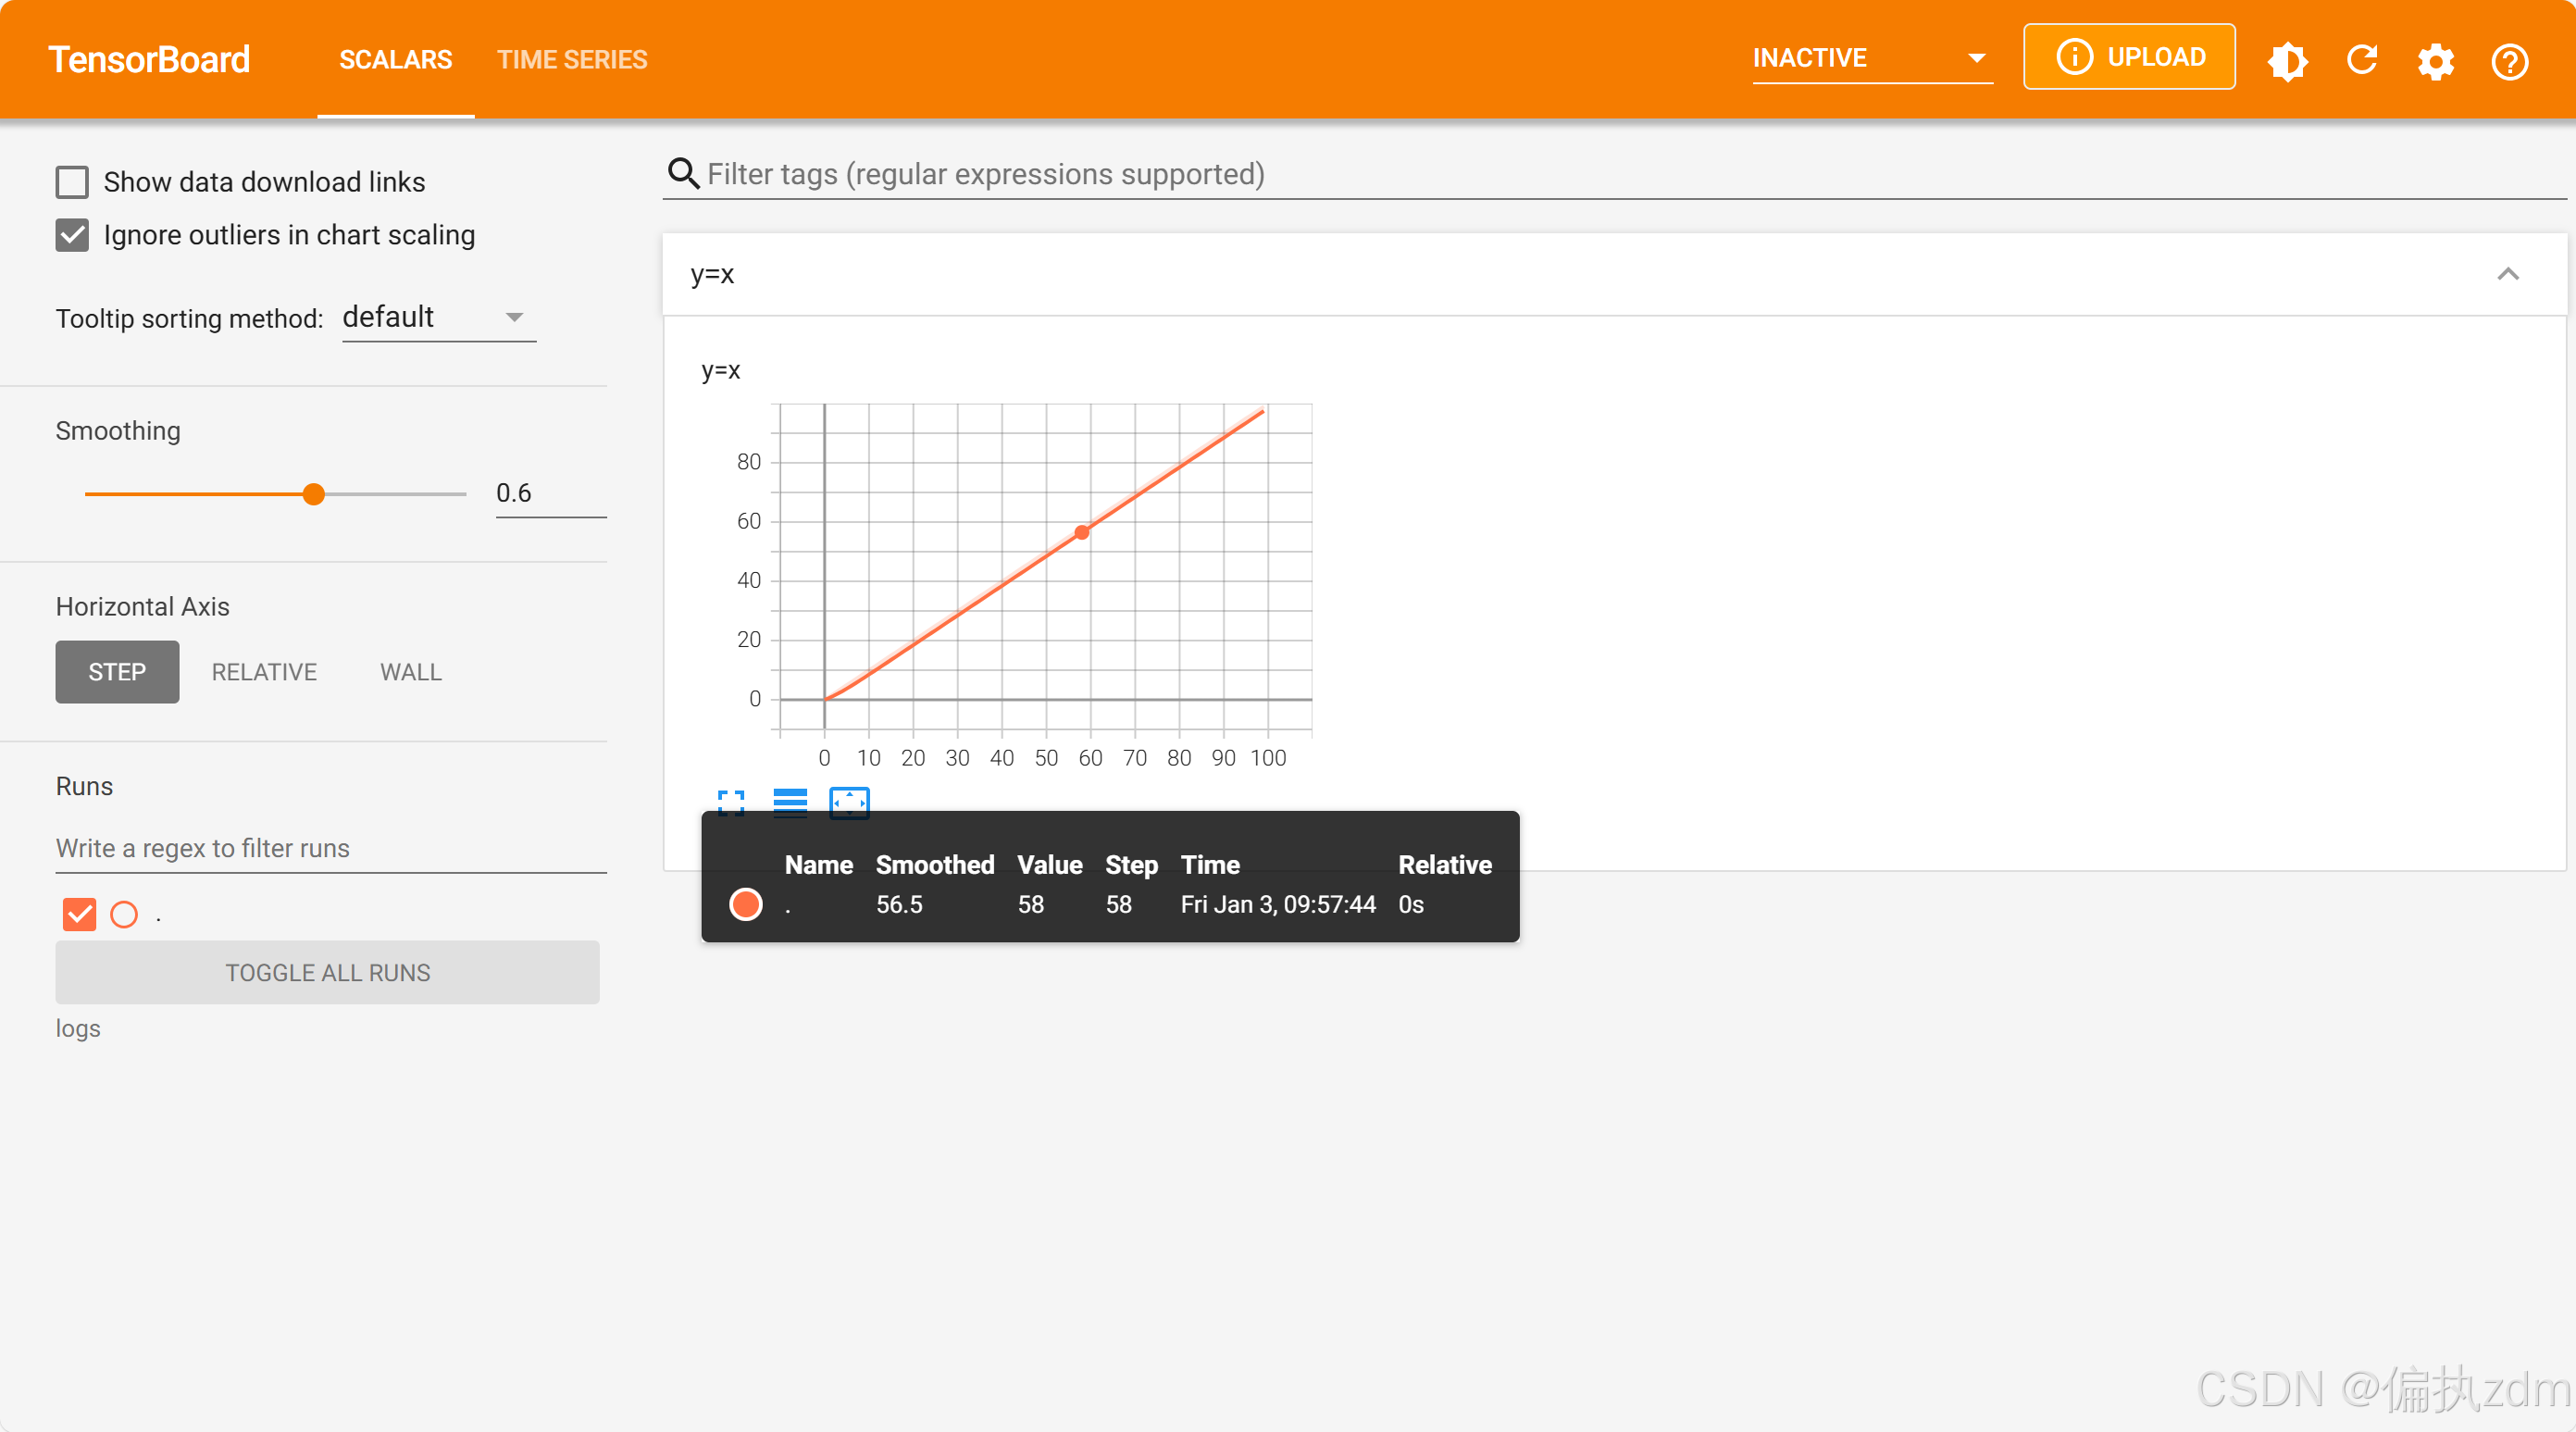
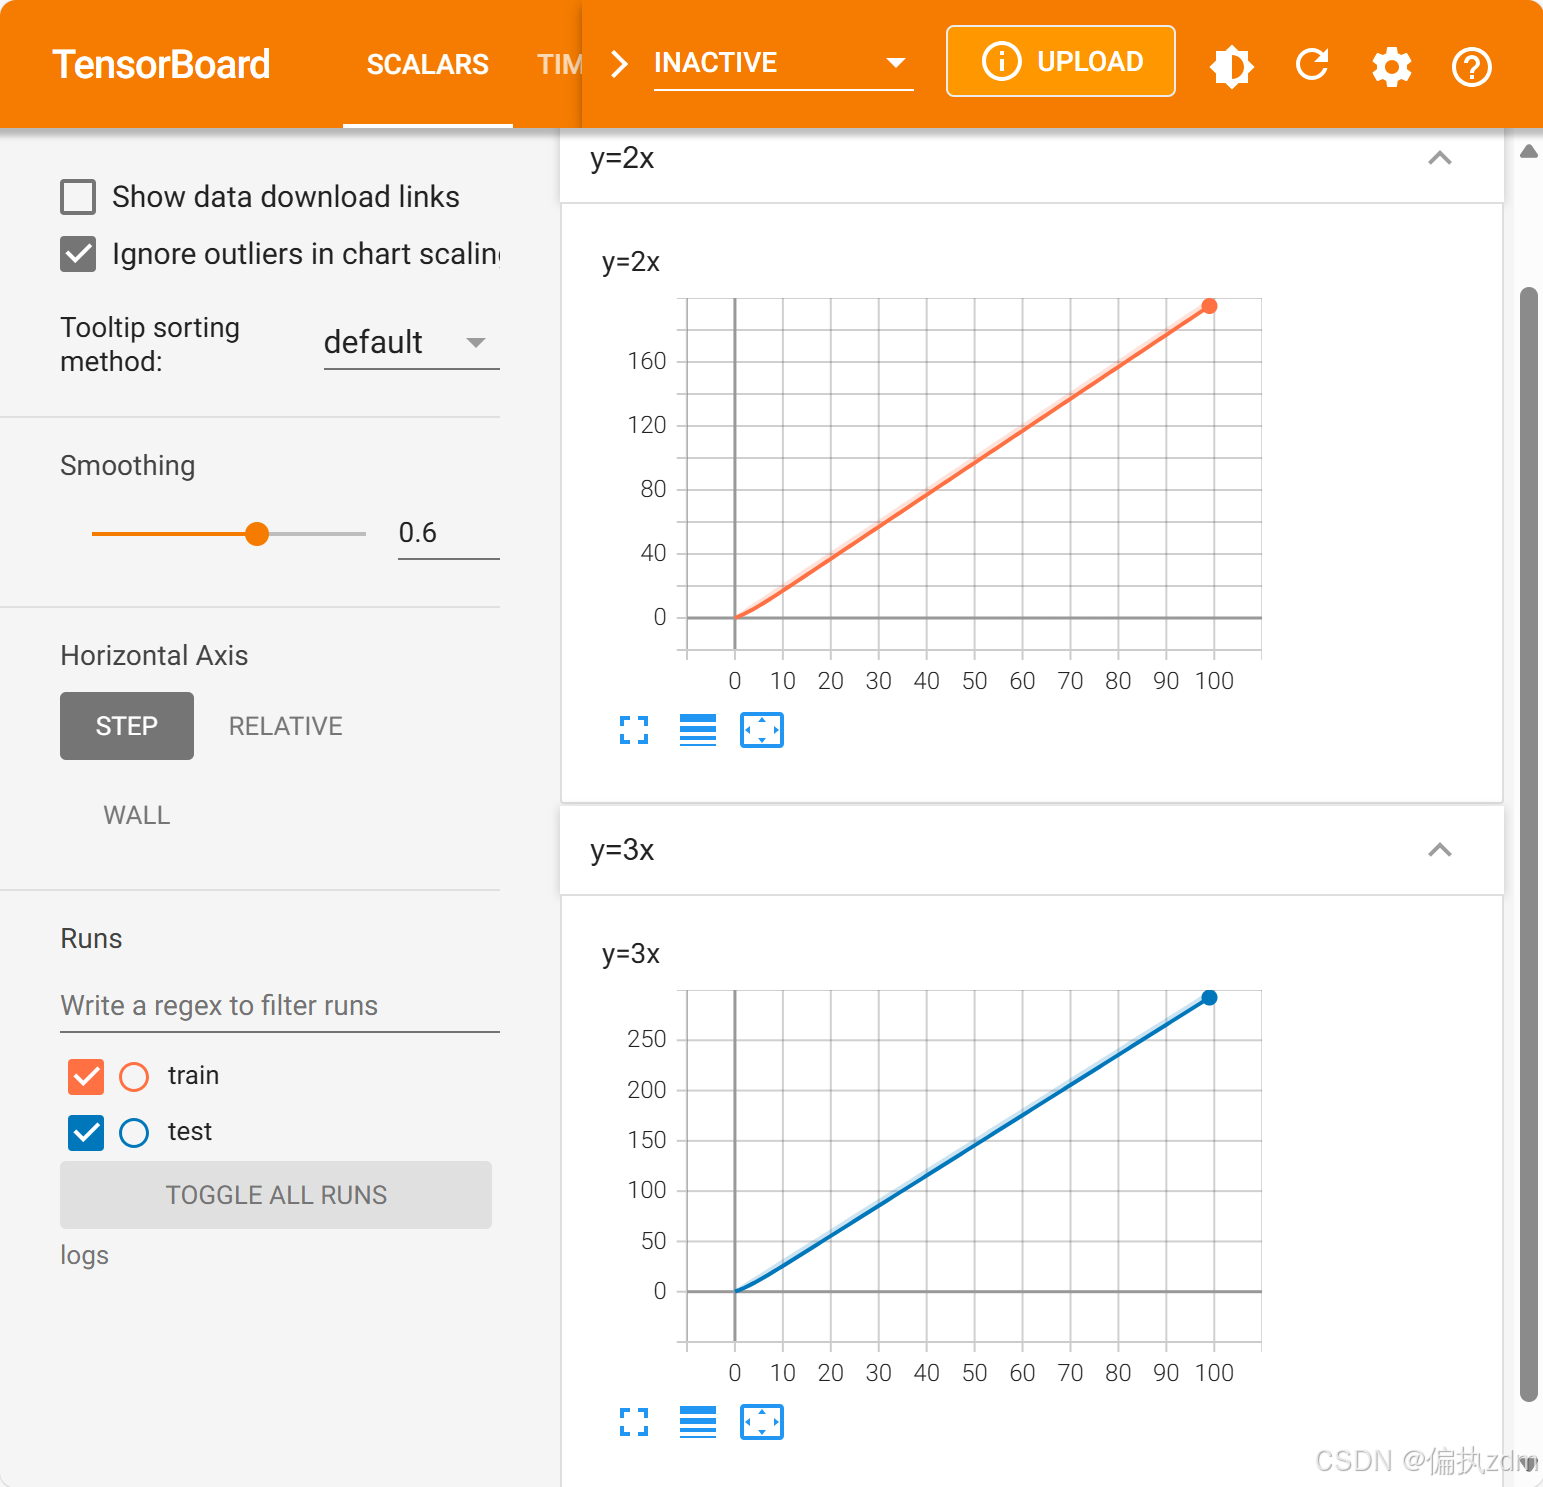
在python控制台输入tensorboard --logdir=logs可以打开对应文件。默认端口为6006;端口号可以修改,可以使用--port进行修改,如下图所示。
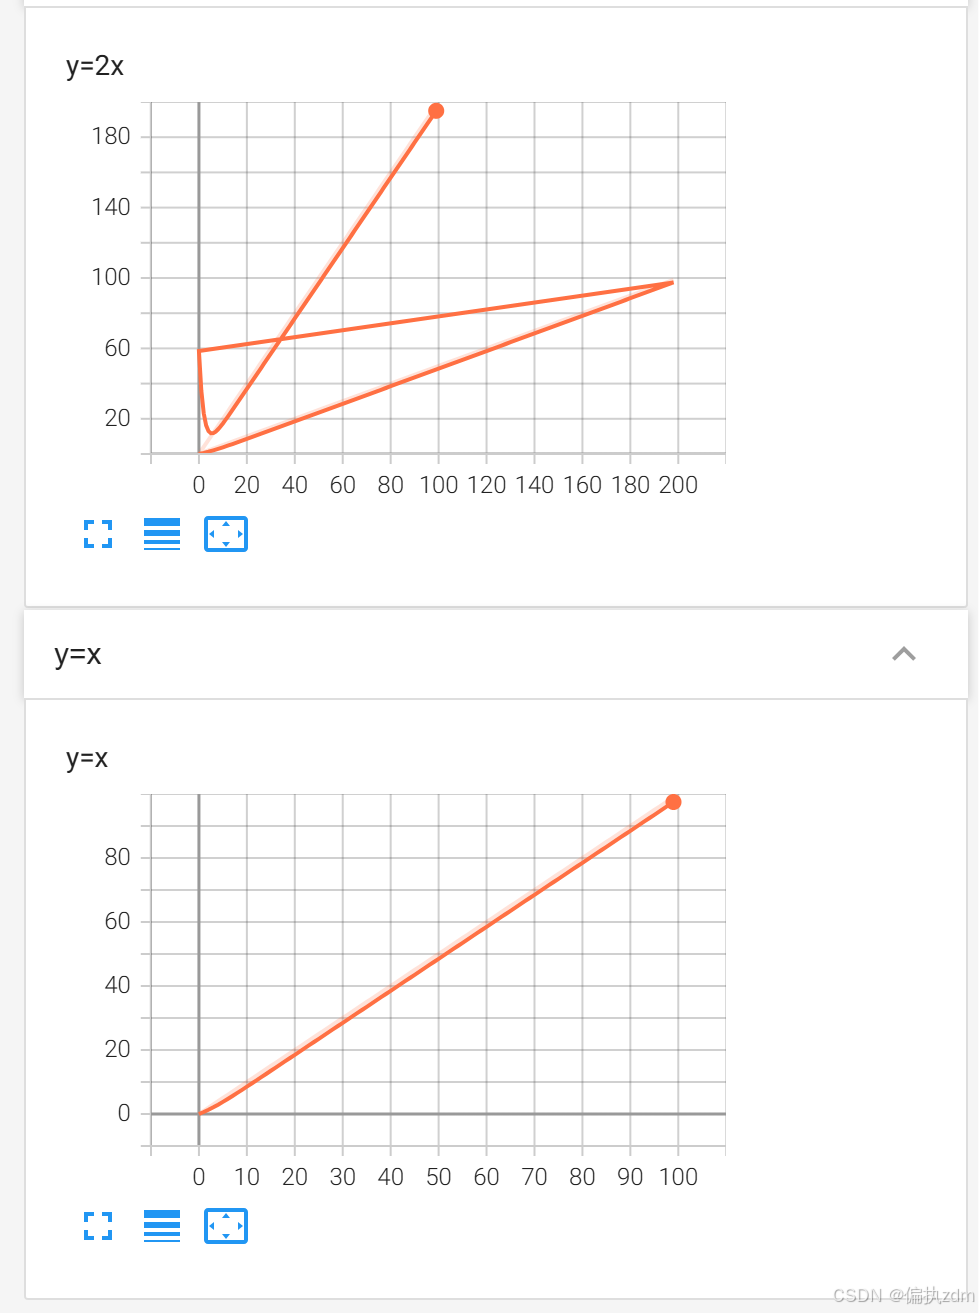
- 在使用tensorboard可视化网络参数时,当因多次训练产生多个events文件后,在tensorboard上显示会非常混乱,非常不易于观察。
如下图所示,这张图只有两次实验的文件,已经比较混乱了。
解决方法:
- 每次跑都将以前的文件删除,保证路径下只有当前产生的events文件
- 保存在不同路径下分别显示
如下所示:
from torch.utils.tensorboard import SummaryWriter

writer1 = SummaryWriter("logs/train")
writer2 = SummaryWriter("logs/test")

# writer.add_image()

# y = x
# for i in range(100):
#     writer.add_scalar("y=x", i, i)

for i in range(100):
    writer1.add_scalar("y=2x", 2 * i, i)

writer1.close()


for i in range(100):
    writer2.add_scalar("y=3x", 3 * i, i)

writer2.close()
2. add_iamge()的使用
——常用来观察训练结果
利用Opencv读取图片,获得numpy型图片数据
from torch.utils.tensorboard import SummaryWriter
import numpy as np
from PIL import Image

writer = SummaryWriter("logs")
image_path = "data_set/val/bees/6a00d8341c630a53ef00e553d0beb18834-800wi.jpg"
img_PIL = Image.open(image_path)
img_array = np.array(img_PIL) # 转成numpy类型

print(type(img_array)) # 类型是numpy
print(img_array.shape) # 输出:(512, 768, 3)即: (高度,宽度,通道);但默认是(通道,高度,宽度),因此调用add_iamge()的时候需要加dataformats='HWC'

writer.add_image("test", img_array, 1, dataformats='HWC')

for i in range(100):
    writer.add_scalar("y = 2x", 3 * i, i)

writer.close()
- 通过这样的方式可以看到在训练过程中给model提供了那些数据。或者想对model进行测试的时候可以看到每一阶段的输出结果。
torchvision中的Transforms
主要对图片进行一些变换,提供了常用的一系列图像预处理方法,例如数据的标准化,中心化,旋转,翻转等
关于transforms 的结构与用法
相当于一个进行变换图片的工具箱,里面有很多“工具”可以使用,比如以下:
-
Compose
- 接收一个包含多个数据变换函数(或可调用对象)的列表作为输入。当对数据(通常是图像)应用 Compose 时,它会按照列表中函数的顺序依次对数据进行处理。
- 可以方便地将多个预处理和增强步骤整合在一起,而不需要手动逐个调用这些函数。
-
ToTensor()
- 功能:将形状为(H, W, C)(高度、宽度、通道数)的PIL Image或形状为(H, W)的numpy.ndarray(H为高度,W为宽度)转换为形状为(C, H, W)的torch.Tensor,并且将像素值从范围[0, 255]转换为范围[0.0, 1.0]的浮点数。
- 这是在处理图像数据时非常常用的一个转换操作,因为深度学习框架通常要求输入数据是张量格式,并且像素值归一化可以帮助模型更好地收敛。
-
Normalize(mean, std)
- 功能:对张量图像进行归一化操作。给定均值mean和标准差std(以元组形式提供,通道数与图像的通道数相同),通过公式
output[channel] = (input[channel] - mean[channel]) / std[channel]对每个通道进行归一化。 - 该操作有助于将数据分布标准化,使模型训练更加稳定。
- 功能:对张量图像进行归一化操作。给定均值mean和标准差std(以元组形式提供,通道数与图像的通道数相同),通过公式
-
Resize(size)
- 功能:调整图像的大小。size可以是一个整数(此时将短边缩放至该整数,长边按比例缩放),也可以是一个元组(H, W)(将图像大小调整为指定的高度H和宽度W)。
- 这在将不同大小的图像输入到模型中之前,统一图像大小是很有用的。
-
RandomResizedCrop(size)
- 功能:随机裁剪并缩放图像。首先从原始图像中随机裁剪出一个区域,然后将裁剪后的区域缩放至指定的size(可以是整数或元组形式)。
- 这种随机操作可以增加数据的多样性,减少模型过拟合的风险。
-
RandomHorizontalFlip(p=0.5)
- 功能:以概率p(默认值为0.5)对图像进行水平翻转。
- 在图像数据集中,物体的左右方向通常不影响其类别,通过随机水平翻转可以扩充数据集,提高模型的泛化能力。
-
RandomVerticalFlip(p=0.5)
- 功能:与RandomHorizontalFlip类似,不过是对图像进行垂直翻转,概率为p(默认值为0.5)。
-
ColorJitter(brightness=0, contrast=0, saturation=0, hue=0)
- 功能:随机改变图像的亮度、对比度、饱和度和色调。参数分别指定了亮度、对比度、饱和度和色调的变化范围。例如,brightness=(0.8, 1.2)表示亮度在原始亮度的0.8到1.2倍之间随机变化。
- 这可以使模型对颜色变化等因素更加鲁棒。
-
在python中的用法
- 解决问题1:问题1: 通过transforms该如何使用?(在python中)
from PIL import Image from torchvision import transforms # python的用法 -> tensor数据类型 # 通过transforms.ToTensor去解决两个问题 # 问题1: 通过transforms该如何使用?(在python) # 问题2: tensor数据类型相较于普通数据类型有什么区别?(为什么需要这样的数据类型?) # 绝对路径:D:\learning\pytorch\learn_pytorch\data_set\train\ants_image\0013035.jpg # 相对路径:data_set/train/ants_image/0013035.jpg img_path = "data_set/train/ants_image/0013035.jpg" img = Image.open(img_path) # 图片的读取 # print(img) # <PIL.JpegImagePlugin.JpegImageFile image mode=RGB size=768x512 at 0x1C0177F9748> # 1.如何使用? # 创建具体的工具 tensor_trains = transforms.ToTensor() # 输入:pic 输出:tensor tensor_img = tensor_trains(img) print(tensor_img)- 问题2: tensor数据类型相较于普通数据类型有什么区别?(为什么需要这样的数据类型?)
- 包装了神经网络中所有的一些基础概念,比如梯度、设备(cpu/gpu)等
代码如下:
from PIL import Image
from torch.utils.tensorboard import SummaryWriter
from torchvision import transforms

# 相对路径:data_set/train/ants_image/0013035.jpg
img_path = "data_set/train/ants_image/0013035.jpg"
img = Image.open(img_path)  # 图片的读取

writer = SummaryWriter("logs_trans")

tensor_trains = transforms.ToTensor()
# 输入:pic 输出:tensor
tensor_img = tensor_trains(img)
writer.add_image("tensor_img", tensor_img)
writer.close()
安装opencv遇到的问题
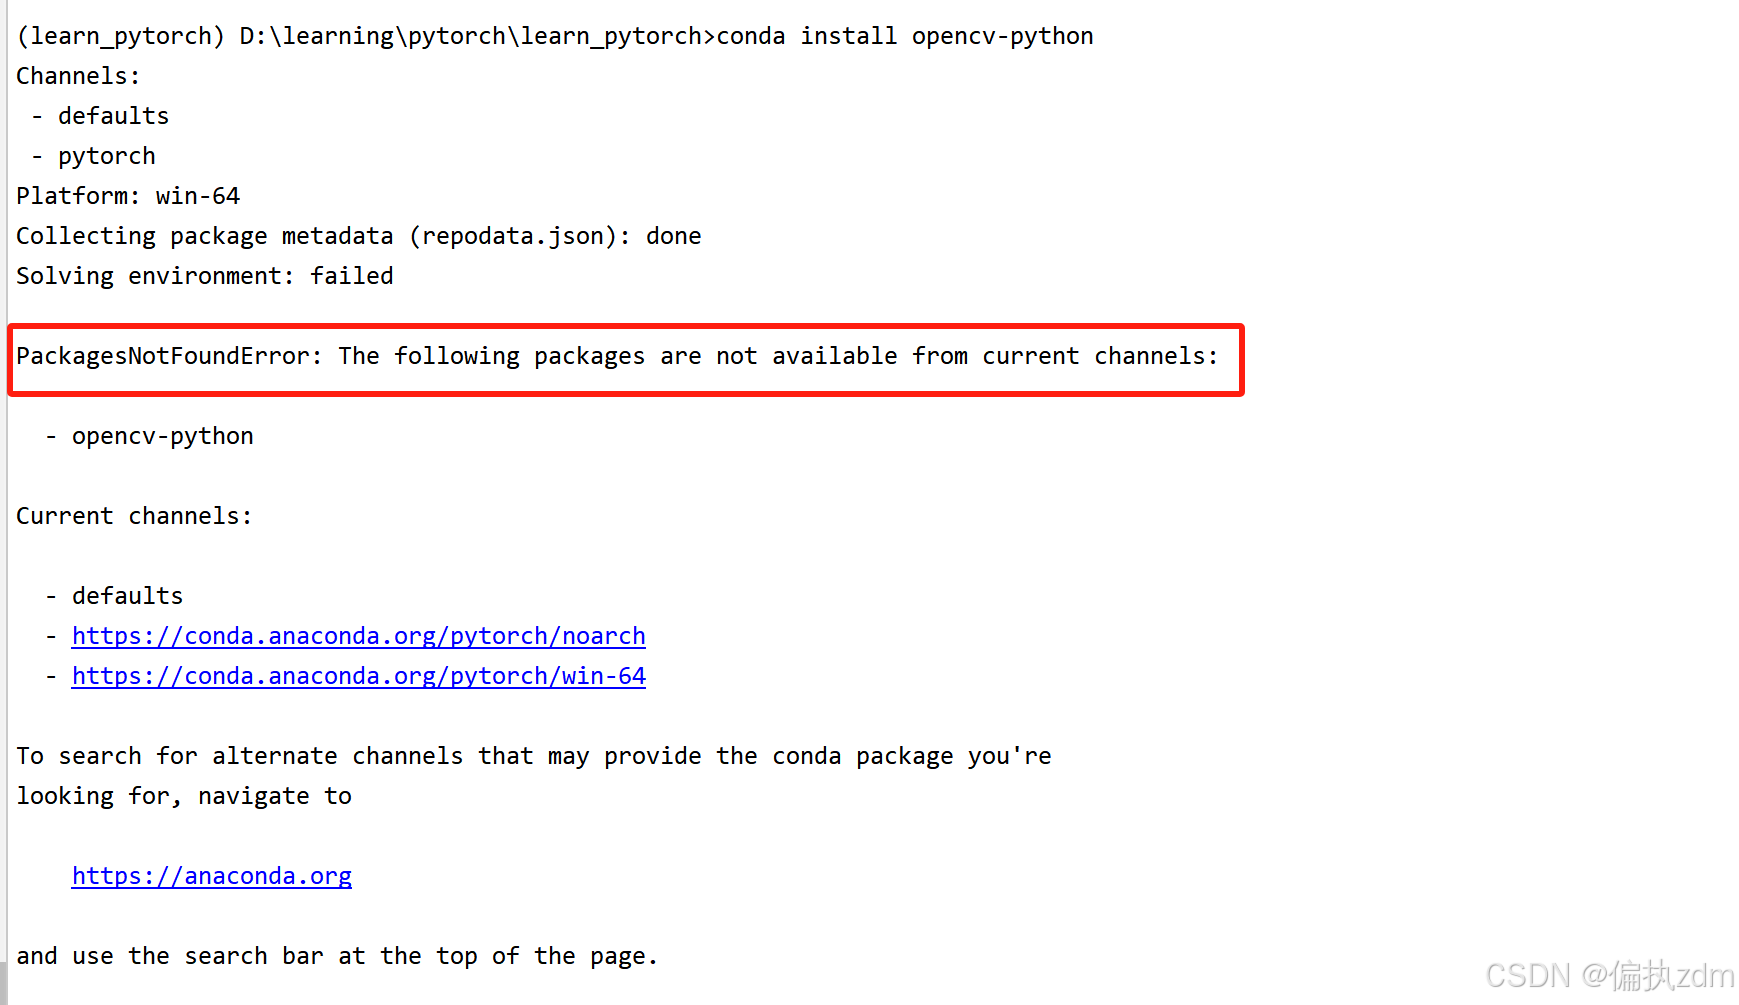
- 解决:查看博客https://blog.csdn.net/lpx666168/article/details/141300010解决。
常见的Transforms
为了更好的学习transforms,主要关注三方面:
- 输入
- 输出
- 作用
案例:
-
__call__的作用:是把一个类的实例化对象变成了可调用对象
class Person: def __call__(self, name): print("__call__" + "hello" + name) def hello(self, name): print("hello" + name) person = Person() person("zhangsan") person.hello("lisi") -
Totensor的使用
from PIL import Image from torch.utils.tensorboard import SummaryWriter from torchvision import transforms writer = SummaryWriter("logs") img = Image.open("images/0013035.jpg") print(img) # ToTensor的使用 trans_totensor = transforms.ToTensor() img_tensor = trans_totensor(img) writer.add_image("ToTensor", img_tensor) writer.close() -
Normalize的使用
输入:平均值和标准差
计算公式:output[channel] = (input[channel] - mean[channel]) / std[channel]
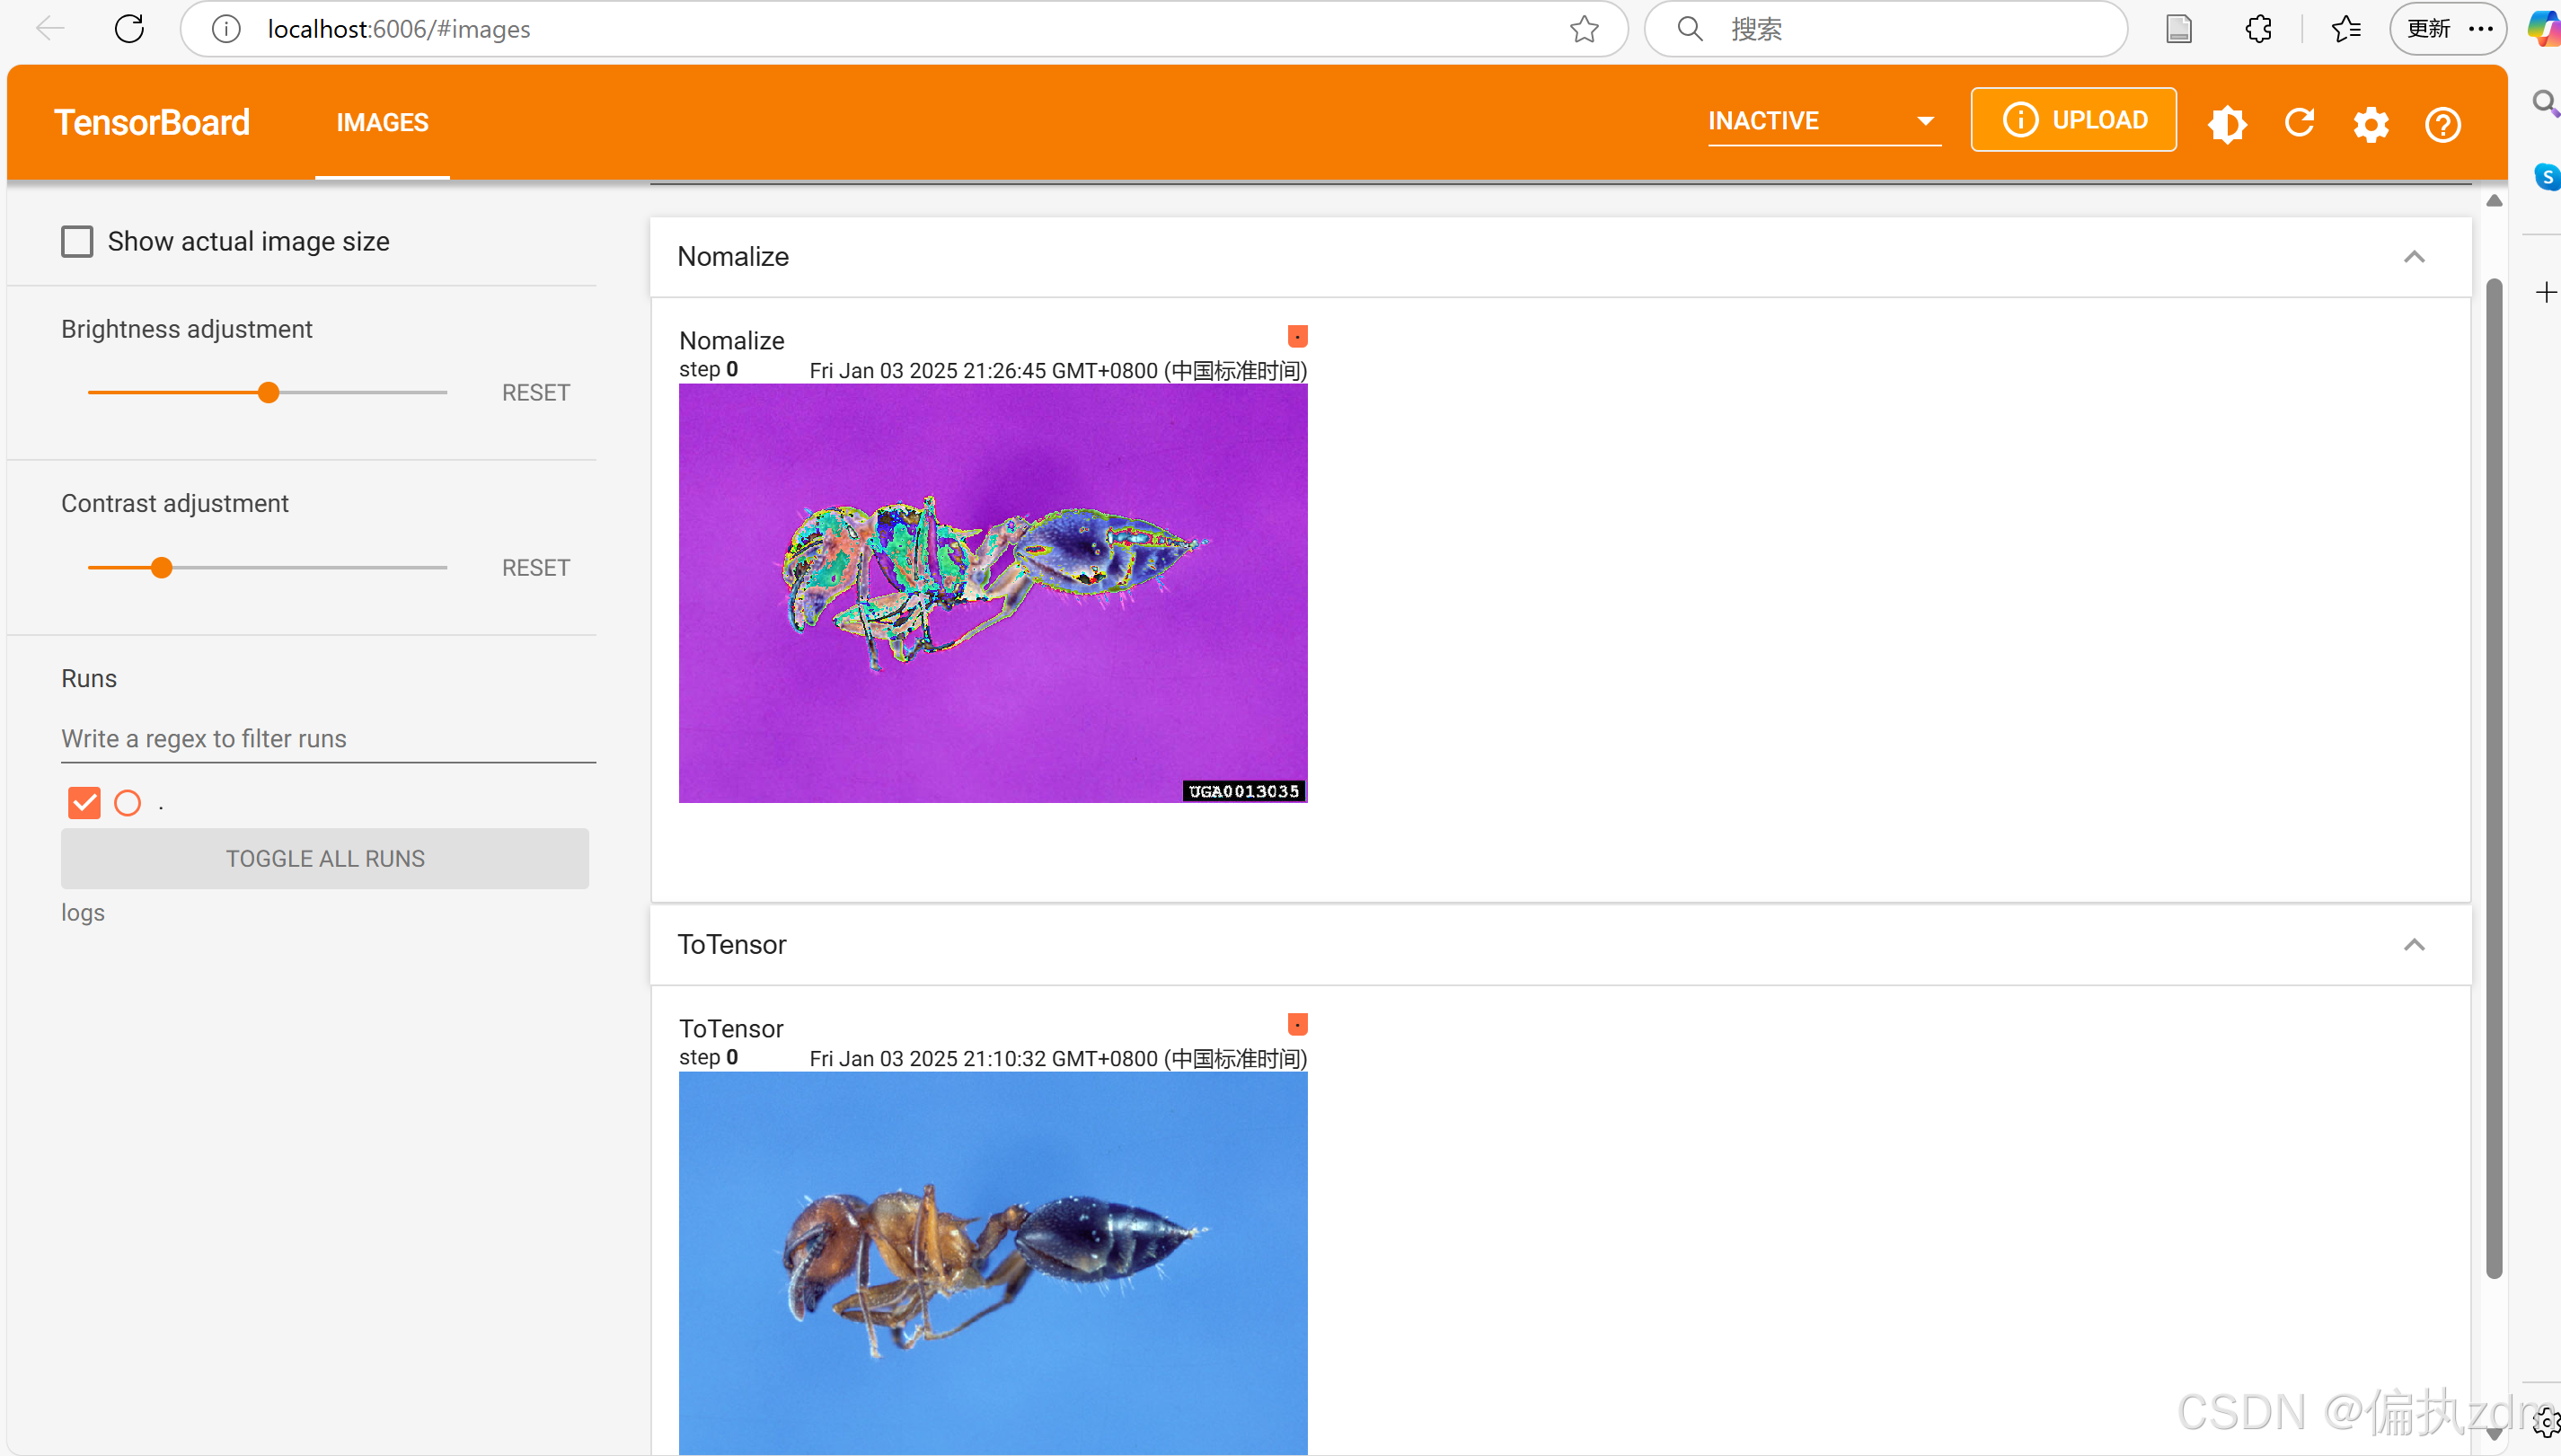
from PIL import Image from torch.utils.tensorboard import SummaryWriter from torchvision import transforms writer = SummaryWriter("logs") img = Image.open("images/0013035.jpg") print(img) # ToTensor的使用 trans_totensor = transforms.ToTensor() img_tensor = trans_totensor(img) writer.add_image("ToTensor", img_tensor) # Normalize print(img_tensor[0][0][0]) trans_norm = transforms.Normalize([1, 3, 5], [3, 2, 1]) img_norm = trans_norm(img_tensor) print(img_norm[0][0][0]) writer.add_image("Nomalize", img_norm) writer.close() -
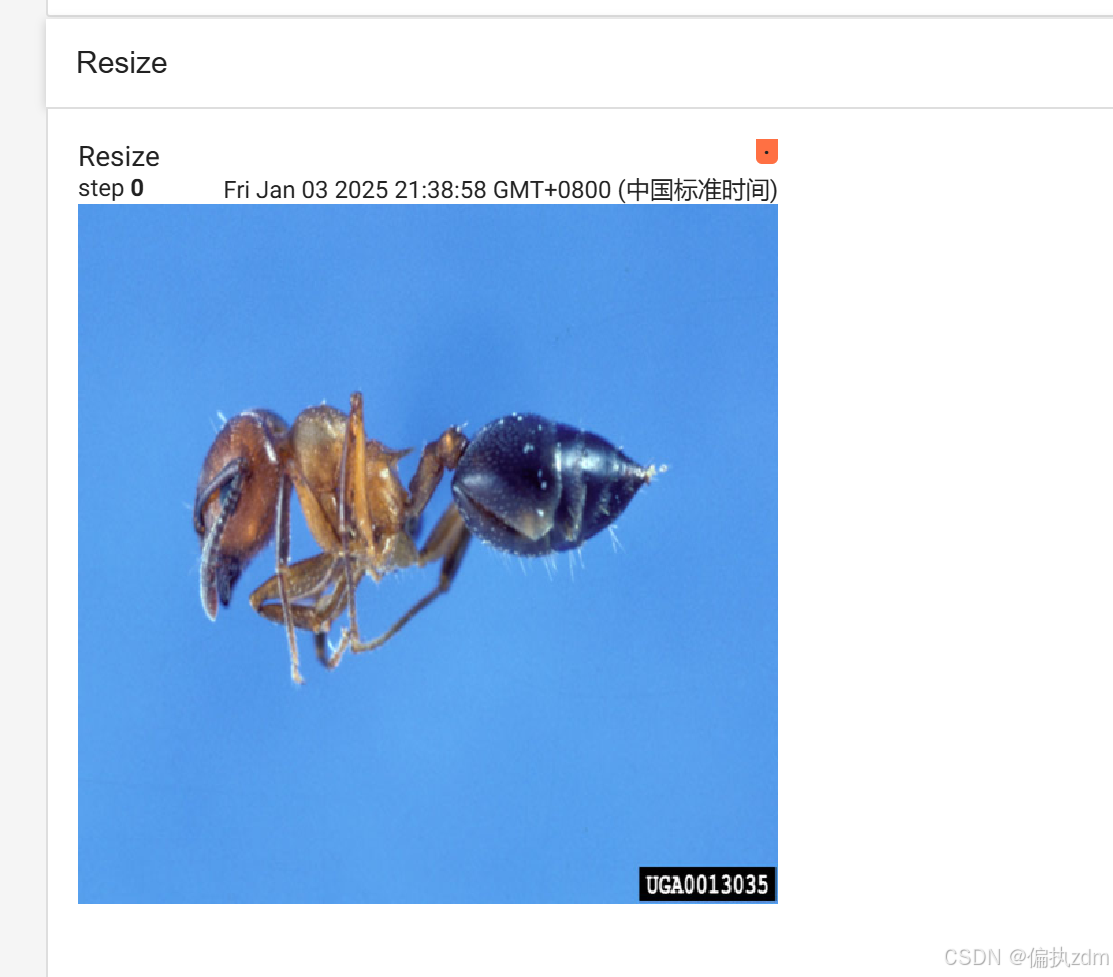
Resize的使用
# Resize
print(img.size)
trans_resize = transforms.Resize((512, 512))
# img PIL类型 -> Resize -> img_resize PIL类型
img_resize = trans_resize(img)
# img_resize PIL -> ToTensor -> tensoe类型
img_resize = trans_totensor(img_resize)
print((img_resize))
writer.add_image("Resize", img_resize)
- Compose的使用
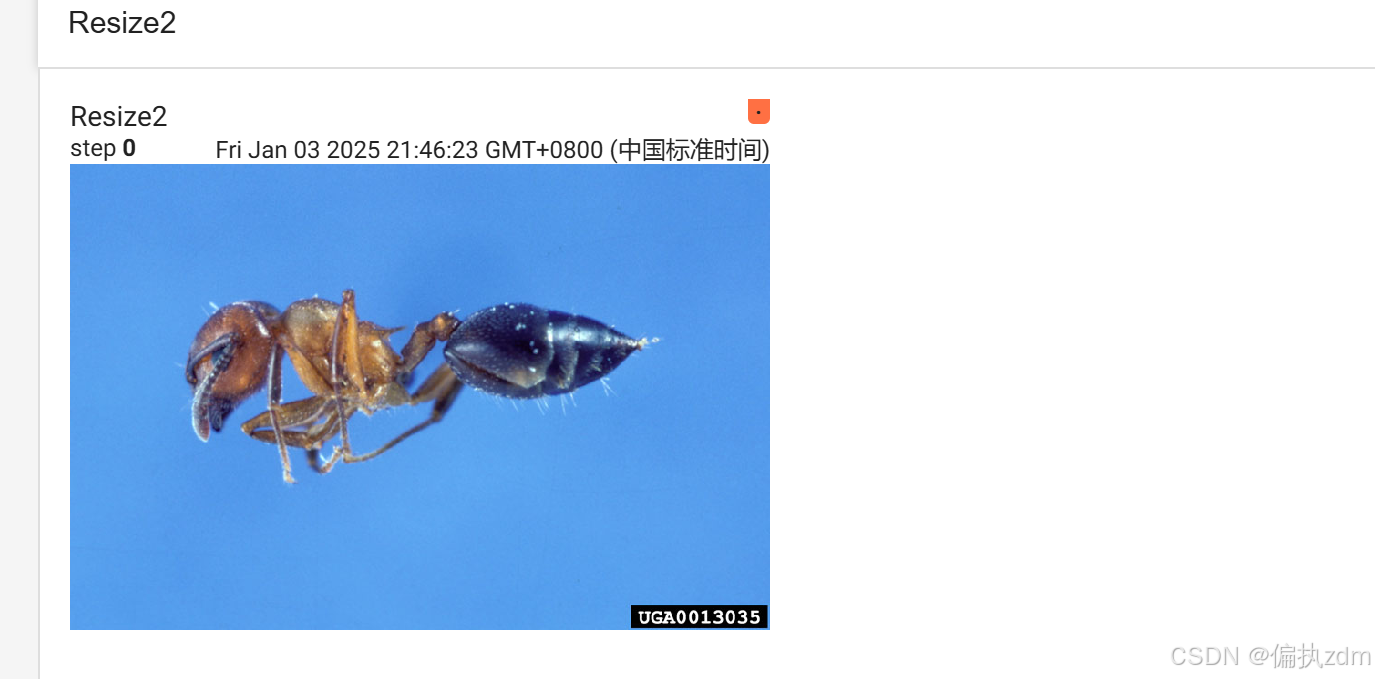
Compose()中的参数需要是一个列表,Python中,列表的表示形式为[数据1,数据2,…];在Compose中,数据需要是transforms类型,所以得到的是Compose([transforms1, transforms2, …])
# Compose - resize -2
trans_resize_2 = transforms.Resize(512)
# PIL > PIL > tensor
trans_compose = transforms.Compose([trans_resize_2, trans_totensor])
img_resize_2 = trans_compose(img)
writer.add_image("Resize2", img_resize_2, )
- RandomCrop的用法
# 随机裁剪:RandomCrop
trans_random = transforms.RandomCrop((500, 1000))
trans_compose_2 = transforms.Compose([trans_random, trans_totensor])
for i in range(10):
    img_crop = trans_compose_2(img)
    writer.add_image("RandomCrop", img_crop, i)
- 总结
- 需要关注输入和输出类型是什么,可以查看官方文档
- 关注方法需要什么参数
- 不确定返回值的时候:print、print(type())、debug
torchvision中数据集的使用
可以使用迅雷进行数据集的下载;相关练习如下:
# dataset 和 transforms的使用

import torchvision
from torch.utils.tensorboard import SummaryWriter

dataset_transform = torchvision.transforms.Compose([
    torchvision.transforms.ToTensor()
])

train_set = torchvision.datasets.CIFAR10(root="./CIFAR10", train=True, transform=dataset_transform, download=True)
test_set = torchvision.datasets.CIFAR10(root="./CIFAR10", train=False, transform=dataset_transform, download=True)

# print(test_set[0]) # (<PIL.Image.Image image mode=RGB size=32x32 at 0x28588226080>, 3)
# print(test_set.classes) # ['airplane', 'automobile', 'bird', 'cat', 'deer', 'dog', 'frog', 'horse', 'ship', 'truck']
#
# img, target = test_set[0]
#
# print(img) #
# print(target) # 3
#
# img.show()

# print(test_set[0])

# 使用tensorboard进行显示
writer = SummaryWriter("p10")
for i in range(10):
    img, target = test_set[i]
    writer.add_image("CIFAR10", img, i)
可以先下载好压缩包,在进行代码下载。
DataLoader 的使用
从dataset取数据,如何取?——通过DataLoader进行设置参数。
- dataset (必需): 用于加载数据的数据集,通常是torch.utils.data.Dataset的子类实例。
- batch_size (可选): 每个批次的数据样本数。默认值为1。
- shuffle (可选): 是否在每个周期开始时打乱数据。默认为False。 (一般会设置为true)
- sampler (可选): 定义从数据集中抽取样本的策略。如果指定,则忽略shuffle参数。
- batch_sampler (可选):与sampler类似,但一次返回一个批次的索引。不能与batch_size、shuffle和sampler同时使用。
- num_workers (可选): 用于数据加载的子进程数量。默认为0,意味着数据将在主进程中加载。 (当报错BrokenPipeError的时候可以尝试将该参数设置为0)
- collate_fn (可选): 如何将多个数据样本整合成一个批次。通常不需要指定。
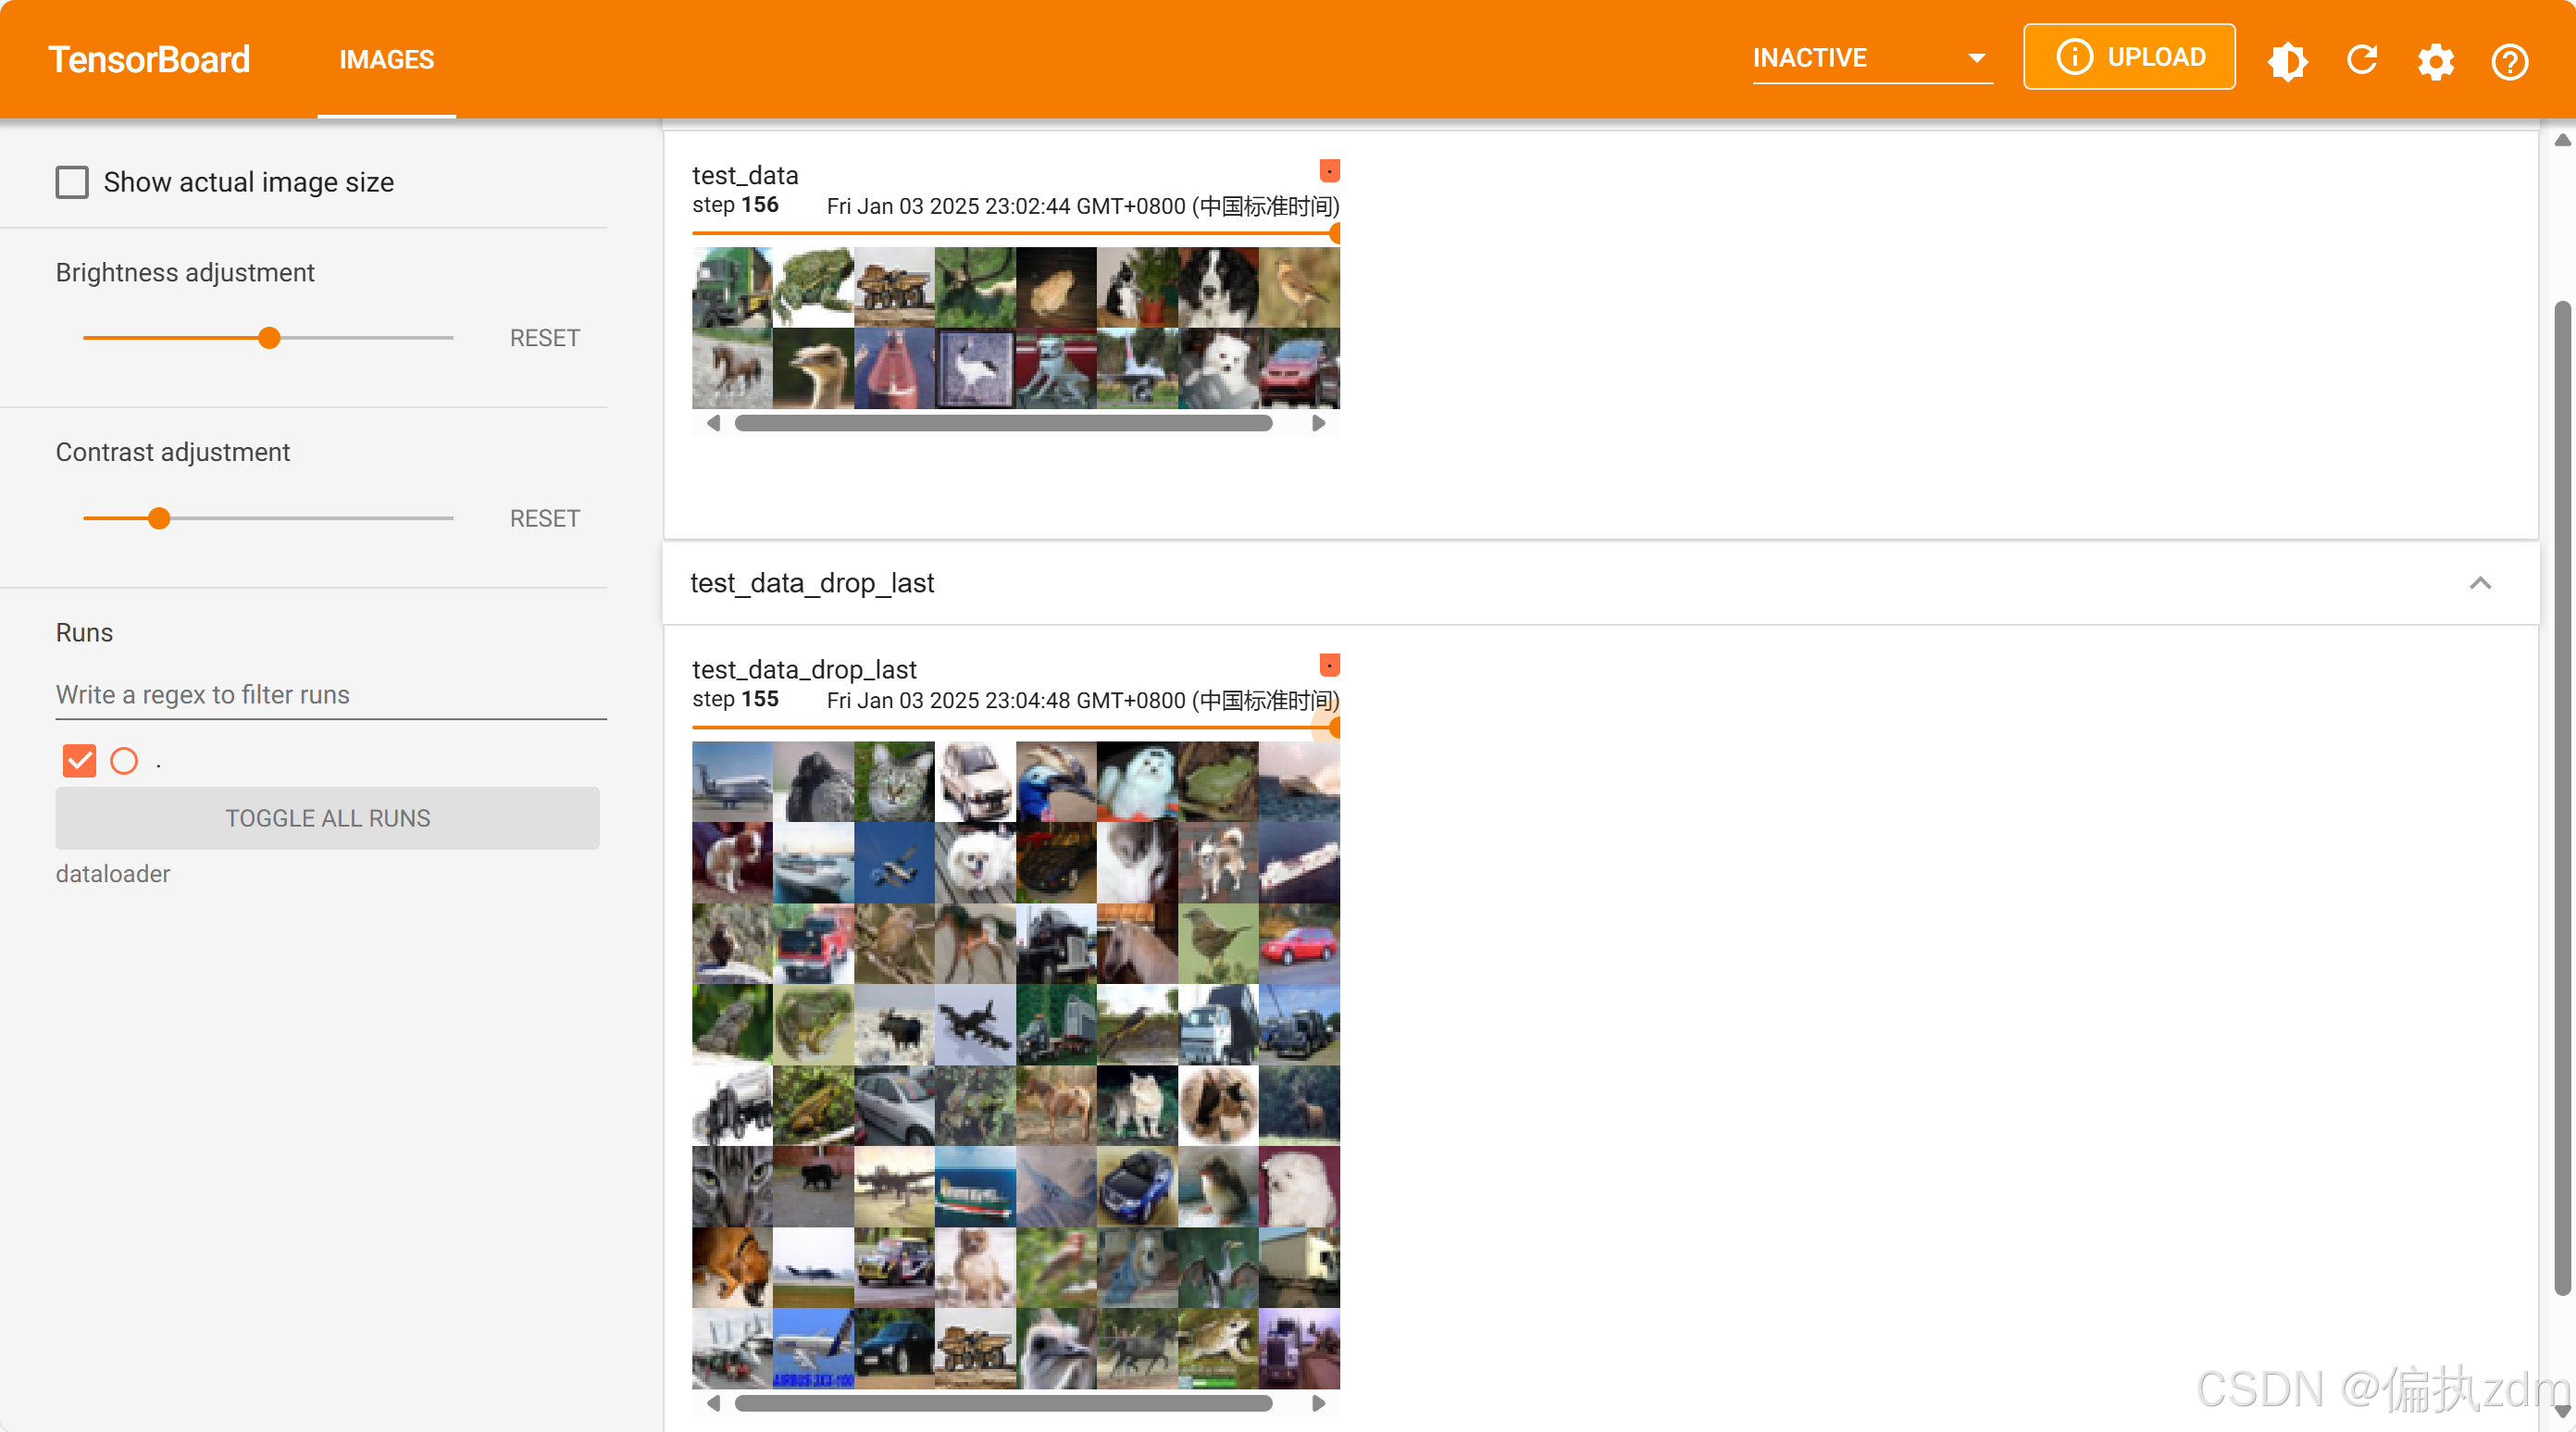
- drop_last (可选): 如果数据集大小不能被批次大小整除,是否丢弃最后一个不完整的批次。默认为False(如下图所示,当该值为true的时候最后不足64的就被丢弃了)
示例:
import torchvision
from torch.utils.data import DataLoader
from torch.utils.tensorboard import SummaryWriter

# 准备测试集
test_data = torchvision.datasets.CIFAR10("./CIFAR10", train=False, transform=torchvision.transforms.ToTensor())

# 从test_data取4个数据
test_loader = DataLoader(dataset=test_data, batch_size=64, shuffle=False, num_workers=0, drop_last=True)

# 测试集中的第一张图片及target
# img, target = test_data[0]
# print(img.shape)
# print(target)

writer = SummaryWriter("dataloader")
for epoch in range(2):
    step = 0
    for data in test_loader:
        imgs, targets = data
        # print(imgs.shape)
        # print(targets)
        writer.add_images("Epoch: {}".format(epoch), imgs, step)
        step = step + 1

writer.close()
神经网络的基本骨架–nn.Module的使用
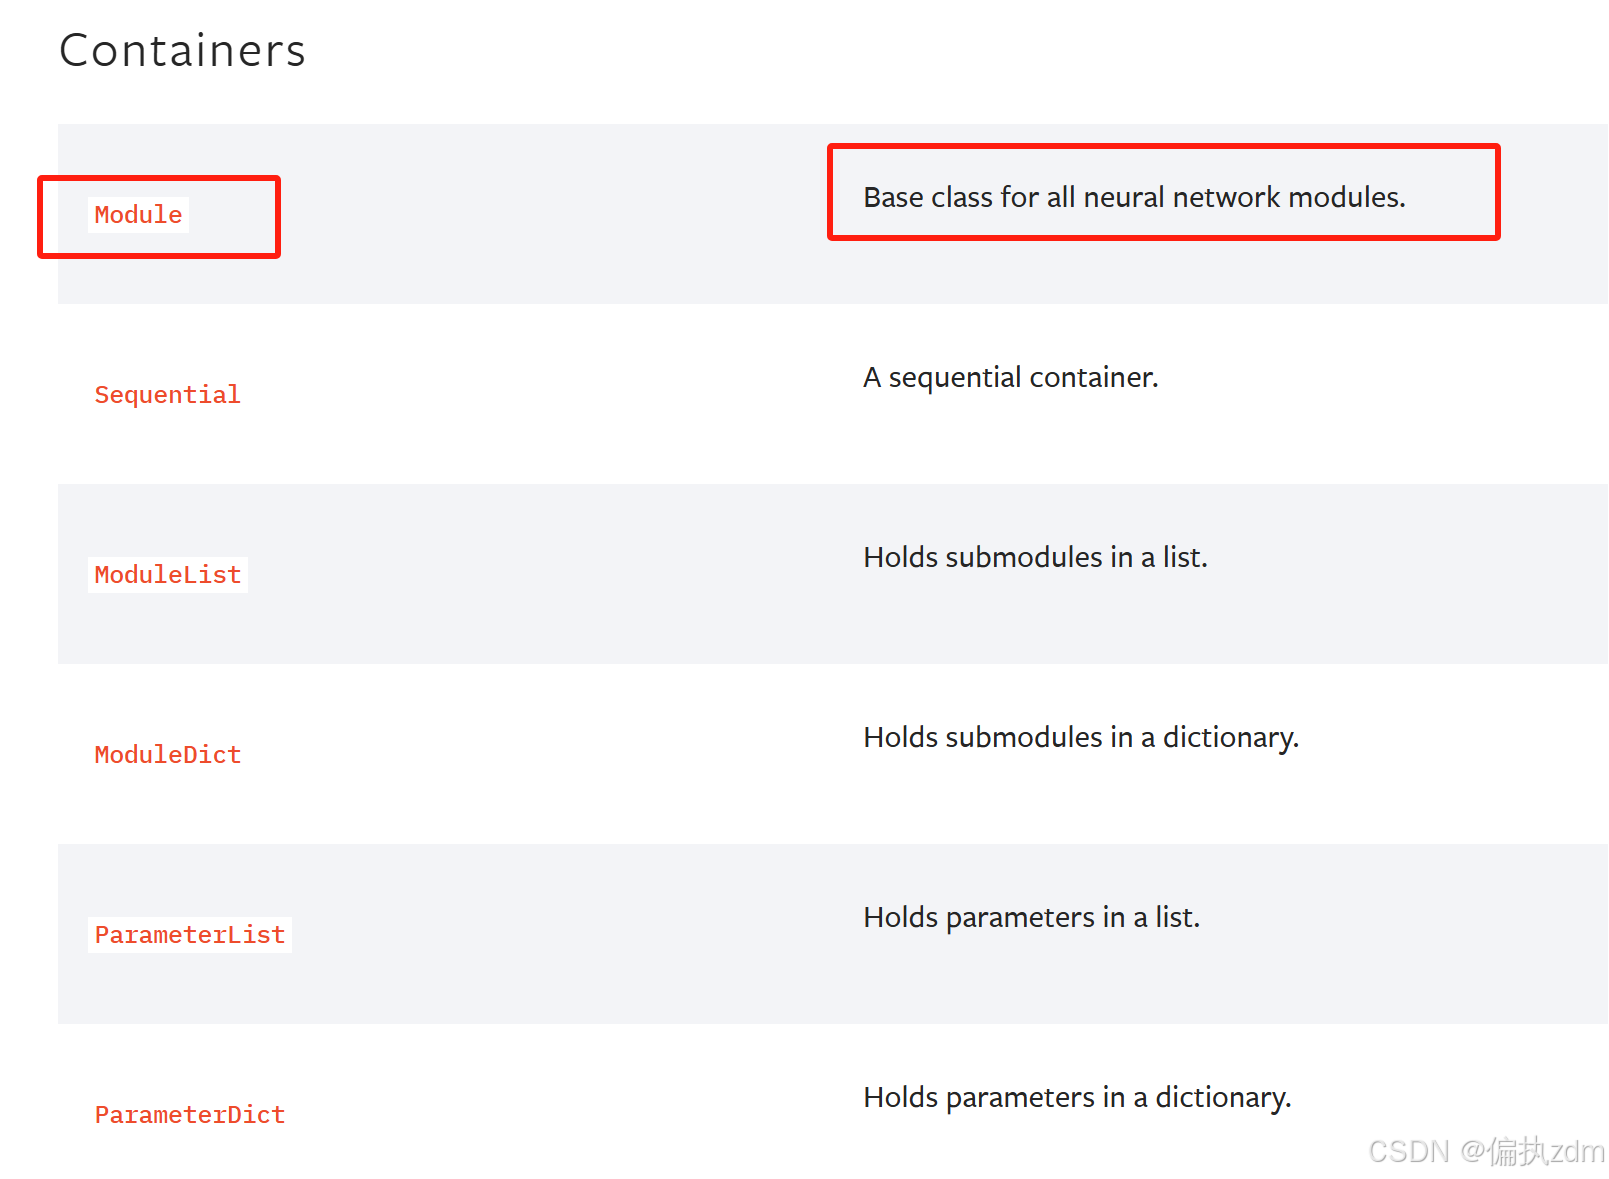
神经网络一个模板:
import torch.nn as nn
import torch.nn.functional as F

class Model(nn.Module):
    def __init__(self) -> None:
        super().__init__()
        self.conv1 = nn.Conv2d(1, 20, 5)
        self.conv2 = nn.Conv2d(20, 20, 5)
	# 向前传播
    def forward(self, x):
        x = F.relu(self.conv1(x))
        return F.relu(self.conv2(x))
流程:输入x --> 卷积 --> 非线性 --> 卷积 --> 非线性 --> 输出
例子:
import torch
from torch import nn
class Zdm(nn.Module):
    def __init__(self):
        super().__init__()

    def forward(self, input):
        output = input + 1
        return output

zz = Zdm()
x = torch.tensor(1.0)
output = zz(x)
print(output)
卷积操作
stride:卷积步长
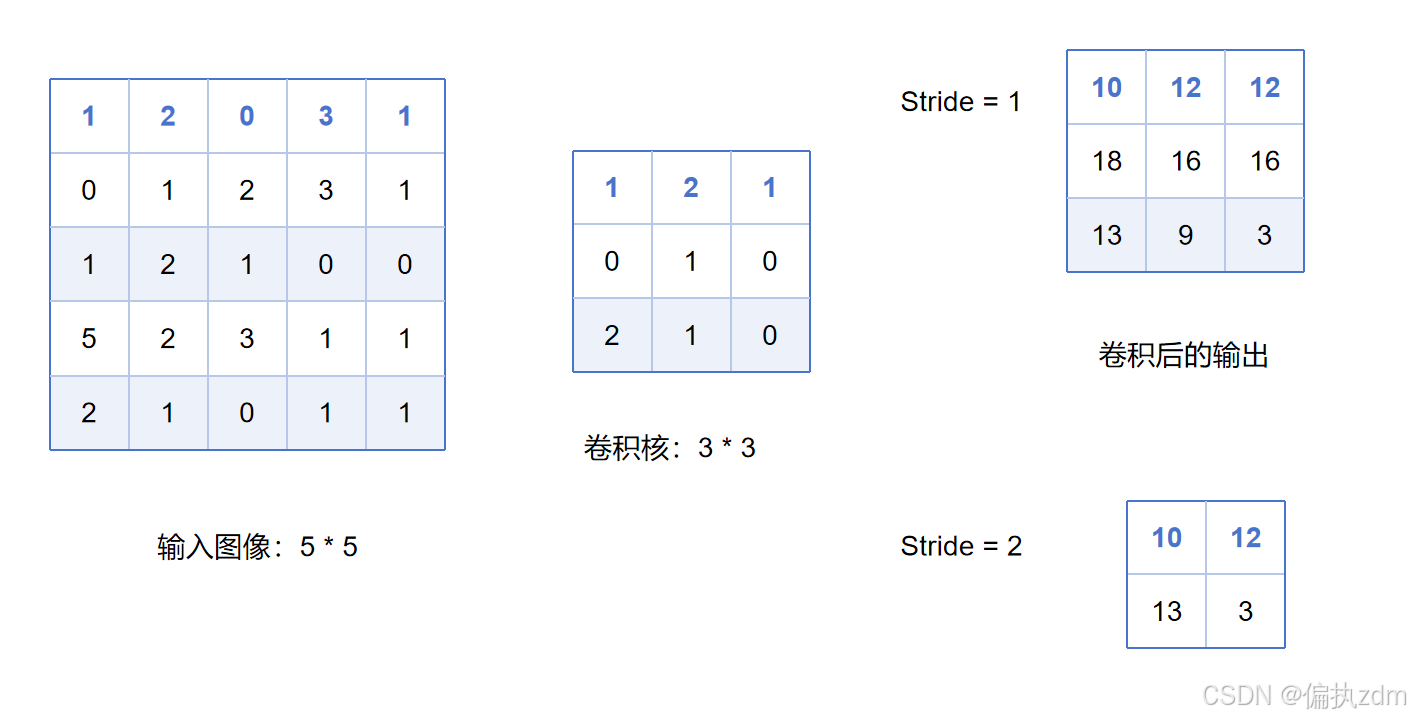
padding:在左右两边进行填充,默认不填充
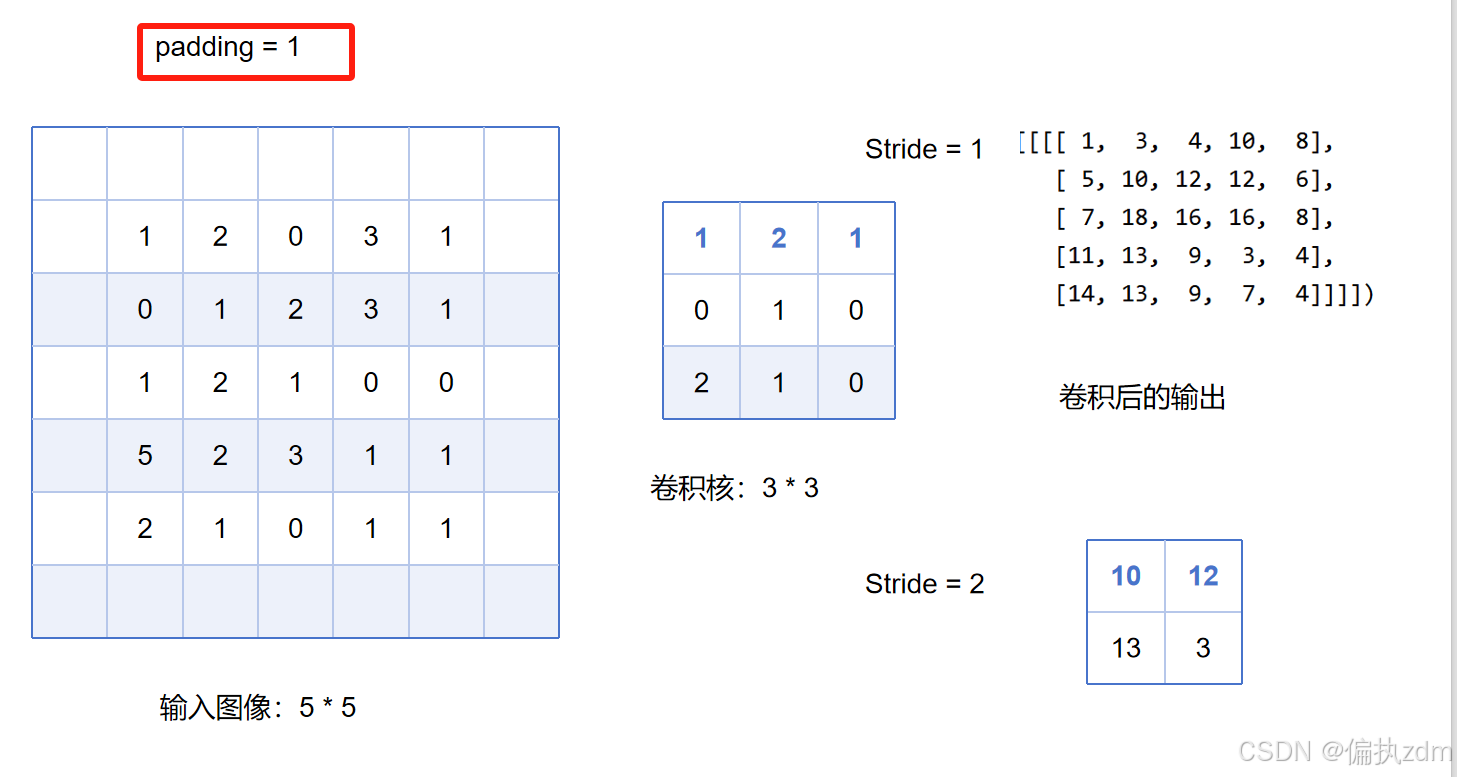
- 程序展示
import torch
import torch.nn.functional as F
input = torch.tensor([[1, 2, 0, 3, 1],
                      [0, 1, 2, 3, 1],
                      [1, 2, 1, 0, 0],
                      [5, 2, 3, 1, 1],
                      [2, 1, 0, 1, 1]])

kernel = torch.tensor([[1, 2, 1],
                       [0, 1, 0],
                       [2, 1, 0]])

# 尺寸变换
input = torch.reshape(input, (1, 1, 5, 5))
kernel = torch.reshape(kernel, (1, 1, 3, 3))

print(input.shape)
print(kernel.shape)

output = F.conv2d(input, kernel, stride=1)
print(output)

output2 = F.conv2d(input, kernel, stride=2)
print(output2)

output3 = F.conv2d(input, kernel, stride=1, padding=1)
print(output3)
先写到这里,明天继续。
更多推荐



 24
 0
- 0


 已为社区贡献3条内容

所有评论(0)