
Pytorch 学习 - 6.pytorch 张量数学-自动求取梯度
先掌握pytorch,学好pytorch, 才能学好人工智能
autograd
torch.autograd.backward
torch.autograd.backward 是 PyTorch 中用于自动计算张量(tensor)梯度的函数。在深度学习和神经网络训练中,梯度计算是反向传播算法的核心部分,它允许我们更新模型的权重以最小化损失函数。下面是对 torch.autograd.backward 函数的详细解释:
功能
torch.autograd.backward 函数用于计算图中所有需要梯度的叶子节点的梯度。这些叶子节点通常是模型的参数(如权重和偏置),它们被标记为 requires_grad=True。在调用此函数后,PyTorch 会自动计算这些叶子节点相对于某个标量(通常是损失函数值)的梯度。
使用方法
-
准备张量:首先,你需要确保你的模型参数(张量)设置了
requires_grad=True。这意味着 PyTorch 会跟踪对这些张量的所有操作,以便后续计算梯度。 -
前向传播:执行模型的前向传播,计算损失值。这个损失值应该是一个标量(单个数值),因为
torch.autograd.backward默认只能对标量进行操作。如果损失值是一个向量或矩阵,你需要指定一个gradient_arguments参数来指明对每个元素求导的权重。 -
调用
backward:调用torch.autograd.backward()或张量自身的.backward()方法来计算梯度。对于标量损失,不需要额外的参数。 -
更新参数:使用优化器(如 SGD, Adam 等)根据计算出的梯度更新模型参数。
参数
tensor(可选):如果你不是对某个标量直接调用torch.autograd.backward(),而是对一个非标量张量调用,你需要传递一个与这个张量形状相同的gradient参数,指明对每个元素的梯度贡献。retain_graph(布尔值,默认为False):如果设置为True,则保留计算图,用于多次调用backward。这在某些情况下很有用,比如当你需要在一个模型的不同部分多次计算梯度时。create_graph(布尔值,默认为False):如果设置为True,则对梯度计算图进行记录,以便计算更高阶的梯度。grad_tensors(可选):如果tensor不是标量,则需要传递一个与tensor形状相同的张量,表示对每个元素的梯度权重。
注意事项
- 每次调用
backward后,梯度会被累积到.grad属性中,而不是被覆盖。因此,如果你不想累积梯度,需要在每次调用backward前调用.zero_()方法清除梯度。 - 默认情况下,
backward只能对标量进行操作。如果你需要对非标量进行操作,需要传递grad_tensors参数。 - 在某些情况下,如循环神经网络中,可能需要使用
retain_graph=True来保留计算图,但这会增加内存消耗。
通过理解 torch.autograd.backward 的工作原理,你可以更有效地进行深度学习模型的训练和优化。
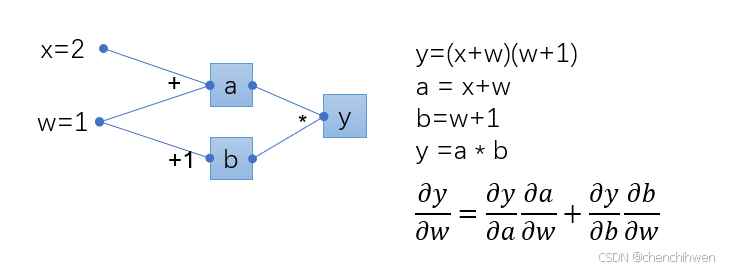
根据链式法则和乘法法则,我们可以这样计算:
b*1+a*1 = b+a = 2 + 3 = 5
import torch


w = torch.tensor([1.],requires_grad=True)
x = torch.tensor([2.],requires_grad=True)

a = torch.add(x,w)
b = torch.add(w,1)
y0 = torch.mul(a,b)
y1 = torch.add(a,b)
loss = torch.cat([y0,y1],dim=0) #[y0,y1]

grad_tensors = torch.tensor([1.,2.])
loss.backward(gradient=grad_tensors)
print('output','\n', 'x :', x,'w :', w,'a :', a,'b :', b,'y0 :', y0,'y1 :', y1,'loss :', loss)
# 查看梯度
print('grad :', 'x :', x.grad,'w :', w.grad,'a :', a.grad,'b :', b.grad,'y0 :', y0.grad,'y1 :', y1.grad,'loss :', loss.grad)
output
x : tensor([2.], requires_grad=True)
w : tensor([1.], requires_grad=True)
a : tensor([3.], grad_fn=<AddBackward0>)
b : tensor([2.], grad_fn=<AddBackward0>)
y0 : tensor([6.], grad_fn=<MulBackward0>)
y1 : tensor([5.], grad_fn=<AddBackward0>)
loss : tensor([6., 5.], grad_fn=<CatBackward0>)
grad :
x : tensor([4.])
w : tensor([9.]) a : None b : None y0 : None y1 : None loss : None
当 grad_tensors = torch.tensor([1.,1.]) ,w.grad = tensor([7.]) = 5+2
grad_tensors = torch.tensor([1.,3.]) ,w.grad = tensor([11.]) = 5+2*3
torch.autograd.grad。
功能概述
- 作用
- 在 PyTorch 中,
torch.autograd.grad用于计算梯度。它是自动求导机制的一部分,在深度学习中,计算梯度对于优化模型参数(如在神经网络中更新权重)是非常关键的操作。
- 在 PyTorch 中,
- 与计算图的关系
- PyTorch 通过构建计算图来记录张量之间的运算关系。当调用
torch.autograd.grad时,它会根据这个计算图来计算所需张量相对于其他张量的导数。
- PyTorch 通过构建计算图来记录张量之间的运算关系。当调用
函数参数
- 基本参数
outputs:这是需要求导的张量或者张量的元组。例如,在一个神经网络中,它可能是损失函数的值。inputs:这是相对于哪些张量求导,是一个张量或者张量的元组。例如,在神经网络中,可能是模型的权重和偏置等参数。grad_outputs(可选):如果outputs不是标量(即一个单独的数),那么需要提供grad_outputs,它表示outputs关于外部梯度的预乘因子。retain_graph(可选):默认值为False。如果设置为True,则计算完梯度后不会释放计算图中的中间变量,这在需要多次反向传播(例如计算二阶导数)时是有用的。create_graph(可选):默认值为False。如果设置为True,将会创建一个新的计算图,这样可以用于计算高阶导数。
示例
以下是一个简单的示例:
import torch

x = torch.tensor([2.0], requires_grad = True)
y = x ** 2
z = torch.square(x)
# 计算y关于x的导数
grad = torch.autograd.grad(y, x,create_graph=True)
print(grad)
grad2 = torch.autograd.grad(grad[0],x)
print(grad2)
(tensor([4.], grad_fn=<MulBackward0>),)
(tensor([2.]),)
在这个示例中:
- 首先创建了一个张量
x,并设置requires_grad = True,表示这个张量在计算过程中需要跟踪其梯度。 - 然后计算
y = x ** 2。 - 最后使用
torch.autograd.grad计算y关于x的导数,得到的结果是[4.],因为y = x^2的导数是2x,当x = 2时,导数为4。 create_graph(可选):默认值为False。如果设置为True,将会创建一个新的计算图,这样可以用于计算高阶导数。-
grad2 = torch.autograd.grad(grad[0],x) 是二阶求导
grad.zero_()
在 PyTorch 中,grad.zero_()(注意方法名中有一个下划线)通常用于将模型参数的梯度清零。以下是详细介绍:
作用与重要性
在深度学习的训练过程中,每次进行反向传播计算梯度后,梯度会累加到参数的.grad属性中。如果不及时清零梯度,那么在后续的迭代中,新计算出的梯度会与之前未清零的梯度累加,这将导致梯度计算错误,进而影响模型的训练效果。因此,在每一轮训练迭代开始前,通常需要将模型参数的梯度清零。
使用方法及示例
import torch


w = torch.tensor([1.], requires_grad=True)
x = torch.tensor([2.], requires_grad=True)


for i in range(4):
    a = torch.add(x,w)
    b = torch.add(w,1)
    y = torch.mul(a,b)
    y.backward()
    print(w.grad)

    # w.grad.zero_() # 清0
tensor([5.])
tensor([10.])
tensor([15.])
tensor([20.])
假设我们有一个简单的神经网络模型,如下所示:
import torch
import torch.nn as nn

class Net(nn.Module):
    def __init__(self):
        super(Net, self).__init__()
        self.fc1 = nn.Linear(10, 5)
        self.fc2 = nn.Linear(5, 2)

    def forward(self, x):
        x = torch.relu(self.fc1(x))
        return self.fc2(x)

model = Net()
在训练循环中,我们通常会这样使用grad.zero_():
optimizer = torch.optim.SGD(model.parameters(), lr=0.01)

for epoch in range(10):
    for inputs, labels in data_loader:
        optimizer.zero_grad()
        outputs = model(inputs)
        loss = loss_function(outputs, labels)
        loss.backward()
        optimizer.step()
在这个训练循环中:
optimizer.zero_grad()这一行代码会遍历模型的所有参数,并将它们的梯度清零。- 接着,前向传播计算输出
outputs,然后根据输出和标签计算损失loss。 loss.backward()进行反向传播,计算参数的梯度。- 最后,
optimizer.step()根据计算出的梯度更新模型参数。
三、注意事项
- 确保在正确的位置调用
grad.zero_():一般是在每一轮迭代的开始,就在计算损失之前调用。如果忘记清零梯度,可能会导致训练结果不准确。 - 不同优化器的清零方法:虽然大多数情况下我们使用
optimizer.zero_grad()来清零梯度,但也可以直接对模型参数进行清零操作,例如for param in model.parameters(): param.grad.zero_()。不过,使用优化器提供的方法更加简洁和通用,因为它可以处理不同类型的优化器。
更多推荐



 9
 0
- 0


 已为社区贡献4条内容

所有评论(0)