
pytorch|autograd使用、训练模型
系列文章目录
PyTorch|Dataset与DataLoader使用、构建自定义数据集
PyTorch|搭建分类网络实例、nn.Module源码学习
文章目录
一、autograd
在训练神经网络时,最常用的算法是反向传播算法。在该算法中,根据损失函数相对于给定参数的梯度来调整参数(模型权重)。为了计算这些梯度,PyTorch有一个内置的微分引擎,叫做torch.autograd,它支持任何计算图的梯度自动计算。
考虑最简单的单层神经网络,输入x,参数w和b,以及一些损失函数。它可以在PyTorch中以以下方式定义:
import torch

x = torch.ones(5)  # input tensor
y = torch.zeros(3)  # expected output

# 传入requires_grad意味着会计算梯度
w = torch.randn(5, 3, requires_grad=True)
b = torch.randn(3, requires_grad=True)
# 预测输出
z = torch.matmul(x, w)+b
loss = torch.nn.functional.binary_cross_entropy_with_logits(z, y)
(一)设定需要计算梯度的参数
对于一个参数,如果需要计算其梯度,有两种方法:
- 在创建张量时直接设置requires_grad
- 创建张量后,调用 x.requires_grad_(True)方法
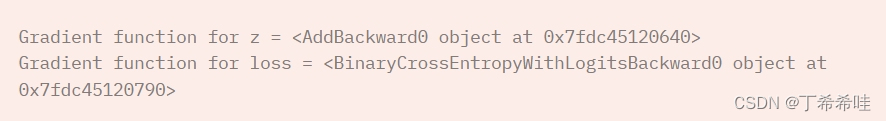
对于设置了requires_grad=True的参数,都可以打印对应的grad_fn:
print(f"Gradient function for z = {z.grad_fn}")
print(f"Gradient function for loss = {loss.grad_fn}")
(二)梯度计算
怎么样计算每个参数的梯度?只需要对要求的根节点调用backward函数就好了
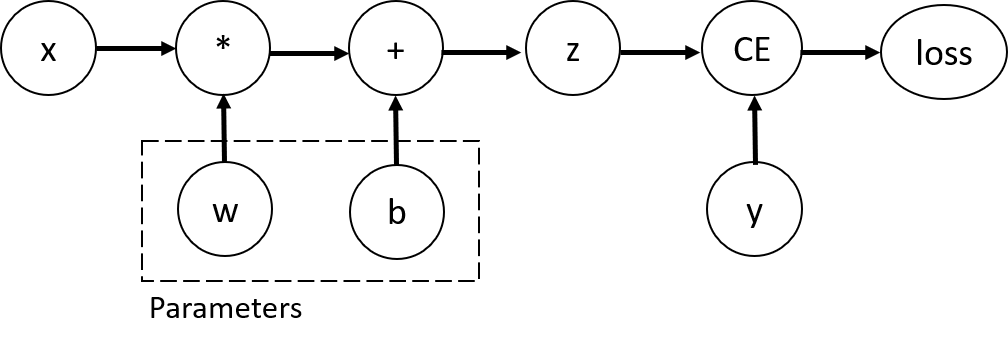 backward函数其实是tensor类的一个方法:
loss必须是一个标量,如果是loss是一个元素个数大于1的张量,括号里需要传入一个vector
loss.backward()
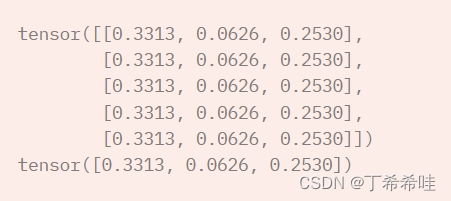
print(w.grad)
print(b.grad)
梯度的shape其实跟节点自身的shape是一样的:
(三)停止梯度计算
默认情况下,所有requires_grad=True的张量都在跟踪它们的计算历史并支持梯度计算。然而,某些情况可能需要我们禁用梯度跟踪:
- 将神经网络中的某些参数标记为冻结参数。
- 只做正向传递时,为了加快计算速度,因为在不跟踪梯度的张量上的计算会更有效率。
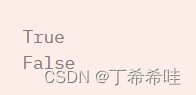
z = torch.matmul(x, w)+b
print(z.requires_grad)

with torch.no_grad():
    z = torch.matmul(x, w)+b
print(z.requires_grad)
只要父节点中有一个是require_grad=true,那么该节点就会计算梯度,比如这里的z。但是当设置with torch.no_grad()之后就不会计算梯度。
另外也可以通过调用detach方法达到同样的效果
z = torch.matmul(x, w)+b
z_det = z.detach()
print(z_det.requires_grad)
(四)梯度清零
pytorch中默认情况下梯度是会累积的。所以会调用zero_grad()
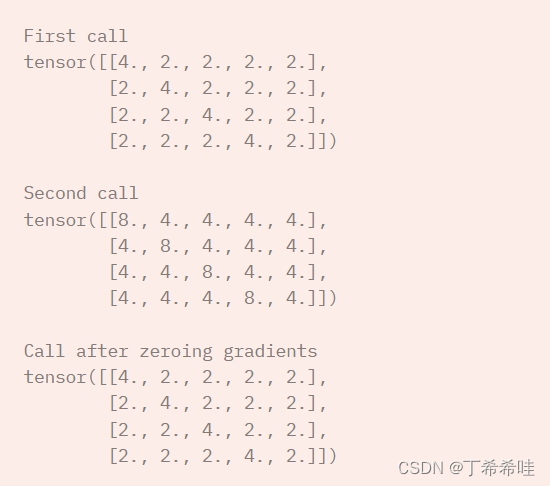
(五)张量梯度和雅可比积
inp = torch.eye(4, 5, requires_grad=True)
out = (inp+1).pow(2).t() #不是标量

out.backward(torch.ones_like(out), retain_graph=True) #矩阵对矩阵求导的时候需要传入一个vector,vector的大小与out保持一致
print(f"First call\n{inp.grad}")

#传入了 retain_graph=True,原因是下边进行了第二次调用
out.backward(torch.ones_like(out), retain_graph=True)
print(f"\nSecond call\n{inp.grad}")

#梯度清零之后调用第三次
inp.grad.zero_()
out.backward(torch.ones_like(out), retain_graph=True)
print(f"\nCall after zeroing gradients\n{inp.grad}")
二、训练模型
(一)数据准备和模型构建
import torch
from torch import nn
from torch.utils.data import DataLoader
from torchvision import datasets
from torchvision.transforms import ToTensor

training_data = datasets.FashionMNIST(
    root="data",
    train=True,
    download=True,
    transform=ToTensor()
)

test_data = datasets.FashionMNIST(
    root="data",
    train=False,
    download=True,
    transform=ToTensor()
)

train_dataloader = DataLoader(training_data, batch_size=64)
test_dataloader = DataLoader(test_data, batch_size=64)

class NeuralNetwork(nn.Module):
    def __init__(self):
        super().__init__()
        self.flatten = nn.Flatten()
        self.linear_relu_stack = nn.Sequential(
            nn.Linear(28*28, 512),
            nn.ReLU(),
            nn.Linear(512, 512),
            nn.ReLU(),
            nn.Linear(512, 10),
        )

    def forward(self, x):
        x = self.flatten(x)
        logits = self.linear_relu_stack(x)
        return logits

model = NeuralNetwork()
(二)定义超参数
常见的需要定义的用于训练的超参数:
- epoch的次数——在数据上迭代的次数;
- batch Size——在参数更新之前通过网络传播的数据样本的数量;
- learning Rate——在每个batch/epoch更新模型参数的次数。
learning_rate = 1e-3
batch_size = 64
epochs = 5
(三)定义目标函数
# Initialize the loss function
loss_fn = nn.CrossEntropyLoss()
(四)定义优化器
优化器一般至少有两个参数:需要更新的模型的参数、学习率
optimizer = torch.optim.SGD(model.parameters(), lr=learning_rate)
在训练循环中,优化分三步进行:
- 需要先调用optimizer.zero_grad(),对模型参数的梯度进行重置
在pytorch中,参数的梯度会默认进行累计,了防止重复计数,每次迭代时需要显式地将它们归零。
- 调用loss.backward()反向传播预测损失
- 计算梯度之后再调用optimizer.step()函数完成对于参数的更新
(五)完整实现
单步训练和单步测试:
def train_loop(dataloader, model, loss_fn, optimizer):
    size = len(dataloader.dataset)
    # Set the model to training mode - important for batch normalization and dropout layers
    # Unnecessary in this situation but added for best practices
    model.train()
    for batch, (X, y) in enumerate(dataloader):
        # Compute prediction and loss
        pred = model(X)
        loss = loss_fn(pred, y)

        # Backpropagation
        loss.backward()
        optimizer.step()
        optimizer.zero_grad()

        if batch % 100 == 0:
            loss, current = loss.item(), batch * batch_size + len(X)
            print(f"loss: {loss:>7f}  [{current:>5d}/{size:>5d}]")


def test_loop(dataloader, model, loss_fn):
    # Set the model to evaluation mode - important for batch normalization and dropout layers
    # Unnecessary in this situation but added for best practices
    model.eval()
    size = len(dataloader.dataset)
    num_batches = len(dataloader)
    test_loss, correct = 0, 0

    # Evaluating the model with torch.no_grad() ensures that no gradients are computed during test mode
    # also serves to reduce unnecessary gradient computations and memory usage for tensors with requires_grad=True
    with torch.no_grad():
        for X, y in dataloader:
            pred = model(X)
            test_loss += loss_fn(pred, y).item()
            correct += (pred.argmax(1) == y).type(torch.float).sum().item()

    test_loss /= num_batches
    correct /= size
    print(f"Test Error: \n Accuracy: {(100*correct):>0.1f}%, Avg loss: {test_loss:>8f} \n")
周期训练:
loss_fn = nn.CrossEntropyLoss()
optimizer = torch.optim.SGD(model.parameters(), lr=learning_rate)

epochs = 10
for t in range(epochs):
    print(f"Epoch {t+1}\n-------------------------------")
    train_loop(train_dataloader, model, loss_fn, optimizer)
    test_loop(test_dataloader, model, loss_fn)
print("Done!")
更多推荐


 14
 0
- 0


 已为社区贡献3条内容

所有评论(0)