
pytorch中遇到的常见的错误处理
1、RutimeError: Expected object of scalar type Float but got scalar type Double for argument #2 'mat1'
当出现以上问题时候,是格式错误:
错误语句:
model_train_x = torch.tensor(model_train_x.values)
该语句中,tensor的默认类型是Float64,需要修改类型成为float32才可以
网上大多数的修改意见是:
1、model_train_x = torch.from_numpy(model_train_x.astype(np.float32))
2、model_train_x = torch.from_numpy(model_train_x.values)
我试了一下不是很可行,依然在报错,我采用如下的操作进行处理之后,操作成功:
model_train_x = torch.tensor(model_train_x.values,dtype=torch.float32)
2、pytorch的形状更改:
我们在改变torch的类型的时候,通常需要进行reshape:
正确的改该方式为:
moodel_train_x = torch.reshape(model_train_x,(1,192,25))
其中model_train_x为处理好的tensor数据,(a,b,c)为更改的形状
3、ValueError: expected sequence of length 72 at dim 1 (got 167)
这个问题出现在对tensor的转换中
tensor的转换要求内部的数组维度相同:例如
model_train_x = [[1],[2,3],[3,4,5,6,6]]
model_train_y = torch.tensor(model_train_y,dtype=torch.float32)
是不可行的,,需要调整数据子集的长度。
4、Cannot convert a symbolic Tensor (lstm/strided_slice:0) to a numpy array.
转换的问题,解决方案之一就是看看numpy版本是否合适
pip install -U numpy==1.19.2
安装新版本的numpy
5、ValueError: ('Lengths must match to compare', (20631,), (4,))
我产生问题的行数:
##错误代码
engno = [1,2,3,4]
for numb in engno:
    eng_df = train_df[train_df['id']==engno]
错误在于将数组进行了赋值
改正后可以运行的,该问题就是将数组赋值给了单个值
##错误代码
engno = [1,2,3,4]
for numb in engno:
    eng_df = train_df[train_df['id']==numb]
6、keras-tcn:ModuleNotFoundError: No module named 'tcn' ////No module named 'TCN'
在你安装好keras-tcn包的时候,如果发现,使用
import tcn
from tcn import *
是不出问题的 ,但是在引入TCN等包的时候发现了问题。
解决方法一:
复制tcn包到anaconda的目录下。注意,这里是安装后产生的tcn的包,并非keras-tcn包
解决方法 二:
使用以下命令:
import sys
sys.path.append("tcn文件所在的位置")
解决方法三:
如果以上两种方法都不好用。试着查看一下,看看上一级乃至上上级别文件夹的命名是否与tcn冲突
7、pycharm在安装成功后发现在setting中搜索不到自己安装好的包
将conda的那个图标点灭,让pycharm去仓库中搜索
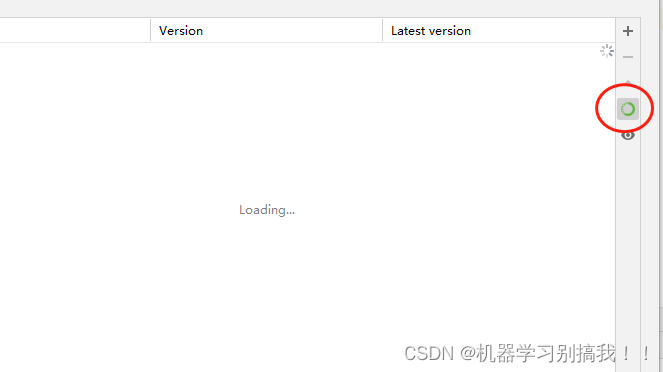
8、Unknown layer: TCN
在load_model时候,处理自定义函数,需要在函数中添加说明
解决方法就是在custom_objects中添加如下说明
"TCN":TCN
添加过后成为如下
load_model("../final_get/tcn_final/" + filename + ".h5",custom_objects={"rmse": rmse, "k_score": k_score,"TCN":TCN})
9、Fatal Python error: init_sys_streams: can't initialize sys standard streams
这个问题,最坑人,一定要注意不要在项目中设置名字为abc.py的文件,否则就会报这个错误。该错误就是,在io.py调用了abc.py过程中,指向不明确导致该类问题。
10、save_model()` using h5 format requires h5py. Could not import h5py.
该错误主要出现在调用了h5py的问题中出现了包的找不到
该错误分为两种,一种是再找包时候,setting不成功,还有一种是setting成功但是,依然导入不进去
解决该问题的方法目前有如下几种:
1、可能是h5py包的缺失,进行手动安装h5py的包
pip install h5py
或者卸载重新安装h5py包(此处的卸载重新安装不可以处于项目下,应该置于系统环境下)
pip uninstall h5py
pip install h5py
2、h5py包的版本和keras的版本不兼容的,进行包的升级,包向下兼容
pip install --upgrade h5py
3、上述解决办法都失效,则进行手动下载和安装,安装到项目所在的annocade的环境的site下。
4、写在最后的一种办法,如果上述方法都不可行,则考虑是否是因为电脑未更新过来的原因;我自己在搭建环境过程中曾经出现过这种问题,在发生问题后,将所有的方法都进行了使用,还是不行。最后关机跑路。在第二天没有更新环境下,实验跑通了。因此,也有电脑配置没有反应过来的原因并不是由于外界因素导致的。(玄学方法,但是亲测好用)
11、Exception encountered when calling layer "max_pooling2d" (type MaxPooling2D).
该问题是出现在使用2维池化过程中。在二维池化过程中,如果处理的池化块时候,如果计数是奇数则会出现问题。出现问题的代码如下:
pool1 = MaxPooling2D(pool_size=(2,2))(bn2)
修改该处代码如下:
pool1 = MaxPooling2D(pool_size=(2,2),padding="same")(bn2)
keras中的padding是分为两种
padding='valid'(默认)
    和
padding="same"
padding-same是将卷积损失的维度使用0补充回来。
12、invalid literal for int() with base10:'0.9912297987616655'
出现问题的代码段为:
a[i] = int(a[i])
其中a为序列数组,其中每个值为'0.99122x',这是float类型,不能连续跨转类型。
处理方法是:强制转换类型使用float
a[i] = float(a[i])
13、NotebookApp.iopub_data_rate_limit=1000000.0 (bytes/sec)
这个问题是出现在jupyter笔记本的计算速度,解决方法是调整jupyter_notebook_config.py
解决方法:
首先找到Anoconda Prompt---->位置和Anoconda处于相同位置
然后输入:
jupyter notebook --generate-config
生成一个jupyter_notebook_config.py的地址
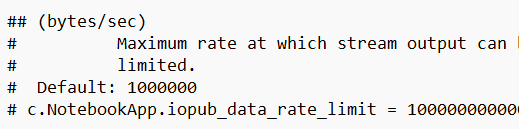
默认是1000000,我们把注释去掉添加一些0
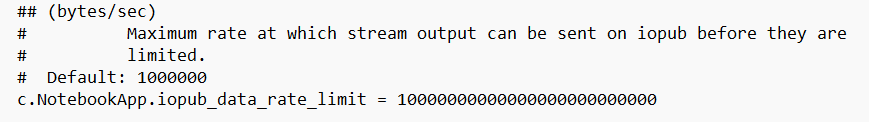
最后,重新启动一下就可以了。
14、'History' object has no attribute 'predict'
问题出现的情况:当我们搭建的模型是如下结构的时候,会出现这样的情况。
model = keras.models.Sequential([
        keras.layers.Dense(hidden1, activation='relu')
])

early_stopping = keras.callbacks.EarlyStopping(patience=5)

model.compile(optimizer='adam', loss='rmse')
auto =model.fit(train_all,train_label,validation_split=0.2)

label_df =auto.predict(test_all)
对搭建后训练好的模型直接进行predict时,会出现上方的参数缺少的情况。
此时对模型设置监测点,将最优的模型保存到整体模型中
model_checkpoint = keras.callbacks.ModelCheckpoint(
    filepath="../filename.h5", save_best_only=True, verbose=1
)
然后通过keras中的load_model进行调用
keras.models.load_model("../filename")
15、WARNING:tensorflow:Early stopping conditioned on metric `val_loss` which is not available. Available metrics are: loss
在训练过程中出现这个情况,这是由于在训练过程中,没有对验证集进行明确的划分,此时需要对验证集在keras中进行给出。
#开始版本
auto = AutoEncoder.fit(x,y, epochs=1)
#更改版本
auto = AutoEncoder.fit(x,y, epochs=1,validation_split=0.2)
更多推荐


 2
 0
- 0


 已为社区贡献1条内容

所有评论(0)