
史上第二简单的WGAN的pytorch实现
·
1. GAN的缺点
上一篇讲了GAN,其实代码中展示的那种生成器G的表达式,有一个很大的缺点,就是梯度消失严重。其实除了上一篇文章写的那种表达式,还有另一种方法,但是第二种方法也面临梯度不稳定和模式崩塌的问题。具体原因建议移步哔哩哔哩找李宏毅老师。
基础GAN的生成器和判别器损失迭代10000次数据如下面几张图所示。判别器一开始分数很高接近1,因为他能很轻易分辨,生成器一开始分数很低,因为很难生成符合条件的分布。
但是随着迭代次数不断增加,二者都趋近0.5,难舍难分,说明达到了最优状态。判别器已经分不出哪些是真实数据哪些是生成数据了,下面三张图都大概在接近10000次才能达到最优。


2. WGAN的改进
上述原因和kl散度,js散度,sigmod函数有关。未来更好的度量两个分布之间的距离,WGAN讲原始的判别器改为了计算两个分布之间的推土机距离,具体算法如下:

其实改进只有四点:
- 判别器最后一层去掉sigmod
D = nn.Sequential( #定义判别器
    nn.Linear(2,64),
    nn.ReLU(),
    nn.Linear(64,1),
    #nn.Sigmoid()
)
- 生成器和判别器的loss不取log
G_loss = -torch.mean(pro_atrist1)
D_loss = -torch.mean(pro_atrist0-pro_atrist1)
- 每次更新D的参数前进行梯度裁剪截断到固定常数c
for p in D.parameters():
     p.data.clamp_(-0.01, 0.01)
- 不用动量的优化算法,推荐RMSprop或者SGD
optimizer_G = torch.optim.RMSprop(G.parameters(),lr=0.0001) #定义生成器优化函数
optimizer_D = torch.optim.RMSprop(D.parameters(),lr=0.0001) #定义判别器优化函数
3. 实验效果
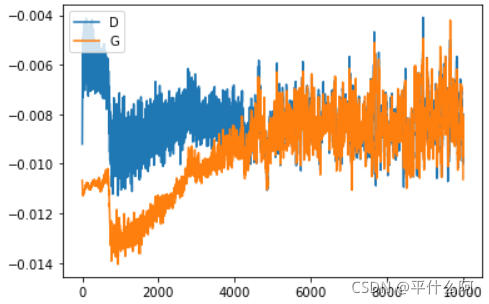
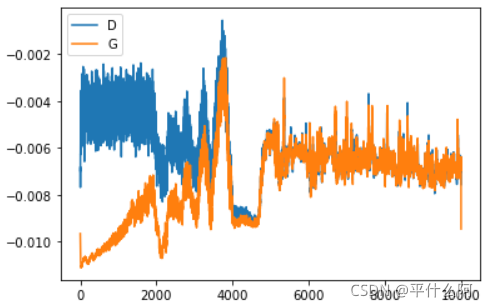
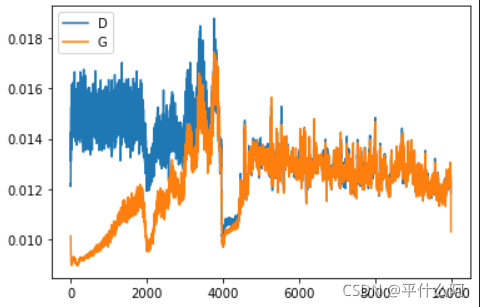
下面是WGAN的效果,可以看出在4000次左右判别器就无法进行区分了,对比原始的GAN有很大的提升。
4. 完整代码
import torch
import torch.nn as nn
import matplotlib.pyplot as plt
import numpy as np

real_data_num = 1000 #真实数据数量
batch = 64 #每次运算处理多少数据

def make_data(w, b, data_num):
    """生成 Y = Xw + b + 噪声的实验数据。数据大小data_num*2"""
    X = torch.randn(data_num)
    Y = X*w + b
    Y += torch.normal(0, 1, Y.shape)
    X = X.view(len(X),1)
    Y = Y.view(len(Y),1)
    data = torch.cat((X, Y), dim=1)
    return data

real_data = make_data(w = 3, b = 1, data_num = 1000) #生成真实数据样本

G = nn.Sequential( #定义生成器,
    nn.Linear(2,64),
    nn.ReLU(),
    nn.Linear(64,2)
)
D = nn.Sequential( #定义判别器
    nn.Linear(2,64),
    nn.ReLU(),
    nn.Linear(64,1),
    #nn.Sigmoid()
)

optimizer_G = torch.optim.RMSprop(G.parameters(),lr=0.0001) #定义生成器优化函数
optimizer_D = torch.optim.RMSprop(D.parameters(),lr=0.0001) #定义判别器优化函数

GD = np.zeros((10001,2))

for step in range(10001): #运算10001次

    """更新5次判别器D"""
    for stepp in range(5):
        A = np.arange(1,1000)
        a = np.random.choice(A, 64)
        real_data_sample = real_data[a] #上面三行对真实数据采样

        noise_z =  torch.Tensor(np.random.rand(64,2)) #产生随机向量
        G_make = G(noise_z) #随机向量丢进G生成

        pro_atrist0 = D(real_data_sample)#给真值打分
        pro_atrist1 = D(G_make)#给假值打分

        G_loss = -torch.mean(pro_atrist1)
        D_loss = -torch.mean(pro_atrist0-pro_atrist1)

        optimizer_D.zero_grad()
        D_loss.backward( )
        optimizer_D.step()

        for p in D.parameters():
            p.data.clamp_(-0.01, 0.01)


    """更新1次生成器G"""
    A = np.arange(1,1000)
    a = np.random.choice(A, 64)
    real_data_sample = real_data[a] #上面三行实现对真实数据采样

    noise_z =  torch.Tensor(np.random.rand(64,2)) #产生随机向量
    G_make = G(noise_z) #随机向量丢进G生成

    pro_atrist1 = D(G_make)#给假值打分

    G_loss = -torch.mean(pro_atrist1)

    optimizer_G.zero_grad()
    G_loss.backward(retain_graph=True)

    optimizer_G.step()

    GD[step-1][0] = pro_atrist0.data.numpy().mean() #储存生成器得分
    GD[step-1][1] = pro_atrist1.data.numpy().mean() #储存判别器得分

    plt.ion()#下面都是输出画图使的
    if step % 2000 == 0:
        noise_z =  torch.Tensor(np.random.rand(1000,2))
        G_make = G(noise_z)
        A = G_make.detach().numpy()
        plt.scatter(A[:,0], A[:,1], 10, label= step )
        plt.legend(loc='upper left')
        plt.pause(0.1)
下面是画图的
plt.plot(GD[:,0], label = 'D') #生成器曲线
plt.plot(GD[:,1], label = 'G') #判别器曲线
plt.legend(loc='upper left')
更多推荐
 7
 0
- 0


 已为社区贡献1条内容

所有评论(0)