
基于pytorch实现图像分类——理解自动求导、计算图、静态图、动态图、pytorch入门
1. pytorch入门
什么是PYTORCH?
这是一个基于Python的科学计算软件包,针对两组受众:
- 替代NumPy以使用GPU的功能
- 提供最大灵活性和速度的深度学习研究平台
1.1 开发环境
anaconda安装pytorch
import torch
1.2 pytorch中的tensor
Tensor是PyTorch中的基础组件,和tensorflow中的tensor类似。
tensor初始化
x = torch.empty(5, 3)
print(x)
"""
output:
tensor([[0., 0., 0.],
        [0., 0., 0.],
        [0., 0., 0.],
        [0., 0., 0.],
        [0., 0., 0.]])
"""

print(x.size())
# output: torch.Size([5, 3])
tensor运算
x = torch.empty(5, 3)
y = torch.rand(5, 3)
print(x + y)
# adds x to y
y.add_(x)
print(y)
"""
output:
tensor([[ 1.4519,  0.7577,  1.4506],
        [ 0.3557,  0.8496,  0.1852],
        [ 0.6745,  0.4696,  1.6169],
        [-1.3345, -0.6746,  1.4474],
        [ 1.0803,  2.1400,  1.1899]])
"""
# 索引
print(y[:, 1])
# output: tensor([ 0.7577, 0.8496, 0.4696, -0.6746,  2.1400])

# 调整大小
x = torch.randn(4, 4)
y = x.view(16)
z = x.view(-1, 8)  # the size -1 is inferred from other dimensions
print(x.size(), y.size(), z.size())
# output: torch.Size([4, 4]) torch.Size([16]) torch.Size([2, 8])
1.3 自动求导AUTOGRAD
我们知道,深度学习最核心的其中一个步骤,就是求导:
根据函数(linear + activation function)求weights相对于loss的导数。然后根据得出的导数,相应的修改weights,让loss最小化。
我们来看看pytorch是怎么自动求导的:
在pytorch框架中,autograd包对tensor的所有运算提供了自动求导机制。
来段代码感受下
import torch

a = torch.tensor(2.0, requires_grad=True) # 如果将torch.Tensor类的属性.requires_grad赋为True,它就会跟踪该张量上的所有操作。
b = torch.tensor(3.0, requires_grad=True)
c = a + b
d = torch.tensor(4.0, requires_grad=True)
e = c * d

# 当你完成了运算可以调用.backward()来自动计算所有的梯度(gradient)。该张量的梯度会累积记录于.grad属性中。
e.backward() # 执行求导

a.grad  # a.grad 即导数 d(e)/d(a) 的值
tensor(4.)
这里让人感觉别扭的是,调用 e.backward() 执行求导,为什么会更新 a 对象的状态 grad ?
我们需要理解pytorch中的另一个重要的元素Function。
1.4 pytorch中的Function
在pytorch框架中,tensor和Function是两个基本组成部分,它们共同构成了pytorch的计算图。
Function 指的是在计算图中某个节点(node)所进行的运算:比如加减乘除卷积等等之类的,Function 内部有 forward() 和 backward() 两个方法,分别应用于正向、反向传播。
a = torch.tensor(2.0, requires_grad=True)
b = a.exp()
print(b)
# tensor(7.3891, grad_fn=<ExpBackward>)
在我们做正向传播的过程中,除了执行 forward() 操作之外,还会同时会为反向传播做一些准备,为反向计算图添加 Function 节点。在上边这个例子中,变量 b 在反向传播中所需要进行的操作是 ExpBackward 。
1.4 计算图(Computational Graphs)
可能大家都听说过,PyTorch 使用的是动态图(Dynamic Computational Graphs)的方式,而 TensorFlow 使用的是静态图(Static Computational Graphs)。
所以到底什么是Computational Graph?动态图和静态图又有什么区别呢?
先简单地介绍一下什么是计算图(Computational Graphs),以方便后边的讲解。
假设我们有一个复杂的神经网络模型,我们把它想象成一个错综复杂的管道结构,不同的管道之间通过节点连接起来,我们有一个注水口,一个出水口。
我们在入口注入数据的之后,数据就沿着设定好的管道路线缓缓流动到出水口,这时候我们就完成了一次正向传播。想象一下输入的 tensor 数据在管道中缓缓流动的场景,这就是为什么 TensorFlow 叫 TensorFlow 的原因!emmm,好像走错片场了,不过计算图在 PyTorch 中也是类似的。
1.5 动态图,静态图
所谓动态图,就是每次当我们搭建完一个计算图,然后在反向传播结束之后,整个计算图就在内存中被释放了。如果想再次使用的话,必须从头再搭一遍。
# 这是一个关于 PyTorch 是动态图的例子:
a = torch.tensor([3.0, 1.0], requires_grad=True)
b = a * a
loss = b.mean()

loss.backward() # 正常
loss.backward() # RuntimeError

# 第二次:从头再来一遍
a = torch.tensor([3.0, 1.0], requires_grad=True)
b = a * a
loss = b.mean()
loss.backward() # 正常
而以 TensorFlow 为代表的静态图,每次都先设计好计算图,需要的时候实例化这个图,然后送入各种输入,重复使用,只有当会话结束的时候创建的图才会被释放,就像我们之前举的那个水管的例子一样,设计好水管布局之后,需要用的时候就开始搭,搭好了就往入口加水,什么时候不需要了,再把管道都给拆了。
2. 基于pytorch实现图像分类
2.1 加载训练和测试数据集
加载和标准化CIFAR10训练和测试数据集 torchvision
import torch
import torchvision
import torchvision.transforms as transforms

transform = transforms.Compose(
    [transforms.ToTensor(),
     transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5))])

trainset = torchvision.datasets.CIFAR10(root='./data', train=True,
                                        download=True, transform=transform)
trainloader = torch.utils.data.DataLoader(trainset, batch_size=4,
                                          shuffle=True, num_workers=2)

testset = torchvision.datasets.CIFAR10(root='./data', train=False,
                                       download=True, transform=transform)
testloader = torch.utils.data.DataLoader(testset, batch_size=4,
                                         shuffle=False, num_workers=2)

classes = ('plane', 'car', 'bird', 'cat',
           'deer', 'dog', 'frog', 'horse', 'ship', 'truck')
查看我们的训练集
import matplotlib.pyplot as plt
import numpy as np

# functions to show an image
def imshow(img):
    img = img / 2 + 0.5     # unnormalize
    npimg = img.numpy()
    plt.imshow(np.transpose(npimg, (1, 2, 0)))
    plt.show()


# get some random training images
dataiter = iter(trainloader)
images, labels = dataiter.next()

# show images
imshow(torchvision.utils.make_grid(images))
# print labels
print(' '.join('%5s' % classes[labels[j]] for j in range(4)))
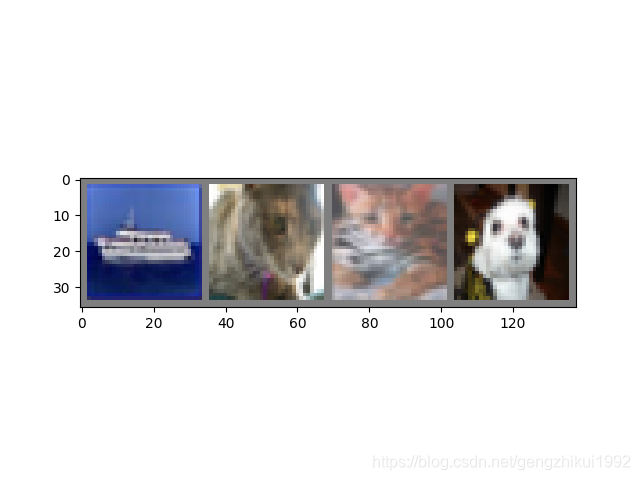
2.2 定义卷积神经网络
import torch.nn as nn
import torch.nn.functional as F

class Net(nn.Module):
    def __init__(self):
        super(Net, self).__init__()
        self.conv1 = nn.Conv2d(3, 6, 5)
        self.pool = nn.MaxPool2d(2, 2)
        self.conv2 = nn.Conv2d(6, 16, 5)
        self.fc1 = nn.Linear(16 * 5 * 5, 120)
        self.fc2 = nn.Linear(120, 84)
        self.fc3 = nn.Linear(84, 10)

    def forward(self, x):
        x = self.pool(F.relu(self.conv1(x)))
        x = self.pool(F.relu(self.conv2(x)))
        x = x.view(-1, 16 * 5 * 5)
        x = F.relu(self.fc1(x))
        x = F.relu(self.fc2(x))
        x = self.fc3(x)
        return x


net = Net()
2.3 定义损失函数和优化器
import torch.optim as optim

criterion = nn.CrossEntropyLoss() # 损失函数
optimizer = optim.SGD(net.parameters(), lr=0.001, momentum=0.9) # 优化器
2.4 训练神经网络
我们只需要遍历数据迭代器,然后将输入馈送到网络并进行优化
for epoch in range(2):  # loop over the dataset multiple times

    running_loss = 0.0
    for i, data in enumerate(trainloader, 0):
        # get the inputs; data is a list of [inputs, labels]
        inputs, labels = data

        # zero the parameter gradients
        optimizer.zero_grad()

        # forward + backward + optimize
        outputs = net(inputs)
        loss = criterion(outputs, labels)
        loss.backward()
        optimizer.step()

        # print statistics
        running_loss += loss.item()
        if i % 2000 == 1999:    # print every 2000 mini-batches
            print('[%d, %5d] loss: %.3f' %
                  (epoch + 1, i + 1, running_loss / 2000))
            running_loss = 0.0

print('Finished Training')
输出结果
[1,  2000] loss: 2.171
[1,  4000] loss: 1.835
[1,  6000] loss: 1.649
[1,  8000] loss: 1.569
[1, 10000] loss: 1.505
[1, 12000] loss: 1.454
[2,  2000] loss: 1.381
[2,  4000] loss: 1.347
[2,  6000] loss: 1.329
[2,  8000] loss: 1.310
[2, 10000] loss: 1.292
[2, 12000] loss: 1.284
Finished Training
保存我们训练有素的模型
PATH = './cifar_net.pth'
torch.save(net.state_dict(), PATH)
2.5 在测试数据集上测试神经网络准确性
重新加载保存的模型
net = Net()
net.load_state_dict(torch.load(PATH))
运行测试集
correct = 0
total = 0
with torch.no_grad():
    for data in testloader:
        images, labels = data
        outputs = net(images) # 在测试数据上运行神经网络,得到结果
        _, predicted = torch.max(outputs.data, 1)
        total += labels.size(0)
        correct += (predicted == labels).sum().item()

print('Accuracy of the network on the 10000 test images: %d %%' % (
    100 * correct / total))
输出
Accuracy of the network on the 10000 test images: 54 %
2.6 在GPU上训练
device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
net.to(device)
inputs, labels = data[0].to(device), data[1].to(device)
3. 参考
使用PyTorch进行深度学习:60分钟的闪电战 – h ttps://pytorch.org/tutorials/beginner/blitz/tensor_tutorial.html#sphx-glr-beginner-blitz-tensor-tutorial-py
PyTorch 的 Autograd – https://zhuanlan.zhihu.com/p/69294347
更多推荐

 1
 0
- 0


 已为社区贡献2条内容

所有评论(0)