
为什么有了大模型还需要用embedding模型?
前言
不知道大家有没有想过这个问题?
我这两天对这个问题还深入思考了一下,思考的初衷是来源于现在这么多的开源大模型,而且挺多是多模态场景,而Embedding模型相对单模且英文语料居多,如果能复用大模型的output layer,是不是会加速手头上的实验进展。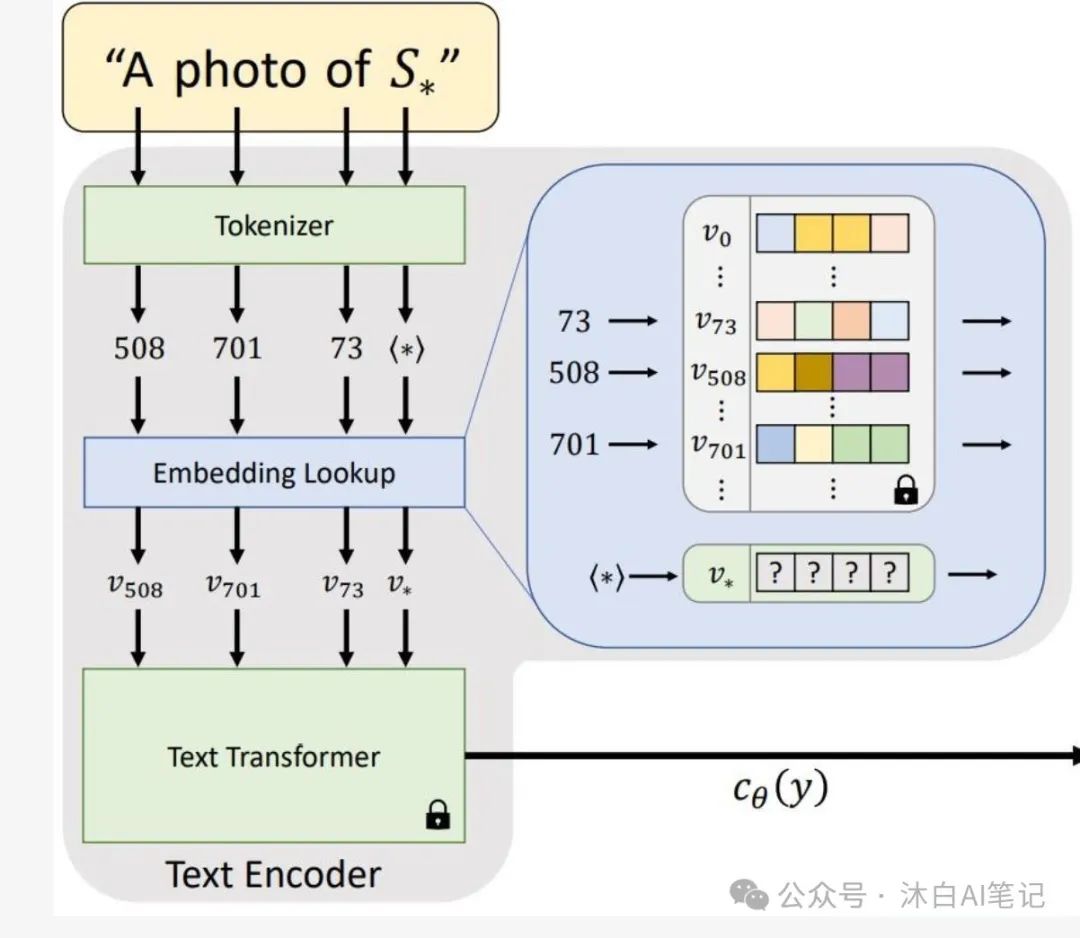
但思考后觉得效果应该是比不上原生的Embedding模型,有空再专门测试一下看看。
可能主要有以下几点原因:
-
像LLM模型都是预测next token,那么针对next token的预测,模型肯定更加关注在这个token附近的信息,那么对应这个Embedding也更多是这附近的局部信息。而我们需要的Embedding表征,是输入句子的全局表征,而不是“你好吗,我吃饭了,你可以出来了吗?”这句话里,对其中“你可以出来了吗”做的局部信息特征映射。
-
目前比较好的Embedding模型都用到了对比学习,这种学习方式能够更精确地学习的全局Eembedding特征,如果用LLM也可以在下游接一个自监督训练器,效果也会很不错,就是成本有点高。最近有一篇paper也可供参考:《Improving Text Embeddings with Large Language Models》
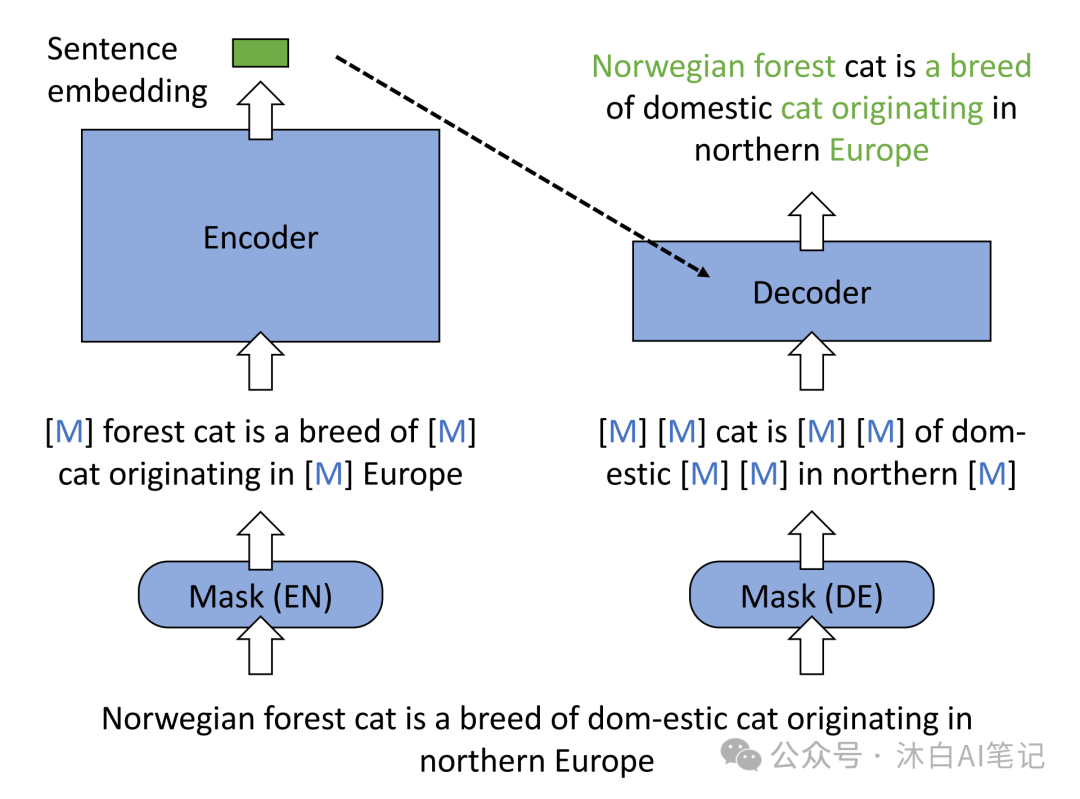
image.png|550
对比学习目标是,学习一个这样的特征提取器,在它提取的特征所构建的 embedding 空间中,同类样本的 embedding 互相靠近,而不同类样本的embedding相互远离。通常,同类样本对互称为正样本(positive sample),不同类样本对互称为负样本(negative sample)。
最后的最后
感谢你们的阅读和喜欢,我收藏了很多技术干货,可以共享给喜欢我文章的朋友们,如果你肯花时间沉下心去学习,它们一定能帮到你。
因为这个行业不同于其他行业,知识体系实在是过于庞大,知识更新也非常快。作为一个普通人,无法全部学完,所以我们在提升技术的时候,首先需要明确一个目标,然后制定好完整的计划,同时找到好的学习方法,这样才能更快的提升自己。
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】

大模型知识脑图
为了成为更好的 AI大模型 开发者,这里为大家提供了总的路线图。它的用处就在于,你可以按照上面的知识点去找对应的学习资源,保证自己学得较为全面。

经典书籍阅读
阅读AI大模型经典书籍可以帮助读者提高技术水平,开拓视野,掌握核心技术,提高解决问题的能力,同时也可以借鉴他人的经验。对于想要深入学习AI大模型开发的读者来说,阅读经典书籍是非常有必要的。

实战案例
光学理论是没用的,要学会跟着一起敲,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。

面试资料
我们学习AI大模型必然是想找到高薪的工作,下面这些面试题都是总结当前最新、最热、最高频的面试题,并且每道题都有详细的答案,面试前刷完这套面试题资料,小小offer,不在话下

640套AI大模型报告合集
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】
更多推荐



 19
 0
- 0


 已为社区贡献6条内容

所有评论(0)