
小红书 hi lab 开源多模态大模型 dots.vlm1,效果接近闭源 SoTA 模型
dots.vlm1 是小红书 hi lab 研发并开源的首个多模态大模型,借助一个从零训练的 12 亿参数视觉编码器以及基于 Deepseek V3 LLM 构建,在视觉的理解和推理任务上均有不错的表现。在大部分多模态评测集上接近闭源 SoTA 模型的水平,并在文本能力和主流文本模型相当。
01、介绍
我们很高兴地介绍 dots.vlm1,这是 dots 模型家族中的首个视觉语言模型。dots.vlm1 构建于一个 12 亿参数的视觉编码器和 DeepSeek V3 大语言模型(LLM)之上,具备强大的多模态理解与推理能力。
模型亮点:
- NaViT 视觉编码器:没有基于成熟视觉编码器进行微调,完全从零开始训练,原生支持动态分辨率。同时在文本监督上增加纯视觉监督,提升感知能力上限。此外,训练数据上在传统的 Image Caption 数据上还引入大量结构化图片进行原生训练,提升 VLM 模型的感知能力(例如各类 OCR 能力)。
- 多模态训练数据:在传统思路上,额外引入多种合成数据思路,覆盖多样的图片类型(例如表格/Chart/文档/Graphics等)及其描述(例如 Alt Text/Dense Caption/Grounding 等);同时,利用多模态大模型来重写图文交错网页数据,显著提升训练数据质量;
- 通过大规模预训练与精细化后训练调优,dots.vlm1 在视觉感知与推理方面达到了接近 SOTA 的表现,为开源视觉语言模型树立了新的性能上限,同时在纯文本任务中仍保持一定竞争力。
Github Repo:
https://github.com/rednote-hilab/dots.vlm1
Huggingface Model:
https://huggingface.co/rednote-hilab/dots.vlm1.inst
Demo:
https://huggingface.co/spaces/rednote-hilab/dots-vlm1-demo
特别感谢 DeepSeek 团队为我们提供了优秀的 DeepSeek V3 模型支持。
02、效果
2.1 评测指标
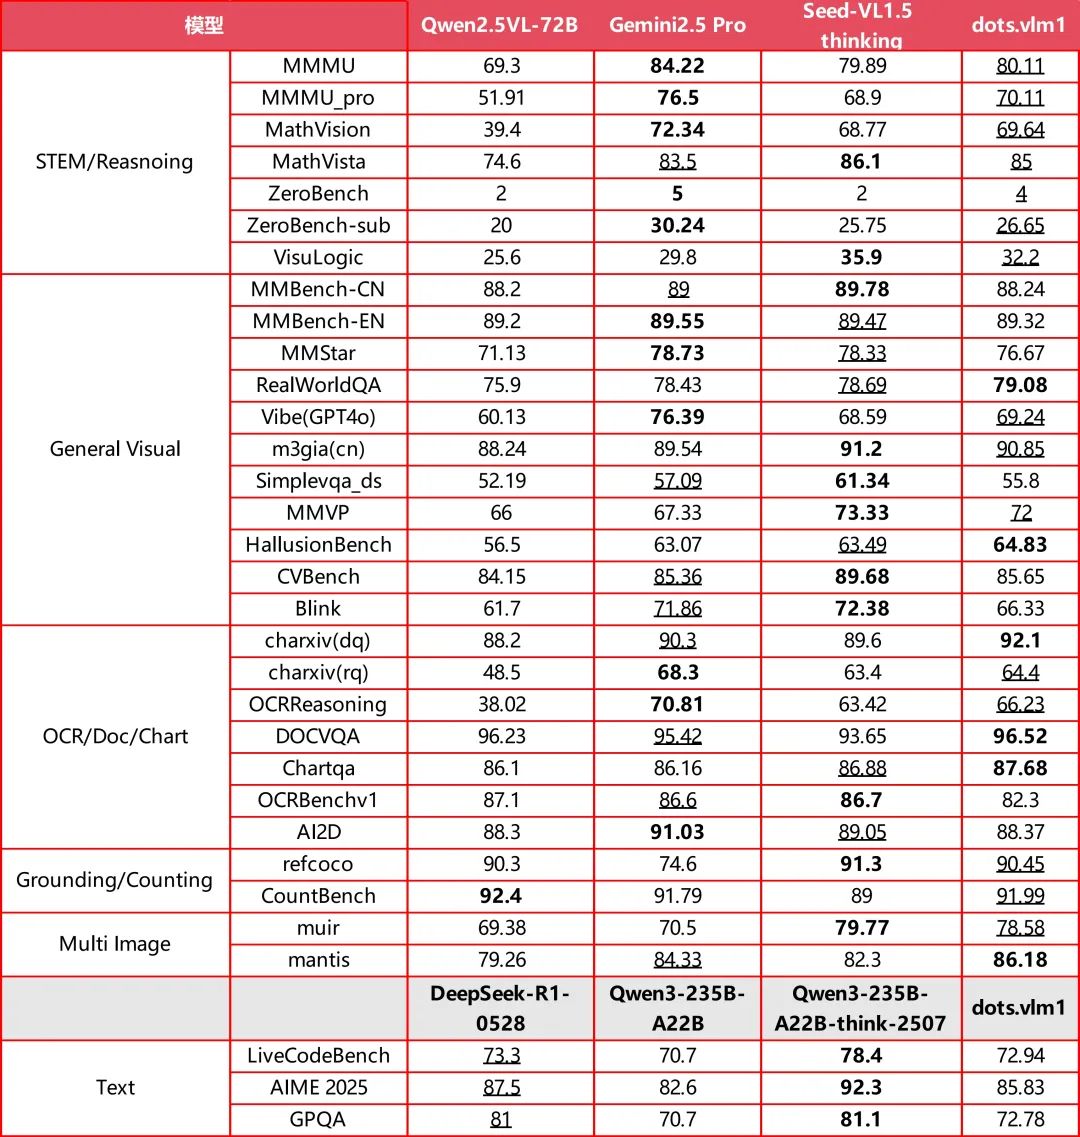
在主要的视觉评测集上,dots.vlm1 的整体表现已接近当前领先模型 Gemini 2.5 Pro 与 Seed-VL1.5 thinking,尤其在 MMMU/MathVision/OCR Reasoning 等多个基准测试中取得了相当竞争力的结果,显示出较强的图文理解与推理能力。
在典型的文本推理任务(如 AIME、GPQA、LiveCodeBench)上,dots.vlm1 的表现大致相当于 DeepSeek-R1-0528,在数学和代码能力上已具备一定的通用性,但在 GPQA 等更多样的推理任务上仍存在差距。
总体来看,dots.vlm1 在视觉多模态能力方面已接近 SOTA 水平,在文本推理方面达到了主流模型的性能。然而,在部分细分任务上仍与最优结果存在一定距离,需要在架构设计与训练数据上进一步优化。这些子集也构成我们下一阶段重点提升的方向之一。
2.2 样例展示
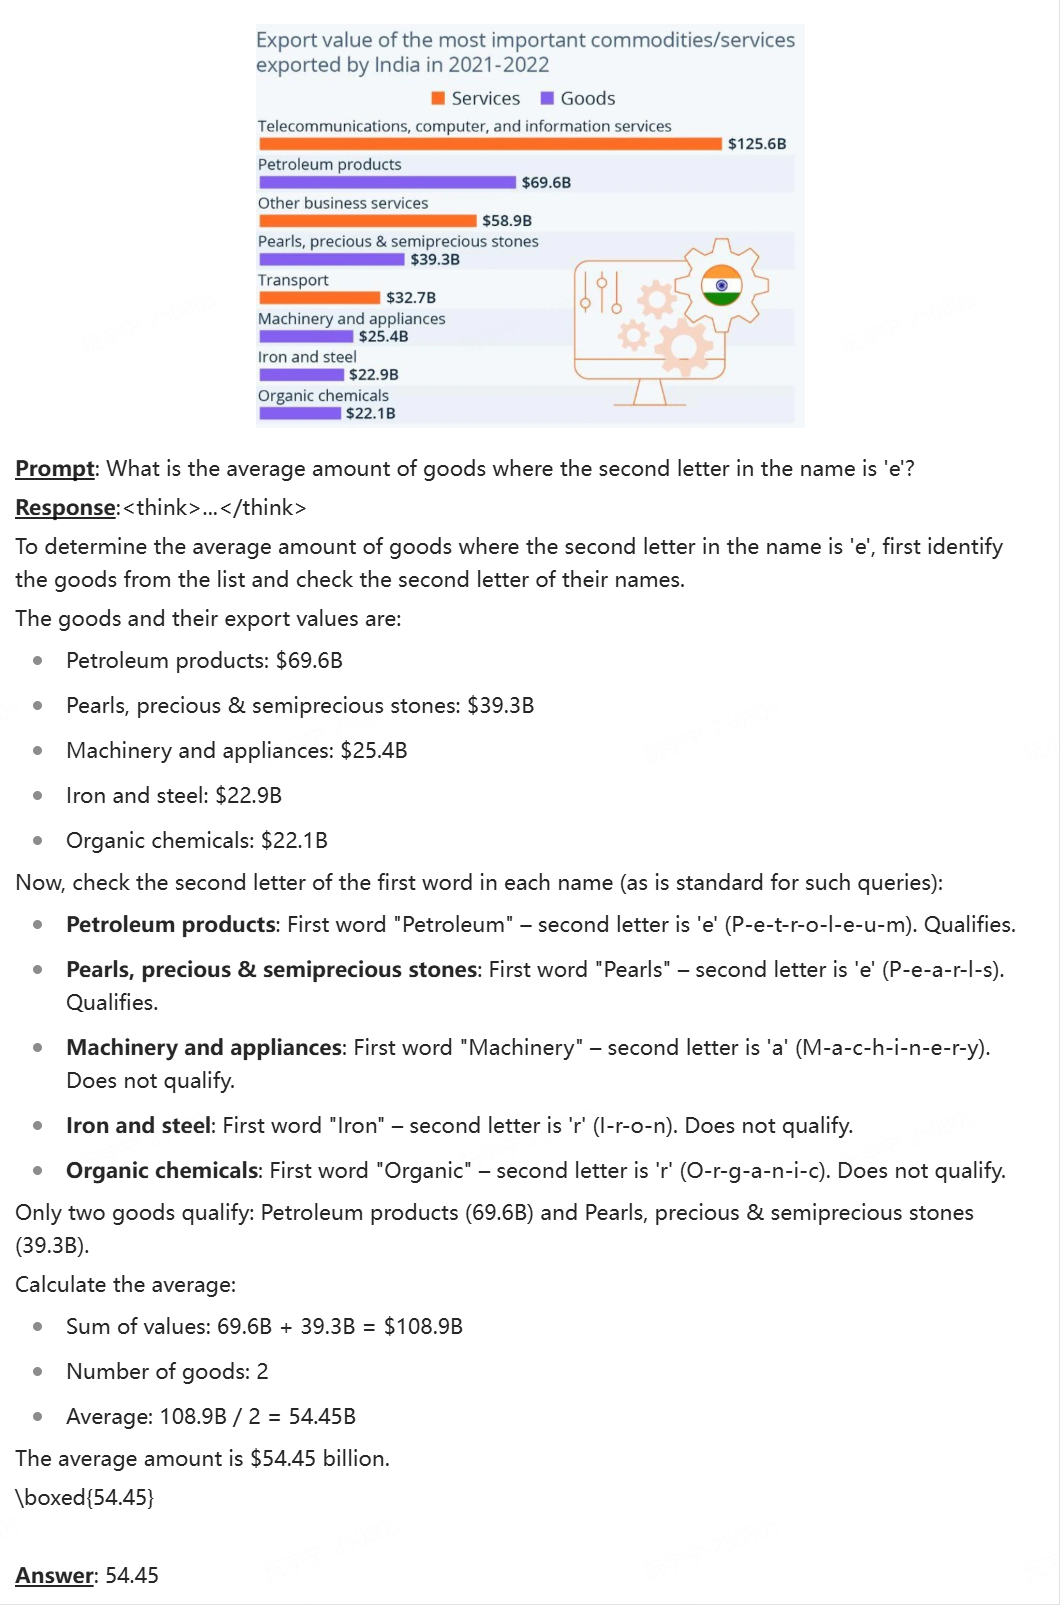
复杂图表推理样例
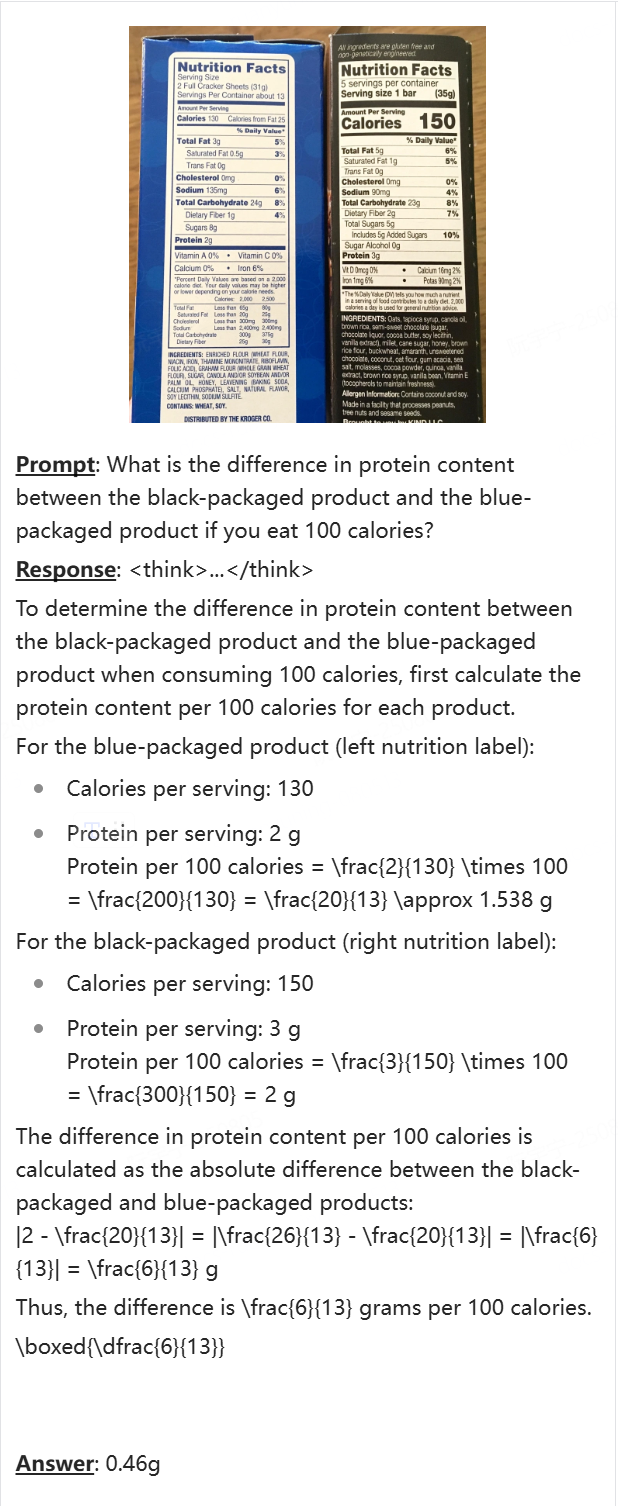
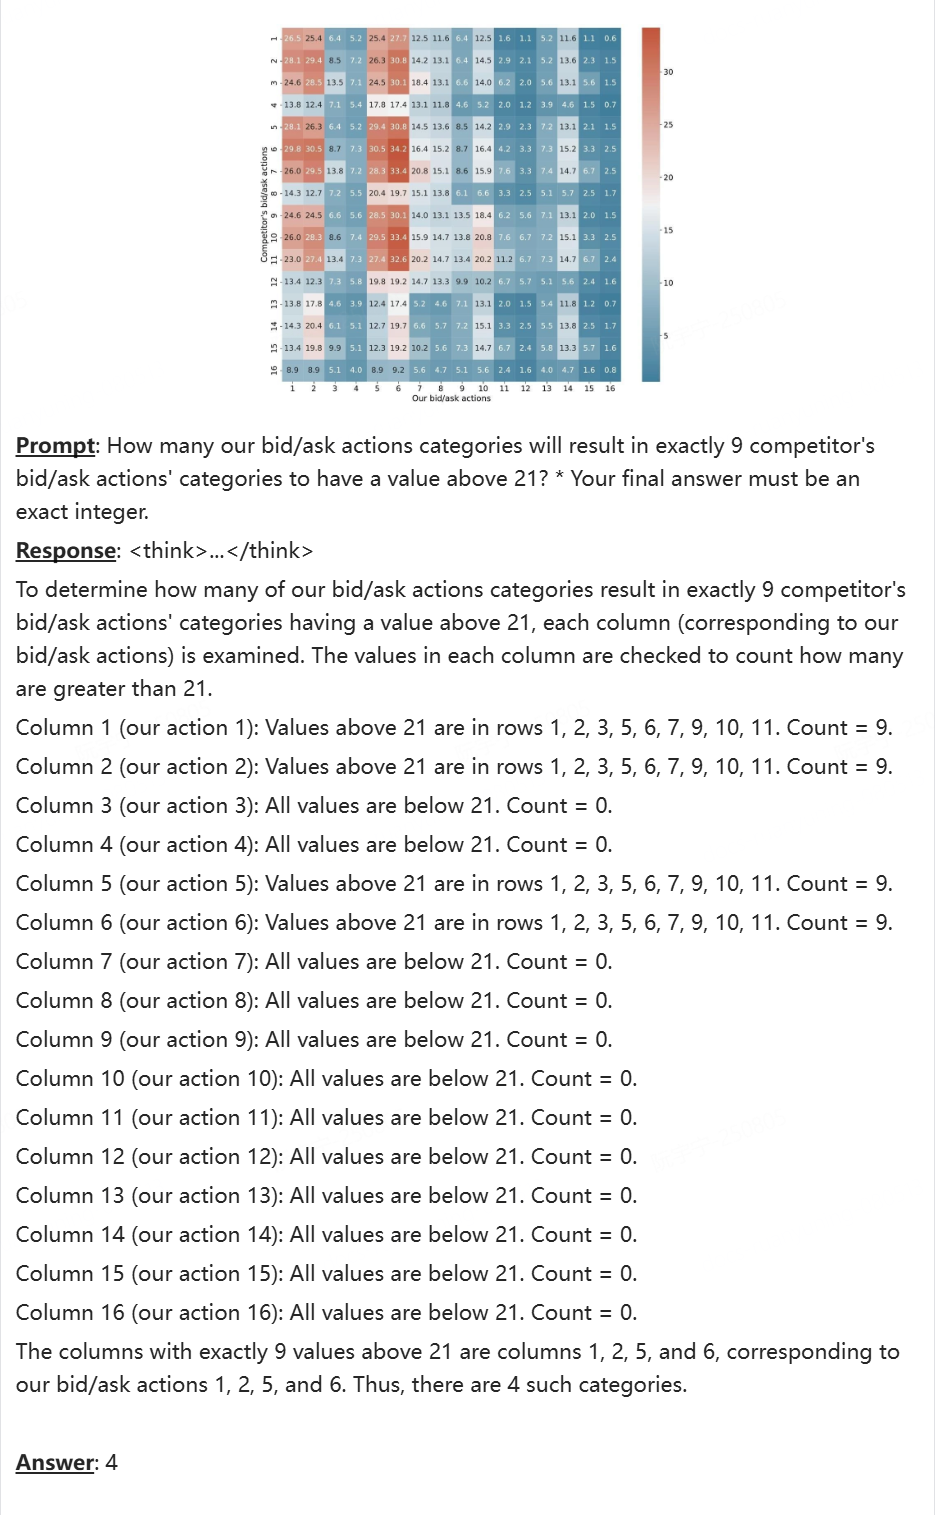
<上下滑动查看更多>
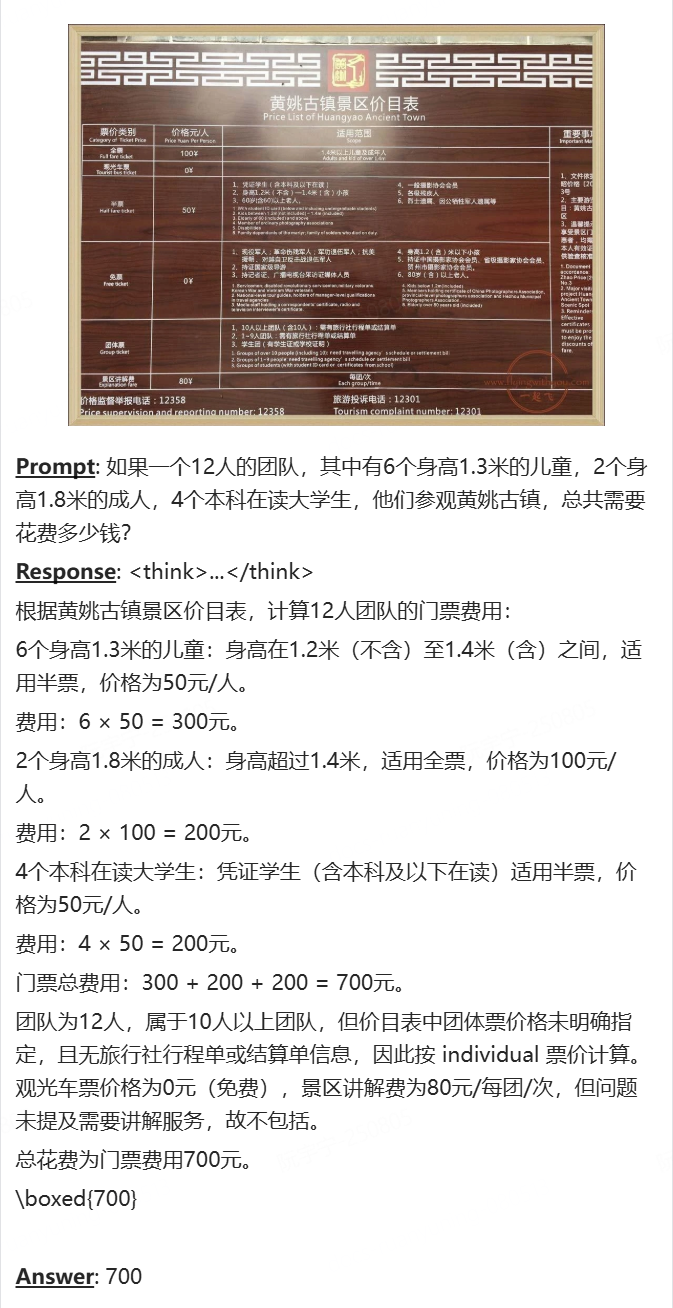
STEM 解题样例
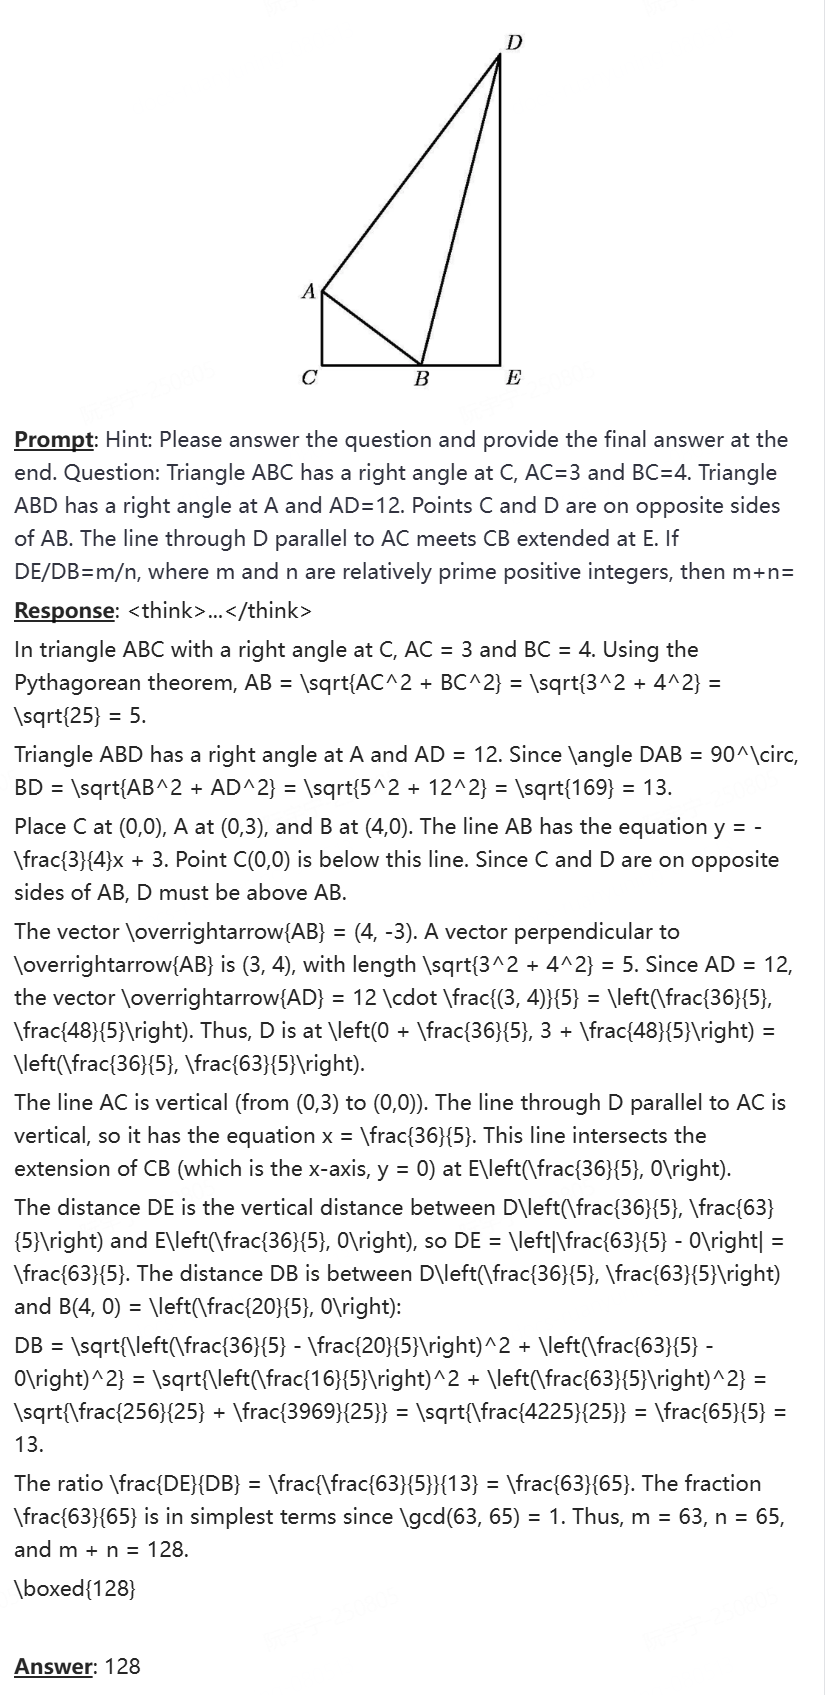
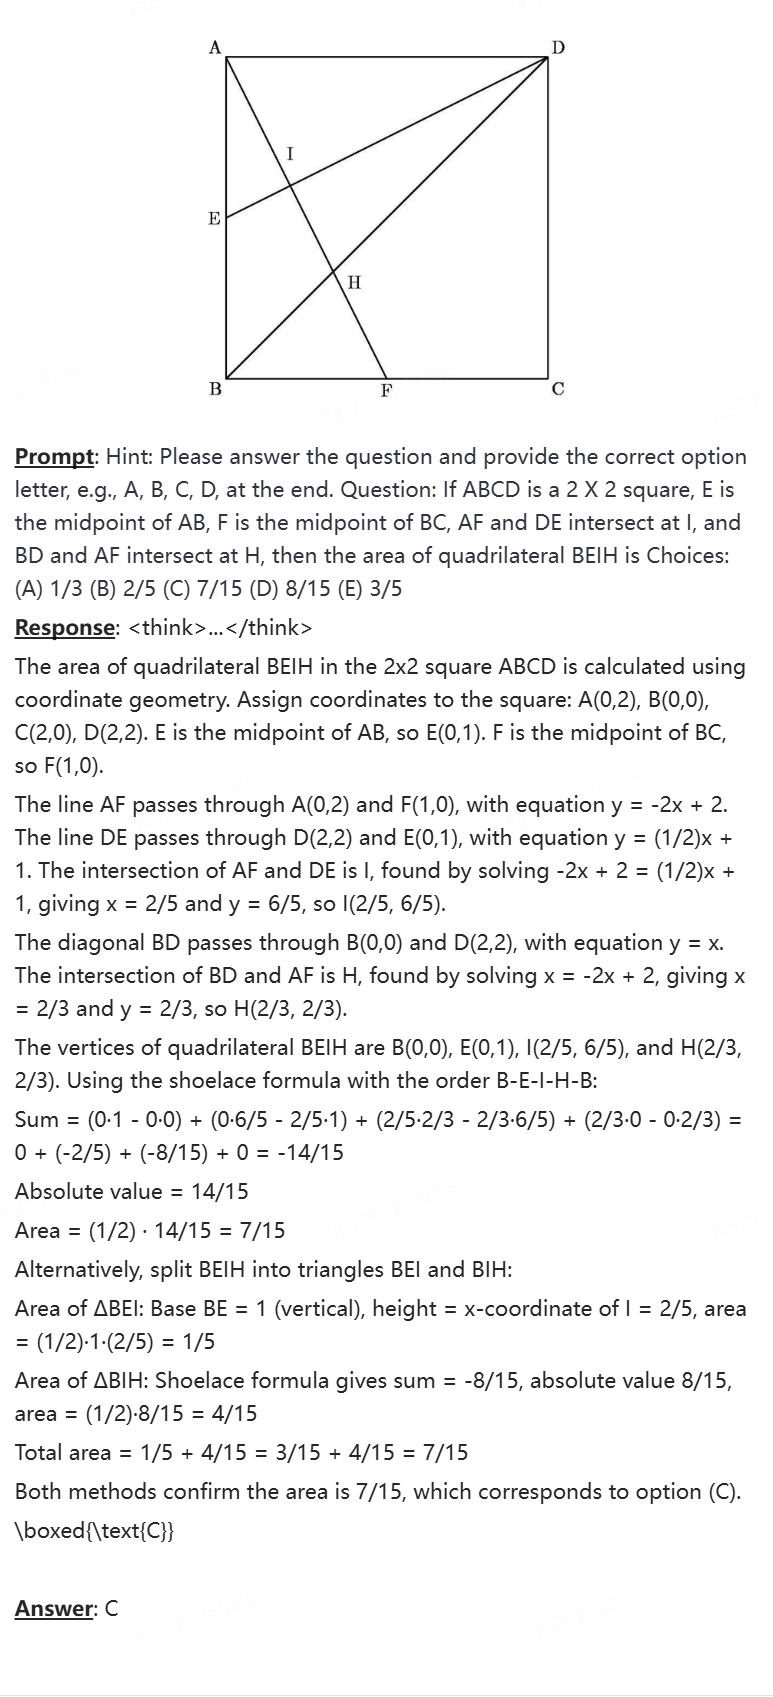
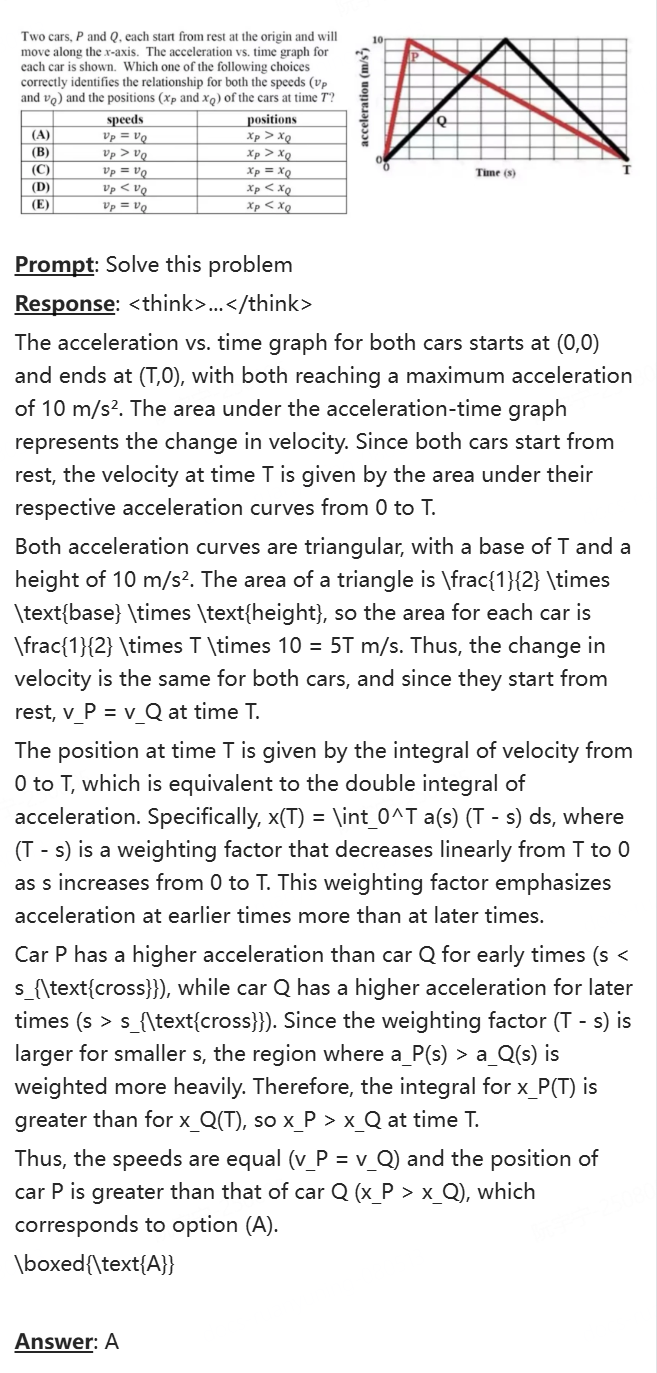

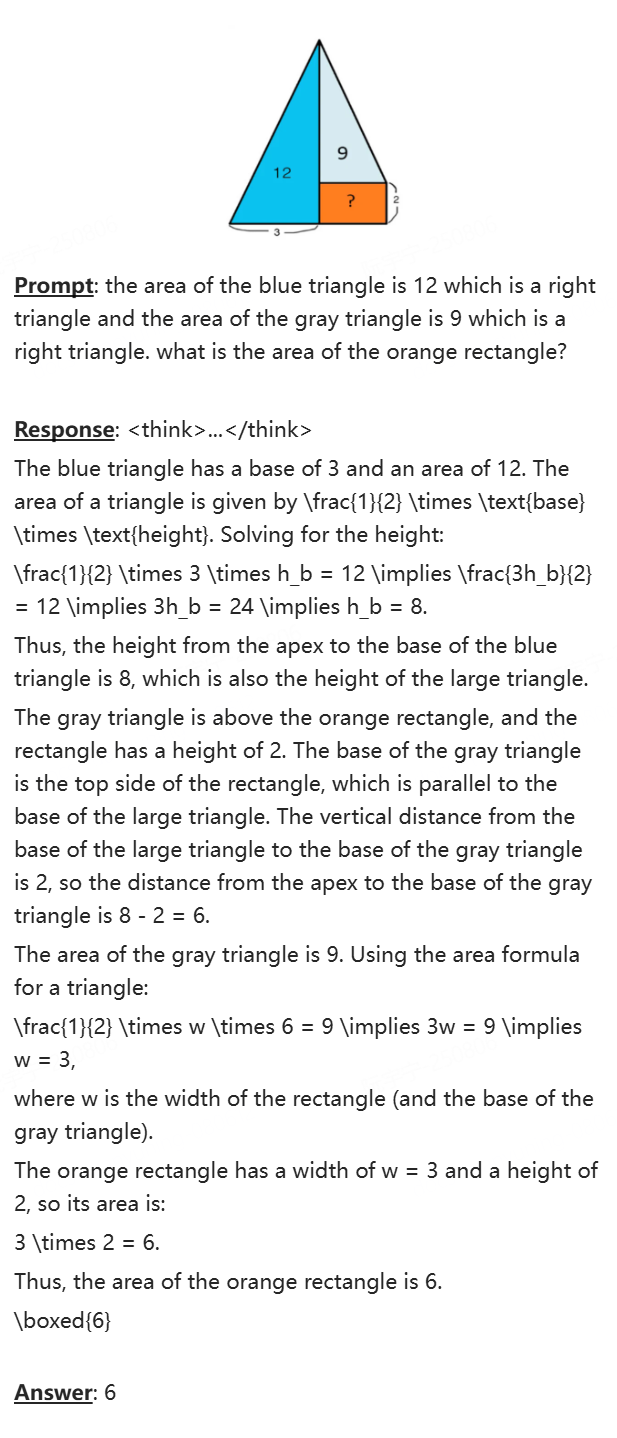
<上下滑动查看更多>
长尾识别解题样例
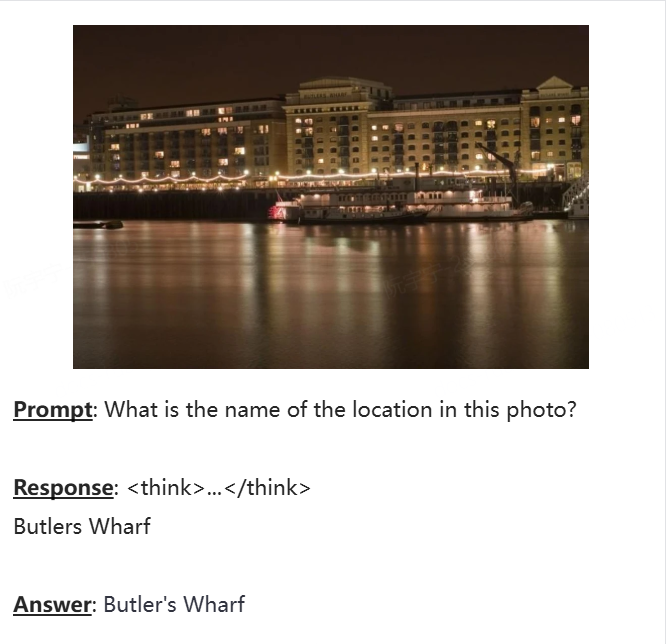
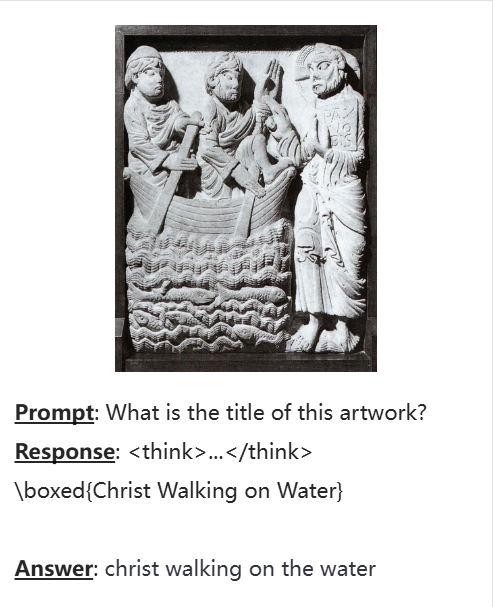
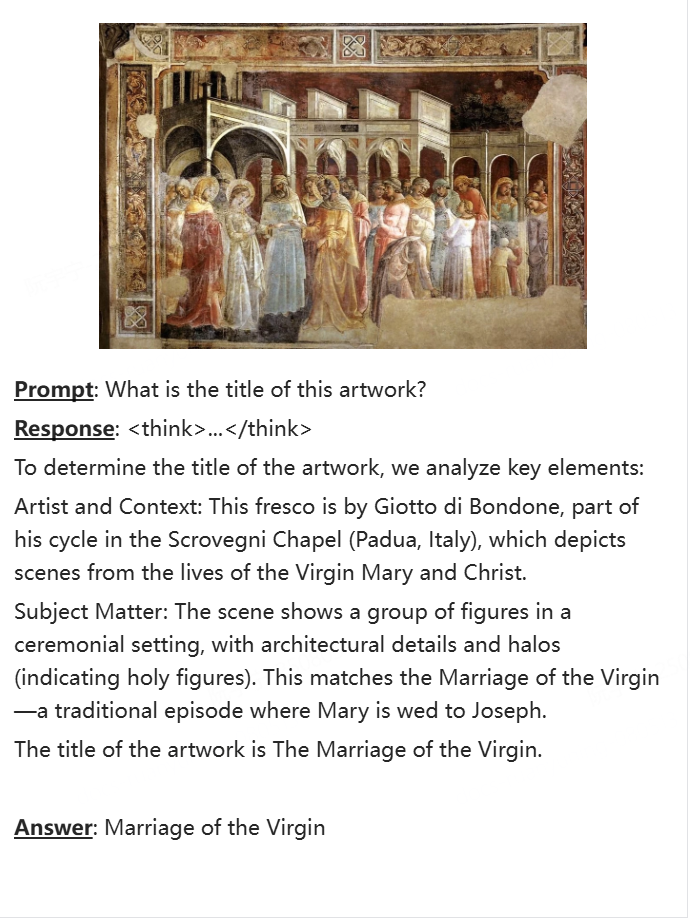
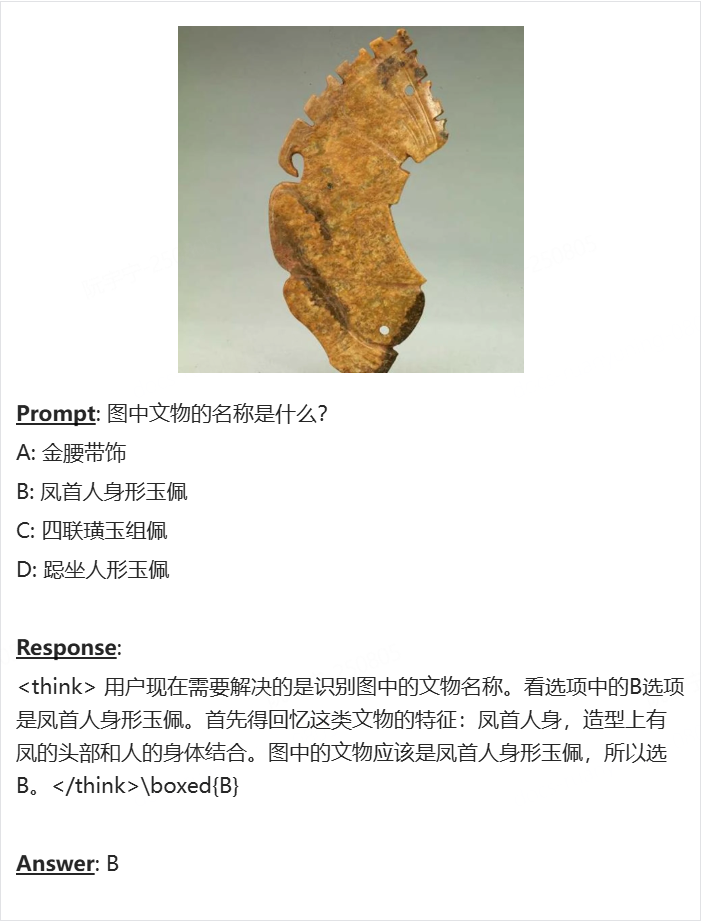
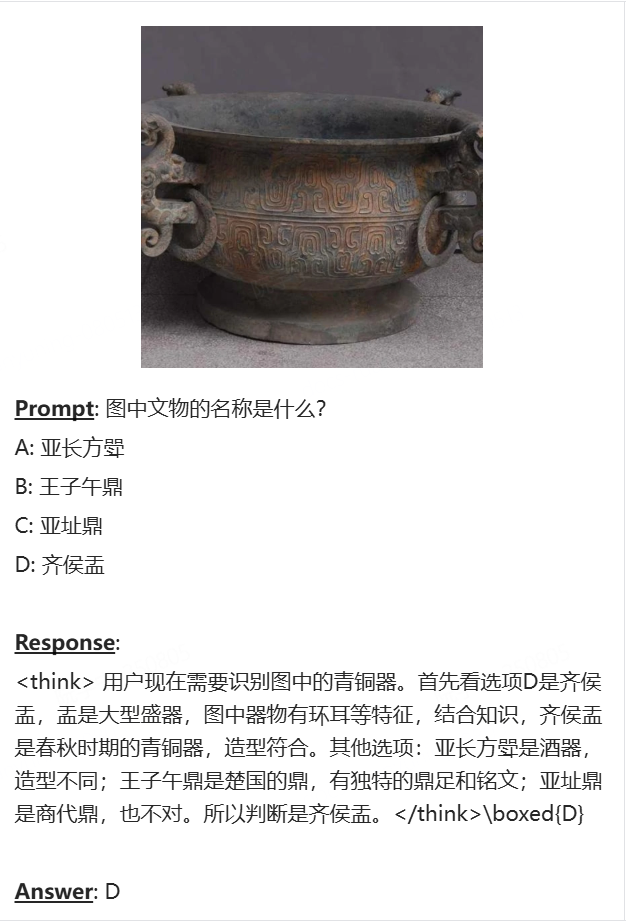
<上下滑动查看更多>
视觉推理样例
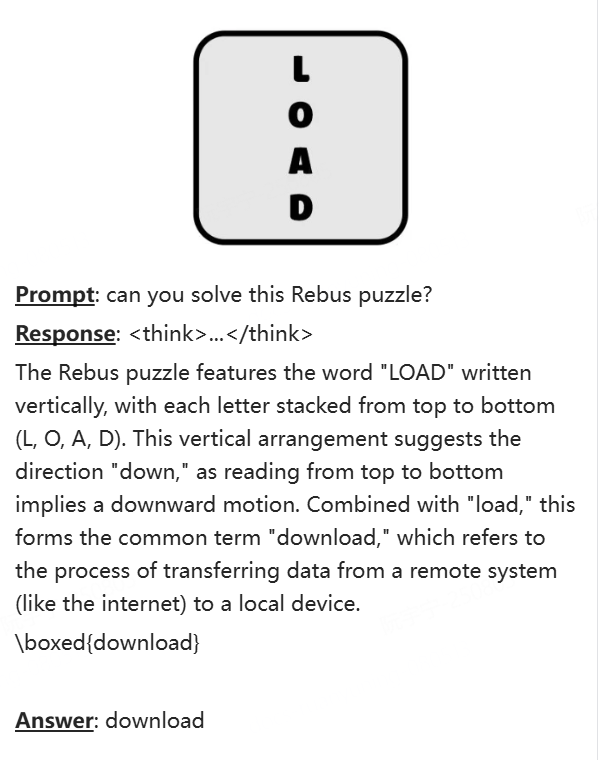
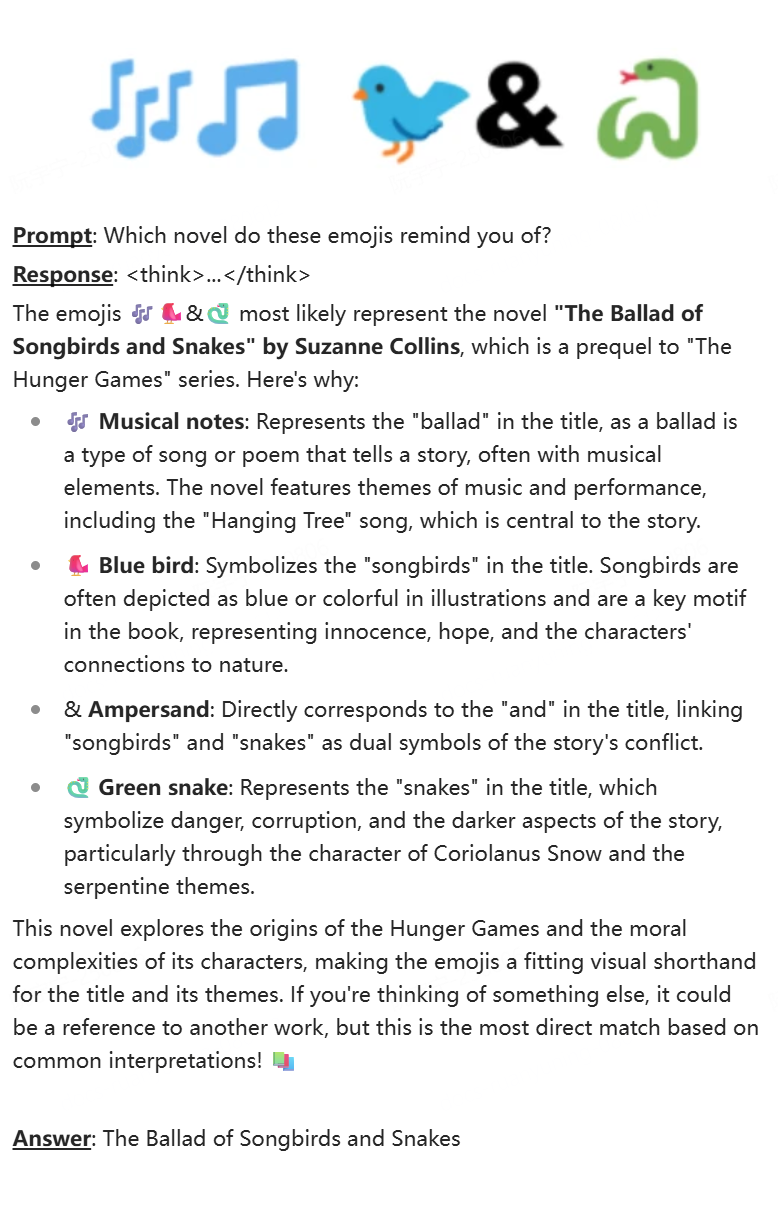
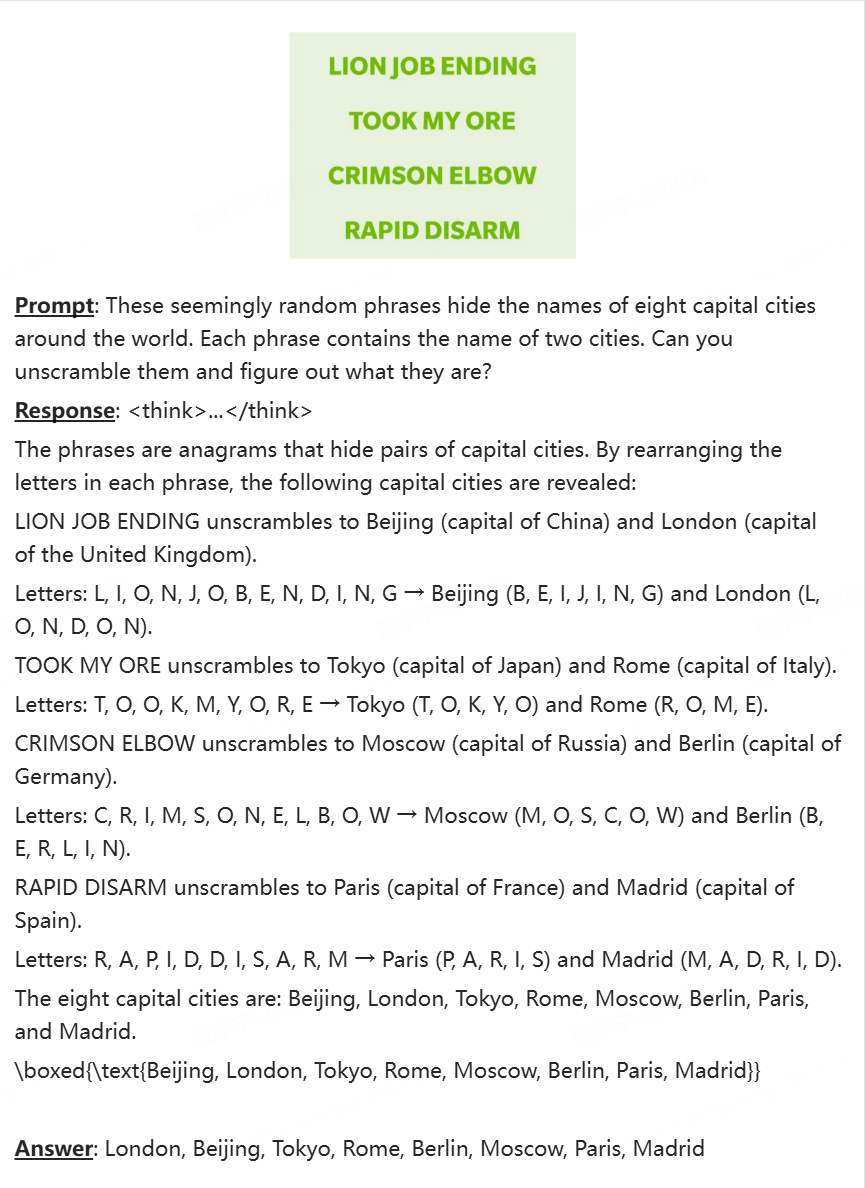
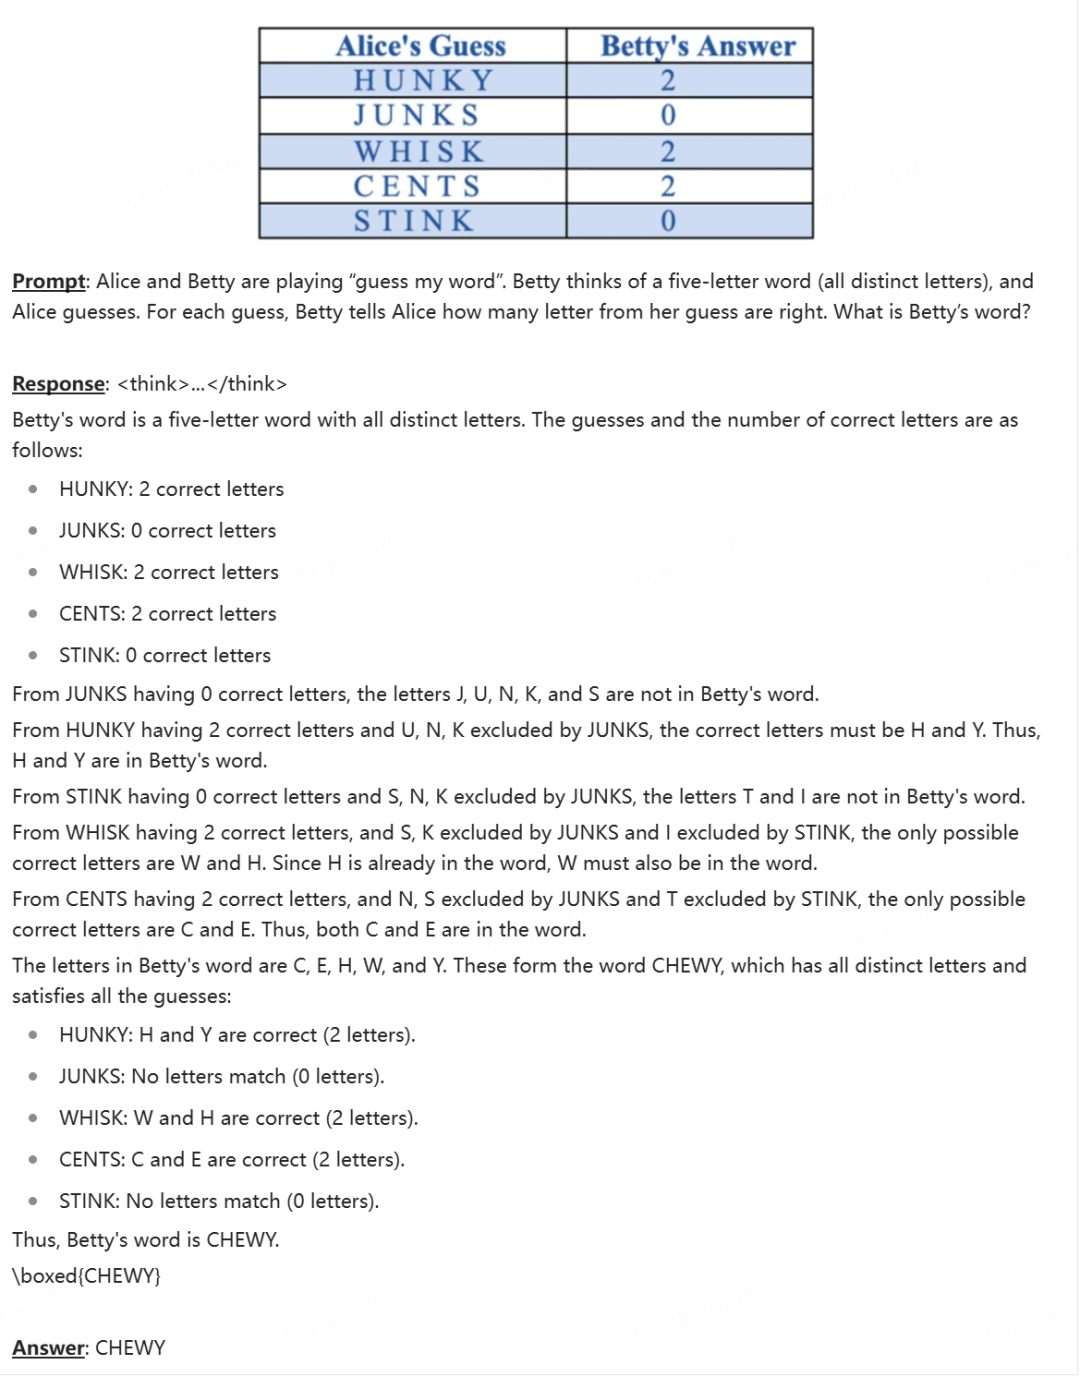
<上下滑动查看更多>
03、方法
3.1 架构概览
dots.vlm1 由三个核心组件构成:一个 12 亿参数的 NaViT 视觉编码器、一个轻量级的 MLP 适配器,以及 DeepSeek V3 MoE 大语言模型。这一架构通过三阶段流程进行训练:
- 第一阶段:视觉编码器预训练:NaViT 编码器从头训练,旨在最大化对多样视觉数据的感知能力。
- 第二阶段:VLM 预训练:将视觉编码器与 DeepSeek V3 LLM 联合训练,使用大规模、多样化的多模态数据集。
- 第三阶段:VLM 后训练:通过有监督微调(SFT)增强模型的泛化能力,仅使用任务多样的数据进行训练。
注:后训练阶段仅包含有监督微调(SFT);强化学习方法将在后续工作中探索。
3.2 NaViT 视觉编码器
我们为 NaViT 编码器设计了两阶段的训练策略。整体结构和训练方式与 AimV2[1] 类似,但我们完全从头开始在原生分辨率上训练。该编码器包含 42 层 Transformer,采用 RMSNorm、SwiGLU 和二维旋转位置编码(2D RoPE)等技术。
第一阶段:预训练
从随机初始化开始,在 224×224 分辨率图像上进行训练,使用双重监督策略:下一 Token 预测(NTP):通过大量图文对训练模型的感知能力;下一 Patch 生成(NPG):利用纯图像数据,通过扩散模型预测图像 patch,增强空间与语义感知能力。训练过程中使用了大量图文对。
第二阶段:分辨率提升预训练
逐步提升图像分辨率:从百万像素级别输入开始,在大量 token 上进行训练,之后升级到千万像素级别进行训练。为进一步提升泛化能力,还引入了更丰富的数据源,包括 OCR 场景图像、grounding 数据和视频帧。
3.3 VLM预训练数据
为增强 dots.vlm1 的多模态能力,我们将预训练数据划分为两个主要类别:
跨模态互译数据
该类数据用于训练模型将图像内容用文本进行描述、总结或重构:
- 普通图像 + Alt Text 或 Dense Caption;
- 复杂图表、表格、公式、图形(真实或合成)+ 结构化注释或文字;
- OCR 场景:多语言、场景理解、纯文本、文档解析等;
- 视频帧 + 时间序列描述;
- Grounding 监督数据:如边界框和关键点。
此类数据难以穷尽枚举,涵盖各种图像/视频与对应文本的组合。我们的目标是构建一个全谱系的数据分布,覆盖所有可被人类理解且可转化为离散 token 序列的视觉信息。
跨模态融合数据
该类数据用于训练模型在图文混合上下文中执行下一 token 预测,避免模型过度依赖单一模态。我们为不同类型的融合数据设计了专门的清洗管线,以下两类效果尤为显著:
- 网页数据:网页图文数据多样性丰富,但视觉与文本对齐质量不佳。我们不使用传统的 CLIP 分数筛选,而是采用内部自研的 VLM 模型进行重写和清洗,剔除低质量图像和弱相关文本。
- PDF 数据:PDF 内容质量普遍较高。为充分利用这类数据,我们开发了专用解析模型 dots.ocr,将 PDF 文档转化为图文交错表示。同时我们还将整页 PDF 渲染为图像,并随机遮挡部分文本区域,引导模型结合版面与上下文预测被遮挡内容,从而增强其理解视觉格式文档的能力。
04、未来工作
尽管 dots.vlm1 已取得显著进展,我们在评估中仍发现其在视觉感知与推理能力上存在不足。
- 在视觉感知方面,我们计划显著扩大跨模态互译数据的规模与多样性,并进一步改进视觉编码器结构,探索更有效的神经网络架构与损失函数设计,从根本上提升训练效率。
- 在视觉推理方面,我们将优先推动强化学习方法,以缩小文本与多模态提示在推理能力上的 test-time scaling 差距。同时也在探索将更多推理能力前置到预训练阶段的可能性,从而增强泛化性和效率。
一、全套AGI大模型学习路线
AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!
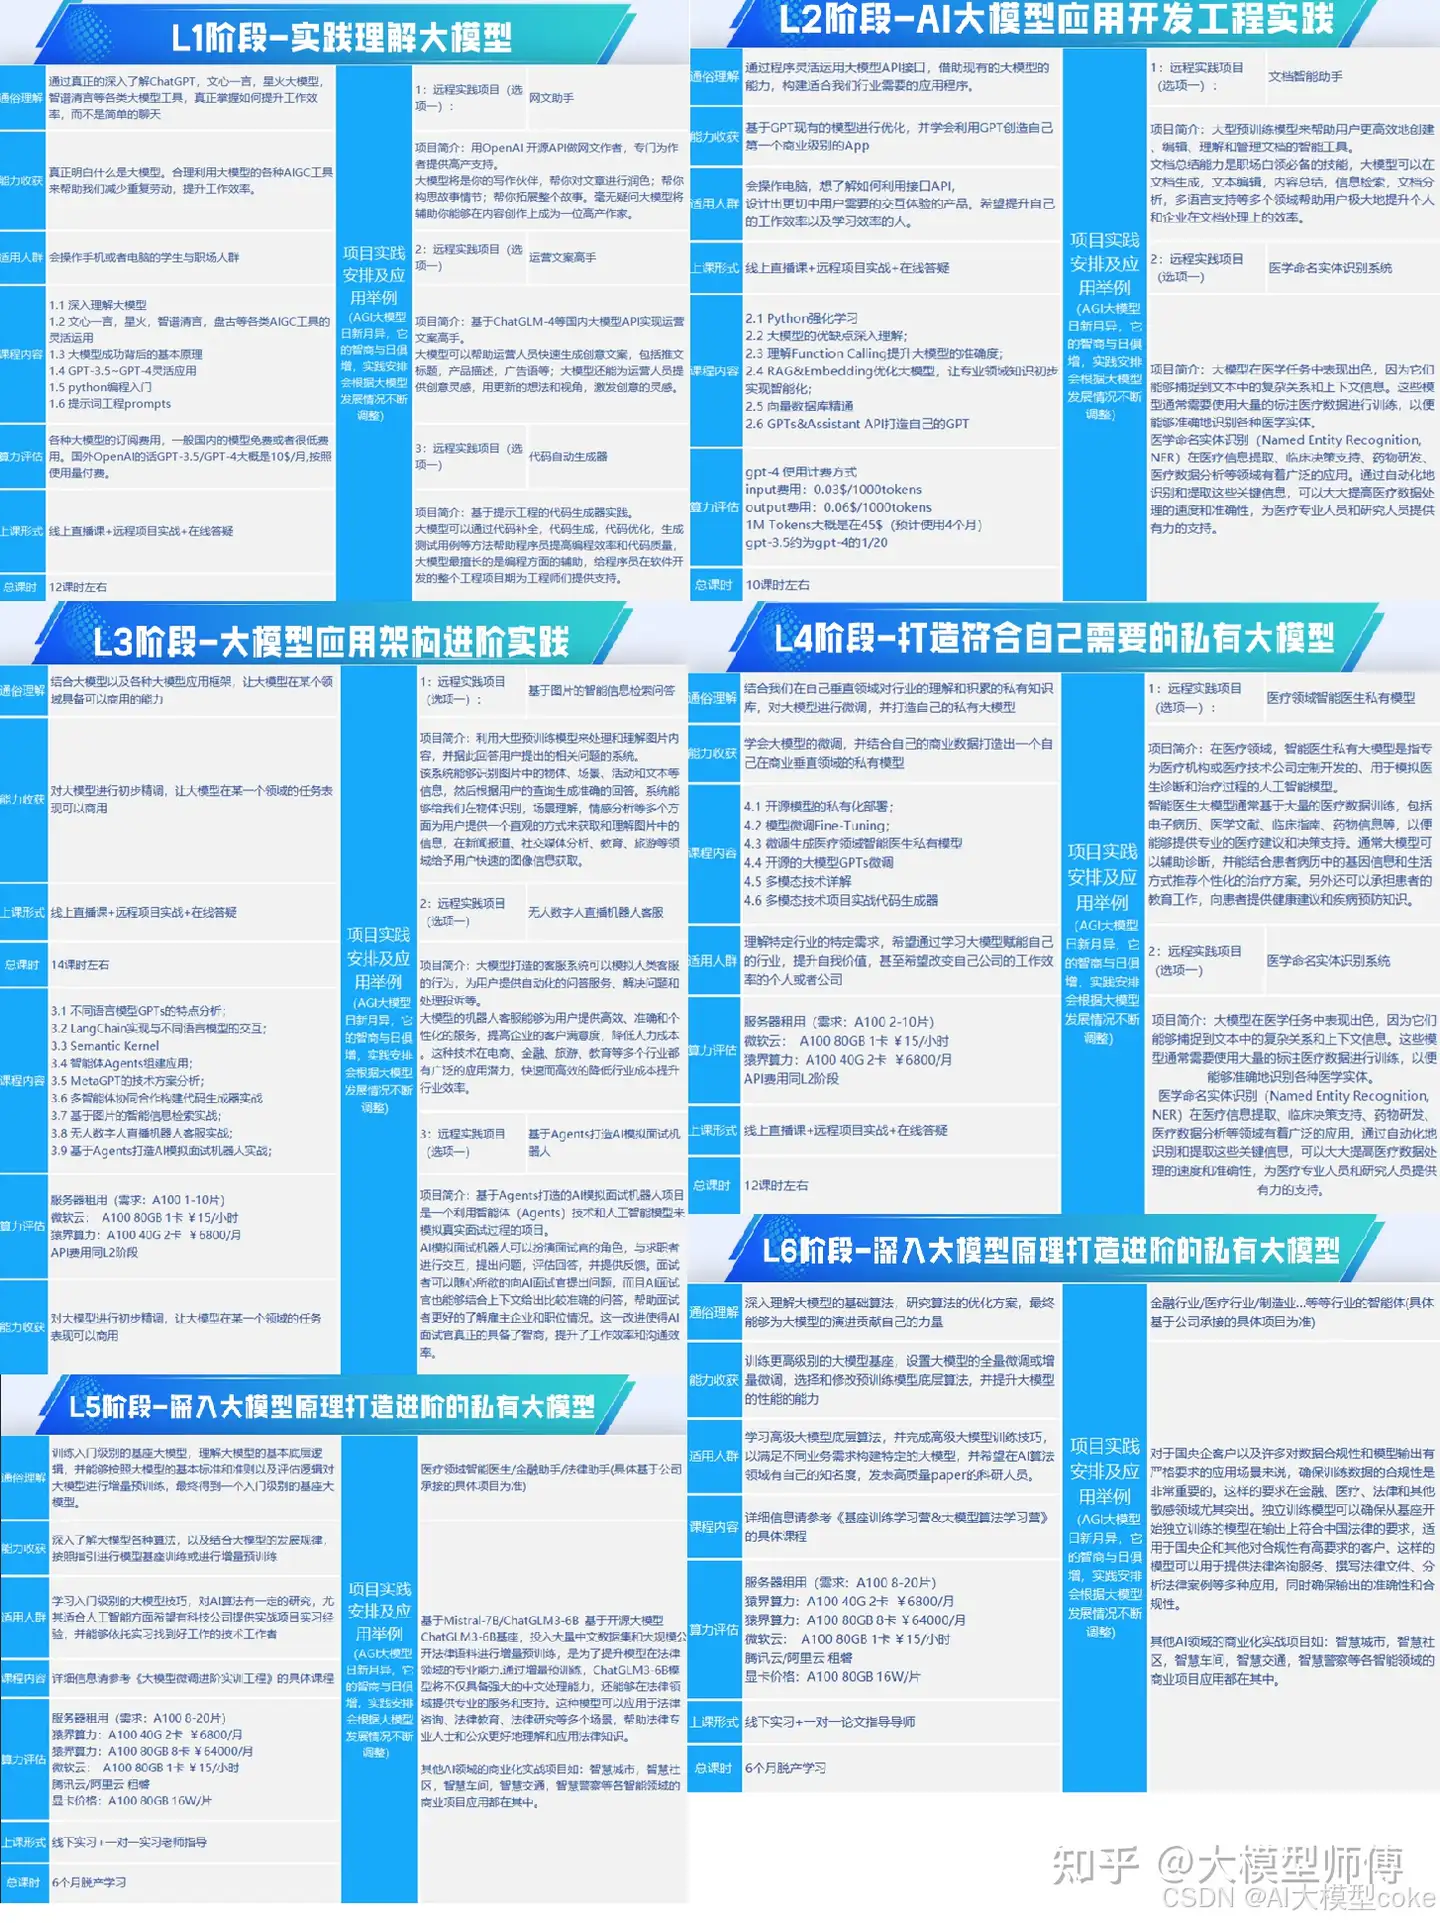
因篇幅有限,仅展示部分资料,需要点击文章最下方名片即可前往获取
二、640套AI大模型报告合集
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。
因篇幅有限,仅展示部分资料,需要点击文章最下方名片即可前往获
三、AI大模型经典PDF籍
随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。
因篇幅有限,仅展示部分资料,需要点击文章最下方名片即可前往获
四、AI大模型商业化落地方案
因篇幅有限,仅展示部分资料,需要点击文章最下方名片即可前往获
作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量
更多推荐


 7
 0
- 0


 已为社区贡献2条内容

所有评论(0)