
文字识别SVTR算法
SVTR算法
- 背景
- 模型结构
- Patch Embedding
- Mixing Blocks
- Global Mixing 和 Local Mixing
- Merging
- Combing和Prediction
背景
OCR通常由俩部分组成,分别是文字检测和文字识别。文字识别算法是由image2text的过程,一般而言是由俩阶段模型组成,一个特征提取模型提取图像特征+一个文本序列模型生成文本。这样的模型通常比较复杂且低效。SVTR在这种背景下提出了基于视觉模块的文本识别模型,相较于CRNN具备更佳的识别效果以及更少的模型参数,做到了快而精。
模型结构
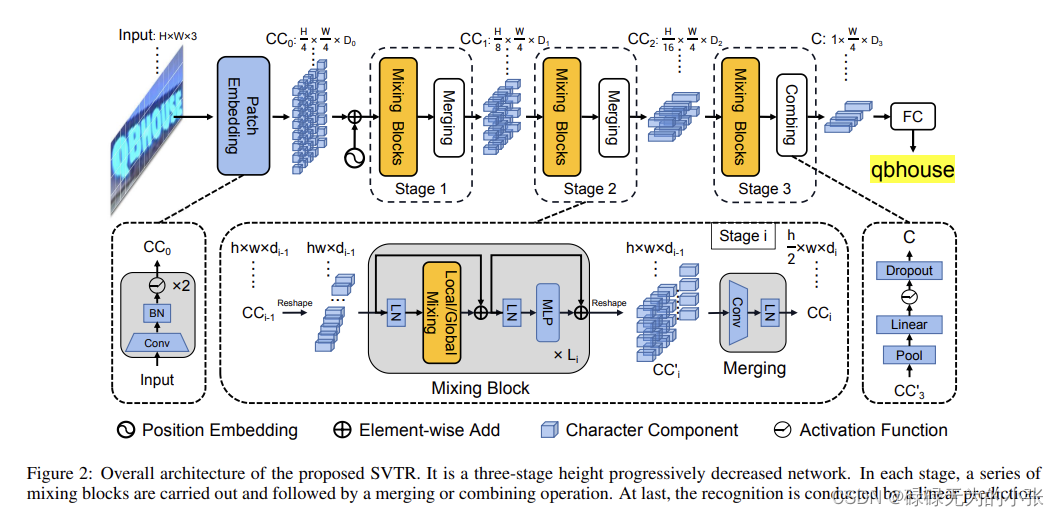
从图上可以看出模型首先做了Patch Embedding,即将图像拆分成4x4的块,并对这些块进行embedding。然后经过了三个Stage,其中Stage1和Stage2是一样的,其中Mixing Blocks是合并了Local信息和Global信息,然后通过Merging模型实现图像的高度减半。Stage3也是先经过了Mixing Blocks,然后通过Combing模块,将高度pooling到1,然后得到(1×W4×D31\times \frac{W}{4}\times D_31×4W×D3)的序列,即序列长度为W4\frac{W}{4}4W,每个token的向量长度为D3D_3D3。最后通过线性分类器实现对每个token的分类预测。
接下来对每个模块进行具体的分析,下文中的代码来自PaddleOCR
Patch Embedding
class PatchEmbed(nn.Layer):
    """Image to Patch Embedding"""

    def __init__(
        self,
        img_size=[32, 100],
        in_channels=3,
        embed_dim=768,
        sub_num=2,
        patch_size=[4, 4],
        mode="pope",
    ):
        super().__init__()
        num_patches = (img_size[1] // (2**sub_num)) * (img_size[0] // (2**sub_num))
        self.img_size = img_size
        self.num_patches = num_patches
        self.embed_dim = embed_dim
        self.norm = None
        if mode == "pope":
            if sub_num == 2:
                self.proj = nn.Sequential(
                    ConvBNLayer(
                        in_channels=in_channels,
                        out_channels=embed_dim // 2,
                        kernel_size=3,
                        stride=2,
                        padding=1,
                        act=nn.GELU,
                        bias_attr=None,
                    ),
                    ConvBNLayer(
                        in_channels=embed_dim // 2,
                        out_channels=embed_dim,
                        kernel_size=3,
                        stride=2,
                        padding=1,
                        act=nn.GELU,
                        bias_attr=None,
                    ),
                )
            if sub_num == 3:
                self.proj = nn.Sequential(
                    ConvBNLayer(
                        in_channels=in_channels,
                        out_channels=embed_dim // 4,
                        kernel_size=3,
                        stride=2,
                        padding=1,
                        act=nn.GELU,
                        bias_attr=None,
                    ),
                    ConvBNLayer(
                        in_channels=embed_dim // 4,
                        out_channels=embed_dim // 2,
                        kernel_size=3,
                        stride=2,
                        padding=1,
                        act=nn.GELU,
                        bias_attr=None,
                    ),
                    ConvBNLayer(
                        in_channels=embed_dim // 2,
                        out_channels=embed_dim,
                        kernel_size=3,
                        stride=2,
                        padding=1,
                        act=nn.GELU,
                        bias_attr=None,
                    ),
                )
        elif mode == "linear":
            self.proj = nn.Conv2D(
                1, embed_dim, kernel_size=patch_size, stride=patch_size
            )
            self.num_patches = (
                img_size[0] // patch_size[0] * img_size[1] // patch_size[1]
            )

    def forward(self, x):
        B, C, H, W = x.shape
        assert (
            H == self.img_size[0] and W == self.img_size[1]
        ), f"Input image size ({H}*{W}) doesn't match model ({self.img_size[0]}*{self.img_size[1]})."
        x = self.proj(x).flatten(2).transpose((0, 2, 1))
        return x
Patch Embedding是实现对图像按4x4的块大小进行Embedding,这里的实现是通过俩个卷积层实现。第一个卷积层使用了卷积核大小为3,stride为2的方式,使图像从(H,W,3)→(H2,W2,D02)(H,W,3)\rightarrow(\frac{H}{2},\frac{W}{2},\frac{D_0}{2})(H,W,3)→(2H,2W,2D0)。然后经过LN层以及GELU激活输出至下一个卷积核,下一个卷积是一样的做法,维度变化为(H2,W2,D02)→(H4,W4,D0)(\frac{H}{2},\frac{W}{2},\frac{D_0}{2})\rightarrow(\frac{H}{4},\frac{W}{4},D_0)(2H,2W,2D0)→(4H,4W,D0)
Mixing Blocks
Mixing Blocks是考虑了在文字识别中,文字的识别通常受全局的影响,同时全局的特征可以使不清晰的局部具备更丰富的特征信息,从而提高识别能力。这也是类似在CRNN中的序列模块使用Bi-LSTM提高模型上下文信息学习能力。在OCR识别的任务,局部特征和全局特征的叠加被广泛使用,有类似于上帝视角和个人视角相结合的意思。
Global Mixing 和 Local Mixing
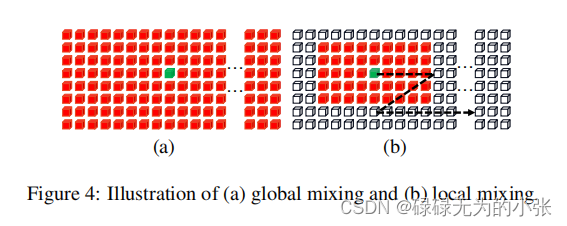
Global Mixing主要是学习上下文信息,更好地考虑一些远距离的信息。具体的实现的方式比较简单,直接将输入的图像看成一个序列,然后直接使用self-attention进行计算。由于是全局,所以不用考虑mask。相较而言,local mixing则是只关注局部特征,实现方式跟global mixing差不多,不过需要对局部之外的部分进行mask。具体实现如下
class Block(nn.Layer):
    def __init__(
        self,
        dim,
        num_heads,
        mixer="Global",
        local_mixer=[7, 11],
        HW=None,
        mlp_ratio=4.0,
        qkv_bias=False,
        qk_scale=None,
        drop=0.0,
        attn_drop=0.0,
        drop_path=0.0,
        act_layer=nn.GELU,
        norm_layer="nn.LayerNorm",
        epsilon=1e-6,
        prenorm=True,
    ):
        super().__init__()
        if isinstance(norm_layer, str):
            self.norm1 = eval(norm_layer)(dim, epsilon=epsilon)
        else:
            self.norm1 = norm_layer(dim)
        if mixer == "Global" or mixer == "Local":
            self.mixer = Attention(
                dim,
                num_heads=num_heads,
                mixer=mixer,
                HW=HW,
                local_k=local_mixer,
                qkv_bias=qkv_bias,
                qk_scale=qk_scale,
                attn_drop=attn_drop,
                proj_drop=drop,
            )
        elif mixer == "Conv":
            self.mixer = ConvMixer(dim, num_heads=num_heads, HW=HW, local_k=local_mixer)
        else:
            raise TypeError("The mixer must be one of [Global, Local, Conv]")

        self.drop_path = DropPath(drop_path) if drop_path > 0.0 else Identity()
        if isinstance(norm_layer, str):
            self.norm2 = eval(norm_layer)(dim, epsilon=epsilon)
        else:
            self.norm2 = norm_layer(dim)
        mlp_hidden_dim = int(dim * mlp_ratio)
        self.mlp_ratio = mlp_ratio
        self.mlp = Mlp(
            in_features=dim,
            hidden_features=mlp_hidden_dim,
            act_layer=act_layer,
            drop=drop,
        )
        self.prenorm = prenorm

    def forward(self, x):
        if self.prenorm:
            x = self.norm1(x + self.drop_path(self.mixer(x)))
            x = self.norm2(x + self.drop_path(self.mlp(x)))
        else:
            x = x + self.drop_path(self.mixer(self.norm1(x)))
            x = x + self.drop_path(self.mlp(self.norm2(x)))
        return x


class Attention(nn.Layer):
    def __init__(
        self,
        dim,
        num_heads=8,
        mixer="Global",
        HW=None,
        local_k=[7, 11],
        qkv_bias=False,
        qk_scale=None,
        attn_drop=0.0,
        proj_drop=0.0,
    ):
        super().__init__()
        self.num_heads = num_heads
        self.dim = dim
        self.head_dim = dim // num_heads
        self.scale = qk_scale or self.head_dim**-0.5

        self.qkv = nn.Linear(dim, dim * 3, bias_attr=qkv_bias)
        self.attn_drop = nn.Dropout(attn_drop)
        self.proj = nn.Linear(dim, dim)
        self.proj_drop = nn.Dropout(proj_drop)
        self.HW = HW
        if HW is not None:
            H = HW[0]
            W = HW[1]
            self.N = H * W
            self.C = dim
        if mixer == "Local" and HW is not None:
            hk = local_k[0]
            wk = local_k[1]
            mask = paddle.ones([H * W, H + hk - 1, W + wk - 1], dtype="float32")
            for h in range(0, H):
                for w in range(0, W):
                    mask[h * W + w, h : h + hk, w : w + wk] = 0.0
            mask_paddle = mask[:, hk // 2 : H + hk // 2, wk // 2 : W + wk // 2].flatten(
                1
            )
            mask_inf = paddle.full([H * W, H * W], "-inf", dtype="float32")
            mask = paddle.where(mask_paddle < 1, mask_paddle, mask_inf)
            self.mask = mask.unsqueeze([0, 1])
        self.mixer = mixer

    def forward(self, x):
        qkv = (
            self.qkv(x)
            .reshape((0, -1, 3, self.num_heads, self.head_dim))
            .transpose((2, 0, 3, 1, 4))
        )
        q, k, v = qkv[0] * self.scale, qkv[1], qkv[2]

        attn = q.matmul(k.transpose((0, 1, 3, 2)))
        if self.mixer == "Local":
            attn += self.mask
        attn = nn.functional.softmax(attn, axis=-1)
        attn = self.attn_drop(attn)

        x = (attn.matmul(v)).transpose((0, 2, 1, 3)).reshape((0, -1, self.dim))
        x = self.proj(x)
        x = self.proj_drop(x)
        return x
可以发现Global Mixing是一个普通的self attention,Local Mixing则是增加了一个mask,这里的mask代码可以自己分析一下。
Local Mixing是计算一个局部窗口的自注意,这里作者默认设定窗口为(7x11)。即hk=7hk=7hk=7,wk=11wk=11wk=11。然后这里
 hk = local_k[0]
 wk = local_k[1]
生成一个全1的mask矩阵,矩阵大小为(H×W,H+hk−1,W+wk−1H\times W,H+hk-1,W+wk-1H×W,H+hk−1,W+wk−1),这里是考虑到边界上点的局部是会超出图像的。
mask = paddle.ones([H * W, H + hk - 1, W + wk - 1], dtype="float32")
这里是指mask矩阵共有H×WH\times WH×W个,每个矩阵对应一个token的局部,这里将每个局部赋0
 for h in range(0, H):
     for w in range(0, W):
         mask[h * W + w, h : h + hk, w : w + wk] = 0.0
提取与图像相对应部分的mask矩阵,超出的部分则裁掉,然后将mask矩阵打平
mask_paddle = mask[:, hk // 2 : H + hk // 2, wk // 2 : W + wk // 2].flatten(1)
对每个mask矩阵进行处理,将非0的部分取负无穷,从而使softmax之后,这些mask部分的权重取0。
 mask_inf = paddle.full([H * W, H * W], "-inf", dtype="float32")
 mask = paddle.where(mask_paddle < 1, mask_paddle, mask_inf)
这里作者先进行Local Mixing,然后再进行Global Mixing,它们是串行的。在其他的方法里会分别进行,然后进行concat或者add。
Merging
Merging是对输入进行高度减半的操作,并将维度从C1C_1C1转为C2C_2C2。
self.conv = nn.Conv2D(in_channels,out_channels,kernel_size=3,
  stride=stride,padding=1, weight_attr=ParamAttr(initializer=KaimingNormal()))
这里比较简单,直接采用了卷积的方式实现
Combing和Prediction
Combing是直接用了Adaptive Pooling,从高度方向,Pool至高度为1。然后直接1x1的卷积实现维度的变换,从D2D_2D2转换为D3D_3D3。,最终得到输出1×W4×D31\times \frac{W}{4}\times D_31×4W×D3
Prediction是从[0,W4][0,\frac{W}{4}][0,4W]上对维度每个维度为D3D_3D3的向量进行分类。
更多推荐

 13
 0
- 0


 已为社区贡献1条内容

所有评论(0)