
build_MiniLLM_from_scratch 入门学习资料汇总 - 从零构建迷你大语言模型
·
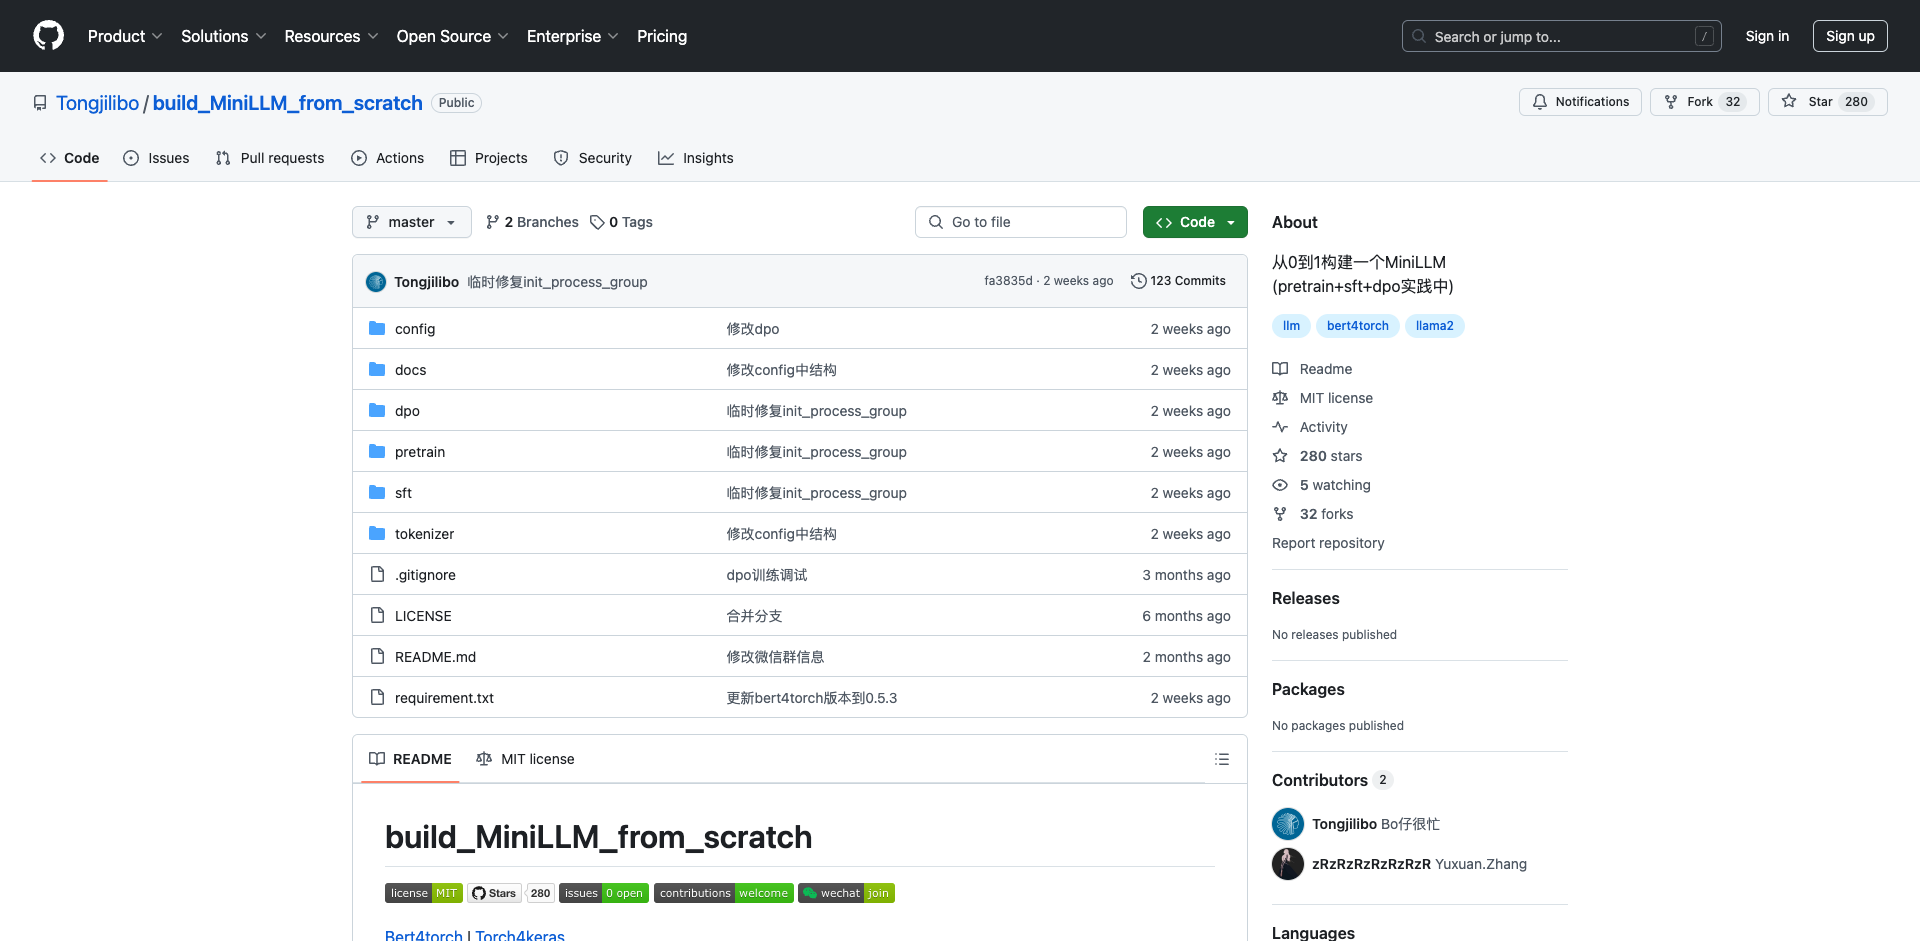
build_MiniLLM_from_scratch 入门学习资料汇总
build_MiniLLM_from_scratch 是一个从零构建迷你大语言模型的开源项目,旨在以可控成本完成一个简单的聊天模型。本文汇总了该项目的关键学习资料,帮助读者快速入门。
项目概述
- GitHub 仓库: build_MiniLLM_from_scratch
- 作者: Bo Li (Tongjilibo)
- 项目目标: 构建小参数量的 LLM,完成预训练、指令微调、奖励模型、强化学习四个阶段
- 当前进度: 已完成预训练和指令微调阶段
项目特色
- 使用 bert4torch 训练框架,代码简洁高效
- 训练的 checkpoint 可直接用 transformers 包推理
- 优化了训练时文件读取方式,减少内存占用
- 提供完整训练 log 供复现比对
- 增加自我认知数据集,可自定义机器人属性
- chat 模型支持多轮对话
快速开始
- 环境安装:
pip install git+https://github.com/Tongjilibo/torch4keras.git
pip install git+https://github.com/Tongjilibo/bert4torch.git@dev
- 预训练:
cd pretrain
torchrun --standalone --nproc_per_node=4 pretrain.py
- 指令微调:
cd sft
python sft.py
预训练语料
项目使用的预训练语料包括:
总计约634亿 Tokens 的数据量。
预训练模型
项目提供了以下几个预训练模型:
-
MiniLLM-0.2B-NoWudao
- 140亿 Tokens 训练
- 下载: 百度网盘, HuggingFace
-
MiniLLM-0.2B-WithWudao
- 640亿 Tokens 训练
- 下载: 百度网盘, HuggingFace
-
MiniLLM-1.1B-WithWudao
- 640亿 Tokens 训练
- 下载: HuggingFace
指令微调数据集
项目使用的指令微调数据集包括:
- Tongjilibo/self_cognition
- shibing624/alpaca-zh
- BelleGroup数据集
- YeungNLP/firefly-train-1.1M
- fnlp/moss-002-sft-data
等多个高质量指令数据集。
指令微调模型
项目提供了以下指令微调模型:
-
MiniLLM-0.2B-WithWudao-SFT_Alpaca
- 4万样本训练
- 下载: 百度网盘, HuggingFace
-
MiniLLM-0.2B-WithWudao-SFT
- 1157万样本训练
- 下载: 百度网盘, HuggingFace
模型使用示例
from transformers import AutoTokenizer, LlamaForCausalLM
import torch

device = 'cuda' if torch.cuda.is_available() else 'cpu'
model_name = 'Tongjilibo/MiniLLM-0.2B-WithWudao-SFT_Alpaca'

tokenizer = AutoTokenizer.from_pretrained(model_name, trust_remote_code=True)
model = LlamaForCausalLM.from_pretrained(model_name).to(device)

query = '你好'
query = f'<human>{query}<robot>'
inputs = tokenizer.encode(query, return_tensors='pt', add_special_tokens=False).to(device)
output_ids = model.generate(inputs)
response = tokenizer.decode(output_ids[0].cpu(), skip_special_tokens=True)[len(query):]
print(response)
未来计划
项目计划继续完成奖励模型和强化学习阶段,构建完整的LLM训练流程。欢迎感兴趣的开发者关注和参与项目开发。
通过本文的资料汇总,相信读者可以快速了解 build_MiniLLM_from_scratch 项目,并开始动手实践构建自己的迷你大语言模型。项目仍在持续更新中,建议定期关注 GitHub 仓库获取最新进展。
项目链接:mp.csdn.net/mp_blog/creation/editor?not_checkout=1
https://mp.csdn.net/mp_blog/creation/editor?not_checkout=1
更多推荐
 20
 0
- 0


 已为社区贡献2条内容

所有评论(0)