
实战:Spring AI + Milvus + RAG高级查询上下文感知和查询重写(附有全部代码)
一、概述
本项目通过 Spring AI 框架 集成 Milvus 向量数据库,构建了一个基于 RAG(Retrieval-Augmented Generation)技术 的智能对话系统。系统不仅实现了基础的 RAG 功能,还引入了 上下文感知查询(Context-aware Queries) 和 查询重写(Query Rewrite) 两种高级 RAG 用法,显著提升了对话的连贯性和检索效率。
-
上下文感知查询(Context-aware Queries)
在多轮对话中,用户的问题通常依赖于之前的上下文。例如,用户先问不爱学习康复医院的副主任医生都有谁?随后可能追问还有么?。系统通过上下文感知查询,能够理解用户意图并生成连贯的回复,例如除了XXX,还有其他副主任医生吗?这种能力确保了对话的连贯性和用户体验。 -
查询重写(Query Rewrite)
查询重写技术可以将用户的自然语言查询转化为更结构化、更明确的形式,从而提高检索的准确性和效率。例如,用户提问我想去北京,坐高铁过去,北京有什么景点比较好玩,还得便宜,系统会将其重写为北京有哪些性价比高的旅游景点?,从而更精准地匹配知识库内容。
技术架构与挑战
本项目的技术栈包括SpringAI、Milvus、Etcd、Minio和Attu。其中,Milvus作为向量数据库,负责存储和检索向量化的知识库数据;Etcd用于分布式协调;Minio提供对象存储支持;Attu则是Milvus的管理工具。这些组件的版本匹配和兼容性是项目成功的关键。
二. 环境准备
在开始之前,请确保你的环境满足以下要求:
- 操作系统:Windows 11
- Java 版本:JDK 17+(请注意 Spring Boot 3.4.4 的兼容性)
- 依赖管理:Maven 3.8.3+
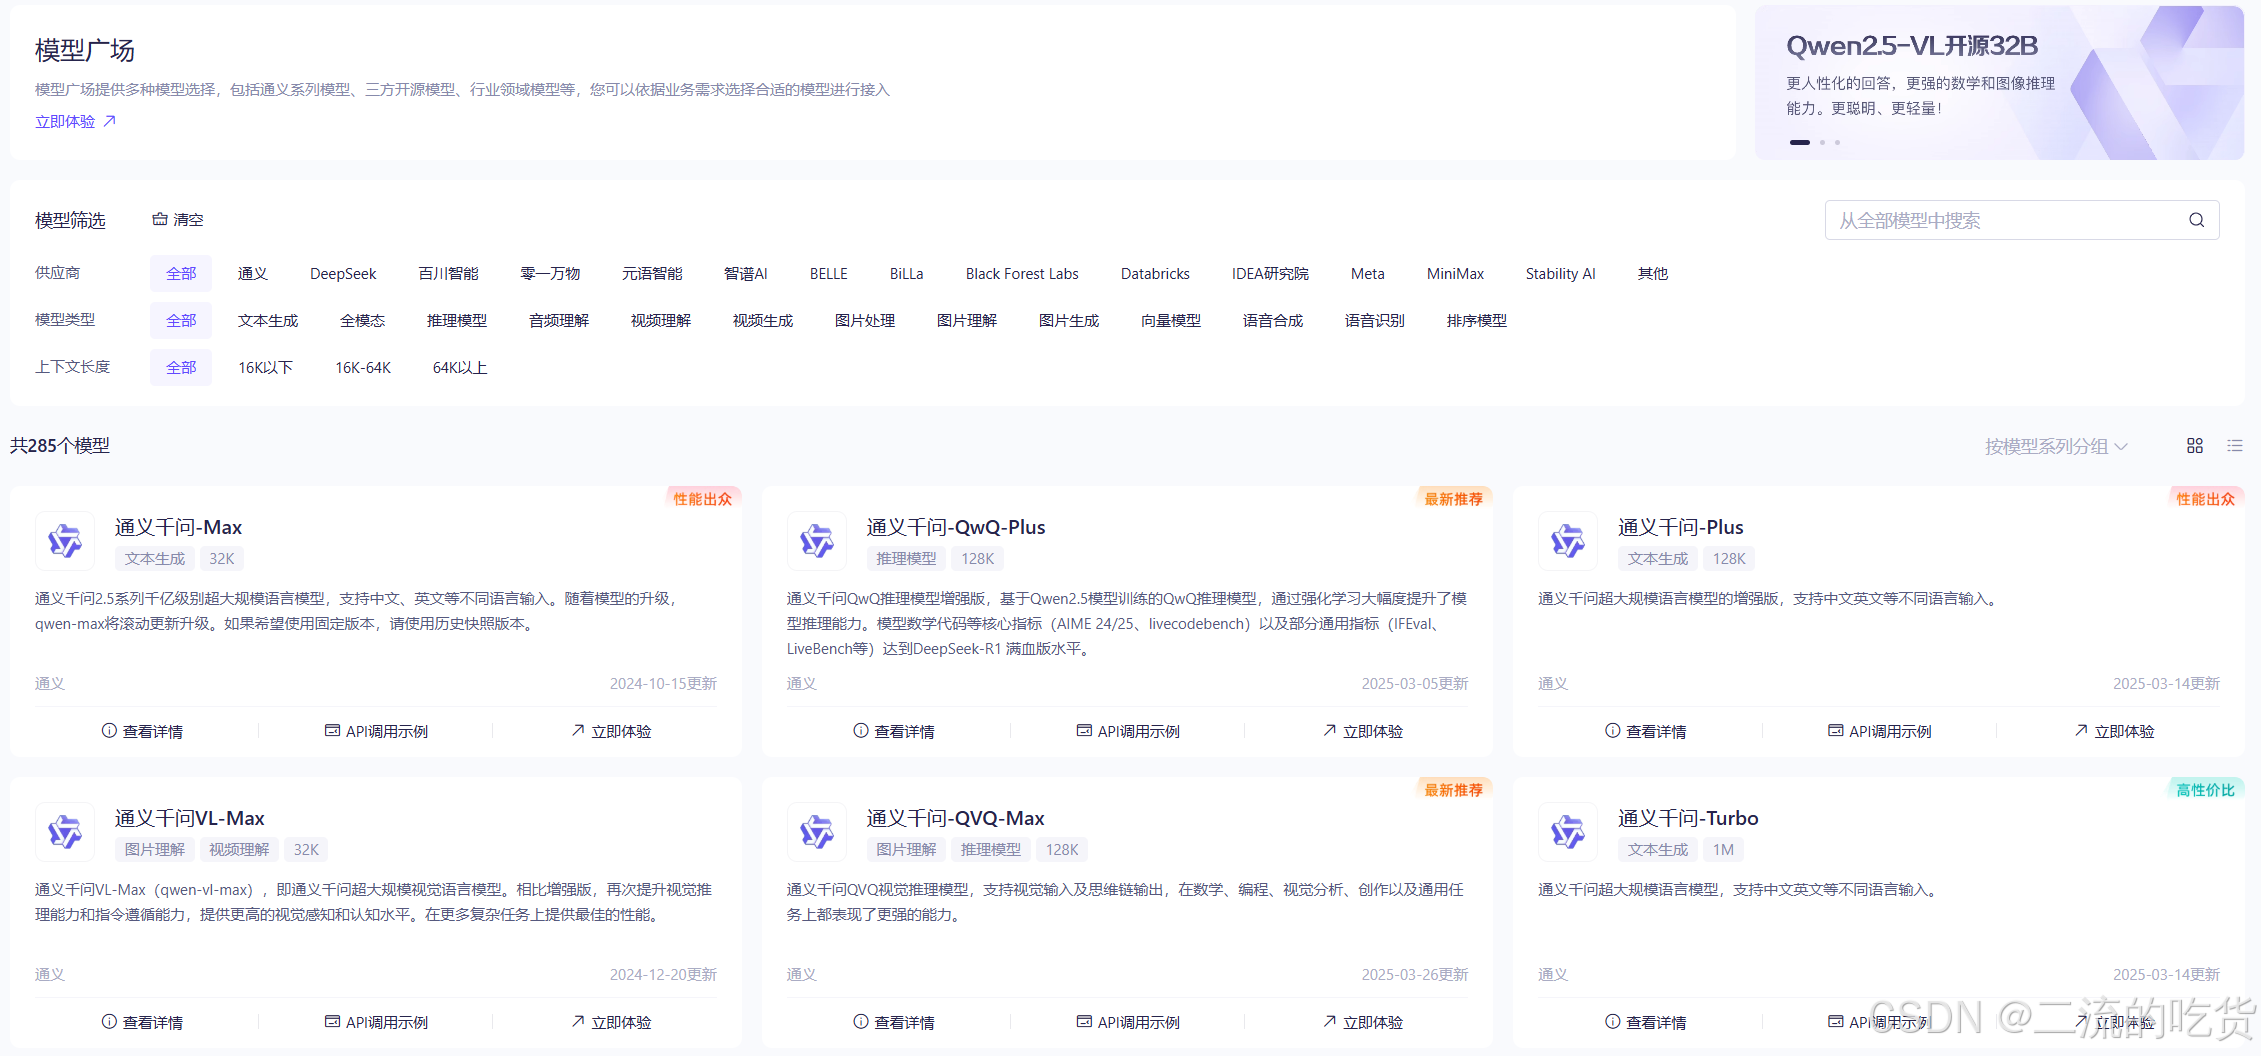
- 阿里云百炼平台: 账号申请 后,可以查看到以下模型的选择
三. 功能介绍
-
1. Docker环境搭建
通过Docker部署Redis、Milvus及相关组件,确保环境一致性。Redis用于存储对话历史,Milvus负责向量检索,两者结合实现了高效的对话记忆和知识库查询。- Redis 部署:通过 Docker 快速部署 Redis 7.4.2 版本,配置持久化存储和密码保护,确保数据安全。
- Milvus 及相关组件部署:通过 Docker Compose 自动化部署 Milvus、Etcd、Minio 和 Attu,确保各组件版本兼容,简化了复杂的安装流程。
2. SpringAI框架集成
Spring AI 作为核心框架,提供了对话系统开发的基础支持。通过集成 Spring AI Alibaba 模块,项目无缝对接阿里百炼平台的高性能模型(如qwq-plus、 DeepSeek-R1)和文本嵌入模型(text-embedding-v2),为对话生成和向量表示提供了强大的能力。- 模型集成:通过阿里百炼平台的 API-KEY,项目能够调用
qwq-plus模型进行对话生成,并使用text-embedding-v2模型生成文本的向量表示。 - 对话规则配置:通过
ChatClient配置对话规则和风格,确保对话的连贯性和一致性。
3. Redis对话记忆
项目通过 Redis 实现了对话历史的持久化存储,支持多轮对话的连贯性。开发者可根据需求灵活扩展为 MySQL 持久化或混合存储方案。- 对话历史存储:通过 Redis 的列表结构存储对话历史,支持快速查询和过期清理。
- 灵活扩展:支持将对话历史存储扩展为 MySQL 或其他数据库,满足不同场景的需求。
4. RAG技术实现
基于阿里百炼的嵌入模型和Milvus,项目实现了本地知识库功能。通过RAG技术,系统能够从知识库中检索相关信息并融入对话生成。测试数据包括虚拟的医院介绍、科室信息和医生资料,验证了RAG的检索能力和对话生成效果。- 知识库构建:通过文本切分和向量化处理,将知识库数据写入Milvus向量数据库。
- 检索与生成:通过向量检索获取相关信息,并结合对话模型生成连贯的回答。
5. 高级RAG用法
- 上下文感知查询:通过历史对话构建上下文,确保多轮对话的连贯性。
- 查询重写:优化用户输入,提升检索效率和准确性。
四、Docker安装与软件部署
** 1. 安装docker**
本地环境使用Docker进行部署,可以大大节省环境配置的工作量,同时减少组件对系统性能的影响。在不开发时,关闭Docker,还能避免各种干扰。对于还不熟悉Docker的同学,建议尽快学习掌握这一强大工具。
由于很多教程都是基于Linux系统的,这里我们详细讲解一下在Windows本地环境下的搭建步骤。首先,访问docker官网,根据你的系统选择合适的版本进行下载和安装。安装完成后,进入PowerShell,输入指令docker ps,如果能看到相关输出,说明Docker安装成功。

安装后,进入PowerShell,输入指令 docker ps ,看到这个就OK了

2. Redis容器部署
说明:此命令从Docker Hub拉取指定版本的Redis镜像,为后续的容器部署做好准备。
docker pull redis:7.4.2
在本地创建文件夹C:\docker\redis\conf和C:\docker\redis\data,并在conf文件夹下创建文件redis.conf,内容如下:
bind 0.0.0.0
port 6379
requirepass 123123
dir /data
appendonly yes
bind 0.0.0.0:允许外部访问requirepass 123123:设置访问密码,你可以根据需要自行设定,虽然是本地环境,但养成良好的安全习惯很重要appendonly yes:开启AOF持久化
接下来,进行容器部署:
docker run -d \
-p 6579:6379 \
-v C:/docker/redis/data:/data \
-v C:/docker/redis/conf:/usr/local/etc/redis \
--name redis \
redis:7.4.2 redis-server /usr/local/etc/redis/redis.conf
说明:通过上述命令,我们基于刚才拉取的镜像创建并启动了一个Redis容器,同时将本地的配置文件和数据目录挂载到容器中,方便进行持久化存储和配置管理。
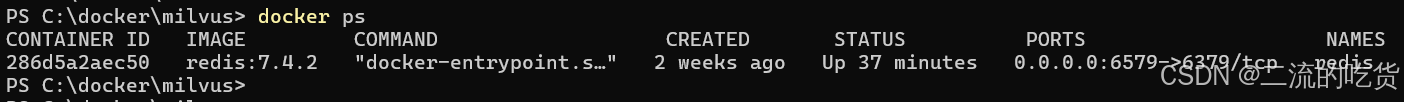
3、Milvus大礼包部署
由于Milvus的安装和配置较为复杂,需要同时部署Etcd、Minio和Attu,这些组件的版本匹配和兼容性是项目成功的关键。通过 Docker Compose 实现了自动化部署,大大简化了环境搭建的复杂度。
- Milvus版本:v2.5.4
- Etcd版本:v3.5.16
- Minio版本:RELEASE.2023-03-20T20-16-18Z
- Attu版本:v2.5
在本地创建文件夹 C:\docker\milvus , 并在文件夹下创建文件 docker-compose.yml, 文件内容如下(很重要):
# 定义 Docker Compose 服务
services:

  # 配置 etcd 服务
  etcd:
    container_name: milvus-etcd  # 容器名称
    image: quay.io/coreos/etcd:v3.5.16  # 使用的镜像
    environment:
      - ETCD_AUTO_COMPACTION_MODE=revision  # 自动压缩模式
      - ETCD_AUTO_COMPACTION_RETENTION=1000  # 保留的修订版本数
      - ETCD_QUOTA_BACKEND_BYTES=4294967296  # 后端存储限制
      - ETCD_SNAPSHOT_COUNT=50000  # 快照计数
    volumes:
      - ${DOCKER_VOLUME_DIRECTORY:-.}/volumes/etcd:/etcd  # 数据卷挂载
    command: etcd -advertise-client-urls=http://127.0.0.1:2379 -listen-client-urls=http://0.0.0.0:2379 --data-dir /etcd  # 启动命令
    healthcheck:
      test: ["CMD", "etcdctl", "endpoint", "health"]  # 健康检查命令
      interval: 30s  # 检查间隔
      timeout: 20s  # 超时时间
      retries: 3  # 重试次数

  # 配置 MinIO 服务
  minio:
    container_name: milvus-minio  # 容器名称
    image: minio/minio:RELEASE.2023-03-20T20-16-18Z  # 使用的镜像
    environment:
      MINIO_ACCESS_KEY: minioadmin  # MinIO 访问密钥
      MINIO_SECRET_KEY: minioadmin  # MinIO 密钥
    ports:
      - "9001:9001"  # 控制台端口映射
      - "9000:9000"  # 服务端口映射
    volumes:
      - ${DOCKER_VOLUME_DIRECTORY:-.}/volumes/minio:/minio_data  # 数据卷挂载
    command: minio server /minio_data --console-address ":9001"  # 启动命令
    healthcheck:
      test: ["CMD", "curl", "-f", "http://localhost:9000/minio/health/live"]  # 健康检查命令
      interval: 30s  # 检查间隔
      timeout: 20s  # 超时时间
      retries: 3  # 重试次数

  # 配置 Milvus 服务
  standalone:
    container_name: milvus-standalone  # 容器名称
    image: milvusdb/milvus:v2.5.4  # 使用的镜像
    command: ["milvus", "run", "standalone"]  # 启动命令
    security_opt:
    - seccomp:unconfined  # 安全选项
    environment:
      ETCD_ENDPOINTS: etcd:2379  # etcd 服务地址
      MINIO_ADDRESS: minio:9000  # MinIO 服务地址
    volumes:
      - ${DOCKER_VOLUME_DIRECTORY:-.}/volumes/milvus:/var/lib/milvus  # 数据卷挂载
    healthcheck:
      test: ["CMD", "curl", "-f", "http://localhost:9091/healthz"]  # 健康检查命令
      interval: 30s  # 检查间隔
      start_period: 90s  # 启动等待时间
      timeout: 20s  # 超时时间
      retries: 3  # 重试次数
    ports:
      - "19530:19530"  # 服务端口映射
      - "9091:9091"  # 管理端口映射
    depends_on:
      - "etcd"  # 依赖 etcd 服务
      - "minio"  # 依赖 MinIO 服务

  # 配置 Milvus Dashboard 服务
  dashboard:
    image: zilliz/attu:v2.5  # 使用的镜像
    container_name: milvus-dashboard  # 容器名称
    environment:
      MILVUS_URL: http://standalone:19530  # Milvus 服务地址
    ports:
      - "8000:3000"  # 端口映射
    depends_on:
      - standalone  # 依赖 Milvus 服务
      - etcd  # 依赖 etcd 服务
      - minio  # 依赖 MinIO 服务

# 定义网络配置
networks:
  default:
    name: milvus  # 网络名称
然后执行命令 docker compose up -d , 如果没有报错,你就安静的等吧(我的网络差不多等了20分钟),直到最后看到如下图

我们再查看一下进程,看样子都起来了:

查看客户端, 输入地址 http://localhost:8000/
进入如下界面:此时什么都不要填写,直接点【连接】按钮

进入系统后

我们点击左侧头像,进入“用户和角色”管理界面

我们新建用户和角色: 用户名:derek, 密码: milvus-4321 (这里要和我们spring工程里的配置一致),角色我们选 admin, 点击 【创建】按钮,就大功告成了。


五. Spring AI 集成:完整代码实现
Spring AI 作为核心框架,提供了对话系统开发的基础支持。通过集成 Spring AI Alibaba 模块,项目无缝对接阿里百炼平台的高性能模型(如 qwq-plus 、DeepSeek-R1)和文本嵌入模型(text-embedding-v2),为对话生成和向量表示提供了强大的能力。
** 1. maven的核心依赖**
<!-- 全局属性管理 -->
    <properties>
        <java.version>23</java.version>
        <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding>
        <project.reporting.outputEncoding>UTF-8</project.reporting.outputEncoding>
        <!-- 自定义依赖版本 -->
        <spring-boot.version>3.4.4</spring-boot.version>
        <spring-ai.version>1.0.0-M6</spring-ai.version>
        <spring-alibaba.version>1.0.0-M6.1</spring-alibaba.version>
        <maven.compiler.version>3.11.0</maven.compiler.version>
    </properties>

    <dependencies>
        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-data-redis</artifactId>
            <version>${spring-boot.version}</version>
        </dependency>
        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-web</artifactId>
            <version>${spring-boot.version}</version>
        </dependency>
        <dependency>
            <groupId>org.springframework.ai</groupId>
            <artifactId>spring-ai-milvus-store-spring-boot-starter</artifactId>
        </dependency>
        <dependency>
            <groupId>com.alibaba.cloud.ai</groupId>
            <artifactId>spring-ai-alibaba-starter</artifactId>
            <version>${spring-alibaba.version}</version>
        </dependency>
        <dependency>
            <groupId>org.projectlombok</groupId>
            <artifactId>lombok</artifactId>
            <version>1.18.32</version>
            <optional>true</optional>
        </dependency>
        <dependency>
            <groupId>org.apache.commons</groupId>
            <artifactId>commons-lang3</artifactId>
            <version>3.17.0</version>
        </dependency>
    </dependencies>
    <dependencyManagement>
        <dependencies>
            <dependency>
                <groupId>org.springframework.ai</groupId>
                <artifactId>spring-ai-bom</artifactId>
                <version>${spring-ai.version}</version>
                <type>pom</type>
                <scope>import</scope>
            </dependency>
        </dependencies>
    </dependencyManagement>

    <!-- 构建配置 -->
    <build>
        <plugins>
            <!-- 编译器插件 -->
            <plugin>
                <groupId>org.apache.maven.plugins</groupId>
                <artifactId>maven-compiler-plugin</artifactId>
                <version>${maven.compiler.version}</version>
                <configuration>
                    <release>${java.version}</release>
                    <annotationProcessorPaths>
                        <path>
                            <groupId>org.projectlombok</groupId>
                            <artifactId>lombok</artifactId>
                            <version>1.18.32</version>
                        </path>
                    </annotationProcessorPaths>
                </configuration>
            </plugin>

            <!-- Spring Boot打包插件 -->
            <plugin>
                <groupId>org.springframework.boot</groupId>
                <artifactId>spring-boot-maven-plugin</artifactId>
                <configuration>
                    <excludes>
                        <exclude>
                            <groupId>org.projectlombok</groupId>
                            <artifactId>lombok</artifactId>
                        </exclude>
                    </excludes>
                </configuration>
            </plugin>
        </plugins>
    </build>

    <!-- 仓库配置 -->
    <repositories>
        <repository>
            <id>alimaven</id>
            <name>aliyun maven</name>
            <url>https://maven.aliyun.com/repository/public</url>
        </repository>
        <repository>
            <id>spring-milestones</id>
            <name>Spring Milestones</name>
            <url>https://repo.spring.io/milestone</url>
            <snapshots>
                <enabled>false</enabled>
            </snapshots>
        </repository>
        <repository>
            <id>spring-snapshots</id>
            <name>Spring Snapshots</name>
            <url>https://repo.spring.io/snapshot</url>
            <releases>
                <enabled>false</enabled>
            </releases>
        </repository>
    </repositories>
说明:上述配置文件中,我们引入了Spring Boot、Spring AI、Alibaba Cloud AI等核心依赖,确保项目能够顺利构建和运行。同时,通过配置Maven插件和仓库,优化项目的构建流程和依赖管理。
** 2. 核心配置(application.yml)**
这里一定要注意的是文本推理模型 model: deepseek-r1, 嵌入模型model: text-embedding-v2用来生成文本的向量数据
server:
  port: 8080
spring:
  application:
    name: Ollama-AI
  data:
    redis:
      host: 127.0.0.1
      port: 6579
      password: 123123
      database: 1
  ai:
    dashscope:
      #      注意这个理是使用阿里云百炼平台的API-KEY
      api-key: sk-*****************
      model: deepseek-r1
      embedding:
        options:
          #      嵌入的向量模型
          model: text-embedding-v2
    vectorstore:
      milvus:
        client:
          host: "localhost"
          port: 19530
          username: "derek"
          password: "milvus-4321"
        databaseName: "default"
        collectionName: "vector_store"
        embeddingDimension: 1536
        indexType: IVF_FLAT
        metricType: COSINE
        initialize-schema: true
说明:在配置文件中,我们设置了服务器端口、Redis连接信息、Milvus地址以及AI模型的相关参数。通过这些配置,项目能够正确连接到各个服务,并使用指定的模型进行对话处理和数据存储。
3. 实现连续对话
** 控制器层(RagAdvanceController.java)**
@Slf4j
@RestController
@RequestMapping("/ai/v1")
public class RagAdvanceController {

    @Autowired
    private ChatClient chatClient;
    @Autowired
    private VectorStore vectorStore;
    @Autowired
    private ChatMemory chatMemory;

    // 对话记忆长度
    private final Integer CHAT_HISTORY_SIZE = 10;

    /**
     * 将本地数据(static/demoHospital.txt)写入到向量数据库中
     * @return
     * @throws IOException
     */
    @GetMapping("/data/load")
    public String loadData() throws IOException {
        // 1. 读取文件
        DocumentReader reader = new TextReader("static/demoHospital.txt");
        List<Document> docs = reader.get();

        // 2.切分文件
        List<Document> splitDocuments = new TokenTextSplitter(
                400, 100, 20, 200, true)
                .apply(docs);  // 参数:块大小、重叠长度、最大块数等
        log.info("文件切分为 [{}]", splitDocuments.size());

         //3.写入数据
        vectorStore.add(splitDocuments);

        return "success";
    }

    /**
     * 查询重写
     * @param userId
     * @param inputMsg
     * @return
     */
    @GetMapping(value = "/rag/rewrite/chat", produces = "text/plain; charset=UTF-8")
    public String ragChatByRewrite(@RequestParam String userId, @RequestParam String inputMsg) {
        // 1、构建查询重写转换器
        QueryTransformer queryTransformer = RewriteQueryTransformer.builder()
                .chatClientBuilder(chatClient.mutate())
                .build();
        // 2、执行查询重写
        Query queryByTransform = queryTransformer.transform(new Query(inputMsg));
        // 3、输出重写后的查询文案
        return queryByTransform.text();
    }


    /**
     * 上下文感知查询
     * @param userId
     * @param inputMsg
     * @return
     */
    @GetMapping(value = "/rag/history/chat", produces = "text/plain; charset=UTF-8")
    public String ragChatByHistory(@RequestParam String userId, @RequestParam String inputMsg) {
        // 1. 获取历史消息
        List<Message> history = chatMemory.get(userId, CHAT_HISTORY_SIZE);
        // 2. 构建查询对象
        Query query = Query.builder()
                .text(inputMsg)
                .history(history)
                .build();

        // 3. 创建 CompressionQueryTransformer
        CompressionQueryTransformer queryTransformerByHis = CompressionQueryTransformer.builder()
                .chatClientBuilder(chatClient.mutate())
                .build();

        // 4、执行历史信息后查询
        Query queryByHistory = queryTransformerByHis.transform(query);

        // 5、输出重写后的查询文案
        return queryByHistory.text();
    }

    /**
     * 调用大模型进行数据对话
     * @param userId
     * @param message
     * @return
     */
    @GetMapping(value = "/rag/chat", produces = "text/plain; charset=UTF-8")
    public String ragChat(@RequestParam String userId, @RequestParam String message) {
        log.info("userId -> [{}], message --> [{}]", userId, message);
        String text = chatClient.prompt()
                .user(message)
                .advisors(new MessageChatMemoryAdvisor(chatMemory,userId, CHAT_HISTORY_SIZE))
                .call().content();
        return text;
    }
}
说明:RagAdvanceController 提供了4个对外的接口:
- 数据加载(/data/load)功能:通过
loadData方法,将本地文本文件(如医院介绍)加载到向量数据库中,为后续的检索和对话提供数据支持。 - 查询重写(/rag/rewrite/chat)功能:将用户的自然语言查询转化为更结构化、更明确的形式,从而提高检索的准确性和效率。
- 上下文感知(/rag/history/chat)查询:结合对话历史构建上下文,确保多轮对话的连贯性和用户体验。
- 对话处理(/rag/chat)功能:调用大模型进行对话生成,结合向量检索结果生成连贯的回答,并通过 Redis 存储对话历史,支持多轮对话的上下文管理。
Redis持久化(ChatRedisMemory.java)
@Slf4j
@Component
public class ChatRedisMemory implements ChatMemory {

    private static final String KEY_PREFIX = "chat:history:";
    private final RedisTemplate<String, Object> redisTemplate;

    public ChatRedisMemory(RedisTemplate<String, Object> redisTemplate) {
        this.redisTemplate = redisTemplate;
    }

    @Override
    public void add(String conversationId, List<Message> messages) {
        String key = KEY_PREFIX + conversationId;
        List<ChatEntity> listIn = new ArrayList<>();
        for(Message msg: messages){
            String[] strs = msg.getText().split("</think>");
            String text = strs.length==2?strs[1]:strs[0];

            ChatEntity ent = new ChatEntity();
            ent.setChatId(conversationId);
            ent.setType(msg.getMessageType().getValue());
            ent.setText(text);
            listIn.add(ent);
        }
        redisTemplate.opsForList().rightPushAll(key,listIn.toArray());
        redisTemplate.expire(key, 30, TimeUnit.MINUTES);
    }

    @Override
    public List<Message> get(String conversationId, int lastN) {
        String key = KEY_PREFIX + conversationId;
        Long size = redisTemplate.opsForList().size(key);
        if (size == null || size == 0){
            return Collections.emptyList();
        }

        int start = Math.max(0, (int) (size - lastN));
        List<Object> listTmp = redisTemplate.opsForList().range(key, start, -1);
        List<Message> listOut = new ArrayList<>();
        ObjectMapper objectMapper = new ObjectMapper();
        for(Object obj: listTmp){
            ChatEntity chat =  objectMapper.convertValue(obj, ChatEntity.class);
//            log.info("MessageType.USER [{}], chat.getType [{}]",MessageType.USER, chat.getType());
            if(MessageType.USER.getValue().equals(chat.getType())){
                listOut.add(new UserMessage(chat.getText()));
            }else if(MessageType.ASSISTANT.getValue().equals(chat.getType())){
                listOut.add(new AssistantMessage(chat.getText()));
            }else if(MessageType.SYSTEM.getValue().equals(chat.getType())){
                listOut.add(new SystemMessage(chat.getText()));
            }
        }
        return listOut;
    }

    @Override
    public void clear(String conversationId) {
        redisTemplate.delete(KEY_PREFIX + conversationId);
    }
}
说明:此组件实现了 ChatMemory 接口,利用Redis进行对话历史记录的持久化存储。通过RedisTemplate操作Redis列表,实现了对话记录的添加、获取和清除功能,确保对话上下文能够在多次请求之间保持连贯,从而支持连续对话。
** 配置类与序列化(RedisConfig.java)**
@Configuration
public class RedisConfig {

    @Bean
    public RedisTemplate<String, Object> redisTemplate(RedisConnectionFactory factory) {
        //生成整个 RedisTemplate
        RedisTemplate<String, Object> redisTemplate = new RedisTemplate<>();
        redisTemplate.setConnectionFactory(factory);
        redisTemplate.setKeySerializer(new StringRedisSerializer());
        redisTemplate.setValueSerializer(new Jackson2JsonRedisSerializer<>(Object.class));
        redisTemplate.setHashKeySerializer(new StringRedisSerializer());
        redisTemplate.setHashValueSerializer(new Jackson2JsonRedisSerializer<>(Object.class));
        redisTemplate.afterPropertiesSet();
        return redisTemplate;
    }
}
说明:该配置类用于创建 RedisTemplate Bean,通过设置不同的序列化方式,确保在与Redis进行数据交互时,键和值能够正确地进行序列化和反序列化操作,从而保证数据的完整性和可读性。
** 实体类(ChatEntity.java)**
@NoArgsConstructor
@AllArgsConstructor
@Data
public class ChatEntity implements Serializable {
    String chatId;
    String type;
    String text;
}
说明:这是一个简单的Java实体类,用于表示对话中的每一条消息记录。包含对话ID、消息类型和消息文本三个属性,通过Lombok的注解自动生成构造方法、getter和setter方法,简化了代码编写。
** 4. 聊天对话的初始化bean**
@Configuration
@RequiredArgsConstructor
public class ChatInit {

    private final VectorStore vectorStore;
    @Autowired
    private ChatModel chatModel;

    @Bean
    public ChatClient chatClient(ChatMemory chatMemory) {
        return ChatClient.builder(chatModel)
                // 设置系统的默认行为和风格
                .defaultSystem("你是一个专业的助手,遇到不确定或不明确的信息时," +
                        "会主动询问用户以获取更多信息。在回答问题时," +
                        "你倾向于使用条理清晰的格式,如果信息复杂或包含多个部分," +
                        "请确保每个部分都有适当的标题以创建分层结构。")
                // 注册向量检索顾问,用于从向量存储中检索相关信息
                .defaultAdvisors(
                        new QuestionAnswerAdvisor(
                                vectorStore,
                                SearchRequest.builder()
                                        .similarityThreshold(0.1) // 设置相似度阈值
                                        .topK(10) // 设置返回最多 10 条相关结果
                                        .build()
                        )
                )
                .build();
    }

    @Bean
    public ChatMemory chatMemory(RedisTemplate<String, Object> redisTemplate) {
        return new ChatRedisMemory(redisTemplate);
    }
}
说明:
- 对话初始化:通过
ChatClient配置对话规则和风格,确保对话的连贯性和一致性; - 向量检索:结合
QuestionAnswerAdvisor和VectorStore,从向量存储中检索相关信息,提升对话的准确性; - 对话记忆:基于 Redis 实现对话记忆,确保对话的上下文一致性。
** 6. 启动类(ToolCallingApplication.java)**
@SpringBootApplication
public class ToolCallingApplication {

	public static void main(String[] args) {
		SpringApplication.run(ToolCallingApplication.class, args);
	}

}
说明: 这是Spring Boot应用的启动类,通过 @SpringBootApplication 注解启用Spring Boot的功能,提高应用的性能和效率。
六. 数据准备
我让kimi帮我生成了一个医院的介绍,包含
- 医院
不爱学习康复医院的介绍, - 3个科室的介绍,分别是
学不会科,学不好科,爱学习科 - 每个科室也有对应的医生信息
文本名称 demoHospital.txt
1. 医院介绍
不爱学习康复医院坐落在风景如画的青云市,是一所独具特色的康复专科医院。医院秉持着“让学习不再成为负担,助力患者重拾学习热情”的理念,专注于帮助各类学习障碍患者恢复学习能力,提升学习信心。自2015年建院以来,医院凭借其专业的医疗团队、先进的康复设备和个性化的治疗方案,赢得了患者和家属的广泛赞誉。
医院占地面积约50亩,建筑面积达8000平方米,拥有300张床位。医院设有学不会科、学不好科和爱学习科等特色科室,配备了智能康复机器人、虚拟现实康复系统等先进设备,为患者提供全面、科学的康复治疗。目前,医院有职工300余人,其中高级职称专家50余名,硕士研究生导师20名。他们不仅在临床工作中积累了丰富的经验,还积极参与科研和教学工作,为康复医学的发展做出了重要贡献。
2. 科室介绍
(1)学不会科:
学不会科是医院的核心科室之一,主要针对那些在学习上有严重障碍的患者,如患有注意力缺陷多动障碍(ADHD)、阅读障碍、数学障碍等。科室配备了一支由心理学家、康复治疗师和教育专家组成的多学科团队,为患者提供全面的评估和个性化的康复治疗方案。他们采用认知行为疗法、感觉统合训练、注意力训练等多种方法,帮助患者逐步克服学习障碍,提升学习能力。此外,学不会科还定期开展家长培训课程,帮助家长更好地理解和支持孩子的康复过程,共同助力患者回归正常学习轨道。
(2)学不好科:
学不好科专注于帮助那些学习能力不足但有潜力提升的患者。这些患者可能没有明显的学习障碍,但在学习过程中遇到诸多困难,如学习方法不当、学习动力不足、情绪管理不佳等。科室采用个性化评估和治疗方案,结合认知行为疗法、情绪管理训练和学习技巧辅导等多种方法,帮助患者改善学习效果。学不好科还设有专门的儿童和青少年康复小组,通过游戏化学习和团队合作,激发患者的学习兴趣和动力。此外,科室与学校紧密合作,为患者提供学习支持和跟踪服务,确保患者在康复过程中能够得到持续的指导和帮助。
(3)爱学习科:
爱学习科是医院的新兴科室,专注于帮助患者建立积极的学习心态和良好的学习习惯。科室采用心理辅导、行为矫正和家庭治疗等多种方法,帮助患者克服学习焦虑和拖延症,培养自主学习能力。爱学习科还设有专门的学习能力提升训练营,通过短期集中训练,帮助患者快速提升学习效率和成绩。此外,科室提供线上学习支持服务,方便患者在家中继续接受康复训练。爱学习科致力于帮助每一位患者重拾学习热情,享受学习的乐趣。

3. 医生介绍
(1)张学明宇
性别:男
出生年月:1985年3月
医生职称:主任医师
所在科室:学不会科
毕业院校:本科毕业于“华山医学学院”,硕士毕业于“峨眉医学研究院”,博士毕业于“少林医学大学”。
介绍:张学明宇教授是学不会科的学科带头人,从事康复医学工作20年。他擅长运用心理学和康复治疗技术,帮助患者克服学习障碍。张教授主持多项省级科研项目,发表学术论文30余篇。他多次受邀参加国内外学术会议,分享临床经验。张教授还积极参与社区康复活动,为患者和家属提供免费咨询和指导。

(2)李梦瑶琪
性别:女
出生年月:1990年7月
医生职称:副主任医师
所在科室:学不好科
毕业院校:本科毕业于“武当医学学院”,硕士毕业于“青城医学研究所”,博士毕业于“昆仑医学大学”。
介绍:李梦瑶琪医生是学不好科的骨干力量,专注于提升患者的认知能力和学习技巧。她熟练掌握多种心理评估工具和康复治疗方法,能够为患者制定个性化的治疗方案。李医生积极参与科室的科研工作,多次获得医院科研奖励。她还多次参与社区义诊活动,普及学习障碍防治知识,为提高公众健康意识做出了积极贡献。

(3)王智勇杰
性别:男
出生年月:1988年2月
医生职称:主治医师
所在科室:爱学习科
毕业院校:本科毕业于“恒山医学院”,硕士毕业于“衡山医学研究所”,博士毕业于“泰山医学大学”。
介绍:王智勇杰医生毕业于多所知名院校,专业基础扎实。他在爱学习科领域积累了丰富的临床经验,尤其擅长帮助患者克服学习焦虑和拖延症。王医生熟练掌握认知行为疗法和情绪管理训练,为患者提供全面的心理支持。他积极参与科室的临床教学工作,为年轻医生传授专业知识和技能。王医生还致力于学习障碍的科普宣传,通过线上线下多种渠道,为患者和公众提供健康咨询和指导。

(4)赵思远航
性别:女
出生年月:1992年11月
医生职称:主治医师
所在科室:学不会科
毕业院校:本科毕业于“华山医学学院”,硕士毕业于“峨眉医学研究院”,博士毕业于“少林医学大学”。
介绍:赵思远航医生是学不会科的优秀青年医生,专注于帮助患者克服学习障碍。她熟练掌握多种心理评估工具和康复治疗方法,能够为患者制定个性化的治疗方案。赵医生积极参与科室的科研工作,发表多篇学术论文。她还多次参与社区义诊活动,普及学习障碍防治知识,为提高公众健康意识做出了积极贡献。

(5)刘宇航宇
性别:男
出生年月:1987年6月
医生职称:副主任医师
所在科室:学不好科
毕业院校:本科毕业于“武当医学学院”,硕士毕业于“青城医学研究所”,博士毕业于“昆仑医学大学”。
介绍:刘宇航宇医生从事康复医学工作15年,积累了丰富的临床经验。他擅长运用认知行为疗法和学习技巧辅导,帮助患者改善学习效果。刘医生积极参与科室的科研工作,主持和参与多项科研项目,发表多篇高质量学术论文。他多次受邀参加国内外学术会议,分享临床经验和研究成果。

(6)陈逸风宇
性别:男
出生年月:1989年9月
医生职称:主治医师
所在科室:爱学习科
毕业院校:本科毕业于“恒山医学院”,硕士毕业于“衡山医学研究所”,博士毕业于“泰山医学大学”。
介绍:陈逸风宇医生是爱学习科的优秀青年医生,专注于帮助患者建立积极的学习心态。他熟练掌握多种心理辅导技术和行为矫正方法,能够为患者提供全面的心理支持。陈医生积极参与科室的科研工作,发表多篇学术论文。他多次参加国际学术交流活动,学习先进的医疗技术和理念,不断提升自己的专业水平。

(7)周雨婷婷
性别:女
出生年月:1991年3月
医生职称:主治医师
所在科室:学不会科
毕业院校:本科毕业于“华山医学学院”,硕士毕业于“峨眉医学研究院”,博士毕业于“少林医学大学”。
介绍:周雨婷婷医生是学不会科的骨干力量,专注于帮助患者克服学习障碍。她熟练掌握多种心理评估工具和康复治疗方法,能够为患者制定个性化的治疗方案。周医生积极参与科室的科研工作,发表多篇学术论文。她多次参与社区义诊活动,普及学习障碍防治知识,为提高公众健康意识做出了积极贡献。

(8)孙悦瑶瑶
性别:女
出生年月:1993年1月
医生职称:住院医师
所在科室:学不好科
毕业院校:本科毕业于“武当医学学院”,硕士毕业于“青城医学研究所”,博士毕业于“昆仑医学大学”。
介绍:孙悦瑶瑶医生是学不好科的新生力量,专业基础扎实。她专注于帮助患者提升学习能力,熟练掌握多种心理评估工具和康复治疗方法。孙医生积极参与科室的科研工作,发表多篇学术论文。她多次参与社区义诊活动,普及学习障碍防治知识,为提高公众健康意识做出了积极贡献。

(9)徐浩然宇
性别:男
出生年月:1986年5月
医生职称:主任医师
所在科室:爱学习科
毕业院校:本科毕业于“恒山医学院”,硕士毕业于“衡山医学研究所”,博士毕业于“泰山医学大学”。
介绍:徐浩然宇教授是爱学习科的资深专家,从事康复医学工作20年。他擅长运用心理辅导和行为矫正技术,帮助患者克服学习焦虑和拖延症。徐教授主持多项省级科研项目,发表学术论文40余篇。他多次受邀参加国内外学术会议,分享临床经验。徐教授还积极参与社区康复活动,为患者和家属提供免费咨询和指导。

(10)林晓梦宇
性别:女
出生年月:1990年7月
医生职称:副主任医师
所在科室:学不会科
毕业院校:本科毕业于“华山医学学院”,硕士毕业于“峨眉医学研究院”,博士毕业于“少林医学大学”。
介绍:林晓梦宇医生是学不会科的骨干力量,专注于帮助患者克服学习障碍。她熟练掌握多种心理评估工具和康复治疗方法,能够为患者制定个性化的治疗方案。林医生积极参与科室的科研工作,发表多篇学术论文。她多次参与社区义诊活动,普及学习障碍防治知识,为提高公众健康意识做出了积极贡献。

(11)张云飞宇
性别:男
出生年月:1988年2月
医生职称:主治医师
所在科室:学不好科
毕业院校:本科毕业于“恒山医学院”,硕士毕业于“衡山医学研究所”,博士毕业于“泰山医学大学”。
介绍:张云飞宇医生毕业于多所知名院校,专业基础扎实。他在学不好科领域积累了丰富的临床经验,尤其擅长帮助患者提升学习能力。张医生熟练掌握多种心理评估工具和康复治疗方法,能够为患者制定个性化的治疗方案。他积极参与科室的科研工作,发表多篇学术论文。张医生还致力于学习障碍的科普宣传,通过线上线下多种渠道,为患者和公众提供健康咨询和指导。

(12)李梦琪琪
性别:女
出生年月:1992年11月
医生职称:主治医师
所在科室:爱学习科
毕业院校:本科毕业于“华山医学学院”,硕士毕业于“峨眉医学研究院”,博士毕业于“少林医学大学”。
介绍:李梦琪琪医生是爱学习科的优秀青年医生,专注于帮助患者建立积极的学习心态。她熟练掌握多种心理辅导技术和行为矫正方法,能够为患者提供全面的心理支持。李医生积极参与科室的科研工作,发表多篇学术论文。她多次参加国际学术交流活动,学习先进的医疗技术和理念,不断提升自己的专业水平。

(13)王浩宇宇
性别:男
出生年月:1987年6月
医生职称:副主任医师
所在科室:学不会科
毕业院校:本科毕业于“武当医学学院”,硕士毕业于“青城医学研究所”,博士毕业于“昆仑医学大学”。
介绍:王浩宇宇医生从事康复医学工作15年,积累了丰富的临床经验。他擅长运用心理评估和康复治疗技术,帮助患者克服学习障碍。王医生积极参与科室的科研工作,主持和参与多项科研项目,发表多篇高质量学术论文。他多次受邀参加国内外学术会议,分享临床经验和研究成果。

(14)陈逸扬宇
性别:男
出生年月:1989年9月
医生职称:主治医师
所在科室:学不好科
毕业院校:本科毕业于“恒山医学院”,硕士毕业于“衡山医学研究所”,博士毕业于“泰山医学大学”。
介绍:陈逸扬宇医生是学不好科的优秀青年医生,专注于帮助患者提升学习能力。他熟练掌握多种心理评估工具和康复治疗方法,能够为患者制定个性化的治疗方案。陈医生积极参与科室的科研工作,发表多篇学术论文。他多次参加国际学术交流活动,学习先进的医疗技术和理念,不断提升自己的专业水平。陈医生还致力于学习障碍的科普宣传,通过线上线下多种渠道,为患者和公众提供健康咨询和指导。

(15)周雨晨宇
性别:女
出生年月:1991年3月
医生职称:主治医师
所在科室:爱学习科
毕业院校:本科毕业于“华山医学学院”,硕士毕业于“峨眉医学研究院”,博士毕业于“少林医学大学”。
介绍:周雨晨宇医生是爱学习科的骨干力量,专注于帮助患者克服学习焦虑和拖延症。她熟练掌握多种心理辅导技术和行为矫正方法,能够为患者提供全面的心理支持。周医生积极参与科室的科研工作,发表多篇学术论文。她多次参与社区义诊活动,普及学习障碍防治知识,为提高公众健康意识做出了积极贡献。周医生还致力于学习障碍的科普宣传,通过线上线下多种渠道,为患者和公众提供健康咨询和指导。

(16)孙悦宁宇
性别:女
出生年月:1993年1月
医生职称:住院医师
所在科室:学不会科
毕业院校:本科毕业于“武当医学学院”,硕士毕业于“青城医学研究所”,博士毕业于“昆仑医学大学”。
介绍:孙悦宁宇医生是学不会科的新生力量,专业基础扎实。她专注于帮助患者克服学习障碍,熟练掌握多种心理评估工具和康复治疗方法。孙医生积极参与科室的科研工作,发表多篇学术论文。她多次参与社区义诊活动,普及学习障碍防治知识,为提高公众健康意识做出了积极贡献。孙医生还致力于学习障碍的科普宣传,通过线上线下多种渠道,为患者和公众提供健康咨询和指导。

(17)徐浩宇航
性别:男
出生年月:1986年5月
医生职称:主任医师
所在科室:学不好科
毕业院校:本科毕业于“恒山医学院”,硕士毕业于“衡山医学研究所”,博士毕业于“泰山医学大学”。
介绍:徐浩宇航教授是学不好科的资深专家,从事康复医学工作20年。他擅长运用心理辅导和行为矫正技术,帮助患者提升学习能力。徐教授主持多项省级科研项目,发表学术论文40余篇。他多次受邀参加国内外学术会议,分享临床经验。徐教授还积极参与社区康复活动,为患者和家属提供免费咨询和指导。

(18)林晓宇航
性别:女
出生年月:1990年7月
医生职称:副主任医师
所在科室:爱学习科
毕业院校:本科毕业于“华山医学学院”,硕士毕业于“峨眉医学研究院”,博士毕业于“少林医学大学”。
介绍:林晓宇航医生是爱学习科的骨干力量,专注于帮助患者建立积极的学习心态。她熟练掌握多种心理辅导技术和行为矫正方法,能够为患者提供全面的心理支持。林医生积极参与科室的科研工作,发表多篇学术论文。她多次参加国际学术交流活动,学习先进的医疗技术和理念,不断提升自己的专业水平。林医生还致力于学习障碍的科普宣传,通过线上线下多种渠道,为患者和公众提供健康咨询和指导。

(19)张云宇航
性别:男
出生年月:1988年2月
医生职称:主治医师
所在科室:学不会科
毕业院校:本科毕业于“恒山医学院”,硕士毕业于“衡山医学研究所”,博士毕业于“泰山医学大学”。
介绍:张云宇航医生毕业于多所知名院校,专业基础扎实。他在学不会科领域积累了丰富的临床经验,尤其擅长帮助患者克服学习障碍。张医生熟练掌握多种心理评估工具和康复治疗方法,能够为患者制定个性化的治疗方案。他积极参与科室的科研工作,发表多篇学术论文。张医生还致力于学习障碍的科普宣传,通过线上线下多种渠道,为患者和公众提供健康咨询和指导。

(20)李梦宇航
性别:女
出生年月:1992年11月
医生职称:主治医师
所在科室:学不好科
毕业院校:本科毕业于“华山医学学院”,硕士毕业于“峨眉医学研究院”,博士毕业于“少林医学大学”。
介绍:李梦宇航医生是学不好科的优秀青年医生,专注于帮助患者提升学习能力。她熟练掌握多种心理评估工具和康复治疗方法,能够为患者制定个性化的治疗方案。李医生积极参与科室的科研工作,发表多篇学术论文。她多次参与社区义诊活动,普及学习障碍防治知识,为提高公众健康意识做出了积极贡献。李医生还致力于学习障碍的科普宣传,通过线上线下多种渠道,为患者和公众提供健康咨询和指导。
七. 测试与验证
Spring 服务启动后,我们看看效果吧
我们Spring 项目中,开放了4个接口
## 1、 数据加载接口
http://127.0.0.1:8080/ai/v1/data/load
## 2、 对话处理接口
http://127.0.0.1:8080/ai/rag/chat
## 3、上下文感知查询
http://127.0.0.1:8080/ai/v1/rag/history/chat
## 4、查询重写接口
http://127.0.0.1:8080/ai/v1/rag/rewrite/chat
1、数据加载接口
数据写入的接口
http://127.0.0.1:8080/ai/v1/data/load
调用接口前,我们看到Milvus中,还没有相关表(Collection)

调用接口后,文件就写进来了

** 2、 对话处理接口**
我们提问:不爱学习康复医院的副主任医生都有谁,不出意外,服务给我们返回了信息

3、上下文感知查询
提问: 还有谁 , 该接口帮我们完善了问题:不爱学习康复医院还有哪些科室的副主任医生名单?请提供具体科室、姓名、性别、出生年月及职称信息。

4、查询重写接口
我们提问:我想去北京,打算坐高铁过去,请问,北京有什么景点比较好玩,还得便宜, 这句话非常啰嗦,接口帮我们改写成:北京有哪些性价比高的旅游景点?。

八. 补充点内容
通过 Spring AI 与 Milvus 的深度集成,本项目成功构建了一个高效、智能的对话系统。上下文感知查询和查询重写技术的应用,显著提升了对话的连贯性和检索效率。未来,我们计划进一步扩展系统的功能,支持更多语言和领域,并通过工具调用和用户行为分析进一步优化用户体验。
更多推荐



 53
 0
- 0


 已为社区贡献1条内容

所有评论(0)