
【SAHI效果提升】训练SAHI 小目标识别 效果提升技巧
·
背景
sahi是比较简单易行的小目标检测工具,yolo等工具都有了支持,官网上给出了非常明显的效果示意图(https://github.com/obss/sahi),自己实际测验效果也非常明显。
例如这是一张田野里的电线杆,不仔细看,你很难发现绝缘子上的一些破损。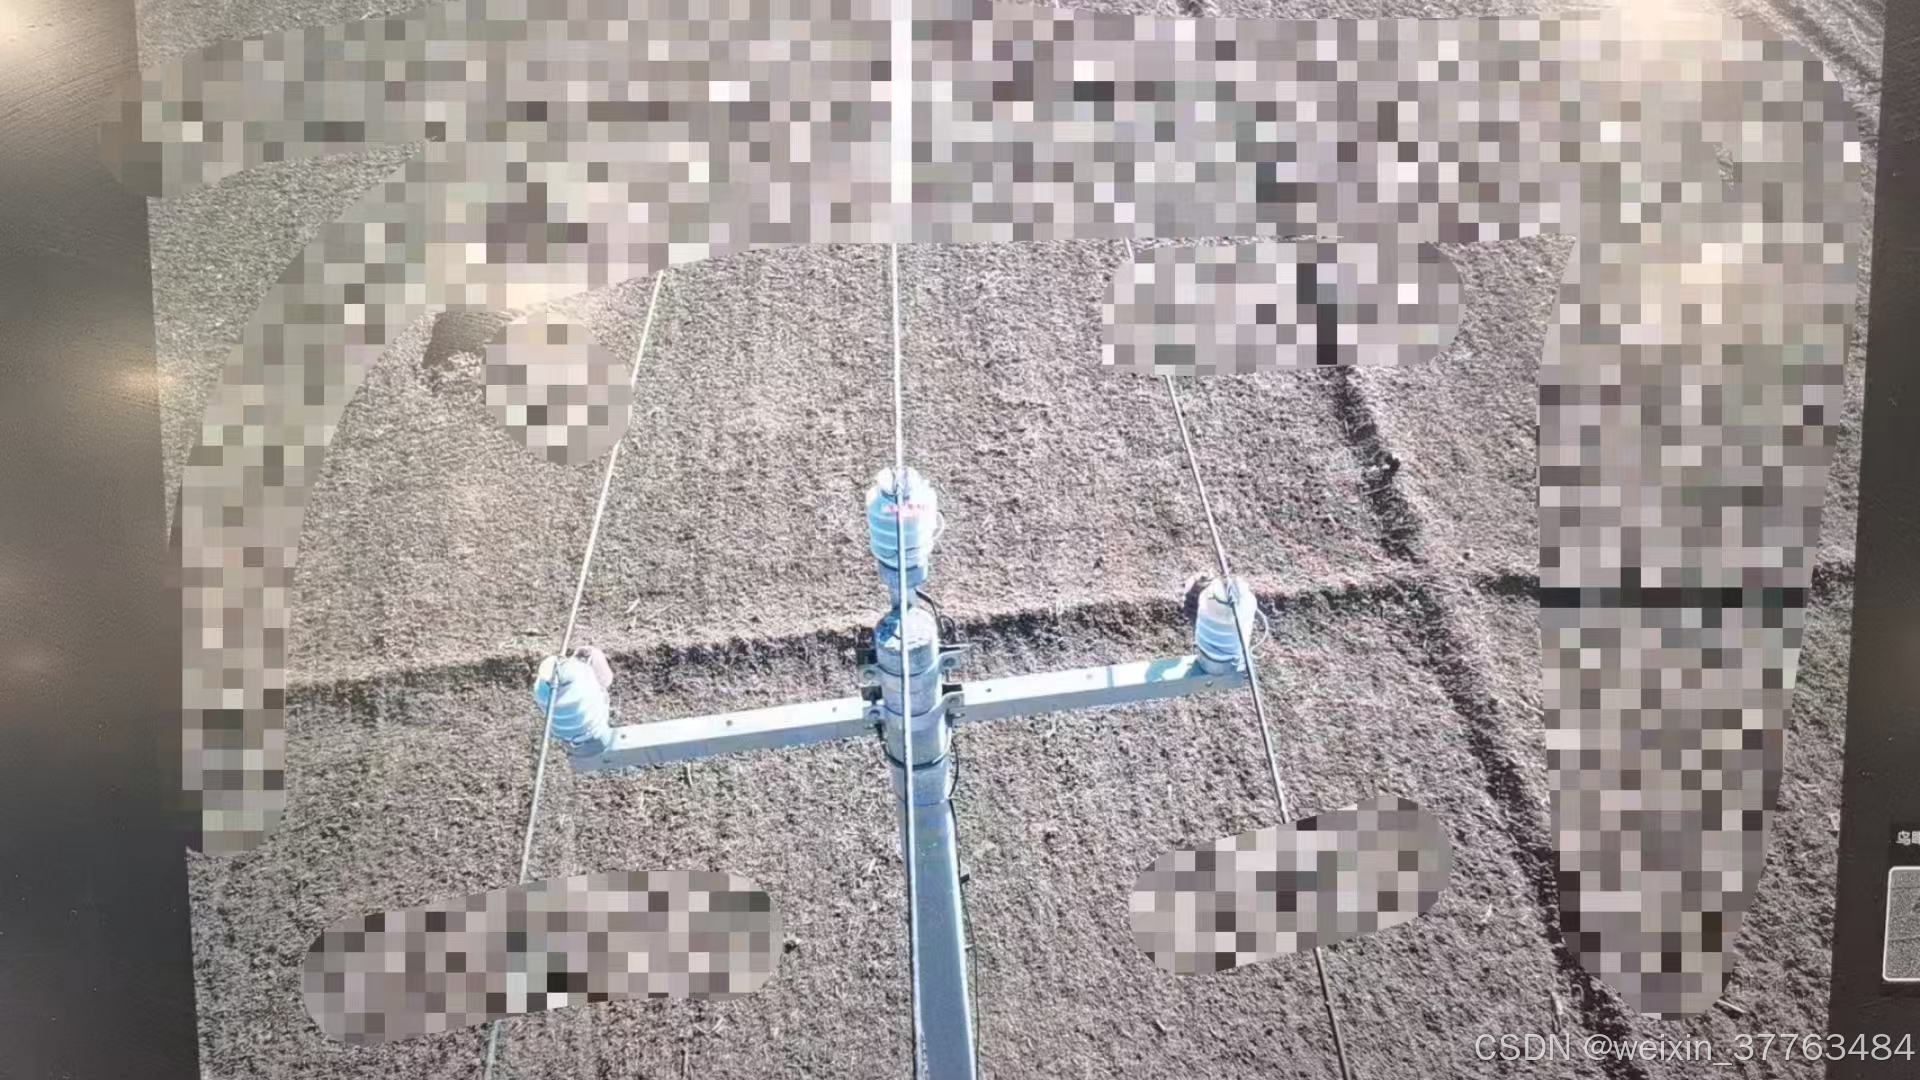
当采用sahi进行识别,可以精准的识别两个小缺口,这些缺口可能导致线路故障。(注意,这里对模型进行了特殊的训练,训练过程会在后面介绍)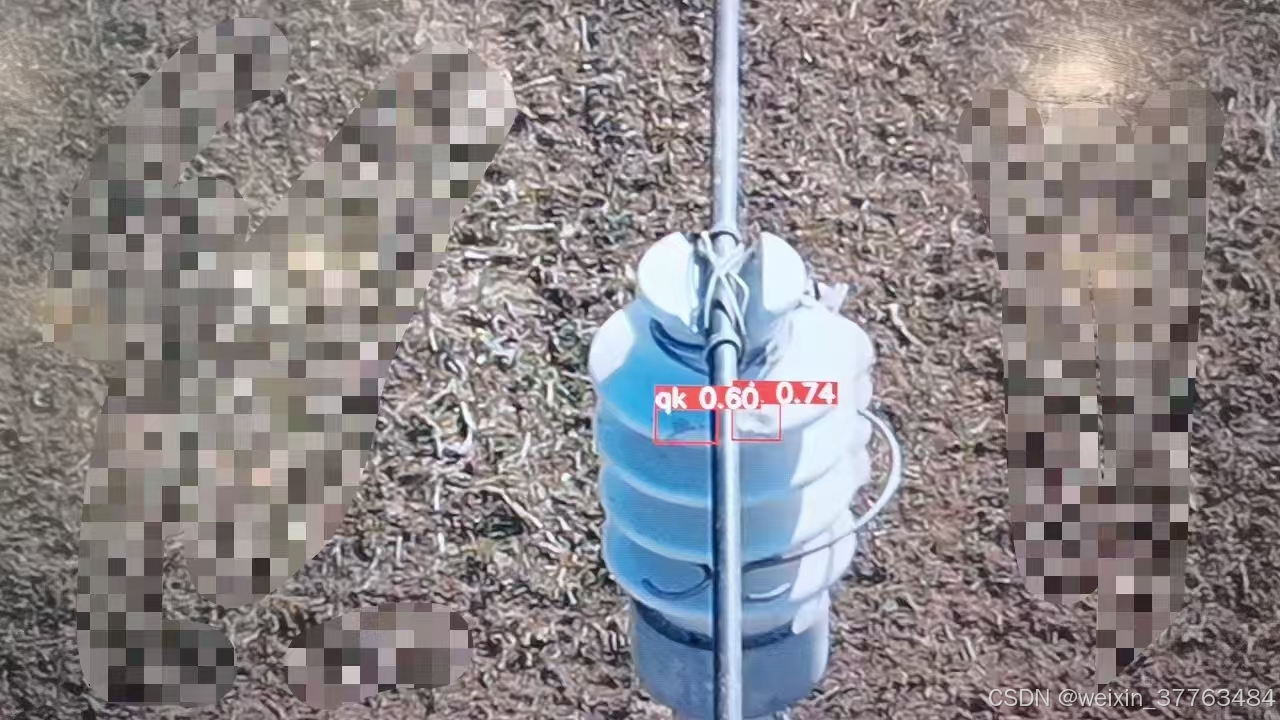
训练
sahi的论文里面提及了模型训练。个人认为,在对较大目标(例如上图中的绝缘子整体)进行sahi识别时,可以直接跑正常的yolo流程,但是对于小目标(例如绝缘子上的缺口),可能就需要额外的训练技巧了。
由于sahi是在640等尺寸上进行识别,因此我想到了在640的尺寸上进行单独的模型训练,这样能保证特征被充分学习(你也可以尝试放大图片,参考这个文章On the Importance of Large Objects in CNN Based Object Detection Algorithms)。
整体效果如下:
原始图像中有三个小汽车(假设小汽车是小目标)
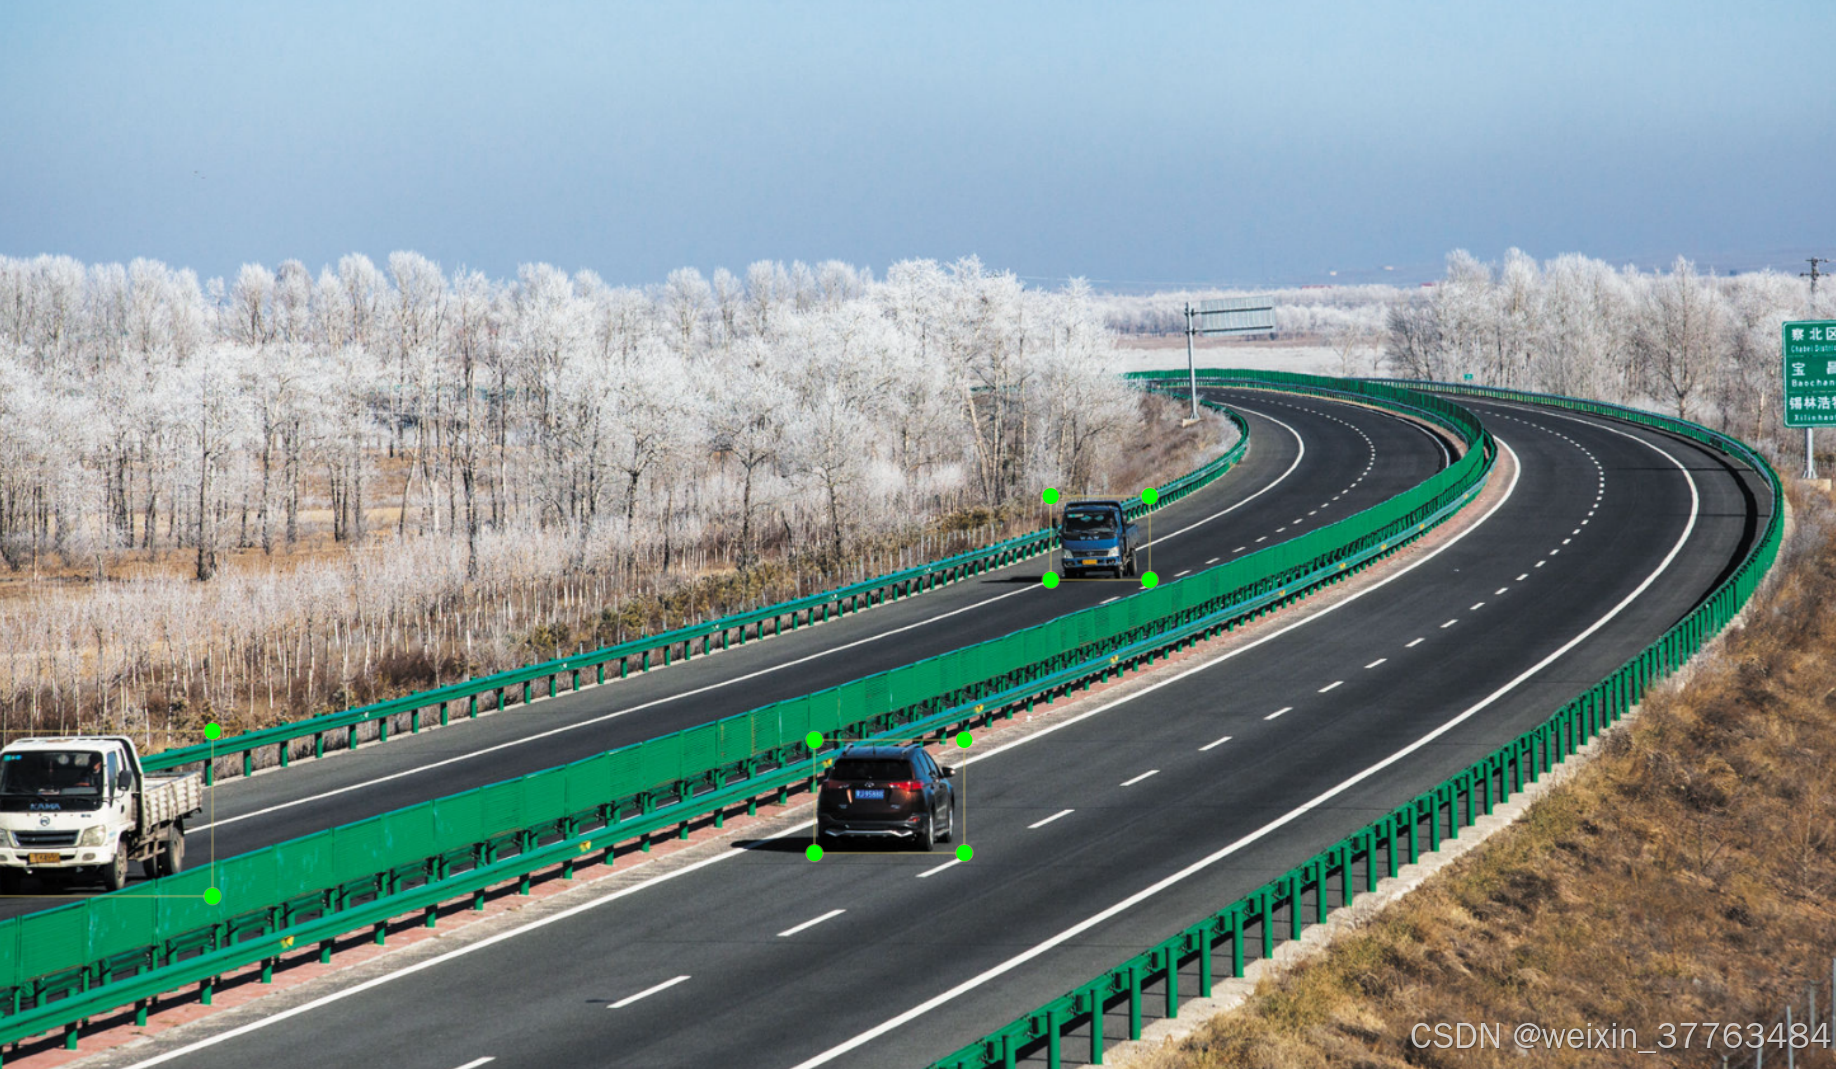
处理结束后,整张图片被分成了两张子图片,可以利用yolo进行训练了。个人感觉这样训练效果更好。

代码
下面是我数据处理的代码,使用的时候请把640换成你需要的尺寸:
import os
import cv2
import xml.etree.ElementTree as ET

def read_xml(xml_path):
    tree = ET.parse(xml_path)
    root = tree.getroot()
    annotations = []
    for obj in root.findall('object'):
        name = obj.find('name').text
        bndbox = obj.find('bndbox')
        xmin = int(bndbox.find('xmin').text)
        ymin = int(bndbox.find('ymin').text)
        xmax = int(bndbox.find('xmax').text)
        ymax = int(bndbox.find('ymax').text)
        annotations.append({'name': name, 'bbox': (xmin, ymin, xmax, ymax)})
    return root, annotations

def process_images(image_folder, xml_folder, output_folder, target_label="qk", split_size=640):
    try:
        if not os.path.exists(output_folder):
            os.makedirs(output_folder)

        for filename in os.listdir(image_folder):
            print(filename)
            if filename.endswith(('.jpg', '.png')):
                image_path = os.path.join(image_folder, filename)
                xml_path = os.path.join(xml_folder, filename.replace('.jpg', '.xml').replace('.png', '.xml'))

                # 读取图像和XML标注
                img = cv2.imread(image_path)
                root, annotations = read_xml(xml_path)

                # 找出所有目标标签的位置
                target_labels = [ann for ann in annotations if target_label in ann['name']]
                if not target_labels:
                    continue

                # 每张图片维护一个processed_areas字典
                processed_areas=[]

                # 遍历所有目标标签进行切分处理
                for i, label in enumerate(target_labels):
                    xmin, ymin, xmax, ymax = label['bbox']

                    # 检查是否该标签已经被其他标签切分框覆盖
                    skip_label = False

                    for processed_area in processed_areas:
                        # 获取已处理标签的位置
                        proc_xmin, proc_xmax, proc_ymin, proc_ymax = processed_area

                        # 检查当前标签与已处理标签是否重叠
                        if (xmin > proc_xmin and xmax < proc_xmax and ymin > proc_ymin and ymax < proc_ymax):
                            skip_label = True
                            break

                    if skip_label:
                        continue  # 跳过这个标签

                    # 计算切分区域,确保640x640区域包含标签
                    x_center, y_center = (xmin + xmax) // 2, (ymin + ymax) // 2
                    split_x_min = max(0, x_center - split_size // 2)
                    split_y_min = max(0, y_center - split_size // 2)
                    split_x_max = min(img.shape[1], split_x_min + split_size)
                    split_y_max = min(img.shape[0], split_y_min + split_size)

                    # 获取切割后的图像
                    cropped_img = img[split_y_min:split_y_max, split_x_min:split_x_max]
                    processed_areas.append([split_x_min,split_x_max, split_y_min,split_y_max])

                    # 重新计算标签位置
                    new_annotations = []
                    for ann in annotations:
                        if target_label in ann['name'] or 1:
                            old_xmin, old_ymin, old_xmax, old_ymax = ann['bbox']
                            if split_x_min <= old_xmin < split_x_max and split_y_min <= old_ymin < split_y_max:
                                # 标签位于切割区域内,计算新的坐标
                                new_xmin = old_xmin - split_x_min
                                new_ymin = old_ymin - split_y_min
                                new_xmax = old_xmax - split_x_min
                                new_ymax = old_ymax - split_y_min
                                new_annotations.append({'name': ann['name'], 'bbox': (new_xmin, new_ymin, new_xmax, new_ymax)})

                    # 为新文件生成符合规范的文件名
                    base_name = os.path.splitext(filename)[0]  # 获取原始文件名(不包含扩展名)
                    new_image_name = f"{base_name}_split_{i+1}.jpg"
                    new_xml_name = f"{base_name}_split_{i+1}.xml"

                    # 保存切割图像
                    output_image_path = os.path.join(output_folder, new_image_name)
                    cv2.imwrite(output_image_path, cropped_img)

                    # 复制原始XML并修改object节点
                    new_root = ET.Element("annotation")
                    for elem in root:
                        if elem.tag != "object":
                            new_root.append(elem)  # 保留原XML中非object的其他元素

                    # 只修改object节点
                    for new_ann in new_annotations:
                        object_elem = ET.SubElement(new_root, 'object')
                        name_elem = ET.SubElement(object_elem, 'name')
                        name_elem.text = new_ann['name']
                        bndbox_elem = ET.SubElement(object_elem, 'bndbox')
                        ET.SubElement(bndbox_elem, 'xmin').text = str(new_ann['bbox'][0])
                        ET.SubElement(bndbox_elem, 'ymin').text = str(new_ann['bbox'][1])
                        ET.SubElement(bndbox_elem, 'xmax').text = str(new_ann['bbox'][2])
                        ET.SubElement(bndbox_elem, 'ymax').text = str(new_ann['bbox'][3])

                    tree = ET.ElementTree(new_root)
                    output_xml_path = os.path.join(output_folder, new_xml_name)
                    tree.write(output_xml_path)
                    print("saved ", output_image_path, "and", output_xml_path)

    except Exception as e:
        print(e)

# 调用函数
image_folder = r'C:\Users\28715\Pictures\test'  # 请替换为你实际的图像文件夹路径
xml_folder = image_folder               # XML文件夹与图像文件夹相同
output_folder = r'C:\Users\28715\Pictures\testaaa'  # 请替换为你保存结果的文件夹路径
process_images(image_folder, xml_folder, output_folder, "car", 640)
更多推荐



 7
 0
- 0


 已为社区贡献3条内容

所有评论(0)