
segmentation_models.pytorch使用指南
segmentation_models.pytorch 使用实战指南
在图像分割任务日益普及的今天,无论是医疗影像分析、自动驾驶感知,还是遥感图像解译,开发者都希望快速搭建一个高效且可复现的训练流程。而 segmentation_models.pytorch(简称 SMP)正是这样一个能极大提升开发效率的工具——它封装了主流的编码器-解码器结构,让你无需重复造轮子。
更幸运的是,借助像 PyTorch-CUDA-v2.7 这样的预配置镜像,我们几乎可以跳过繁琐的环境配置,直接进入模型设计和实验阶段。本文将带你从零开始,完整走通一条基于 SMP 的语义分割开发路径,涵盖环境使用、模型构建、数据处理到训练闭环的全过程。
开箱即用:PyTorch-CUDA 镜像带来的效率革命
传统深度学习项目的第一道坎往往是环境搭建:CUDA 版本是否匹配?cuDNN 是否安装正确?PyTorch 与 torchvision 能否兼容?这些问题常常耗费新手数小时甚至数天时间。
而 PyTorch-CUDA-v2.7 镜像彻底解决了这一痛点。它基于 PyTorch 官方 v2.7 构建,内置完整的 GPU 支持栈,开箱即用支持多卡训练(DDP / DataParallel),并集成了 Jupyter Lab 和 SSH 访问能力,真正实现了“拉起即写”。
更重要的是,这个镜像已经为你准备好了高性能计算所需的一切底层依赖,包括:
- CUDA 工具链(适配主流 NVIDIA 显卡)
- cuDNN 加速库
- TorchScript 与 ONNX 导出支持
- 常用视觉库如 OpenCV、albumentations 等
这意味着你可以把精力集中在模型结构设计和业务逻辑优化上,而不是被环境问题拖慢节奏。
如何使用 Jupyter 进行交互式开发?
容器启动后,浏览器访问内置的 Jupyter Lab 是最直观的入门方式。
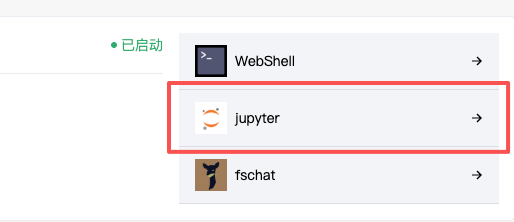
登录成功后,你会看到熟悉的文件浏览器界面。在这里可以创建 .ipynb 文件,进行探索性编程:加载样本图像、可视化标注掩码、调试模型前向传播等操作都非常方便。
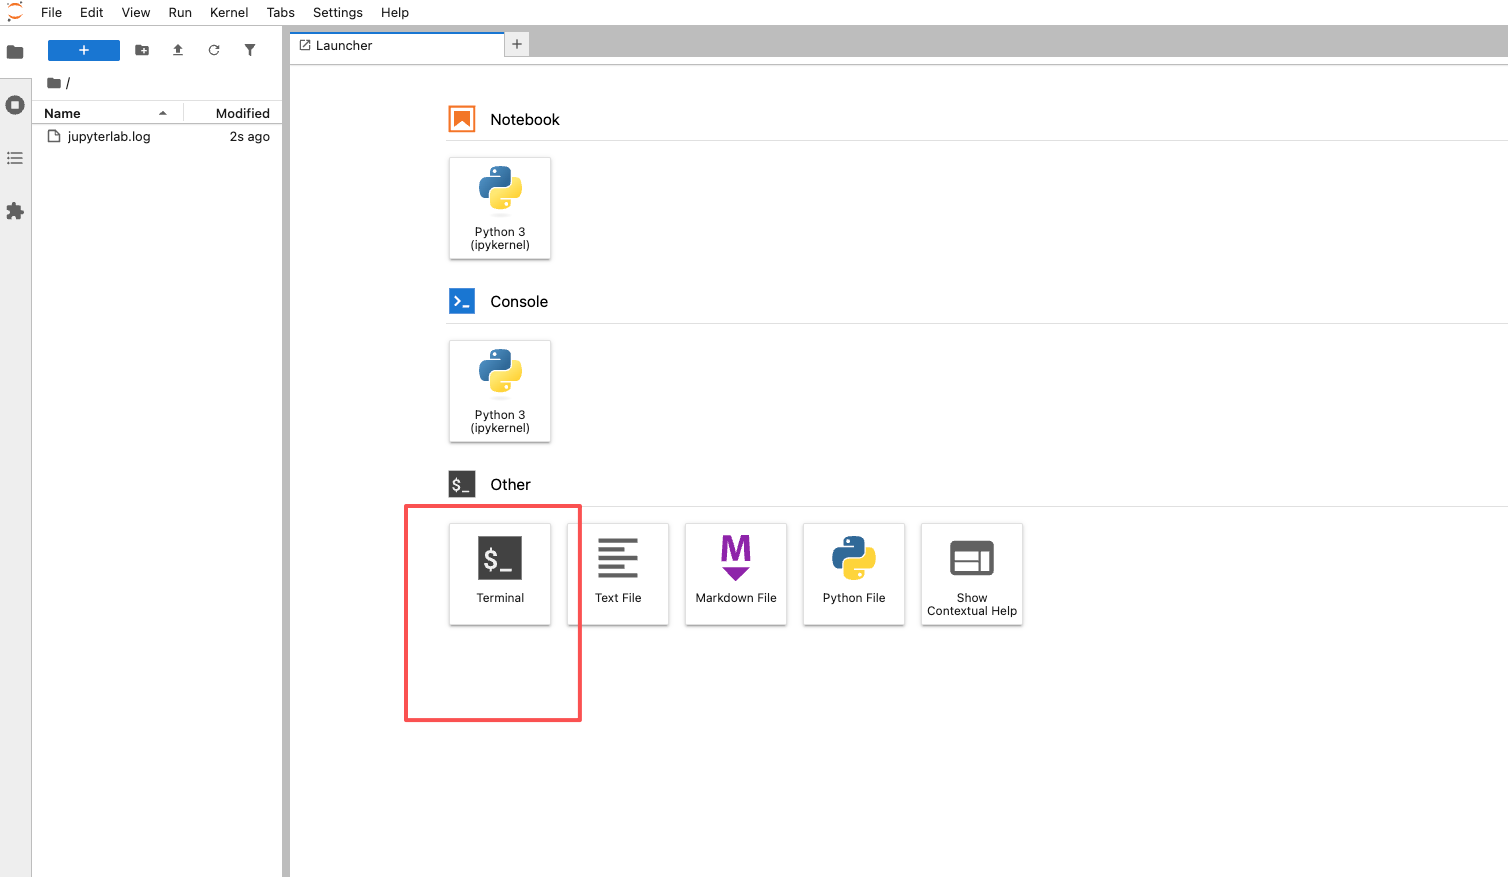
💡 实践建议:强烈推荐通过 Docker volume 将本地项目目录挂载进容器,例如:
bash
docker run -p 8888:8888 -v ./my_project:/workspace my_pytorch_image
这样既能利用容器内的强大运行时,又能保证代码和数据持久化保存。
更灵活的选择:SSH 命令行开发
对于需要长期运行训练任务或批量处理脚本的场景,SSH 登录是更合适的方式。
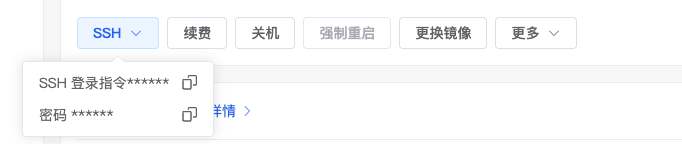
只需一条标准命令即可连接:
ssh -p <port> user@<host>
进入终端后,你就可以使用 vim 编辑代码、用 tmux 或 screen 挂起训练进程,甚至结合 nohup 实现后台运行:
nohup python train.py > logs/train.log &
这种方式更适合自动化流水线部署,也便于远程监控资源占用情况(nvidia-smi, htop 等)。
安装 segmentation_models.pytorch
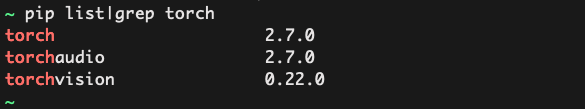
虽然基础镜像功能强大,但 segmentation_models.pytorch 并未默认包含其中,需手动安装:
pip install segmentation-models-pytorch -i https://pypi.tuna.tsinghua.edu.cn/simple
推荐使用清华源加速下载,尤其在国内网络环境下可显著减少超时风险。
安装完成后,务必验证是否导入成功:
import segmentation_models_pytorch as smp
print(smp.__version__)  # 输出类似 '0.3.3'
如果出现版本号,则说明安装无误。若报错,请检查 Python 环境是否冲突,或尝试升级 pip 后重装。
快速构建分割模型:SMP 的核心优势
SMP 最大的价值在于其高度模块化的设计。它统一抽象了“编码器 + 解码器”的通用范式,支持多种 backbone 和架构组合,几行代码就能实例化一个强大的分割网络。
以经典的 U-Net 为例:
import segmentation_models_pytorch as smp

model = smp.Unet(
    encoder_name="resnet34",        # 主干特征提取网络
    encoder_weights="imagenet",     # 使用 ImageNet 预训练权重初始化
    in_channels=3,                  # 输入通道数(RGB 图像为 3)
    classes=1,                      # 输出类别数(二分类设为 1)
    activation=None                 # 训练时不加激活函数
)
短短几行就完成了一个具备迁移学习能力的全卷积网络构建。其中 encoder_weights="imagenet" 是关键——它意味着模型会加载在大规模自然图像上预训练好的权重作为起点,这不仅能加快收敛速度,还能有效防止过拟合,特别适合小样本任务。
可选 backbone 一览:按需选择,平衡性能与速度
SMP 支持数十种主流骨干网络作为编码器,覆盖从轻量级到高性能的完整谱系。你可以通过以下代码查看所有可用选项:
from segmentation_models_pytorch.encoders import get_encoder_names

encoders = get_encoder_names()
print(encoders)
常见选择包括:
| 类型 | 示例 |
|---|---|
| ResNet 系列 | resnet18, resnet34, resnet50 |
| EfficientNet 系列 | efficientnet-b0 ~ b7 |
| MobileNetV2 | mobilenet_v2 |
| DenseNet 系列 | densenet121, densenet169 |
| SENet / ResNeXt | senet154, resnext50_32x4d |
工程建议:
- 医疗图像等精细分割任务推荐 resnet34 或 efficientnet-b4,兼顾精度与感受野。
- 边缘设备部署优先考虑 mobilenet_v2 或 resnet18,参数量小、推理快。
- 多类分割时注意设置 classes=N,并配合 'multiclass' 模式的损失函数。
输入预处理:别让归一化毁了你的训练
很多人忽略了这一点:预训练模型对输入分布极其敏感。如果你用了 imagenet 初始化,就必须使用 ImageNet 的均值和标准差进行归一化,否则特征提取器可能无法正常工作。
SMP 提供了便捷的预处理函数,自动匹配不同 backbone 的统计参数:
from segmentation_models_pytorch.encoders import get_preprocessing_fn

preprocess_input = get_preprocessing_fn('resnet34', pretrained='imagenet')

# 示例处理流程
image = cv2.imread("sample.jpg")                    # HWC, BGR
image = cv2.cvtColor(image, cv2.COLOR_BGR2RGB)      # 转为 RGB
image = preprocess_input(image)                     # 归一化至 [0,1] 并减去均值除以标准差
image = image.transpose(2, 0, 1)                    # HWC → CHW
image = torch.tensor(image).unsqueeze(0)          # CHW → BCHW (batch 维度)
⚠️ 重要提醒:不同 backbone 对应不同的
(mean, std)!例如resnet34使用的是[0.485,0.456,0.406], [0.229,0.224,0.225],而efficientnet-b0则略有差异。混用会导致性能下降甚至训练失败。
损失函数与评估指标:如何科学衡量分割效果?
图像分割任务中,简单的交叉熵往往不够用,尤其是面对前景稀疏、背景主导的情况(如肺部CT中的病灶)。这时候就需要更鲁棒的损失设计。
SMP 内置了多个专为分割优化的损失函数,推荐采用“组合拳”策略:
import segmentation_models_pytorch as smp

# Dice Loss:应对类别不平衡,关注正样本重叠率
dice_loss = smp.losses.DiceLoss(mode='binary')

# BCE With Logits:带 sigmoid 的二元交叉熵,稳定训练
bce_loss = smp.losses.SoftBCEWithLogitsLoss()

# 联合损失
def criterion(y_pred, y_true):
    return 0.5 * dice_loss(y_pred, y_true) + 0.5 * bce_loss(y_pred, y_true)
这种加权组合既保留了 BCE 的梯度稳定性,又引入了 Dice 对空间重叠的关注,在实践中表现优异。
常用评估指标解析
训练过程中,除了看 loss 曲线,更要关注实际分割质量。SMP 提供了一套完整的评估接口:
output = torch.randn(4, 1, 256, 256).sigmoid() > 0.5
target = torch.randint(0, 2, (4, 1, 256, 256)).float()

tp, fp, fn, tn = smp.metrics.get_stats(output, target, mode='binary')

iou_score = smp.metrics.iou_score(tp, fp, fn, tn, reduction='micro')
f1_score = smp.metrics.f1_score(tp, fp, fn, tn, reduction='micro')
accuracy = smp.metrics.accuracy(tp, fp, fn, tn, reduction='macro')

print(f"IOU: {iou_score:.4f}, F1: {f1_score:.4f}, Acc: {accuracy:.4f}")
| 指标 | 适用场景 | 说明 |
|---|---|---|
| IOU (Jaccard) | 通用,强调区域重叠 | 预测与真实区域交集 / 并集 |
| Dice Score | 医学图像常用 | $ \frac{2TP}{2TP+FP+FN} $,对正样本更敏感 |
| Precision / Recall | 关注误检与漏检 | 查准率 vs 查全率权衡 |
| Accuracy | 整体像素准确率 | 在类别极度不均衡时意义有限 |
通常我们会将 IOU 和 Dice 作为主要评价标准,尤其是在挑战赛或论文提交中。
完整训练流程:从数据到模型保存
下面是一个端到端的训练 pipeline 示例,整合了上述所有组件。
数据集定义与增强
使用 albumentations 实现高效的在线数据增强:
import albumentations as A
from albumentations.pytorch import ToTensorV2
from torch.utils.data import Dataset, DataLoader
import cv2
import numpy as np

class SegmentationDataset(Dataset):
    def __init__(self, image_paths, mask_paths, transform=None):
        self.image_paths = image_paths
        self.mask_paths = mask_paths
        self.transform = transform

    def __len__(self):
        return len(self.image_paths)

    def __getitem__(self, idx):
        img = cv2.imread(self.image_paths[idx], cv2.IMREAD_COLOR)
        msk = cv2.imread(self.mask_paths[idx], cv2.IMREAD_GRAYSCALE)

        img = cv2.cvtColor(img, cv2.COLOR_BGR2RGB)
        msk = msk.astype('float32') / 255.

        if self.transform:
            augmented = self.transform(image=img, mask=msk)
            img = augmented['image']
            msk = augmented['mask']

        return img, msk.unsqueeze(0)  # 扩展 channel 维度

# 定义训练增强策略
train_transform = A.Compose([
    A.Resize(256, 256),
    A.HorizontalFlip(p=0.5),
    A.VerticalFlip(p=0.5),
    A.RandomBrightnessContrast(p=0.2),
    A.Normalize(mean=(0.485, 0.456, 0.406), std=(0.229, 0.224, 0.225)),
    ToTensorV2(),
])
模型、优化器与学习率调度
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

model = smp.Unet(
    encoder_name="resnet34",
    encoder_weights="imagenet",
    in_channels=3,
    classes=1,
    activation=None
).to(device)

optimizer = optim.Adam(model.parameters(), lr=1e-3, weight_decay=1e-4)
scheduler = lr_scheduler.ReduceLROnPlateau(optimizer, mode='min', factor=0.1, patience=5)
这里选用 Adam 优化器搭配 L2 正则化,并使用 ReduceLROnPlateau 根据验证 loss 自动调整学习率,是一种稳健的选择。
训练与验证逻辑
def train_one_epoch(model, dataloader, optimizer, device):
    model.train()
    running_loss = 0.0
    pbar = tqdm(dataloader, desc="Train", leave=False)

    for images, masks in pbar:
        images = images.to(device, dtype=torch.float32)
        masks = masks.to(device, dtype=torch.float32)

        optimizer.zero_grad()
        outputs = model(images)
        loss = criterion(outputs, masks)
        loss.backward()
        optimizer.step()

        running_loss += loss.item() * images.size(0)
        pbar.set_postfix({"loss": f"{loss.item():.4f}"})

    epoch_loss = running_loss / len(dataloader.dataset)
    return epoch_loss

@torch.no_grad()
def valid_one_epoch(model, dataloader, device):
    model.eval()
    running_loss = 0.0
    scores = []

    for images, masks in tqdm(dataloader, desc="Valid", leave=False):
        images = images.to(device, dtype=torch.float32)
        masks = masks.to(device, dtype=torch.float32)

        outputs = model(images)
        loss = criterion(outputs, masks)
        running_loss += loss.item() * images.size(0)

        # 计算 Dice Score
        preds = (outputs.sigmoid() > 0.5).float()
        tp, fp, fn, tn = smp.metrics.get_stats(preds, masks, mode='binary')
        dice = smp.metrics.f1_score(tp, fp, fn, tn, reduction='micro').item()
        scores.append(dice)

    val_loss = running_loss / len(dataloader.dataset)
    avg_dice = np.mean(scores)
    return val_loss, avg_dice
主循环:记录历史、保存最优模型
num_epochs = 50
best_dice = 0.0
history = defaultdict(list)

for epoch in range(1, num_epochs + 1):
    print(f"\nEpoch {epoch}/{num_epochs}")

    train_loss = train_one_epoch(model, train_loader, optimizer, device)
    val_loss, val_dice = valid_one_epoch(model, valid_loader, device)

    history['Train Loss'].append(train_loss)
    history['Valid Loss'].append(val_loss)
    history['Valid Dice'].append(val_dice)

    print(f"Train Loss: {train_loss:.4f} | Val Loss: {val_loss:.4f} | Dice: {val_dice:.4f}")

    scheduler.step(val_loss)

    if val_dice > best_dice:
        best_dice = val_dice
        best_model_wts = copy.deepcopy(model.state_dict())
        torch.save(best_model_wts, "best_model.pth")
        print(f"✅ Best model saved with Dice Score: {best_dice:.4f}")

print(f"\n🎉 Training completed! Best Dice Score: {best_dice:.4f}")
整个流程清晰明了:每个 epoch 完成一次训练+验证,动态调整学习率,并只保留表现最好的模型权重。
写在最后:让工具真正服务于研发
segmentation_models.pytorch 的价值不仅在于节省代码量,更在于它提供了一套标准化、可复现、易扩展的开发范式。配合 PyTorch-CUDA 镜像的强大支持,开发者可以在几分钟内完成从环境搭建到模型训练的全流程。
但也要记住:再好的工具也只是手段。真正的核心竞争力仍然来自于对问题的理解、对数据的洞察以及对模型行为的细致调优。
未来你可以进一步拓展这个框架:
- 接入 TensorBoard 或 WandB 实时监控训练过程
- 使用 Test Time Augmentation(TTA)提升推理精度
- 导出 ONNX 模型用于生产部署
- 尝试 SMP 支持的其他架构如 DeepLabV3+, PAN, LinkNet 等
技术演进的本质,就是不断站在巨人的肩膀上,把更多时间留给创造性的工作。而这,或许才是现代深度学习工程化的真正意义所在。
更多推荐


 7
 0
- 0


 已为社区贡献14条内容

所有评论(0)