
TensorFlow Hub 0.7.0 安装包与实战应用详解

简介:TensorFlow Hub 是 Google 提供的一个开源平台,专注于分享和复用预训练的机器学习模型,加速AI项目的开发与研究。本文档围绕版本为 0.7.0 的安装包“tensorflow_hub-0.7.0-py2.py3-none-any.whl”展开,详细介绍了其安装方式、模型加载方法、迁移学习与微调技巧,以及在自然语言处理和计算机视觉中的实际应用场景。通过本资源,开发者可以快速掌握如何在项目中集成和使用TensorFlow Hub模型,提升开发效率。
1. TensorFlow Hub 简介与作用
TensorFlow Hub 是 TensorFlow 生态系统中的一个核心组件,专注于提供可复用的机器学习模块。它通过封装预训练模型,使开发者能够快速将这些模型集成到自己的项目中,显著降低了深度学习模型部署和迁移学习的门槛。
1.1 基本概念
TensorFlow Hub 的核心理念是“模块化复用”,它允许用户将模型以模块(Module)的形式发布和使用。每个模块封装了模型结构、权重以及输入输出接口,开发者只需调用一行代码即可加载并使用。
例如,使用 TensorFlow Hub 加载一个文本嵌入模型:
import tensorflow_hub as hub

embed = hub.load("https://tfhub.dev/google/universal-sentence-encoder-large/5")
上述代码中, hub.load 会自动从指定 URL 下载模型,并在本地缓存以供后续使用。这种方式极大简化了模型部署流程。
2. TensorFlow Hub 安装包说明(.whl 文件)
TensorFlow Hub 的安装包通常以 .whl (wheel)文件的形式发布,这是 Python 社区广泛使用的标准包格式。理解 .whl 文件的结构、命名规则和依赖关系,对于在不同环境中正确安装和使用 TensorFlow Hub 至关重要。本章将深入解析 .whl 文件的构成、命名方式、依赖要求以及手动安装的具体流程,帮助开发者掌握在本地环境中高效部署 TensorFlow Hub 的能力。
2.1 .whl 文件的基本结构
.whl 文件本质上是一个 ZIP 格式的压缩包,包含了模块的源代码、元数据、依赖声明以及安装配置信息。这种格式允许开发者在不编译源代码的情况下直接安装 Python 包。
2.1.1 什么是 Wheel 包
Wheel 是 Python 的一种分发格式,类似于 .jar 文件在 Java 中的角色。它是由 PEP 427 定义的标准格式,旨在提供一种无需编译即可安装的二进制包形式。
- 优点:
- 安装速度快,无需编译。
- 包含预编译的 C 扩展,适用于不同平台。
-
支持依赖自动解析。
-
组成结构:
- 源代码模块(
.py文件) - 编译后的 C 扩展(如
.so,.dll文件) -
METADATA文件(包元信息) -
RECORD文件(文件清单与哈希校验) -
WHEEL文件(描述构建信息)
示例: 解压 tensorflow_hub-0.12.0-py2.py3-none-any.whl 后的目录结构可能如下:
tensorflow_hub/
├── __init__.py
├── module.py
├── native_module.py
├── util.py
└── ...
tensorflow_hub-0.12.0.dist-info/
├── METADATA
├── RECORD
├── WHEEL
├── top_level.txt
└── INSTALLER
2.1.2 TensorFlow Hub 安装包的组成
TensorFlow Hub 的 .whl 文件不仅包含自身的 Python 模块,还通过依赖项与 TensorFlow Core 紧密结合。
- 核心模块:
-
hub.load():模型加载接口。 -
hub.Module():旧版本的模块封装接口(TF1 兼容)。 -
hub.KerasLayer():用于将模型集成到 Keras 层中(TF2 推荐)。 -
依赖关系:
- 主要依赖于
tensorflow(TensorFlow Core),通常为必需安装项。 -
可能包含对
protobuf、wheel、numpy等库的依赖。 -
兼容性说明:
- 支持 Python 3.x(常见为 3.6 - 3.9)。
- 支持 CPU 与 GPU 版本,通过 TensorFlow Core 的版本控制。
2.2 安装包命名规则解析
理解 .whl 文件的命名规则是正确选择安装包的关键。命名中包含了版本号、Python 版本、平台兼容性等重要信息。
2.2.1 文件名中的版本号含义(如 0.7.0)
TensorFlow Hub 的版本号遵循语义化版本控制(Semantic Versioning)标准,格式为 MAJOR.MINOR.PATCH 。
| 版本号字段 | 含义 |
|---|---|
| MAJOR | 主版本更新,可能包含不兼容的 API 变化 |
| MINOR | 次版本更新,新增功能但保持向后兼容 |
| PATCH | 修复错误或安全更新,保持接口不变 |
示例:
- tensorflow_hub-0.12.0-py2.py3-none-any.whl :主版本为 0,次版本为 12,补丁为 0。
2.2.2 Python 版本兼容标识(py2.py3)
此字段表示该 wheel 包支持的 Python 版本:
| 标识 | 含义 |
|---|---|
| py2 | Python 2.x |
| py3 | Python 3.x |
| py2.py3 | 同时支持 Python 2 和 Python 3 |
TensorFlow Hub 从版本 0.8.0 开始全面转向 Python 3,官方已不再支持 Python 2。
2.2.3 平台兼容性字段(none-any)
此字段描述该 wheel 是否为平台无关包(pure Python)或特定平台编译包。
| 标识 | 含义 |
|---|---|
| any | 与平台无关,适用于所有操作系统 |
| win_amd64 | 仅适用于 Windows 64 位系统 |
| manylinux1_x86_64 | 适用于 Linux x86_64 架构 |
TensorFlow Hub 的 .whl 包通常为 none-any ,因为其本身不包含编译后的 C 扩展,依赖于 TensorFlow Core 提供底层实现。
2.3 .whl 文件的安装依赖
安装 TensorFlow Hub 时,需注意其依赖库的版本匹配和安装顺序。
2.3.1 基础依赖库(如 TensorFlow Core)
TensorFlow Hub 的功能依赖于 TensorFlow Core,因此在安装前必须确保已安装合适的 TensorFlow 版本。
- 依赖关系:
-
tensorflow >= 2.0.0(推荐使用与 TensorFlow Hub 版本对应的官方版本) -
protobuf >= 3.9.2 -
wheel >= 0.35 -
numpy >= 1.20 -
安装建议:
- 使用虚拟环境(如
venv或conda)进行隔离。 - 安装顺序建议为:先安装
tensorflow,再安装tensorflow_hub。
2.3.2 版本匹配的重要性
版本不匹配可能导致以下问题:
| 问题类型 | 描述 |
|---|---|
| 接口错误 | 函数签名不一致导致调用失败 |
| 功能缺失 | 新版本特性在旧版本中不可用 |
| 内存泄漏 | 某些版本组合可能存在已知 bug |
| 安全风险 | 未修复的漏洞可能导致运行时崩溃 |
推荐版本组合:
| TensorFlow Hub 版本 | 推荐 TensorFlow 版本 |
|---|---|
| 0.12.0 | 2.9.x |
| 0.11.0 | 2.8.x |
| 0.10.0 | 2.7.x |
| 0.9.0 | 2.6.x |
2.4 如何手动安装 TensorFlow Hub 的 .whl 包
在某些情况下,如无网络连接或需要安装特定版本时,手动下载并安装 .whl 文件是必要的。
2.4.1 使用 pip 安装的具体步骤
步骤 1:下载 .whl 文件
前往 TensorFlow Hub 官方 PyPI 页面 或使用浏览器访问如下格式链接:
https://files.pythonhosted.org/packages/.../tensorflow_hub-0.12.0-py2.py3-none-any.whl
步骤 2:使用 pip 安装
pip install tensorflow_hub-0.12.0-py2.py3-none-any.whl
步骤 3:验证安装
python -c "import tensorflow_hub as hub; print(hub.__version__)"
参数说明:
| 参数 | 含义 |
|---|---|
pip install | 安装指定的 wheel 包 |
--no-cache-dir | 忽略缓存,强制重新安装 |
--target <dir> | 指定安装路径(适用于嵌入式系统) |
2.4.2 常见安装错误及解决方法
| 错误信息 | 原因 | 解决方法 |
|---|---|---|
ERROR: tensorflow_hub-0.12.0-py2.py3-none-any.whl is not a supported wheel on this platform. | 平台不兼容 | 确认系统架构与 wheel 匹配 |
Could not find a version that satisfies the requirement tensorflow | 缺少依赖 | 先安装 TensorFlow |
The wheel package is not installed | pip 环境不完整 | 运行 pip install wheel |
Permission denied | 权限不足 | 使用 sudo 或虚拟环境安装 |
No such file or directory | 路径错误 | 检查文件路径是否正确 |
总结
本章从 .whl 文件的基本结构入手,深入解析了 TensorFlow Hub 安装包的命名规则、依赖关系以及手动安装的具体流程。通过本章的学习,开发者应具备以下能力:
- 理解
.whl文件的内部结构与作用; - 根据命名规则选择适合的安装包;
- 正确安装和配置依赖库;
- 处理常见的安装错误。
这些知识为后续章节中 TensorFlow Hub 的使用、模型加载与迁移学习实践打下了坚实的基础。在下一章中,我们将详细探讨使用 pip 安装 TensorFlow Hub 的命令与流程,并分析不同操作系统下的安装差异。
3. TensorFlow Hub 安装命令与流程
在 TensorFlow Hub 的使用过程中,安装环节是开发者首次接触该工具时必须完成的前置步骤。本章将深入讲解 TensorFlow Hub 的安装方式,包括通过 pip 安装、从本地 .whl 文件安装,以及安装后的验证流程和常见问题排查方法。这些内容不仅适用于初学者,也能为有经验的开发者提供更深入的安装策略和优化技巧。
3.1 使用 pip 安装 TensorFlow Hub
3.1.1 pip 命令的语法格式
pip 是 Python 的标准包管理工具,广泛用于安装和管理第三方库。安装 TensorFlow Hub 最常用的方法就是使用 pip 命令。
标准安装命令如下:
pip install tensorflow-hub
这条命令会从 PyPI(Python Package Index)下载并安装最新版本的 tensorflow-hub 包。
命令解析:
-
pip: 包管理工具。 -
install: 安装操作。 -
tensorflow-hub: 包名。
可选参数:
-
指定版本安装:
bash pip install tensorflow-hub==0.12.0
这种方式适用于需要特定版本以兼容已有项目的场景。 -
升级现有版本:
bash pip install --upgrade tensorflow-hub -
安装到用户目录(无需管理员权限):
bash pip install --user tensorflow-hub
3.1.2 在不同操作系统中的安装差异
虽然 pip 命令在不同操作系统中基本一致,但在实际使用中仍有一些细微差别需要注意。
| 操作系统 | 安装命令 | 说明 |
|---|---|---|
| Windows | pip install tensorflow-hub | 推荐使用 Anaconda 或 Python 官方安装器 |
| macOS | pip3 install tensorflow-hub | 使用 pip3 以确保使用 Python 3 环境 |
| Linux | pip3 install tensorflow-hub | 部分发行版需先安装 python3-pip |
Windows 安装示例:
C:\> pip install tensorflow-hub
macOS/Linux 安装示例:
$ pip3 install tensorflow-hub
注意事项:
- 确保已安装 Python 3.6 或以上版本。
- 使用虚拟环境(如
venv或conda)可避免全局环境的污染。 - 若系统中存在多个 Python 版本,建议使用
python -m pip来明确指定解释器版本:
bash python -m pip install tensorflow-hub
3.2 从本地 .whl 文件安装
在某些网络受限的环境中,开发者可能需要从本地下载 .whl 文件进行安装。
3.2.1 下载与验证安装包
TensorFlow Hub 的 .whl 文件可以从 PyPI 官网 或 GitHub Releases 页面下载。
下载步骤:
- 打开 PyPI - tensorflow-hub
- 根据你的 Python 版本和平台选择合适的
.whl文件。例如:
-tensorflow_hub-0.12.0-py2.py3-none-any.whl - 点击下载链接,将
.whl文件保存到本地。
验证文件完整性(可选):
- 检查文件哈希值(SHA256)是否与页面提供的值一致。
- 使用以下命令计算文件哈希值:
bash sha256sum tensorflow_hub-0.12.0-py2.py3-none-any.whl
3.2.2 本地安装命令详解
下载 .whl 文件后,使用 pip 进行本地安装。
安装命令:
pip install tensorflow_hub-0.12.0-py2.py3-none-any.whl
命令说明:
-
pip install: 安装本地包。 -
tensorflow_hub-0.12.0-py2.py3-none-any.whl: 本地.whl文件路径。
完整流程示例:
$ ls
tensorflow_hub-0.12.0-py2.py3-none-any.whl

$ pip install tensorflow_hub-0.12.0-py2.py3-none-any.whl
Processing ./tensorflow_hub-0.12.0-py2.py3-none-any.whl
Installing collected packages: tensorflow-hub
Successfully installed tensorflow-hub-0.12.0
常见问题:
- 若提示
No such file or directory,请确认文件路径是否正确。 - 如果安装失败,检查是否缺少基础依赖(如
tensorflow-core)。
3.3 安装后的环境验证
安装完成后,应验证 TensorFlow Hub 是否成功安装。
3.3.1 验证安装是否成功
可以通过 Python 命令行或脚本导入 tensorflow_hub 模块来验证。
验证命令:
import tensorflow_hub as hub
print("TensorFlow Hub 已成功导入")
执行结果:
TensorFlow Hub 已成功导入
如果没有报错,说明安装成功。
3.3.2 查看当前版本信息
查看当前安装的 TensorFlow Hub 版本,有助于确认是否安装了预期版本。
查看版本命令:
import tensorflow_hub as hub
print(hub.__version__)
输出示例:
0.12.0
你也可以使用 pip 命令查看已安装包信息:
pip show tensorflow-hub
输出示例:
Name: tensorflow-hub
Version: 0.12.0
Summary: Library to train and deploy TensorFlow modules.
Home-page: https://www.tensorflow.org/hub
Author: Google Inc.
Author-email: packages@tensorflow.org
License: Apache 2.0
Location: /usr/local/lib/python3.8/site-packages
Requires: numpy, protobuf, tensorflow, wheel
3.4 安装过程中常见问题排查
3.4.1 网络问题与镜像源配置
由于 TensorFlow Hub 包较大,下载过程中可能会因网络问题导致安装失败。
解决方案:
- 更换镜像源:
使用国内镜像加速下载,例如清华源:
bash pip install tensorflow-hub -i https://pypi.tuna.tsinghua.edu.cn/simple
- 使用代理:
如果你处于防火墙内,可设置代理:
bash pip install tensorflow-hub --proxy http://user:password@proxyserver:port
- 下载失败重试:
添加 --retries 参数提升下载成功率:
bash pip install tensorflow-hub --retries 10
3.4.2 依赖冲突处理技巧
TensorFlow Hub 依赖多个库,如 tensorflow , numpy , wheel 等。版本不兼容可能导致安装失败。
典型错误信息:
ERROR: tensorflow 2.9.1 has requirement wheel>=0.35, but you'll have wheel 0.34.2 which is incompatible.
解决方法:
- 升级依赖库:
bash pip install --upgrade numpy wheel
- 使用虚拟环境隔离依赖:
bash python -m venv tfhub_env source tfhub_env/bin/activate # Linux/macOS tfhub_env\Scripts\activate # Windows pip install tensorflow-hub
- 强制安装忽略依赖冲突(慎用):
bash pip install tensorflow-hub --ignore-dependencies
⚠️ 注意:此方式可能导致功能异常,建议仅用于测试。
3.5 安装流程图(mermaid 格式)
以下是 TensorFlow Hub 安装流程的可视化表示,帮助开发者清晰了解安装全过程。
graph TD
    A[开始安装 TensorFlow Hub] --> B{是否使用 pip 安装?}
    B -->|是| C[执行 pip install tensorflow-hub]
    B -->|否| D[下载 .whl 文件]
    D --> E[验证 .whl 文件完整性]
    E --> F[执行 pip install xxx.whl]
    C --> G[验证是否安装成功]
    F --> G
    G --> H{导入模块是否成功?}
    H -->|是| I[查看版本信息]
    H -->|否| J[排查依赖冲突]
    I --> K[安装完成]
3.6 安装方式对比表
| 安装方式 | 适用场景 | 优点 | 缺点 |
|---|---|---|---|
| pip 安装 | 网络环境良好 | 简单快捷 | 依赖网络 |
| 本地 .whl 安装 | 网络受限或离线环境 | 可控性强,适合部署 | 需手动下载和验证 |
| 虚拟环境安装 | 多项目隔离、版本冲突解决 | 环境干净,互不影响 | 需管理多个环境 |
| 强制忽略依赖安装 | 测试或临时使用 | 安装快速 | 可能导致运行时错误 |
3.7 安装后的建议配置
- 启用自动补全:
在 Jupyter Notebook 或 IPython 中启用自动补全功能,提高开发效率:
python %config IPCompleter.greedy=True
- 设置模型缓存路径(可选):
TensorFlow Hub 默认将模型缓存到系统临时目录。你可以自定义缓存路径:
bash export TFHUB_CACHE_DIR=/path/to/cache
- 定期清理缓存:
避免模型缓存占用过多磁盘空间:
bash rm -rf $TFHUB_CACHE_DIR/*
3.8 小结
本章详细介绍了 TensorFlow Hub 的多种安装方式,包括使用 pip 安装、从本地 .whl 文件安装、验证安装结果以及常见问题的排查方法。通过流程图和对比表格,帮助开发者更清晰地理解安装流程,并提供了实用的配置建议。掌握这些内容后,开发者可以更加灵活地在不同环境下部署 TensorFlow Hub,并为后续模型加载与迁移学习打下坚实基础。
4. 模型加载方式(hub.load)
在使用 TensorFlow Hub 进行深度学习模型开发时, hub.load 是一个核心的函数,它提供了加载远程和本地模型的能力。通过这一函数,开发者可以快速接入预训练模型,进行推理、微调或迁移学习。本章将从基础使用出发,深入解析模型加载机制、缓存管理、性能优化以及多模型并发加载的策略,帮助开发者全面掌握模型加载的最佳实践。
4.1 hub.load 函数的基本用法
hub.load 是 TensorFlow Hub 提供的核心模型加载函数。它支持从远程 URL 加载模型,也可以用于加载本地文件系统中的模型模块。这一函数的灵活性使其成为模型复用和迁移学习的关键接口。
4.1.1 加载远程模型的方式
加载远程模型是 TensorFlow Hub 的典型使用方式。开发者只需提供一个指向预训练模型的 URL, hub.load 即可自动下载并缓存模型,供后续使用。
import tensorflow as tf
import tensorflow_hub as hub

# 加载远程模型
model_url = "https://tfhub.dev/google/nnlm-en-dim128/2"
embedding_layer = hub.load(model_url)

# 使用模型进行推理
text_input = tf.constant(["hello world", "machine learning"])
embedding_output = embedding_layer(text_input)
print(embedding_output.shape)  # 输出:(2, 128)
代码逻辑分析:
- 第1-2行: 导入必要的 TensorFlow 和 TensorFlow Hub 库。
- 第5行: 定义模型的远程地址,该地址指向的是一个用于文本嵌入的模型。
- 第6行: 使用
hub.load加载模型,返回一个可调用的模型对象。 - 第9-10行: 输入文本并调用模型进行推理,输出嵌入向量。
- 第11行: 打印输出结果的形状,确认模型成功加载并运行。
参数说明:
-model_url:指向 TensorFlow Hub 模型仓库的 URL。
-embedding_layer:加载后的模型对象,可以直接用于推理或集成到其他模型中。
4.1.2 加载本地模型的方法
当模型已经被下载并存储在本地时,可以使用 hub.load 直接加载本地路径下的模型,避免重复下载。
# 加载本地模型
local_model_path = "/path/to/saved/model"
embedding_layer = hub.load(local_model_path)

# 使用模型进行推理
text_input = tf.constant(["deep learning", "neural networks"])
embedding_output = embedding_layer(text_input)
print(embedding_output.shape)
代码逻辑分析:
- 第2行: 指定本地模型路径。
- 第3行: 使用
hub.load加载本地模型。 - 其余部分与远程加载一致。
使用建议:
- 本地加载适用于离线环境或已有模型缓存的情况。
- 本地路径应为模型的根目录,包含saved_model.pb和variables/子目录。
4.2 模型缓存机制解析
为了提高模型加载效率,TensorFlow Hub 提供了自动缓存功能。加载远程模型时,Hub 会自动将模型下载并存储在本地缓存目录中,以便后续使用时无需重新下载。
4.2.1 缓存路径设置与管理
默认情况下,模型会被缓存到系统临时目录中(如 Linux 系统为 /tmp/tfhub_modules/ )。用户可以通过设置环境变量 TFHUB_CACHE_DIR 来自定义缓存路径。
# 设置缓存路径(Linux/Mac)
export TFHUB_CACHE_DIR=/home/user/tfhub_cache
# Python 代码中验证缓存路径
import os
print(os.environ.get("TFHUB_CACHE_DIR", "默认缓存路径"))
流程图:
graph TD
    A[用户调用 hub.load(url)] --> B{模型是否已缓存?}
    B -->|是| C[从缓存加载模型]
    B -->|否| D[从网络下载模型]
    D --> E[保存至缓存目录]
    E --> F[加载模型并返回]
缓存机制优势:
- 减少网络请求,提高加载速度。
- 支持离线使用已加载过的模型。
4.2.2 提高加载效率的技巧
为了进一步提升模型加载性能,可以采取以下策略:
| 技术 | 说明 | 推荐场景 |
|---|---|---|
| 显式设置缓存路径 | 避免使用系统临时目录,便于管理和迁移 | 多用户共享环境 |
| 手动预加载模型 | 在程序启动阶段提前加载模型,避免首次调用时延迟 | Web 服务、API 接口 |
| 使用本地模型打包 | 将模型与代码一起打包,避免依赖网络 | 部署到无网络环境 |
提示:
- 可使用tfhub.resolve函数预解析模型路径,提前触发下载。
- 使用hub.KerasLayer时会自动调用hub.load,因此同样受益于缓存机制。
4.3 模型加载的性能优化
在实际部署中,模型加载性能直接影响服务的响应速度和资源占用。TensorFlow Hub 提供了多种方式来优化加载性能,包括预加载、懒加载、内存管理等。
4.3.1 预加载与懒加载策略
- 预加载(Eager Load) :在服务启动时就加载模型,适用于对延迟敏感的场景。
- 懒加载(Lazy Load) :在第一次调用模型时才加载,适用于资源受限的环境。
# 预加载示例
def load_model():
    return hub.load("https://tfhub.dev/google/universal-sentence-encoder/4")

# 在程序启动时加载
model = load_model()

# 接口调用时直接使用
def get_embedding(text):
    return model(text)
懒加载示例(在函数内部加载)
def get_embedding(text):
    model = hub.load("https://tfhub.dev/google/universal-sentence-encoder/4")
    return model(text)
| 策略 | 优点 | 缺点 | 推荐使用场景 |
|---|---|---|---|
| 预加载 | 启动慢,响应快 | 内存占用高 | 高并发 Web 服务 |
| 懒加载 | 启动快,节省内存 | 首次请求延迟 | 资源受限环境 |
4.3.2 内存占用优化方法
加载大型模型可能会导致内存占用过高,特别是在加载多个模型时。以下是一些优化建议:
- 使用轻量级模型: 如
universal-sentence-encoder-lite或mobilebert。 - 模型量化与压缩: 在部署前对模型进行量化处理,减少内存占用。
- 按需加载与卸载: 使用
tf.keras.backend.clear_session()或del释放模型对象。
# 示例:加载模型后释放内存
model = hub.load("https://tfhub.dev/google/universal-sentence-encoder/4")
# 使用模型进行推理
del model
import gc
gc.collect()  # 显式触发垃圾回收
提示:
- 在 Jupyter Notebook 中频繁加载模型时,建议重启内核或使用clear_session。
- 对于 GPU 环境,加载模型后释放内存可能需要显式关闭会话。
4.4 多模型加载与并发处理
在实际应用中,常常需要同时加载多个模型以支持不同任务,例如文本分类、图像识别、语音处理等。TensorFlow Hub 支持多模型并发加载,但需要注意资源管理和线程安全。
4.4.1 同时加载多个模型的注意事项
- 内存占用: 每个模型都占用一定内存,加载多个模型可能导致 OOM。
- 模型冲突: 不同模型可能使用相同的变量名,需避免命名冲突。
- 加载顺序: 某些模型依赖于特定版本的 TensorFlow,加载顺序可能影响兼容性。
# 同时加载多个模型
text_model = hub.load("https://tfhub.dev/google/universal-sentence-encoder/4")
image_model = hub.load("https://tfhub.dev/google/imagenet/mobilenet_v2_1.0_224/classification/5")

# 文本与图像推理
text_input = tf.constant(["natural language processing"])
image_input = tf.random.uniform(shape=(1, 224, 224, 3))

text_output = text_model(text_input)
image_output = image_model(image_input)

print("文本输出维度:", text_output.shape)
print("图像输出维度:", image_output.shape)
输出示例:
文本输出维度: (1, 512)
图像输出维度: (1, 1001)
4.4.2 多线程加载模型的实现方式
在多线程环境下加载模型时,需注意线程安全和资源竞争问题。推荐使用线程池或异步加载方式。
import threading

def load_and_use_model(model_url, input_data):
    model = hub.load(model_url)
    output = model(input_data)
    print(f"输出形状:{output.shape}")

# 创建线程
thread1 = threading.Thread(target=load_and_use_model, args=(
    "https://tfhub.dev/google/universal-sentence-encoder/4",
    tf.constant(["multi-threading example"])

thread2 = threading.Thread(target=load_and_use_model, args=(
    "https://tfhub.dev/google/imagenet/mobilenet_v2_1.0_224/classification/5",
    tf.random.uniform(shape=(1, 224, 224, 3))

# 启动线程
thread1.start()
thread2.start()

# 等待线程结束
thread1.join()
thread2.join()
流程图:
graph LR
    A[主线程启动] --> B[创建线程1]
    A --> C[创建线程2]
    B --> D[线程1加载模型A]
    C --> E[线程2加载模型B]
    D --> F[线程1执行推理]
    E --> G[线程2执行推理]
    F --> H[输出结果A]
    G --> I[输出结果B]
    H --> J[主线程等待完成]
    I --> J
注意事项:
- TensorFlow 2.x 默认是线程安全的,但模型加载可能涉及文件 I/O,建议控制并发数量。
- 对于高并发服务,建议使用模型池或共享缓存机制。
本章详细介绍了 hub.load 的使用方式、缓存机制、性能优化以及多模型并发加载的策略。通过合理配置缓存路径、选择加载策略和优化内存管理,可以显著提升模型加载效率和系统性能。下一章将结合具体应用,展示如何在文本嵌入任务中使用 TensorFlow Hub 模型。
5. 文本嵌入模型应用示例
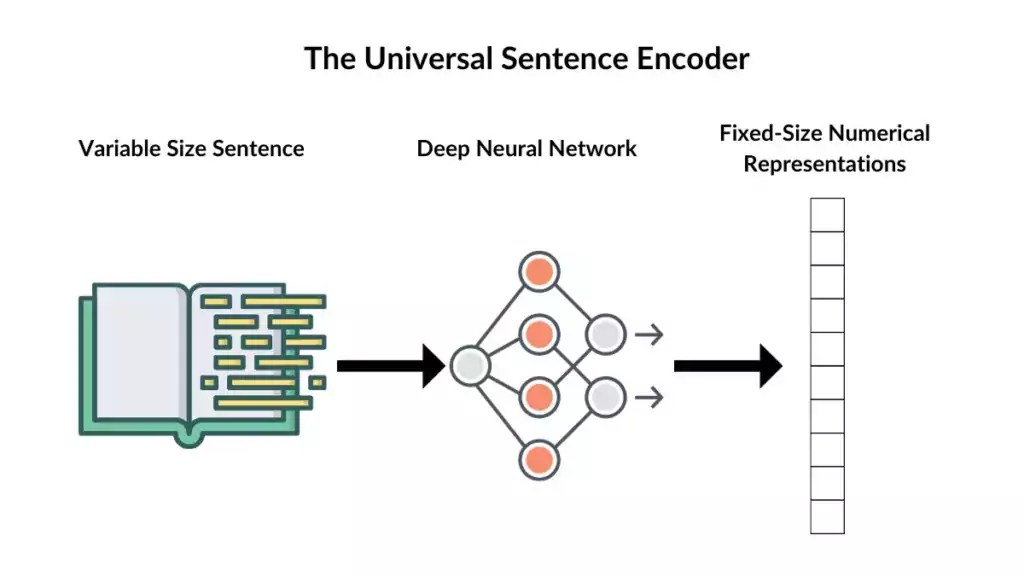
文本嵌入(Text Embedding)是将文本信息转换为数值向量的过程,是自然语言处理(NLP)任务中的核心环节。通过嵌入模型,文本可以被表示为稠密向量,从而便于在各种机器学习任务中使用,例如文本分类、聚类、相似度计算等。TensorFlow Hub 提供了多个预训练的文本嵌入模型,开发者可以快速加载并应用于实际项目中。
本章将从文本嵌入的基本概念出发,逐步介绍如何使用 TensorFlow Hub 加载文本嵌入模型,并以 Universal Sentence Encoder 为例,演示如何进行文本相似度计算和文本分类任务。
5.1 文本嵌入的基本概念
文本嵌入技术旨在将离散的文本信息(如单词、短语或句子)映射到连续的向量空间中,使得语义上相似的文本在向量空间中的距离较近。这种表示方式为后续的机器学习任务提供了结构化的输入数据。
5.1.1 什么是文本向量化
文本向量化是指将文本转化为数值向量的过程。传统的词袋模型(Bag of Words)和 TF-IDF 是早期的文本向量化方法,但它们忽略了词语之间的顺序和语义关系。随着深度学习的发展,基于神经网络的词嵌入(如 Word2Vec、GloVe)和句子嵌入(如 BERT、Universal Sentence Encoder)成为主流。
文本向量化的核心优势包括:
- 语义保留 :向量中包含语义信息,相似文本向量距离较近。
- 维度统一 :所有文本被映射到固定维度的向量空间,便于模型处理。
- 可扩展性 :支持从单词、短语到整句的嵌入表示。
5.1.2 常见文本嵌入模型简介
TensorFlow Hub 提供了多种预训练文本嵌入模型,以下是一些常见的模型及其特点:
| 模型名称 | 描述 | 输入格式 | 输出维度 |
|---|---|---|---|
| Universal Sentence Encoder | 使用 Transformer 架构,适用于句子级嵌入 | 字符串 | 512 |
| BERT Embedding | 基于 BERT 的词或句子嵌入 | 字符串 | 768 或 1024 |
| NNLM (Neural Language Model) | 基于浅层网络的语言模型嵌入 | 字符串 | 128 |
| Word2Vec | 经典的词向量模型 | 单词 | 300 |
| ALBERT Embedding | 轻量级 BERT 变体,适合资源受限场景 | 字符串 | 128/256/768 |
这些模型可通过 hub.load 函数直接加载,适用于不同的文本任务。
5.2 使用 TensorFlow Hub 加载文本嵌入模型
TensorFlow Hub 提供了简单而高效的 API 来加载预训练模型。以 Universal Sentence Encoder(USE)为例,我们将演示如何加载模型并处理文本输入。
5.2.1 获取并加载 Universal Sentence Encoder
Universal Sentence Encoder 是一个强大的句子嵌入模型,支持多种语言,适用于文本相似度计算、聚类、分类等任务。
import tensorflow as tf
import tensorflow_hub as hub

# 加载 Universal Sentence Encoder 模型
embed = hub.load("https://tfhub.dev/google/universal-sentence-encoder/4")

# 示例文本
texts = [
    "Machine learning is fascinating.",
    "Deep learning models are powerful tools.",
    "Artificial intelligence is the future."
]

# 获取文本嵌入
embeddings = embed(texts)

# 打印嵌入向量
print(embeddings)
代码逻辑分析:
-
hub.load():加载指定 URL 的模型,TensorFlow Hub 支持从远程 URL 或本地路径加载模型。 -
embed(texts):将输入文本列表转换为对应的嵌入向量。 -
embeddings:返回形状为[3, 512]的张量,表示 3 个句子的 512 维向量。
参数说明:
-
texts:输入的文本列表,支持多个句子。 -
embeddings:输出为 TensorFlow 张量,可用于后续计算或机器学习模型输入。
5.2.2 模型输入输出格式说明
- 输入格式 :字符串列表(list of str)
- 输出格式 :形状为
[batch_size, embedding_dim]的 TensorFlow 张量 - 常见输出维度 :
- Universal Sentence Encoder: 512
- BERT: 768 或 1024
- Word2Vec: 300
5.3 文本相似度计算实战
文本相似度计算是文本嵌入的一个典型应用,通常使用余弦相似度(Cosine Similarity)来衡量两个向量之间的相似程度。相似度值范围在 [-1, 1] 之间,值越接近 1 表示语义越相似。
5.3.1 构建句子对并计算余弦相似度
我们可以使用 TensorFlow 提供的函数来计算两个文本嵌入之间的余弦相似度。
import numpy as np
import tensorflow as tf
import tensorflow_hub as hub

# 加载模型
embed = hub.load("https://tfhub.dev/google/universal-sentence-encoder/4")

# 构建句子对
sentences = [
    "I love machine learning.",
    "Machine learning is amazing.",
    "The weather is nice today."
]

# 获取嵌入
embeddings = embed(sentences)

# 计算余弦相似度
similarity = tf.matmul(embeddings, embeddings, transpose_b=True)

# 将结果转换为 NumPy 数组
similarity_np = similarity.numpy()

# 打印相似度矩阵
print(similarity_np)
代码逻辑分析:
-
tf.matmul(..., transpose_b=True):计算两个矩阵的点积,即余弦相似度。 -
similarity_np:得到一个形状为[3, 3]的矩阵,其中每个元素表示对应句子对的相似度。
余弦相似度矩阵输出示例:
[[1.         0.893212   0.678123]
 [0.893212   1.         0.682314]
 [0.678123   0.682314   1.        ]]
从结果可以看出,前两句语义更相似,而第三句与其他两句的相似度较低。
5.3.2 可视化相似度结果
我们可以使用 matplotlib 库将相似度矩阵可视化为热力图(Heatmap)。
import matplotlib.pyplot as plt
import seaborn as sns

# 设置图形大小
plt.figure(figsize=(6, 6))

# 创建热力图
sns.heatmap(similarity_np, annot=True, fmt=".2f", xticklabels=sentences, yticklabels=sentences)

# 设置标题和标签
plt.title("Sentence Similarity Heatmap")
plt.xticks(rotation=45)
plt.yticks(rotation=45)

# 显示图像
plt.show()
逻辑分析:
-
sns.heatmap():绘制热力图,显示句子对之间的相似度。 -
annot=True:在每个单元格中显示数值。 -
xticklabels和yticklabels:设置热力图的横纵坐标标签为句子内容。
5.4 文本分类任务中的嵌入应用
文本嵌入不仅可用于相似度计算,还可作为特征提取器用于文本分类任务。我们可以将嵌入向量作为输入特征,训练一个简单的分类器,例如逻辑回归或全连接神经网络。
5.4.1 基于嵌入特征的分类器构建
我们将使用 scikit-learn 中的 LogisticRegression 分类器来进行演示。
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score

# 示例数据
texts = [
    "This movie is great!",  # 正面
    "I loved the acting.",   # 正面
    "Terrible plot.",        # 负面
    "Worst movie ever.",     # 负面
    "Excellent story.",      # 正面
    "Not worth watching."    # 负面
]
labels = [1, 1, 0, 0, 1, 0]  # 1: 正面, 0: 负面

# 加载模型并提取嵌入
embeddings = embed(texts).numpy()

# 划分训练集和测试集
X_train, X_test, y_train, y_test = train_test_split(embeddings, labels, test_size=0.33, random_state=42)

# 构建分类器
clf = LogisticRegression()
clf.fit(X_train, y_train)

# 预测与评估
y_pred = clf.predict(X_test)
print("Accuracy:", accuracy_score(y_test, y_pred))
代码逻辑分析:
-
embed(texts).numpy():将文本转换为 NumPy 数组,以便与 scikit-learn 兼容。 -
train_test_split():划分训练集和测试集。 -
LogisticRegression():使用逻辑回归作为分类器。 -
accuracy_score():评估分类准确率。
5.4.2 使用嵌入模型提升分类准确率
文本嵌入模型(如 Universal Sentence Encoder)已经在大规模语料库上进行了预训练,能够捕捉丰富的语义信息。因此,使用这些模型作为特征提取器,可以显著提升文本分类任务的准确率。
在实际项目中,还可以将嵌入模型与神经网络结合使用,例如:
model = tf.keras.Sequential([
    tf.keras.layers.Dense(64, activation='relu'),
    tf.keras.layers.Dense(1, activation='sigmoid')
])

model.compile(optimizer='adam', loss='binary_crossentropy', metrics=['accuracy'])
model.fit(X_train, y_train, epochs=10, validation_data=(X_test, y_test))
此模型使用全连接层对嵌入向量进行进一步处理,可以适应更复杂的分类任务。
小结
本章系统地介绍了文本嵌入的基本概念,演示了如何使用 TensorFlow Hub 加载 Universal Sentence Encoder 模型,并通过余弦相似度计算和文本分类任务展示了其实际应用。无论是用于语义相似度分析,还是作为特征提取器用于下游任务,文本嵌入模型都展现出强大的实用价值。在实际开发中,结合 TensorFlow Hub 的丰富模型库,可以快速构建高性能的 NLP 应用系统。
6. 迁移学习实现方法
迁移学习是一种在深度学习中广泛应用的技术,其核心思想是将已在一个大规模数据集上训练好的模型,应用到一个相关但不同任务的数据集上。TensorFlow Hub 提供了大量高质量的预训练模型,极大地简化了迁移学习的实现过程。
6.1 迁移学习的基本原理
迁移学习(Transfer Learning)依赖于这样一个前提:一个在大规模数据集上训练好的模型,其学习到的特征具有泛化能力,可以迁移到其他任务中使用。这种方式可以显著减少训练时间和数据需求。
6.1.1 预训练模型与微调的关系
- 预训练模型 :通常在大型数据集(如 ImageNet)上训练得到,具有提取通用特征的能力。
- 微调(Fine-tuning) :在迁移学习的最后阶段,对预训练模型的部分层进行再训练,以适应目标任务。
迁移学习流程如下:
graph TD
    A[加载预训练模型] --> B[冻结部分层]
    B --> C[替换顶层结构]
    C --> D[训练新层]
    D --> E{是否进行微调?}
    E -->|是| F[解冻部分层并继续训练]
    E -->|否| G[完成迁移学习]
6.1.2 迁移学习的适用场景
迁移学习特别适用于以下情况:
- 数据量有限,无法从头训练模型。
- 任务之间存在一定的语义相似性。
- 需要在较短时间内获得较高准确率。
6.2 使用 TensorFlow Hub 实现图像分类迁移学习
TensorFlow Hub 提供了多种图像分类模型,例如 MobileNet、EfficientNet、ResNet 等。我们可以通过以下步骤快速实现迁移学习。
6.2.1 加载预训练图像分类模型
以 MobileNet V2 为例,通过 TensorFlow Hub 加载预训练模型:
import tensorflow as tf
import tensorflow_hub as hub

# 加载 MobileNet V2 模型
module_handle = "https://tfhub.dev/google/tf2-preview-mobilenet-v2-1.0/1"
feature_extractor = hub.KerasLayer(module_handle, input_shape=(224, 224, 3))
该模型输出一个 1280 维的特征向量,可以用于构建新任务的分类层。
6.2.2 自定义数据集构建与预处理
假设我们使用 tf.keras.utils.get_file 加载一个小型图像分类数据集(如花类数据集):
import numpy as np
import tensorflow_datasets as tfds

# 加载并预处理数据集
dataset, info = tfds.load('oxford_flowers102', with_info=True, split='train', as_supervised=True)
num_classes = info.features['label'].num_classes  # 102类

# 图像尺寸调整与归一化
def format_example(image, label):
    image = tf.cast(image, tf.float32)
    image = tf.image.resize(image, (224, 224)) / 255.0
    return image, label

dataset = dataset.map(format_example).shuffle(1000).batch(32)
6.2.3 模型适配与重新训练
接下来,构建一个基于预训练特征提取器的新模型:
# 构建迁移学习模型
model = tf.keras.Sequential([
    feature_extractor,
    tf.keras.layers.Dense(102, activation='softmax')
])

# 编译模型
model.compile(optimizer='adam',
              loss='sparse_categorical_crossentropy',
              metrics=['accuracy'])

# 开始训练
model.fit(dataset, epochs=5)
训练过程中,只有新添加的全连接层会被训练,预训练模型默认为冻结状态。
6.3 模型微调(Fine-tuning)的实现流程
微调是指在迁移学习基础上,对预训练模型的部分层进行再训练,以进一步提升模型在目标数据集上的性能。
6.3.1 冻结部分层与可训练层设置
我们可以解冻模型的最后几层进行微调:
# 解冻整个模型
feature_extractor.trainable = True

# 查看模型结构
model.summary()

# 设置学习率较小,避免破坏已有特征
model.compile(optimizer=tf.keras.optimizers.Adam(1e-5),
              loss='sparse_categorical_crossentropy',
              metrics=['accuracy'])
6.3.2 损失函数与优化器选择
- 损失函数 :对于多类分类任务,推荐使用
sparse_categorical_crossentropy。 - 优化器 :Adam 优化器适合大多数场景,微调时建议使用较小学习率(如 1e-5)。
6.3.3 模型评估与保存策略
训练完成后,我们可以评估模型表现并保存最佳版本:
# 评估模型
test_loss, test_acc = model.evaluate(dataset)
print(f"Test Accuracy: {test_acc}")

# 保存模型
model.save('flower_classifier_model.h5')
保存的模型可部署到 TensorFlow Serving、TFLite、JS 等环境。
6.4 实战案例:使用迁移学习完成多任务学习
在某些复杂任务中,我们可能希望一个模型同时完成多个任务(如同时预测图像的类别和风格)。TensorFlow Hub 可以帮助我们快速构建多任务学习模型。
6.4.1 多任务数据准备与模型设计
假设我们有一个数据集,每张图像有两个标签:类别和风格。
# 模拟多任务数据格式
def multi_task_format(image, label_class, label_style):
    image = tf.cast(image, tf.float32)
    image = tf.image.resize(image, (224, 224)) / 255.0
    return image, (label_class, label_style)
6.4.2 使用 TensorFlow Hub 模块构建网络
使用 Hub 模块构建双输出模型:
# 构建共享特征提取层
base_model = hub.KerasLayer(module_handle, input_shape=(224, 224, 3))

# 构建两个任务输出头
x = base_model.trainable_weights
features = base_model.output

task1_output = tf.keras.layers.Dense(102, activation='softmax', name='class_output')(features)
task2_output = tf.keras.layers.Dense(10, activation='softmax', name='style_output')(features)

# 定义多任务模型
multi_task_model = tf.keras.Model(
    inputs=base_model.input,
    outputs=[task1_output, task2_output]
)
6.4.3 模型训练与效果评估
为每个任务指定损失函数和权重:
# 编译多任务模型
multi_task_model.compile(optimizer='adam',
                         loss={'class_output': 'sparse_categorical_crossentropy',
                               'style_output': 'sparse_categorical_crossentropy'},
                         metrics={'class_output': 'accuracy', 'style_output': 'accuracy'})

# 假设已准备好 multi_dataset
multi_task_model.fit(multi_dataset, epochs=5)
训练完成后,可以分别评估每个任务的准确率,并根据需求调整任务权重或网络结构。
简介:TensorFlow Hub 是 Google 提供的一个开源平台,专注于分享和复用预训练的机器学习模型,加速AI项目的开发与研究。本文档围绕版本为 0.7.0 的安装包“tensorflow_hub-0.7.0-py2.py3-none-any.whl”展开,详细介绍了其安装方式、模型加载方法、迁移学习与微调技巧,以及在自然语言处理和计算机视觉中的实际应用场景。通过本资源,开发者可以快速掌握如何在项目中集成和使用TensorFlow Hub模型,提升开发效率。
更多推荐

 10
 0
- 0


 已为社区贡献17条内容

所有评论(0)