
嵌入式软件工程师笔试必备资料大全

简介:嵌入式软件工程师专注于在嵌入式系统上开发、优化软件。这份笔试资料集涵盖了操作系统、C/C++编程、数据结构、硬件接口编程等多个关键学习领域。学习资料详细介绍了RTOS、内存管理、中断处理、数据结构的选择与算法实现,以及嵌入式系统开发的其他重要方面,如固件更新和版本控制。掌握这些内容对于准备笔试和提升开发技能至关重要。 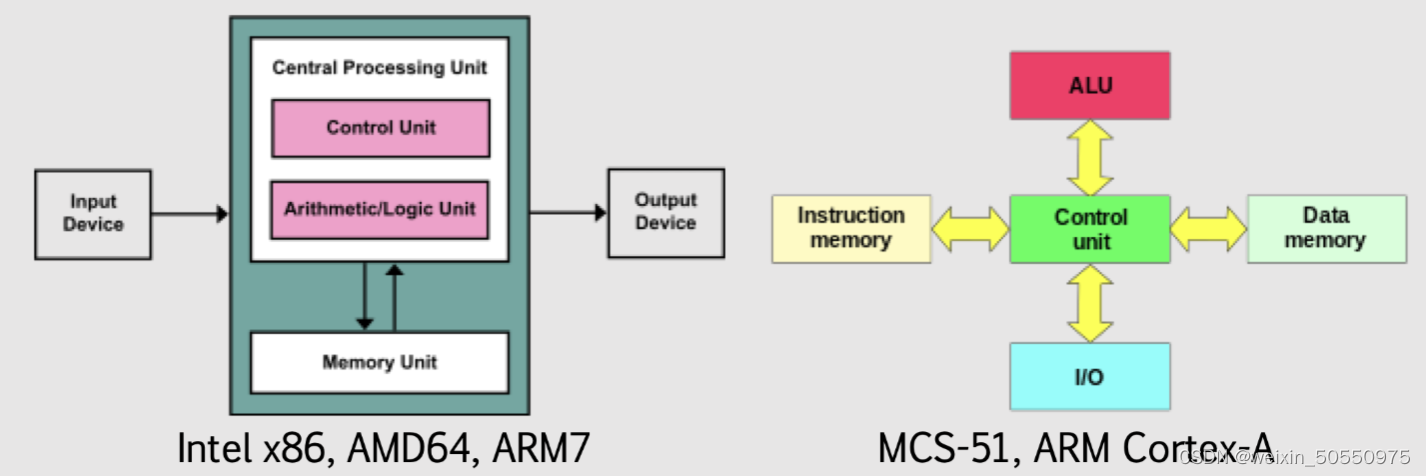
1. 嵌入式系统与RTOS(实时操作系统)原理
1.1 嵌入式系统的概念
嵌入式系统是一种专用计算机系统,它被设计为运行在控制设备和应用程序上,而不是通用计算。其特点包括有限的资源(如CPU、内存)、实时操作要求和硬件与软件高度定制化。
1.2 实时操作系统RTOS的特性
实时操作系统(RTOS)是专为满足实时计算需求而设计的操作系统。它能够保证任务的及时完成,具有确定性的响应时间和高可靠性。其主要特点包括多任务处理、中断管理、调度策略、内存管理和同步机制。
1.3 嵌入式系统与RTOS的结合
在嵌入式系统中集成RTOS可以显著提升系统的性能和稳定性,尤其是在处理多个并发任务时。RTOS提供了一套管理这些任务的机制,如任务调度和资源分配,确保关键任务按时得到处理,从而满足实时性要求。
案例分析 :例如,在医疗设备或汽车电子中,RTOS的使用保障了患者监测和汽车安全控制的实时性,避免了潜在的风险和故障。通过适当的任务优先级设置和调度策略,RTOS确保了这些系统对紧急事件的快速响应。
在后续章节中,我们将深入探讨如何在嵌入式系统中有效地使用RTOS,并且掌握其设计原理与最佳实践。我们将通过实际案例来说明RTOS在复杂嵌入式项目中的关键作用。
2. C/C++编程基础与性能优化
2.1 C/C++基础语法回顾
C和C++是嵌入式系统编程中使用最广泛的语言之一,因为它们提供了对硬件层面的精细控制,同时具有高效的执行速度。在这一小节中,我们会复习一些C/C++的基础语法,并介绍一些对于嵌入式开发者来说至关重要的概念。
2.1.1 基本数据类型和运算符
在C/C++中,数据类型定义了变量的种类和占用内存的大小。基本的数据类型包括整型、浮点型、字符型等。
int main() {
    int integerVar = 10; // 整型变量
    float floatVar = 3.14; // 浮点型变量
    char charVar = 'A'; // 字符型变量
    // 其他基本数据类型
    double doubleVar = 0.001; // 双精度浮点型
    short shortVar = 5; // 短整型
    long longVar = 100000L; // 长整型
    unsigned int uintVar = 10u; // 无符号整型
}
在上述代码中,我们声明了不同类型的变量并初始化。在嵌入式系统中,合理选择数据类型不仅可以节省存储空间,还能提高程序运行效率。
2.1.2 控制结构与函数定义
控制结构,如if-else语句、循环语句(for、while、do-while),允许程序根据条件执行不同的操作,或者重复执行一段代码。
int max(int a, int b) {
    if (a > b) {
        return a;
    } else {
        return b;
    }
}
在这个例子中,函数 max 使用了if-else结构来比较两个整数,并返回最大值。函数是组织和重用代码的基本单元,有助于保持代码的模块化和可维护性。
2.2 面向对象编程(OOP)的深入理解
OOP是C++中一项关键的编程范式,它提供了封装、继承和多态等特性,使得程序设计更加符合实际问题的结构。
2.2.1 类与对象的概念
在C++中,类是创建对象的蓝图,对象是类的实例。
class Car {
public:
    void startEngine() {
        // 发动引擎
    }
};

int main() {
    Car myCar;
    myCar.startEngine();
    return 0;
}
这里定义了一个 Car 类,它有一个公共方法 startEngine 。然后在 main 函数中创建了 Car 类的一个对象 myCar ,并调用了该方法。在嵌入式系统中,类和对象可以用于模拟现实世界中的实体,使得系统设计更加直观和易于管理。
2.2.2 继承、多态与封装在嵌入式中的应用
继承允许我们创建一个类来继承另一个类的属性和方法,多态则是指不同类的对象对同一个消息做出相应的能力,封装是指隐藏对象的属性和实现细节,仅对外提供有限的操作接口。
class Vehicle {
protected:
    int speed;
public:
    Vehicle(int s) : speed(s) {}
    virtual void move() = 0; // 纯虚函数定义接口
};

class Car : public Vehicle {
public:
    Car(int s) : Vehicle(s) {}
    void move() override {
        // Car特定的移动实现
    }
};

int main() {
    Vehicle *myCar = new Car(60); // 多态使用
    myCar->move();
    delete myCar;
    return 0;
}
在上例中, Car 类继承了 Vehicle 类,并覆盖了 move 方法,这显示了多态的使用。使用指针时的多态允许在运行时决定调用哪个对象的 move 方法。封装确保了对象的内部状态只被授权的操作访问,这对于保护嵌入式设备的安全性非常关键。
2.3 C/C++性能优化技巧
优化嵌入式系统的性能对于确保设备的稳定运行和延长电池寿命至关重要。这一小节将介绍一些C/C++的性能优化技巧。
2.3.1 编译器优化选项和编译器安全特性
编译器的优化选项,如 -O2 和 -O3 ,可以对生成的机器代码进行性能优化。
g++ -O2 -o program program.cpp
这个编译指令使用了GCC编译器的优化选项 -O2 来优化程序 program.cpp 。优化不仅加快了程序的执行速度,也可能减少程序的内存占用。当然,优化过程需要综合考虑程序的可读性和维护性。
编译器的安全特性,如 -fstack-protector ,可以增加程序的安全性,通过在栈上放置校验和来防止栈溢出攻击。
g++ -fstack-protector -o program program.cpp
通过在编译时增加这一选项,编译器会在栈帧的开始处插入一个随机的保护值,并在返回地址之前检查这个值,如果值发生了改变,说明发生了栈溢出,程序会立即终止运行。
2.3.2 内存管理与算法优化
在嵌入式系统中,由于有限的内存资源,良好的内存管理策略是至关重要的。动态内存分配和释放需要谨慎处理,以避免内存泄漏。
#include <stdlib.h>

int main() {
    int *array = (int*)malloc(100 * sizeof(int));
    if (array == NULL) {
        // 处理内存分配失败的情况
    }
    // 使用array
    free(array); // 释放内存
    return 0;
}
在上述代码中,我们使用 malloc 分配了100个整数的空间,并在使用完毕后用 free 释放。这是避免内存泄漏的典型例子。在更复杂的情况下,可能需要使用内存池或引用计数等技术来管理内存。
算法优化是指通过改进算法逻辑或数据结构来提高程序运行效率。例如,在排序时使用快速排序算法通常比使用冒泡排序算法要快。
#include <stdio.h>

void quickSort(int *array, int low, int high) {
    if (low < high) {
        int pivot = partition(array, low, high);
        quickSort(array, low, pivot - 1);
        quickSort(array, pivot + 1, high);
    }
}

int partition(int *array, int low, int high) {
    // ...
}
快速排序算法在平均情况下的时间复杂度为O(n log n),这比冒泡排序的O(n^2)要快得多,特别是在处理大量数据时。
在嵌入式系统中,上述的内存管理和算法优化都是确保系统高效稳定运行的重要策略。开发者需要不断地评估和测试以寻找最佳的优化方案。
3. 数据结构与算法在嵌入式开发中的应用
在嵌入式系统开发中,数据结构与算法的应用是构建高效、可靠系统的基石。嵌入式系统往往资源有限,这要求开发者不仅要有扎实的编程基础,还要精通如何使用合适的数据结构和算法来优化程序性能。本章节将探讨核心数据结构的实现、应用案例以及常见算法的设计和优化。
核心数据结构的实现与应用
栈、队列和链表的嵌入式实现
栈、队列和链表是三种最基础的数据结构,它们在嵌入式开发中的应用广泛,尤其是在资源受限的环境下。
栈的嵌入式实现
栈是一种后进先出(LIFO)的数据结构,它支持两种主要操作:push(压栈)和pop(弹栈)。在嵌入式系统中,栈常用于函数调用、中断处理以及递归算法实现。
#define MAX_SIZE 100
int stack[MAX_SIZE];
int top = -1;

void push(int value) {
    if (top < MAX_SIZE - 1) {
        stack[++top] = value;
    } else {
        // Handle stack overflow
    }
}

int pop() {
    if (top >= 0) {
        return stack[top--];
    } else {
        // Handle stack underflow
    }
}
在上述代码中,我们定义了一个最大容量为 MAX_SIZE 的数组 stack 来模拟栈的行为,以及一个名为 top 的变量来追踪栈顶位置。 push 函数用于添加元素到栈顶,而 pop 函数用于移除栈顶元素并返回它。
队列的嵌入式实现
队列是一种先进先出(FIFO)的数据结构,支持两个操作:enqueue(入队)和dequeue(出队)。队列在任务调度、缓冲和时间管理等领域有广泛应用。
#define MAX_SIZE 100
int queue[MAX_SIZE];
int front = 0, rear = -1;

void enqueue(int value) {
    if (rear < MAX_SIZE - 1) {
        rear++;
        queue[rear] = value;
    } else {
        // Handle queue overflow
    }
}

int dequeue() {
    if (front <= rear) {
        int value = queue[front++];
        // Optional: clear the dequeued element
        return value;
    } else {
        // Handle queue underflow
    }
}
本段代码中,我们使用数组 queue 以及变量 front 和 rear 来表示队列的前端和后端。 enqueue 函数用于添加元素到队列尾部,而 dequeue 函数用于移除并返回队列前端的元素。
链表的嵌入式实现
链表是一种由节点组成的线性集合,每个节点包含数据部分和指向下一个节点的指针。链表在嵌入式系统中的应用包括动态内存分配、数据缓存以及复杂数据的快速检索。
typedef struct Node {
    int data;
    struct Node* next;
} Node;

void append(Node** head, int data) {
    Node* new_node = malloc(sizeof(Node));
    new_node->data = data;
    new_node->next = NULL;

    if (*head == NULL) {
        *head = new_node;
    } else {
        Node* temp = *head;
        while (temp->next != NULL) {
            temp = temp->next;
        }
        temp->next = new_node;
    }
}
上述实现了一个单向链表的基本结构,并提供了一个 append 函数用于在链表末尾添加新的节点。链表在嵌入式系统中的主要优点是它不需要预先分配固定大小的内存,并且它允许在任意位置进行插入和删除操作。
树和图的嵌入式应用案例
树的嵌入式应用案例
树是一种层次化数据结构,广泛应用于嵌入式系统中的数据组织和存储,如解析表达式树、文件系统、数据库索引等。
typedef struct TreeNode {
    int value;
    struct TreeNode* left;
    struct TreeNode* right;
} TreeNode;

TreeNode* createNode(int value) {
    TreeNode* newNode = (TreeNode*)malloc(sizeof(TreeNode));
    newNode->value = value;
    newNode->left = NULL;
    newNode->right = NULL;
    return newNode;
}

void insertNode(TreeNode** root, int value) {
    if (*root == NULL) {
        *root = createNode(value);
    } else if (value < (*root)->value) {
        insertNode(&((*root)->left), value);
    } else {
        insertNode(&((*root)->right), value);
    }
}
上述代码定义了树的节点结构,并提供了创建节点和插入节点的函数。这些操作可以用于构建二叉搜索树,其中每个节点的左子节点都小于当前节点,而右子节点都大于当前节点。
图的嵌入式应用案例
图是一种由顶点(节点)和边(连接顶点的线)组成的非线性数据结构,常用于路径规划、社交网络分析以及复杂系统建模等。
#define MAX_VERTICES 100
int graph[MAX_VERTICES][MAX_VERTICES]; // Adjacency matrix
int num_vertices = 0;

void addEdge(int start, int end) {
    if (start >= 0 && start < num_vertices && end >= 0 && end < num_vertices) {
        graph[start][end] = 1;
        graph[end][start] = 1; // For undirected graph
    }
}
在此代码中,我们使用邻接矩阵来表示图。 addEdge 函数用于在图中添加边,它接受两个顶点作为参数,并将它们的对应矩阵值设为1,表示这两个顶点之间存在一条边。如果图是有向的,则只需要设置一个方向的边。
算法设计与优化
常见算法在嵌入式中的应用
嵌入式系统中的算法设计需要考虑程序的效率和资源消耗。例如,排序和搜索算法在数据处理和查找方面至关重要。
排序算法
排序算法的目的是将一组数据按照特定顺序排列。在嵌入式系统中,选择合适的排序算法可以有效减少处理时间,特别是对于需要频繁更新的数据集。
void bubbleSort(int arr[], int n) {
    for (int i = 0; i < n - 1; i++) {
        for (int j = 0; j < n - i - 1; j++) {
            if (arr[j] > arr[j + 1]) {
                // Swap temp and arr[i]
                int temp = arr[j];
                arr[j] = arr[j + 1];
                arr[j + 1] = temp;
            }
        }
    }
}
冒泡排序是最简单的排序算法之一,它重复地遍历要排序的数列,一次比较两个元素,如果它们的顺序错误就把它们交换过来。尽管在最坏情况下其时间复杂度为O(n^2),但其简单性和易于实现的特点使其在嵌入式系统中仍然有一席之地。
搜索算法
搜索算法用于在数据集合中查找特定元素。二分查找是一种高效的搜索算法,它适用于有序数据集。
int binarySearch(int arr[], int l, int r, int x) {
    while (l <= r) {
        int m = l + (r - l) / 2;

        // Check if x is present at mid
        if (arr[m] == x) {
            return m;
        }

        // If x greater, ignore left half
        if (arr[m] < x) {
            l = m + 1;
        }
        // If x is smaller, ignore right half
        else {
            r = m - 1;
        }
    }

    // If we reach here, then the element was not present
    return -1;
}
二分查找算法将数据集分为两半,然后决定哪一半包含目标值,只搜索那一半。这个过程重复进行,直到找到目标值或者搜索范围为空。该算法的时间复杂度为O(log n),非常适合资源有限的嵌入式系统。
时间复杂度和空间复杂度分析
在嵌入式系统中,时间复杂度和空间复杂度是衡量算法性能的两个重要指标。理解它们对于选择和设计高效的算法至关重要。
时间复杂度
时间复杂度指的是算法执行时间随输入数据量增长的变化趋势。它通常用大O符号表示,忽略常数和低阶项。
graph TD
    A[算法执行时间] --> B[时间复杂度]
    B --> C[O(1) 常数时间]
    B --> D[O(log n) 对数时间]
    B --> E[O(n) 线性时间]
    B --> F[O(n log n) 线性对数时间]
    B --> G[O(n^2) 平方时间]
例如,冒泡排序的时间复杂度为O(n^2),而二分查找的时间复杂度为O(log n)。
空间复杂度
空间复杂度指的是算法在运行过程中临时占用存储空间大小的增长趋势。它同样用大O符号表示。
graph TD
    A[存储空间占用] --> B[空间复杂度]
    B --> C[O(1) 常数空间]
    B --> D[O(n) 线性空间]
    B --> E[O(n^2) 平方空间]
    B --> F[O(2^n) 指数空间]
例如,冒泡排序的空间复杂度为O(1),因为它只需要固定数量的额外空间。而深度优先搜索算法在最坏情况下可能需要O(n)的空间复杂度,因为它可能需要保存整个递归调用栈。
通过分析和优化数据结构与算法,嵌入式开发者能够大幅提升系统性能,优化资源使用,从而构建出更高效、更可靠的嵌入式应用。下一章将介绍嵌入式系统硬件接口编程与固件更新,以及调试工具与版本控制的使用。
4. 嵌入式系统硬件接口编程与固件更新
4.1 硬件接口编程基础
4.1.1 GPIO、I2C、SPI等接口的编程实践
通用输入输出(GPIO)是嵌入式系统中最常见的硬件接口之一,允许开发者控制和读取设备的数字信号。GPIO口可以被配置为输入或输出模式,并可应用于按钮控制、LED指示灯控制等场景。
// 示例:配置GPIO为输出模式,并输出高电平信号
#include <stdio.h>
#include <wiringPi.h>

// 定义引脚编号,此处以wiringPi库编号为例
const int LED_PIN = 1; // 假设我们使用引脚1作为LED控制引脚

int main(void) {
    // 初始化wiringPi库
    if (wiringPiSetup() == -1) {
        printf("wiringPi setup failed\n");
        return -1;
    }
    // 设置引脚模式为输出
    pinMode(LED_PIN, OUTPUT);
    // 输出高电平信号,点亮LED
    digitalWrite(LED_PIN, HIGH);
    // 延时3秒
    delay(3000);
    // 输出低电平信号,熄灭LED
    digitalWrite(LED_PIN, LOW);
    return 0;
}
该代码示例展示了如何使用wiringPi库配置一个GPIO引脚并控制LED灯的开关。代码中包含了必要的头文件引入、错误处理、引脚初始化、模式配置、信号控制等步骤。
I2C(Inter-Integrated Circuit)是一种串行通信协议,常用于微控制器与其他低速外围设备之间的通信,例如温度传感器、实时时钟模块等。I2C接口具有主机和从机两种工作模式,允许多个从设备共用同一总线。
// 示例:使用I2C接口读取温度传感器数据
#include <linux/i2c-dev.h>
#include <sys/ioctl.h>
#include <fcntl.h>
#include <stdio.h>
#include <unistd.h>

// 假设传感器地址为0x48,温度寄存器地址为0x01
const char *filename = "/dev/i2c-1"; // I2C设备文件
const int addr = 0x48; // 传感器设备地址
const int reg = 0x01; // 寄存器地址

int main() {
    int file;
    unsigned char value;
    unsigned char buf[2] = { reg };

    if ((file = open(filename, O_RDWR)) < 0) {
        printf("Failed to open the i2c bus\n");
        exit(1);
    }

    if (ioctl(file, I2C_SLAVE, addr) < 0) {
        printf("Failed to acquire bus access and/or talk to slave\n");
        exit(1);
    }

    if (write(file, buf, 1) != 1) {
        printf("Failed to write to the i2c bus\n");
        exit(1);
    }

    if (read(file, &value, 1) != 1) {
        printf("Failed to read from the i2c bus\n");
        exit(1);
    }

    printf("Sensor value: %d\n", value);

    close(file);
    return 0;
}
该代码示例展示了如何使用Linux下的 i2c-dev 接口读取连接在I2C总线上的温度传感器数据。
串行外设接口(SPI)是一个常用的同步串行数据链接标准,适用于微处理器与各种外围设备之间的数据传输。SPI通信有多个引脚,包括SCK(时钟线)、MISO(主设备输入从设备输出)、MOSI(主设备输出从设备输入)和CS(片选线)。
// 示例:使用SPI接口发送和接收数据
#include <stdio.h>
#include <stdlib.h>
#include <stdint.h>
#include <unistd.h>
#include <fcntl.h>
#include <linux/spi/spidev.h>

int main() {
    int spi_handle;
    uint8_t tx[] = { 0xAA, 0xBB, 0xCC, 0xDD }; // 待发送数据
    uint8_t rx[4]; // 用于接收数据的缓冲区

    spi_handle = open("/dev/spidev0.0", O_RDWR); // 打开SPI设备文件

    if (spi_handle < 0) {
        printf("Failed to open SPI device.\n");
        return -1;
    }

    // SPI数据传输
    struct spi_ioc_transfer transfer = {
        .tx_buf = (unsigned long)tx,
        .rx_buf = (unsigned long)rx,
        .len = sizeof(tx),
        .delay_usecs = 1,
        .speed_hz = 500000,
        .bits_per_word = 8,
    };

    int status = ioctl(spi_handle, SPI_IOC_MESSAGE(1), &transfer); // 执行传输操作
    if (status < 0) {
        printf("SPI transfer error: %s\n", strerror(errno));
    } else {
        printf("SPI transfer status: %d\n", status);
        printf("Received: %02x %02x %02x %02x\n", rx[0], rx[1], rx[2], rx[3]);
    }

    close(spi_handle); // 关闭SPI设备文件
    return 0;
}
该代码示例展示了如何通过Linux下的 spidev 接口与SPI设备进行数据传输。
4.1.2 并行和串行通信协议的嵌入式实现
并行通信和串行通信是两种常见的数据传输方式。并行通信通常用于微处理器和高速外围设备之间的通信,比如连接到微处理器的打印机或大容量存储设备。串行通信则适合于远距离或低速设备之间的通信。
并行通信涉及多个数据线同时传输数据,因此传输速度快,但硬件复杂度高,距离较短。串行通信只使用一对线就可以进行数据传输,降低了成本和复杂度,但传输速度相对较慢。在嵌入式系统设计中,根据具体应用场景和性能要求选择合适的通信方式至关重要。
4.2 固件更新机制的设计
4.2.1 固件升级流程和策略
固件升级是指将新版本的程序代码写入到嵌入式设备的存储器中,这个过程对产品的可靠性和用户体验至关重要。固件升级流程通常涉及以下步骤:
- 版本检查 :设备启动时,首先检查当前固件版本。
- 远程升级请求 :设备与服务器通信,获取固件更新状态,如果发现新版本,则下载更新。
- 升级前准备 :确保设备电量充足或连接电源,并且有足够的存储空间用于升级。
- 下载固件 :从服务器下载新固件文件到本地存储。
- 固件验证 :验证下载的固件文件的完整性和安全性。
- 备份重要数据 :在升级前,系统可能需要备份用户数据。
- 固件擦写 :将旧固件从存储中擦除,并写入新固件。
- 重启验证 :升级完成后设备重启,检查新固件是否正常工作。
固件升级策略可能包括:
- 增量升级 :只下载和更新改动的部分,以减少数据传输量。
- 全量升级 :下载并更新整个固件。
- 回滚机制 :在新固件出现兼容性问题时,可以恢复到旧版本固件。
- 远程管理 :通过远程管理功能,可以远程控制固件升级,实现集中管理。
4.2.2 多版本固件管理与安全更新方法
多版本固件管理是为了确保设备在升级过程中仍然可以安全地回滚到之前的版本。为实现这一点,开发者通常需要保持旧版本固件的可用性,直至确认新版本固件完全稳定。
安全更新方法是确保整个固件升级过程的安全性,避免固件升级过程中的意外情况导致设备损坏或被恶意攻击。安全更新的关键措施包括:
- 签名验证 :对固件进行数字签名,确保固件来源的合法性。
- 加密传输 :通过加密方式传输固件数据,防止数据在传输过程中被截获或篡改。
- 写保护 :在非升级模式下,对固件存储区域进行写保护,避免非法程序修改固件。
- 安全引导 :启动时验证固件的签名,确保启动的固件是经过验证的版本。
- 在线状态检查 :在升级前检查设备的在线状态,确保升级指令只在网络连接稳定时执行。
为了更好地管理多版本固件,开发人员可以采用版本控制策略,例如使用版本号来标识固件。固件的版本号通常包括主版本号、次版本号和修订号,这样可以通过版本号来区分新旧版本,并根据需要进行相应的回滚操作。
总结:
本章节深入探讨了嵌入式系统硬件接口编程以及固件更新机制的设计。我们从GPIO、I2C和SPI等常见硬件接口的编程实践开始,逐步过渡到并行和串行通信协议的嵌入式实现。继而,我们探索了固件升级流程和策略,确保系统稳定性和安全性。在多版本固件管理和安全更新方法中,我们讨论了如何安全地管理不同版本的固件,以及如何保护升级过程免受未授权操作的影响。本章内容为嵌入式开发者提供了硬件编程和固件升级的深入知识,帮助他们打造更安全、更可靠的嵌入式产品。
5. 调试工具与版本控制的使用
5.1 调试工具的选用和实践
5.1.1 JTAG、SWD调试接口的使用
JTAG(Joint Test Action Group)和SWD(Serial Wire Debug)是嵌入式开发中常用的调试接口,它们提供了访问处理器内部调试资源的途径。JTAG接口是基于边界扫描技术的标准,广泛用于芯片级别的调试和测试。SWD是ARM公司推出的一种简化版JTAG,它使用两根线(SWDIO和SWCLK)进行调试数据的传输,比传统JTAG占用更少的引脚,从而节省了芯片资源。
使用JTAG调试时,需要连接相应的硬件调试器,例如J-Link或ULINK,将调试器的接口与目标开发板的JTAG接口相连。调试器会识别连接到目标处理器上的调试接口,并允许开发者执行单步执行、设置断点、读写内存等调试操作。
SWD调试接口相较于JTAG来说更为简单高效,尤其在资源紧张的嵌入式系统中,SWD提供了一个更优的选择。例如在STM32系列微控制器中,通过SWD接口可以快速地进行程序下载、调试和仿真操作。
在使用JTAG或SWD接口进行调试时,开发者需要确保调试器驱动程序正确安装,且目标开发板上的调试接口没有物理损坏或连接不当的问题。调试前,通常建议开发者使用“硬件检测”功能验证硬件连接的稳定性。
代码块示例与解释:
# 使用OpenOCD软件启动JTAG调试会话
openocd -f interface/jlink.cfg -c "transport select jtag" -f target/stm32f4x_stlink.cfg
在上述代码块中,我们使用了OpenOCD软件和jlink配置文件( -f interface/jlink.cfg )来启动一个调试会话。通过 transport select jtag 命令选择了JTAG传输模式,并且使用 target/stm32f4x_stlink.cfg 文件配置了针对特定目标(如STM32F4系列)的调试设置。这个调试会话将允许开发者与目标处理器建立连接并执行调试任务。
# 在调试过程中通过GDB进行单步执行和寄存器检查
(gdb) step
(gdb) info registers
以上是GDB(GNU Debugger)中常见的调试命令。执行 step 命令可以使程序执行到下一行代码,并在有函数调用时单步进入函数内部。而 info registers 命令则可以用来查看处理器的当前寄存器状态。
5.2 版本控制系统的应用
5.2.1 Git等版本控制系统的选择与配置
版本控制系统是软件开发中的重要工具,它帮助团队成员管理和跟踪代码的变更,便于协同工作。Git由于其出色的性能、分布式架构和强大的分支管理功能,在业界被广泛使用。
Git的配置可以分为本地配置和全局配置。本地配置仅对当前仓库有效,而全局配置则会影响到所有使用同一用户账户的Git仓库。通常,开发者会设置用户信息和编辑器偏好:
# 设置用户信息,这将对本地仓库生效
git config --local user.name "Your Name"
git config --local user.email "your-email@example.com"

# 设置用户信息,这将对全局所有仓库生效
git config --global user.name "Your Name"
git config --global user.email "your-email@example.com"
表格示例:
| 配置命令 | 描述 | |---------------------------------|---------------------------------------------| | git config --local user.name | 设置当前仓库的用户名 | | git config --local user.email | 设置当前仓库的用户邮箱 | | git config --global user.name | 设置全局用户名,影响用户的所有Git仓库 | | git config --global user.email | 设置全局邮箱,影响用户的所有Git仓库 | | git config --system core.editor | 设置系统范围内使用的文本编辑器,适用于所有用户的所有仓库 |
在实际工作中,为了有效地管理分支,Git提供了丰富的分支管理功能:
# 创建并切换到新分支
git checkout -b new-branch

# 合并分支到当前分支
git merge another-branch

# 将分支的变更推送到远程仓库
git push origin my-branch
Mermaid流程图示例:
graph LR
    A[开始] --> B[创建本地仓库]
    B --> C[提交更改]
    C --> D[连接到远程仓库]
    D --> E[推送更改到远程]
    E --> F[协作开发]
    F --> G[拉取并合并远程分支]
    G --> H[结束]
版本控制系统的有效使用,有助于开发者维护项目的健康和代码的质量,尤其是在多人协作的大型项目中。理解并熟练使用Git等版本控制系统,是现代软件开发者的必备技能之一。
6. 软件工程实践在嵌入式开发中的应用
6.1 软件开发生命周期
在嵌入式系统的开发中,软件开发生命周期(SDLC)是管理软件从概念到退役整个过程的一套方法和步骤。SDLC包括需求分析、系统设计、实现(编码)、测试、部署、维护和支持等阶段。
6.1.1 需求分析与系统设计的实践
需求分析阶段涉及与利益相关者沟通,以确定软件必须满足的要求。此阶段通常包括以下步骤:
- 收集需求: 识别用户需求和系统需求,包括功能性和非功能性需求。
- 需求规格说明: 详细记录需求并形成文档。
- 需求验证: 确保需求是完整、一致且可实现的。
系统设计 则关注如何根据需求来构建软件。它包括:
- 架构设计: 设计软件的整体结构,决定技术栈和组件划分。
- 接口设计: 确定系统中各模块如何交互。
- 数据设计: 规划数据的存储、访问和管理方式。
在这一部分,代码示例和参数说明不如实际的流程图来得有效。因此,通常会使用如Mermaid流程图来描述需求分析和系统设计的流程。
graph TD
    A[开始] --> B[需求收集]
    B --> C[需求规格说明]
    C --> D[需求验证]
    D --> E[架构设计]
    E --> F[接口设计]
    F --> G[数据设计]
    G --> H[编码实现]
    H --> I[系统测试]
    I --> J[部署与维护]
6.1.2 编码标准和代码审查过程
编码是软件开发的核心部分,而编码标准是保证代码质量、可读性和一致性的关键。嵌入式开发中的编码标准可能包括:
- 命名约定: 规定变量、函数和模块的命名规则。
- 代码布局: 指定代码的缩进、空格、括号使用等格式规范。
- 注释规范: 指导如何写注释以提高代码的可读性。
代码审查是团队协作中的一种质量保证活动,旨在检查代码变更是否满足代码标准和设计要求。审查过程中,其他开发者会对代码进行分析,并提供改进建议。代码审查通常借助工具进行,比如Gerrit或CodeReview。
在实际操作中,我们可以使用下面的代码块展示嵌入式编程的一个简单示例,并分析其代码风格是否符合标准。
#include <stdio.h>

int main(void) {
  printf("Hello, Embedded World!\n");
  return 0;
}
该代码块是一个嵌入式C程序的典型例子,它展示了以下几点:
- 包含标准输入输出头文件
#include <stdio.h>。 -
main函数作为程序的入口点。 - 使用
printf进行输出。 -
return 0;表示程序正常退出。
在实际的代码审查中,会检查此类代码是否遵循团队或公司的编码规范,例如函数名是否大小写一致,大括号风格是否正确,还有代码的注释是否充分等。
6.2 持续集成和自动化测试
6.2.1 持续集成的工具与流程
持续集成(CI)是一种软件开发实践,开发人员频繁地(通常是每天多次)将代码集成到共享的仓库中。每次集成都通过自动化构建(包括编译、测试等)来验证,从而尽早发现集成错误。CI的实施通常依赖于专门的工具,如Jenkins、Travis CI或GitLab CI/CD。
持续集成的流程一般如下:
- 版本控制: 开发人员将代码变更提交到版本控制系统。
- 自动化构建: CI工具运行构建脚本,编译代码。
- 自动化测试: 执行单元测试、集成测试等。
- 结果反馈: 如果构建或测试失败,CI工具会通知相关人员。
6.2.2 自动化测试框架和测试用例设计
自动化测试框架提供了编写测试脚本、执行测试和生成测试报告的基础设施。它提高了测试的效率和可靠性。在嵌入式开发中常用的自动化测试框架包括Unity(针对C语言)、Google Test(针对C++)等。
设计测试用例需要遵循特定的方法和原则,如等价类划分、边界值分析等。测试用例应覆盖所有功能点,并且要特别注意资源受限的嵌入式环境。测试用例设计还应该能适应持续集成的流程。
对于测试框架的使用,下面的代码块展示了如何使用C语言的Unity测试框架进行简单的单元测试:
#define UNITY_INCLUDE_DOUBLE
#define UNITY_ENABLE我が家
#include "unity.h"

void test_my_function(void) {
  TEST_ASSERT_EQUAL_INT(42, my_function(21));
}

int main(void) {
  UNITY_BEGIN();
  RUN_TEST(test_my_function);
  return UNITY_END();
}
该代码块展示了以下几个关键点:
- 引入了Unity测试框架。
-
TEST_ASSERT_EQUAL_INT用于验证两个整数是否相等。 -
RUN_TEST宏用于执行一个测试函数。 -
main函数负责初始化测试环境并启动测试。
在测试用例设计中,需确保测试用例能覆盖所有正常情况和边界条件,以确保嵌入式软件的可靠性和健壮性。
此章节的详细内容涵盖了软件开发生命周期中的需求分析与系统设计,以及持续集成和自动化测试在嵌入式开发中的应用。通过对这些核心流程的分析,我们可以看到它们对于软件质量的保障和提升的重要性。在嵌入式开发的实践中,通过合理应用这些实践可以大大提高项目的成功率和软件的稳定性。
7. 特定领域知识在嵌入式开发中的应用
在当今这个快速发展的技术世界中,嵌入式系统已经成为了许多特定领域中不可或缺的一部分。本章节将着重介绍物联网(IoT)技术和自动驾驶与工业自动化在嵌入式开发中的应用。
7.1 物联网(IoT)技术
物联网(IoT)技术已逐步渗透到日常生活的方方面面,从智能家居、智能城市到工业物联网(IIoT),无一不是物联网技术的体现。嵌入式系统作为IoT设备的心脏,其设计和开发的复杂性不言而喻。
7.1.1 IoT设备的嵌入式开发要点
在开发IoT设备时,开发者需要考虑设备的低功耗特性、通信协议的选择、数据处理与存储、以及设备的安全性。例如,使用低功耗的蓝牙(BLE)技术可以显著延长设备的使用寿命。同时,确保数据通过安全的通信协议传输,如TLS/SSL,是至关重要的。此外,嵌入式设备通常资源有限,数据处理和存储必须在保证效率的同时尽可能地减少资源消耗。
7.1.2 安全通讯协议和数据加密技术
物联网设备经常与网络接口进行通信,这就产生了数据被截获或篡改的风险。因此,使用加密技术保护数据传输的安全性变得尤为重要。例如,使用AES加密算法对传输的数据进行加密,并且通过TLS/SSL等安全协议确保数据的传输通道的安全。开发者需要评估加密算法对设备性能的影响,并在安全性和性能之间找到平衡点。
#include <openssl/aes.h>
#include <openssl/rand.h>

// AES加密示例函数
void encrypt_aes(const unsigned char *plaintext, int plaintext_len,
                 unsigned char *ciphertext, const unsigned char *key) {
    AES_KEY aes_key;
    AES_set_encrypt_key(key, 128, &aes_key);
    AES_cbc_encrypt(plaintext, ciphertext, plaintext_len, &aes_key, iv, AES_ENCRYPT);
}
7.2 自动驾驶与工业自动化
随着技术的发展,嵌入式系统也被广泛应用于自动驾驶车辆和工业自动化领域。这些领域对系统性能、可靠性和实时性有着极高的要求。
7.2.1 嵌入式系统在自动驾驶中的角色
自动驾驶车辆需要实时处理来自传感器的大量数据,如摄像头、雷达和激光雷达(LIDAR)数据。嵌入式系统需要具备强大的数据处理能力,以及能够响应时间敏感事件的能力。此外,为了确保自动驾驶系统的可靠性,通常会采用冗余设计和故障检测机制。
7.2.2 工业自动化中的嵌入式应用案例分析
在工业自动化领域,嵌入式系统是实现设备互联、生产过程监控和数据分析的核心。例如,在一个制造厂中,嵌入式控制器可以实时监测生产线上的设备状态,通过物联网技术发送数据到中央控制系统,实现设备状态的实时监控和故障预警。这种实时的数据处理与分析能力对于提高生产效率和保证生产安全至关重要。
graph LR
    A[传感器] -->|数据| B(嵌入式控制器)
    B -->|控制信号| C[机械设备]
    B -->|数据传输| D[中央控制系统]
    D -->|指令| B
在分析了物联网技术在嵌入式开发中的应用以及自动驾驶和工业自动化领域中嵌入式系统的作用之后,我们可以看到嵌入式系统已经深入到了现代技术的各个层面。在下一章节中,我们将探讨调试工具与版本控制系统的应用,它们是保障嵌入式系统开发质量的重要因素。
简介:嵌入式软件工程师专注于在嵌入式系统上开发、优化软件。这份笔试资料集涵盖了操作系统、C/C++编程、数据结构、硬件接口编程等多个关键学习领域。学习资料详细介绍了RTOS、内存管理、中断处理、数据结构的选择与算法实现,以及嵌入式系统开发的其他重要方面,如固件更新和版本控制。掌握这些内容对于准备笔试和提升开发技能至关重要。
更多推荐


 13
 0
- 0


 已为社区贡献23条内容

所有评论(0)