
Jetson Orin平台搭建部署yolov5(一)
1. 最近英伟达召开的面向开发者的2024年全球人工智能(GTC)大会可谓是赚足了眼球,其中发布了地表最强芯片—B200,推出了面向人工智能模型的新一代Blackwell GPU架构,以及基于此架构的新一代AI加速卡—GB200,这是一款“巨大的超级芯片”,将两个英伟达B200 Tensor Core GPU连接到英伟达Grace CPU上。除此之外,英伟达还发布了“Jetson Thor”平台,这是一款用于人形机器人的新型计算机,具有AI功能,是其人工智能驱动机器人计划的一部分。(ps:看到机器人的模样有没有想到电影《机器人总动员》里面的瓦力。)
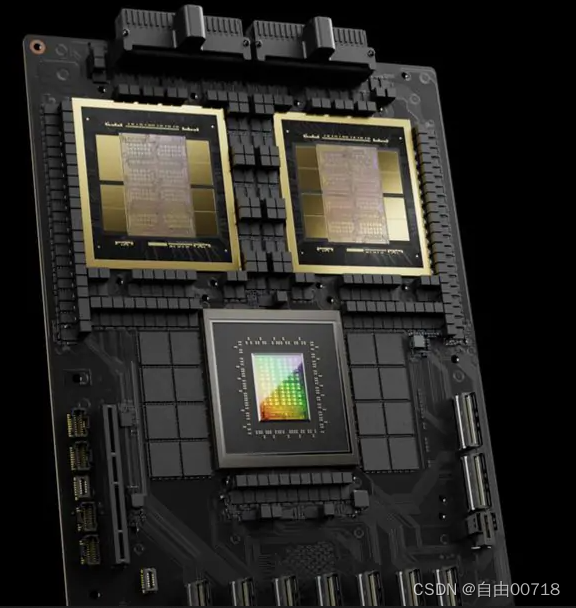
GB200 =两个GPU+1个CPU+电路板
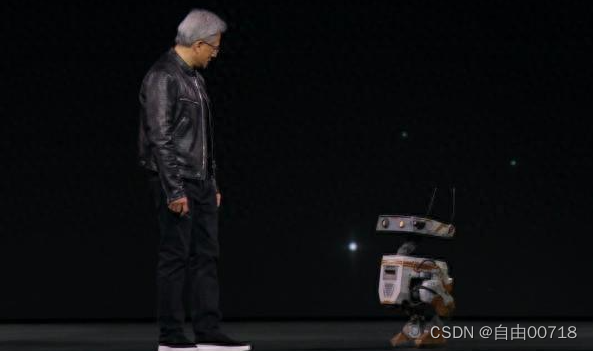
2. 借次机会记录一下之前学习过Jetson平台在上面安装过Pytorch的AI框架,以及基于目标物体检测的Yolov5应用。本例以Jetson AGX Orin Jetpack5.1.2为例搭建cuda环境,TensorRT等。
3.首先安装了Jetpack的os中都会在/etc/apt/sourch.list.d/中带有nvidia-l4t-apt-source.list文件,里面包含了需要安装基础环境的源路径,不用在单独去下载cuda,cudnn,tensorRT安装包,而且单独下载经过测试存在兼容性问题。而且官方release的包大多是针对arm64-sbsa平台,不是适配Jetson平台,这里需要区分一下。
# SPDX-FileCopyrightText: Copyright (c) 2019-2021 NVIDIA CORPORATION & AFFILIATES. All rights reserved.
# SPDX-License-Identifier: LicenseRef-NvidiaProprietary
#
# NVIDIA CORPORATION, its affiliates and licensors retain all intellectual
# property and proprietary rights in and to this material, related
# documentation and any modifications thereto. Any use, reproduction,
# disclosure or distribution of this material and related documentation
# without an express license agreement from NVIDIA CORPORATION or
# its affiliates is strictly prohibited.

deb https://repo.download.nvidia.com/jetson/common r35.4 main
deb https://repo.download.nvidia.com/jetson/<SOC> r35.4 main
nvidia-l4t-apt-source.list
这里只需将<SOC>修改为t234即可,对于Jetson Orin系列对应t234,Jetson Xavier系列对应t194。
4. 更改完成后,接下来就需要更新源和下载了。
apt update;apt install cuda-11-4 libfreeimage-dev libcudnn8 libcudnn8-dev
libcudnn8-samples tensorrt tensorrt-dev tensorrt-libs python3-libnvinfer
python3-libnvinfer-dev uff-converter-tf onnx-graphsurgeon
graphsurgeon-tf deepstream-6.3
5. 下载安装Pytorch,使用pip3工具下载软件包【加-i参数可以指定国内下载源】
PyTorch for Jetson:使用论坛已经提供好的whl文件,如果没有则需要下载torch源码编译安装了。
apt install python3-pip libopenblas-dev

python3 -m pip install aiohttp opencv-python scipy=='1.5.3' -i https://pypi.tuna.tsinghua.edu.cn/simple

pip3 install ./torch-2.1.0a0+41361538.nv23.06-cp38-cp38-linux_aarch64.whl -i https://pypi.tuna.tsinghua.edu.cn/simple
6. 安装torchvision
torchvision是PyTorch中专门用来处理图像的库,包含数据集、模型、转换函数等。
# 安装编译torchvision所需依赖包
apt install ffmpeg libavutil-dev libavcodec-dev libavformat-dev
libavdevice-dev libavfilter-dev libswscale-dev libswresample-dev
libswresample-dev libpostproc-dev libjpeg-dev libpng-dev

# 下载torchvision源码
git clone https://github.com/pytorch/vision torchvision

# 编译torchvision
python3 setup.py install

# 利用编译成功的源码生成*.whl文件,生成文件路径在/源码根目录/dist/
python3 setup.py bdist_wheel
7. 验证torch和torchvision是否安装成功,如果输出计算结果则安装成功。
import torch
 36 >>> print(torch.__version__)
 37 >>> print('CUDA available: ' + str(torch.cuda.is_available()))
 38 >>> print('cuDNN version: ' + str(torch.backends.cudnn.version()))
 39 >>> a = torch.cuda.FloatTensor(2).zero_()
 40 >>> print('Tensor a = ' + str(a))
 41 >>> b = torch.randn(2).cuda()
 42 >>> print('Tensor b = ' + str(b))
 43 >>> c = a + b
 44 >>> print('Tensor c = ' + str(c))
 45
 46 >>> import torchvision
 47 >>> print(torchvision.__version__)
8. 下载yolov5网络模型
# 安装依赖环境
pip3 install gitpython==3.1.30 numpy==1.22.2 setuptools==65.5.1 -i https://pypi.tuna.tsinghua.edu.cn/simple
pip3 install onnx onnxruntime opencv-python ultralytics -i https://pypi.tuna.tsinghua.edu.cn/simple

wget https://github.com/ultralytics/yolov5/releases/download/v7.0/yolov5s.pt

git clone https://github.com/ultralytics/yolov5.git
【备注:yolov5s.pt, yolov5m.pt, yolov5l.pt,yolov5x.pt, yolov5n.pt是YOLOV5的不同变体,表示不同大小和复杂性的模型】
9. 部署运行yolov5模型,运行结果生成文件在runs/detect目录下。
python3 detect.py --weights yolov5s.pt
YOLOv5 🚀 v7.0-231-gc2f131a Python-3.8.10 torch-2.1.0a0+41361538.nv23.06 CUDA:0 (Orin, 14533MiB)
Fusing layers...
YOLOv5s summary: 213 layers, 7225885 parameters, 0 gradients
image 1/2 /mnt/yolov5/data/images/bus.jpg: 640x480 4 persons, 1 bus, 211.0ms
image 2/2 /mnt/yolov5/data/images/zidane.jpg: 384x640 2 persons, 2 ties, 218.8ms
Speed: 3.3ms pre-process, 168.0ms inference, 10.5ms NMS per image at shape (1, 3, 640, 640)
Results saved to runs/detect/exp
10. 自定义训练数据集
a. 下载数据集图片素材,然后通过labelImg或labelme工具进行不分类标注, 使用标注工具标记图像后,将标签导出为YOLO格式,
每张*.txt图像一个文件(如果图像中没有对象,则不需要*.txt文件)
生成images/和labels/:
--> imaegs/:里面存放素材图片
--> labels/:里面存放标注的*.txt文件,
--> 文件*.txt规格,包含class x_center y_center width height(类 标注x坐标 标注y坐标 宽度 高度)
b. 准备custom.yaml,放置yolov5/data/目录下: yaml里面指定YOLOv5的images,labels目录位置以及有关我们的自定义类的信息
Example(data/custom.yaml):
path: ../datasets/hard-hat
train: train/images
val: valid/images
test: test/images
nc: 3
names: ['head', 'helmet', 'person']
【备注:另外一种方法直接在Roboflow网站上下载标注好的数据集,里面有已经生成好的images和labels,data.yaml(重命名custom.yaml)】
c. 接下来为自定义对象检测器编写模型配置文件,选择了最小、最快的 YOLOv5 基础模型-yolov5s.pt
cp yolov5/models/yolov5s.yaml yolov5/models/custom.yaml //拷贝标准网络结构,来设置自定义的网络结构
编辑网络的结构, 修改custom.yaml里面的【nc:】, 和data/custom.yaml的nc一致, 适配自定义数据集
d. 准备好以上文件后就可以开始训练
python3 train.py --data=data/custom.yaml --img 640 --epochs 300 --cfg=models/custom-yolov5s.yaml --weights weights/yolov5s.pt
--data 设置我们数据集yaml文件的路径
--img 定义输入图像大小
--epochs 定义训练时期的数量
--cfg 指定我们的模型yaml配置路径
--weights 指定权重的自定义路径
--name 结果名称
--nosave 只保存最后的检查点
--cache ram or disk 缓存图像以加快训练速度,需要大量 RAM/磁盘资源
未完待续...
更多推荐

 31
 0
- 0


 已为社区贡献3条内容

所有评论(0)