
mysql-索引1
一 简介
MySql的索引是一种数据结构。它可以帮助数据库高效地查询、更新数据表中的数据。它类似于书籍的目录,通过指向数据行的位置,可以快速定位和访问表中的数据。
那为什么使用索引呢?
主要就是提升数据检索的效率
刚才提到索引是一种数据结构,那它选择的是哪种数据结构呢?让我们一个一个地来看一下吧
二 索引数据结构的选择
1 HASH
它的时间复杂度是O(1),感觉非常适合。但是它不支持范围查找
2 二叉搜索树
它支持范围查找,但它的时间复杂度在单边树的时候为O(N),因为节点个数过多时,树的高度无法保证,磁盘IO的次数就会变得很多。因为数据库中的数据都是在磁盘上保存的,每访问一次子节点,就会发生一次磁盘IO,磁盘IO是制约数据库性能的主要因素
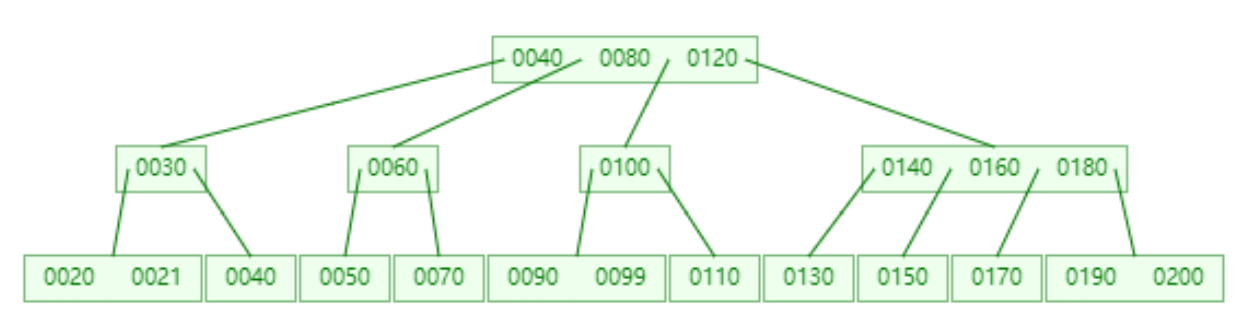
3 N叉树
它的每个节点可以有超过两个的子节点,可以解决树高的问题。它的时间复杂度是O(logN),在数据量相同的情况下,可以有效的控制树高,也就是说可以使用更少的IO次数找到目标节点,从而提高数据库的效率。但是这个还是不够好,看看下一个(下一个更乖,哈哈)
比如:
4 B+树
B+树是一种经常用于数据库和文件系统等场合的平衡查找树,这就是MySql索引采用的数据结构。它的时间复杂度也是O(logN),可以有效的控制树高
比如:
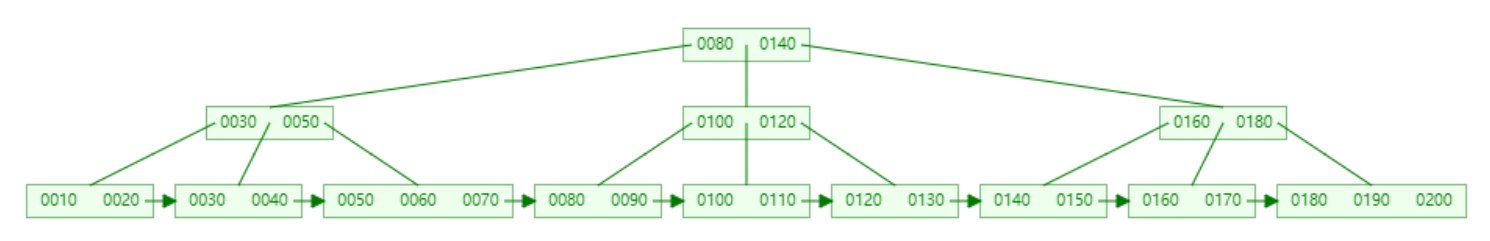
它的特点如下:
1)叶子节点之间有一个相互连接的引用(看图),可以通过一个叶子节点找到它相近的兄弟节点。MySql在组织叶子节点时使用的是双向链表(上面的图是单向的,应该是双向的)。
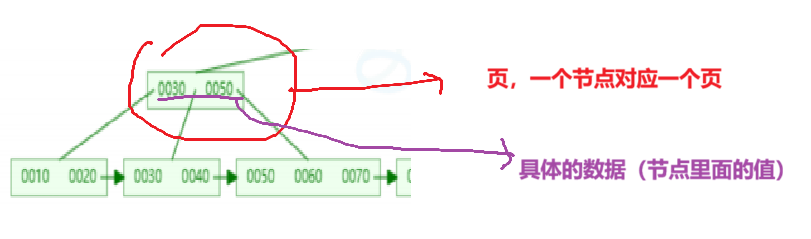
三 MySql中的页
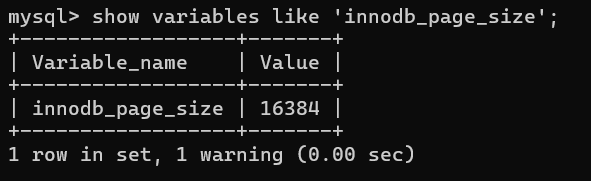
1 简介
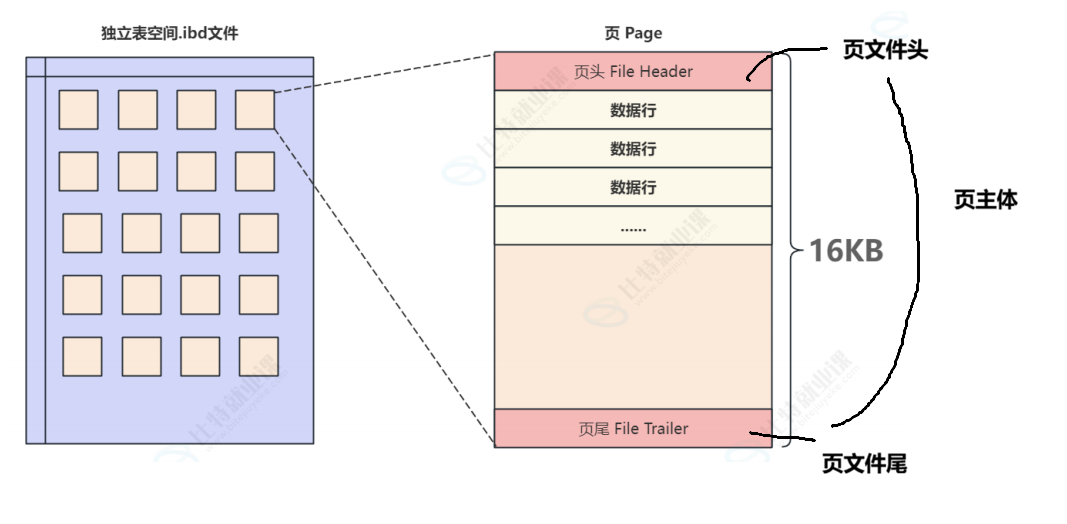
2 页文件头和页文件尾
表示当前页文件的主要信息。这里只关注,上一页页号和下一页页号,通过这两个属性可以把页与页之间连接起来,形成一个双向链表(通过页号和页大小,可以计算出下一页和上一页在磁盘上的偏移量)
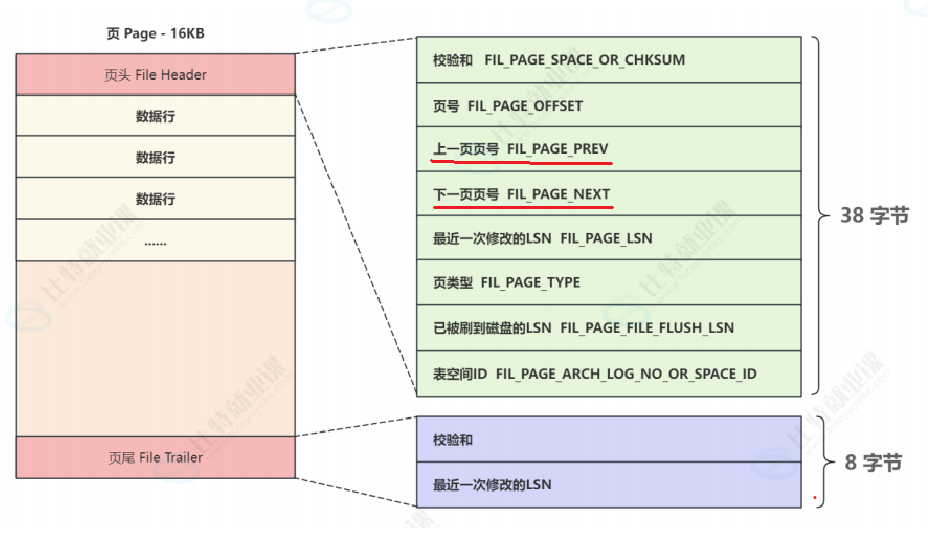
3 页主体
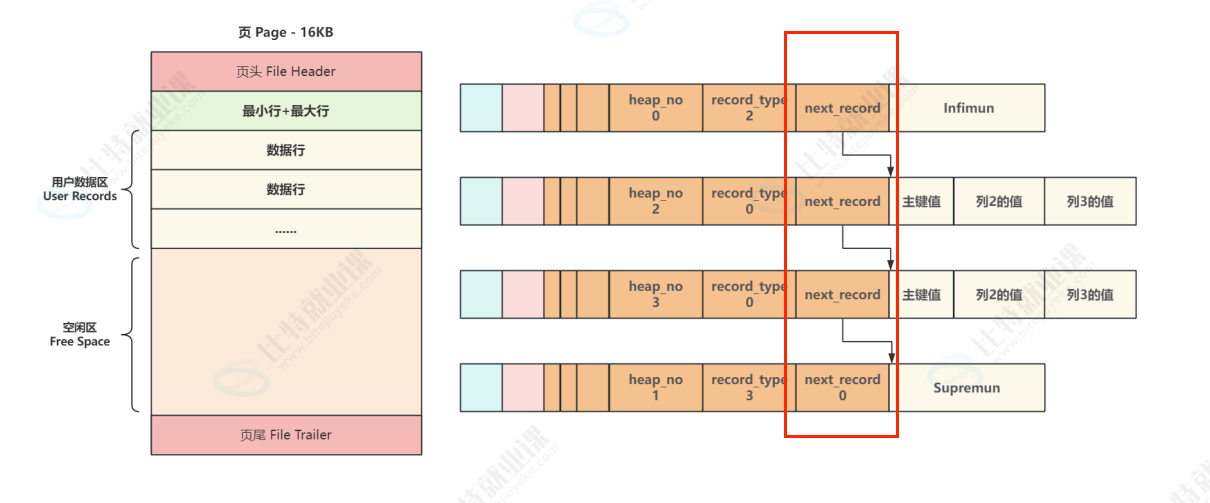
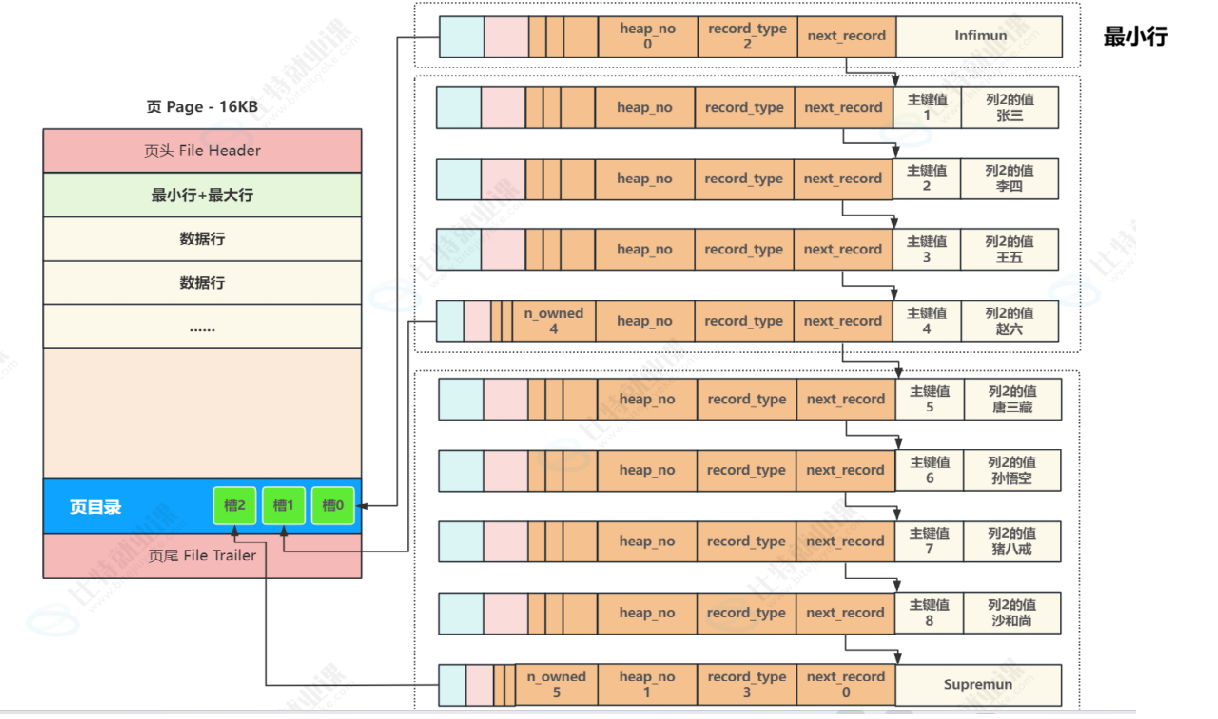
页主体是保存真实数据的主要区域,每当创建一个新页,都会自动分配两个行,一个是页内最小行Infimun,另一个是页内最大行 Supremun,这两个行并不存储任何真实信息,而是作为数据行链表的头和尾,第一个数据行有一个记录下一行的地址偏移量的区域next_record,将页内所有数据行组成了一个单向链表,新页(没有数据)结构如下:
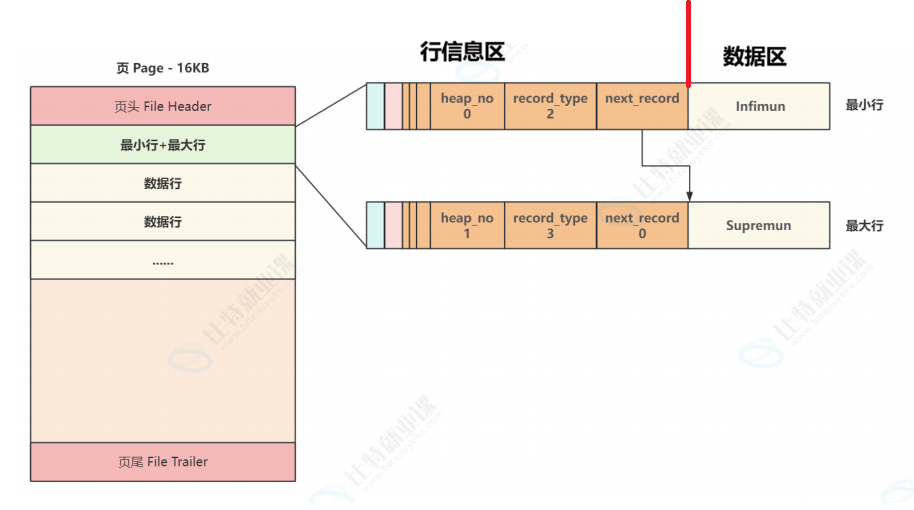
此时,插入数据时,将Infimun连接第一个数据行,最后一行真实数据行连接Supremun,这样数据行就成了一个单向链表,更多的行插入之后,会按照主键从小到大的顺序进行连接
图:
这是就会有疑问了:单向链表,数据过多的时候,查起来的时候也麻烦,怎么办呢?
页目录:
4 页目录
在每一个页中加入页目录的结构,将页内所有行进行分组,其中,最小行单独为一组,其他每个组最多8条数据,超过8条时会分裂出来一个新组,最大行永远在最后一个分组中。同时把每个组最后一行在页中的地址,按主键从小到大的顺序记录在页目录中,页目录中的每一个位置称为一个槽,槽的数量与分组的数据是一致的
1)找到这条记录所在的页、
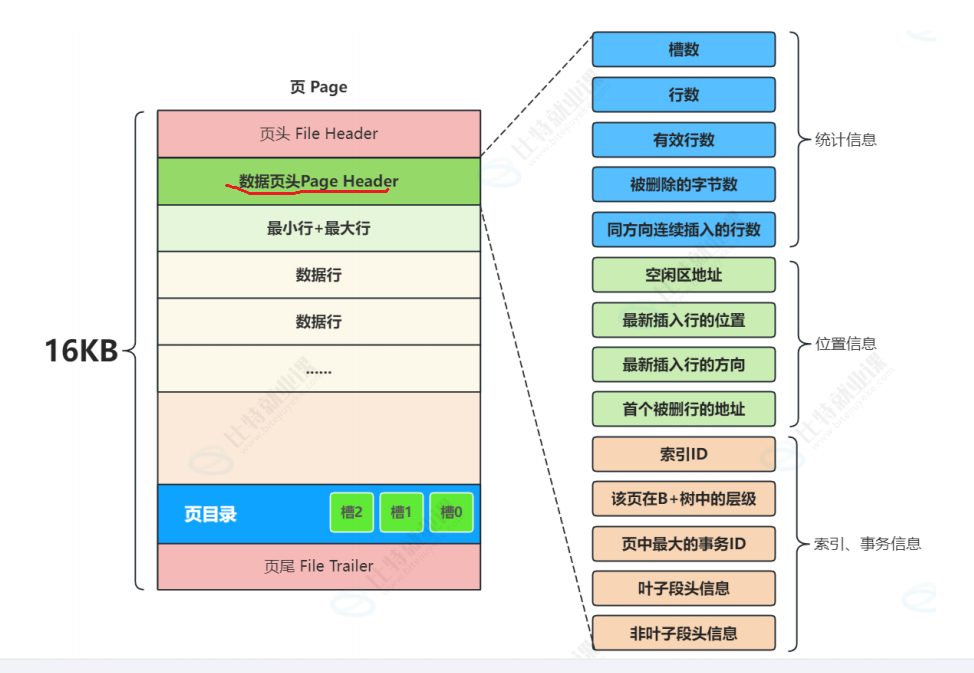
5 数据页头
记录了当前页保存数据相关的信息
6 B+树在索引中的应用
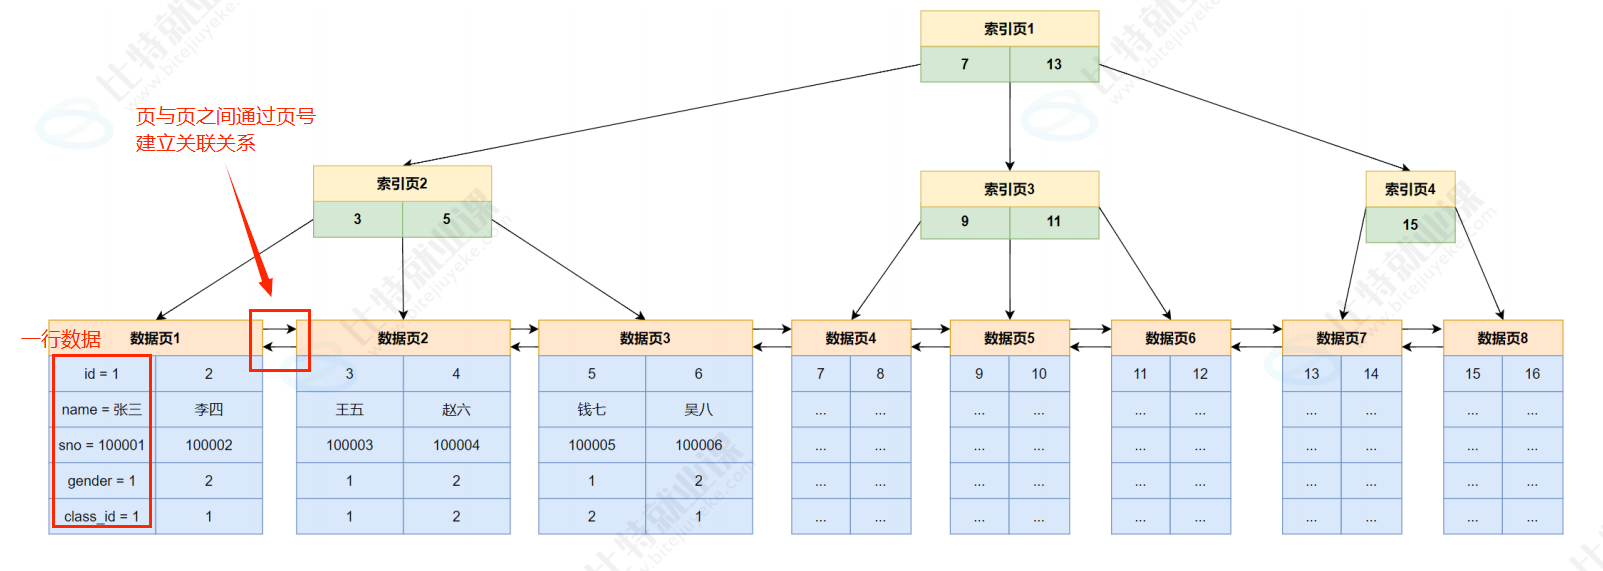
索引页保存的是主键的值和子节点的引用,非叶子节点记录的是索引信息
叶子节点存储的是真实数据,数据页保存的是具体数据,叶子节点最终形成了一个双向循环链表
值得注意的是,所有关于页的访问和操作都是在内存中进行的
加载索引页1 -> 加载索引页2 -> 加载数据页3 就是3次IO
OK啦!!!!
更多推荐


 7
 0
- 0


 已为社区贡献1条内容

所有评论(0)