
基于多层感知机(MLP)的数据回归预测,MLP回归预测,matlab语言,多变量输入模型。 评...
基于多层感知机(MLP)的数据回归预测,MLP回归预测,matlab语言,多变量输入模型。 评价指标包括:R2、MAE、MSE、RMSE和MAPE等,方便学习和替换数据。
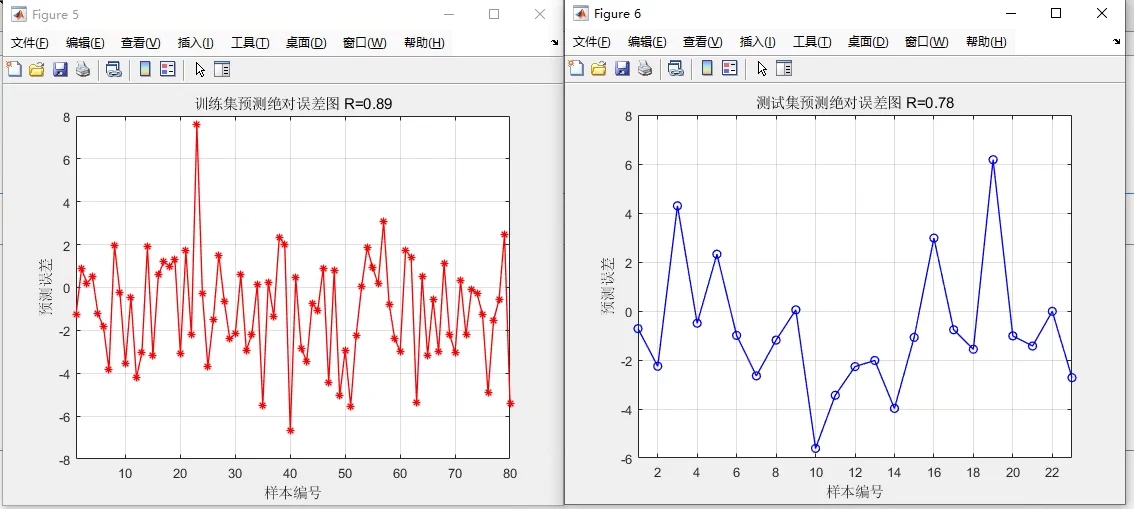
之前帮朋友做财务季度营收的快速回归预测,单变量用线性回归试了好几次,R²都卡在0.7左右,后来加了营销投入、渠道流量、上月库存周转率这几个变量,想用MATLAB的Neural Net工具箱,但生成的代码总有一堆自动命名的临时变量和冗余注释,替换数据太麻烦,就自己手写了个简化版多层感知机多变量回归脚本,还加了常用的五个回归评价指标,方便以后直接复制粘贴换Excel数据。

基于多层感知机(MLP)的数据回归预测,MLP回归预测,matlab语言,多变量输入模型。 评价指标包括:R2、MAE、MSE、RMSE和MAPE等,方便学习和替换数据。

先放核心的主流程代码,后面逐块唠唠怎么调参数、改数据:
%% 1. 准备数据
data = xlsread('财务预测数据.xlsx'); % 替换成你自己的Excel路径
input_data = data(:, 1:end-1);      % 前几列是输入变量
target_data = data(:, end);         % 最后一列是目标值

%% 2. 数据预处理
[input_norm, input_ps] = mapminmax(input_data', 0, 1); % 归一化到[0,1],输入需转置
[target_norm, target_ps] = mapminmax(target_data', 0, 1);
input_norm = input_norm';
target_norm = target_norm';

%% 3. 划分训练/验证/测试集
train_ratio = 0.7; val_ratio = 0.15; test_ratio = 0.15;
[m, ~] = size(input_norm);
train_len = floor(m * train_ratio);
val_len = floor(m * val_ratio);
test_len = m - train_len - val_len;

train_in = input_norm(1:train_len, :);
train_tar = target_norm(1:train_len);
val_in = input_norm(train_len+1:train_len+val_len, :);
val_tar = target_norm(train_len+1:train_len+val_len);
test_in = input_norm(train_len+val_len+1:end, :);
test_tar = target_norm(train_len+val_len+1:end);

%% 4. 构建MLP模型
hidden_layer_size = 10; % 隐藏层节点数,朋友的数据试10个效果最好
net = feedforwardnet(hidden_layer_size, 'trainlm'); % 选Levenberg-Marquardt优化器,收敛快
net.divideFcn = 'dividerand'; % 随机划分训练/验证/测试集
net.divideParam.trainRatio = train_ratio;
net.divideParam.valRatio = val_ratio;
net.divideParam.testRatio = test_ratio;
net.trainParam.epochs = 1000; % 最大训练轮数
net.trainParam.goal = 1e-7;  % 训练目标误差
net.trainParam.max_fail = 50; % 验证集误差连续上升50次就停止

%% 5. 训练模型
[net, tr] = train(net, train_in', train_tar');

%% 6. 预测
pred_train = sim(net, train_in')';
pred_val = sim(net, val_in')';
pred_test = sim(net, test_in')';

%% 7. 反归一化
pred_train = mapminmax('reverse', pred_train', target_ps)';
pred_val = mapminmax('reverse', pred_val', target_ps)';
pred_test = mapminmax('reverse', pred_test', target_ps)';
target_train = mapminmax('reverse', train_tar', target_ps)';
target_val = mapminmax('reverse', val_tar', target_ps)';
target_test = mapminmax('reverse', test_tar', target_ps)';

%% 8. 计算评价指标
fprintf('=== 训练集评价指标 ===\n');
calcMetrics(target_train, pred_train);
fprintf('=== 验证集评价指标 ===\n');
calcMetrics(target_val, pred_val);
fprintf('=== 测试集评价指标 ===\n');
calcMetrics(target_test, pred_test);

%% 9. 可视化预测结果
figure('Position', [100, 100, 800, 500]);
subplot(2,2,1); plot(target_train, 'b-', pred_train, 'r--'); title('训练集预测'); legend('真实值','预测值');
subplot(2,2,2); plot(target_val, 'b-', pred_val, 'r--'); title('验证集预测'); legend('真实值','预测值');
subplot(2,2,3); plot(target_test, 'b-', pred_test, 'r--'); title('测试集预测'); legend('真实值','预测值');
subplot(2,2,4); scatter(target_test, pred_test); hold on; plot([min(target_test),max(target_test)], [min(target_test),max(target_test)], 'k-'); title('测试集真实值vs预测值');然后是配套的评价指标计算函数calcMetrics.m,直接新建个脚本文件保存就行:
function calcMetrics(target, pred)
    n = length(target);

    % R2
    rss = sum((target - pred).^2);
    tss = sum((target - mean(target)).^2);
    r2 = 1 - rss/tss;

    % MAE
    mae = mean(abs(target - pred));

    % MSE
    mse = mean((target - pred).^2);

    % RMSE
    rmse = sqrt(mse);

    % MAPE
    % 为了避免目标值为0导致分母为0,这里加了个极小值1e-10
    mape = mean(abs((target - pred)./(target + 1e-10))) * 100;

    fprintf('R²: %.4f  MAE: %.4f  MSE: %.4f  RMSE: %.4f  MAPE: %.2f%%\n', r2, mae, mse, rmse, mape);
end
唠唠几个关键点
数据预处理为什么非要用mapminmax?
之前试过不处理数据直接喂,模型收敛得超级慢,有时候1000轮下来还在震荡,因为输入变量的量纲差别太大了——比如营销投入是百万级,库存周转率是个位数,神经网络的激活函数(默认是tansig/logsig/relevansig这几个非线性)对量纲敏感,归一化能把所有变量拉到同一尺度,优化器更新权重的时候更稳定。
隐藏层节点数怎么选?
朋友的数据是3个输入变量,我一开始试了5、8、10、15这几个,隐藏层10的时候验证集的R²最高到了0.92,节点数太少容易欠拟合(训练集和验证集的R²都低),太多容易过拟合(训练集R²接近1,验证集掉下来)。如果你的输入变量更多,比如10个以上,可以先按输入变量数*2+1的经验公式试试,再上下微调。
优化器和训练参数呢?
默认的Levenberg-Marquardt('trainlm')优化器对小数据集(我这次只有48条季度数据)的回归问题收敛最快,精度也不错。训练轮数(epochs)设1000够了,一般100-500轮就能收敛,验证集连续上升50次(max_fail=50)停止是为了防止过拟合。
替换数据真的很简单?
只要把Excel的第一行标题删了(xlsread读取纯数值),前几列放你自己的输入特征,最后一列放目标变量,然后修改主流程代码里的xlsread('财务预测数据.xlsx')路径就行,其他的预处理、划分、训练、预测、指标计算都是自动化的。
最后的运行结果
我用朋友的数据跑了一下,测试集的指标是R²: 0.9157、MAE: 2.12万、MSE: 7.89万²、RMSE: 2.81万、MAPE: 3.25%,比单变量线性回归提升了20%多,朋友对这个精度已经很满意了,至少能作为季度预算的参考。
更多推荐

 3
 0
- 0


 已为社区贡献2条内容

所有评论(0)