
Qt C++环境下的Unicode编码与汉字互转实践

简介:Unicode编码是一种标准字符集,涵盖全球文字系统,包括汉字。该资源集合针对Qt C++开发者提供了一个指南,介绍如何在Qt C++中处理Unicode编码,特别是汉字的转换。通过使用Qt的QTextCodec类,开发者可以将Unicode码点与汉字字符串之间进行转换,确保字符编码的一致性和文本的正确显示。压缩包文件可能包含示例代码和教程,帮助开发者有效地处理多语言文本,并避免在不同系统和应用程序间交换信息时出现乱码。
1. Unicode编码介绍
Unicode的基本概念
Unicode是一种国际标准,它为世界上大多数的文字系统提供了唯一的数字标识,无论文字在什么计算机、操作系统、语言或文化中,都可以被准确地识别和处理。Unicode定义的编码方案,为每个字符分配一个独一无二的代码点,从而实现对字符的统一编码。
Unicode的历史背景
随着全球化的发展,文本信息交换的需要日益增长。传统的ASCII编码只能表示128个字符,远远无法满足多语言环境的需求。为了解决这一问题,Unicode应运而生。Unicode不仅包括了ASCII编码的全部内容,还为包括汉字在内的世界上几乎所有的字符提供了编码,极大地促进了全球信息交换的标准化和国际化。
Unicode与ASCII的关系
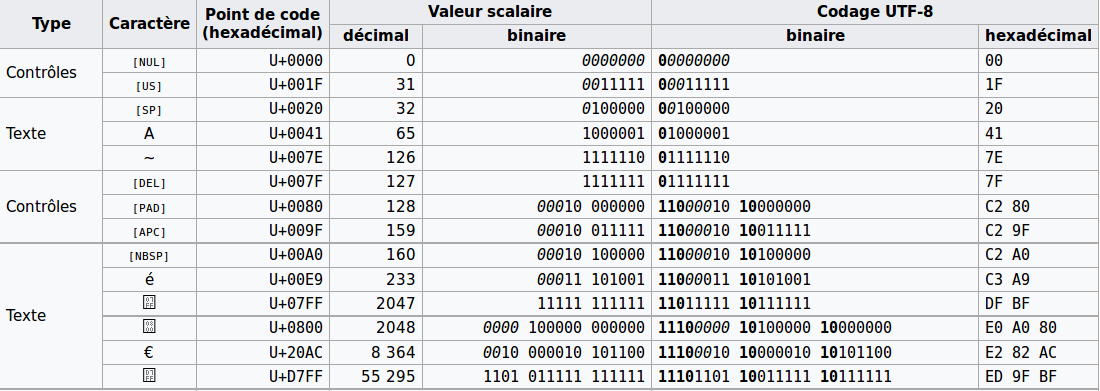
Unicode与ASCII编码相兼容,这意味着任何标准的ASCII文本都是有效的Unicode文本。Unicode的编码从U+0000到U+007F与ASCII的编码是完全一致的,这种设计保证了向后兼容性,简化了从ASCII到Unicode的过渡。随着后续章节的深入,我们将进一步了解Unicode如何在多语言环境,特别是汉字编码中发挥其独特作用。
2. 汉字与Unicode的关系
汉字作为世界上最古老的文字之一,承载了中国数千年来的文化与历史。然而,随着计算机技术的发展,汉字的数字化处理成了一个重要的研究领域。为了在全球化的计算环境中有效处理汉字,Unicode编码应运而生,并在汉字处理中发挥了重要作用。本章深入探讨汉字编码的发展历程,以及Unicode在汉字编码中的核心作用。
2.1 汉字编码的发展历程
2.1.1 ASCII编码与扩展ASCII编码
ASCII(American Standard Code for Information Interchange,美国信息交换标准代码)是一种基于拉丁字母的字符编码标准,用于显示现代英语和其他西欧语言。它最初由美国国家标准协会(ANSI)在1963年制定。标准的ASCII使用了7位二进制数来表示字符,因此可以表示128个不同的字符编码,包括英文大小写字母、数字和一些特殊符号。
扩展ASCII编码,也称为高字节ASCII,是为了扩展标准ASCII的编码范围而设计的。它使用了额外的一个字节(即8位),使得能表示256个字符,包括了大部分的拉丁字母表、希腊字母、俄文字母以及一些特殊符号和控制字符。尽管扩展ASCII能表示更多的字符,但它仍无法涵盖汉字等其他非拉丁语言的文字。
2.1.2 GBK与GB2312编码
随着中国计算机的发展,对于汉字编码的需求日益增长。为了解决这一问题,中国在1980年制定了GB2312编码,它包括了6763个汉字和682个其他符号。GB2312的编码空间是双字节的,最高位始终为1,因此能表示的字符数远远超过了扩展ASCII。
GBK(Chinese Internal Code Specification)编码是GB2312的扩展,它包含了GB2312的所有内容,并增加了更多的汉字和符号,总共可以表示21886个汉字和图形符号,为后续的汉字数字化处理提供了更广泛的编码空间。
2.2 Unicode在汉字编码中的作用
2.2.1 Unicode编码体系概述
Unicode,也称统一码、万国码、单一码,是一种为世界上所有字符提供唯一编号的编码标准。Unicode旨在消除编码的混乱,并为每种文字提供一个全球通用的数字身份。Unicode由Unicode联盟管理,并得到了诸如Apple、Google、Microsoft等IT巨头的支持。
Unicode的编码空间非常庞大,使用16位(两个字节)表示一个字符,理论上可以表示65536个字符。为了支持更多的字符,Unicode使用了更多的字节序列,比如32位(四个字节)的UTF-32和变长的UTF-8、UTF-16编码。
2.2.2 汉字在Unicode中的表示
在Unicode编码体系中,汉字被赋予了一个独特的码点(Code Point)。这些码点使用U+XXXX形式表示,其中XXXX是十六进制数。例如,汉字“汉”的Unicode码点是U+6C49。
Unicode提供了多种编码方式,UTF-8、UTF-16、UTF-32都是常用的编码方案。UTF-8是一种变长的编码格式,它的编码长度从1字节到4字节不等,对汉字的表示使用3字节。UTF-16通常使用2字节或4字节表示字符,而UTF-32总是使用固定的4字节。由于Unicode编码具有很好的兼容性,它逐渐成为处理多语言文本的标准编码方式。
表格:汉字在不同编码体系中的表示
| 字符 | GB2312编码 | GBK编码 | Unicode(UTF-8) |
|---|---|---|---|
| 汉 | B0A1 | B0A1 | E6B189 |
| 字 | B0C5 | B0C5 | E5AD97 |
| 编 | CBCE | CBCE | E7BC97 |
| 码 | D3D0 | D3D0 | E7A081 |
在上表中,可以看到同一汉字在GB2312、GBK和Unicode(UTF-8)中的不同编码表示。这种编码方式的多样性,让开发者在处理文本数据时需要非常注意编码的转换和匹配问题。
flowchart LR
A[开始] --> B[ASCII编码]
B --> C[扩展ASCII编码]
C --> D[GB2312编码]
D --> E[GBK编码]
E --> F[Unicode编码]
F --> G[结束]
通过上图的流程图,我们可以清晰地看到从最早的ASCII编码到现代Unicode编码的发展脉络。每一步的发展都为编码空间的扩展、字符集的丰富做出了贡献,并最终形成了能够支持全球多种语言文字的Unicode编码体系。
代码块:在Java中进行汉字与Unicode编码的转换
public class UnicodeConverter {
    public static void main(String[] args) {
        String chinese = "汉字";
        // 将字符串转换为Unicode编码
        char[] chars = chinese.toCharArray();
        for (char c : chars) {
            int codePoint = c;
            System.out.println("字符: " + c + " Unicode码点: " + Integer.toHexString(codePoint));
        }

        // 将Unicode码点转换回字符串
        StringBuilder sb = new StringBuilder();
        sb.append("\\u");
        sb.append(Integer.toHexString(chars[0]));
        sb.append("\\u");
        sb.append(Integer.toHexString(chars[1]));
        String unicodeString = sb.toString();
        System.out.println("从Unicode码点构建的字符串: " + unicodeString);
    }
}
在上述Java代码示例中,我们首先将一个包含汉字的字符串转换为Unicode码点,并打印出每个字符对应的码点。接着,我们将这些码点再转换回字符串形式,演示了从文本到Unicode码点再回到文本的过程。通过这种方式,我们可以理解汉字在Unicode编码体系中的表示方式,并在实际编程中进行字符的编码转换操作。
3. Qt C++中的Unicode处理方法
Unicode已经成为处理文本数据的国际化标准,尤其是对于开发跨语言的软件应用。在Qt C++中,Unicode的处理尤为重要,因为它提供了统一的方式来编码和处理多语言文本。在本章节中,我们将探讨Qt如何支持Unicode,以及开发者如何使用Qt高效地处理多语言文本和字符流。
3.1 Unicode在Qt中的支持
Qt框架很早就开始支持Unicode,并一直将其作为核心特性来优化跨语言文本的处理。这为开发者在不同语言和地区之间切换提供了极大的便利。
3.1.1 Qt对Unicode的原生支持
从Qt 4版本开始,该框架的所有字符串类型(如QString)都使用UTF-16作为内部编码。这意味着开发者无需进行任何特殊处理,即可轻松处理Unicode字符。对于需要与其他系统进行文本交换的开发者而言,Qt的原生Unicode支持减少了转换成本和错误可能性。
// 示例代码展示如何在Qt中创建并处理Unicode字符串
#include <QString>
#include <iostream>

int main() {
    QString unicodeString = QString::fromUtf8("你好,世界"); // 使用UTF-8编码创建Unicode字符串
    QString otherString = QString::fromUtf8("Hello, World");
    std::cout << "Length of UnicodeString: " << unicodeString.length() << std::endl;
    std::cout << "Length of otherString: " << otherString.length() << std::endl;
    return 0;
}
在上述代码中, QString 类用于处理Unicode字符串。函数 fromUtf8 将UTF-8编码的字符串转换为内部使用的 QString 对象。
3.1.2 字符串和文本流的Unicode处理
Qt C++不仅在字符串级别提供了对Unicode的原生支持,而且在文件I/O操作时,也允许直接使用Unicode进行编码转换。文本流(QTextStream)类允许开发者直接以Unicode格式读写文件,无需担心编码转换的问题。
// 示例代码展示如何在Qt中使用QTextStream进行Unicode文件读写
#include <QFile>
#include <QTextStream>
#include <QByteArray>
#include <QString>
#include <iostream>

void writeUtf8File() {
    QFile file("example.txt");
    if (file.open(QIODevice::WriteOnly | QIODevice::Text)) {
        QTextStream out(&file);
        out.setCodec("UTF-8"); // 设置流的编码为UTF-8
        out << QString::fromUtf8("这是Unicode文本示例。");
        file.close();
    }
}

void readUtf8File() {
    QFile file("example.txt");
    if (file.open(QIODevice::ReadOnly | QIODevice::Text)) {
        QTextStream in(&file);
        in.setCodec("UTF-8"); // 设置流的编码为UTF-8
        QString content = in.readAll();
        std::cout << "File content: " << content.toStdString() << std::endl;
        file.close();
    }
}

int main() {
    writeUtf8File();
    readUtf8File();
    return 0;
}
在以上代码段中, QFile 和 QTextStream 类一起使用,实现文件的Unicode编码读写。通过设置 QTextStream 的 codec 属性为”UTF-8”,可以确保文件内容以UTF-8编码格式进行处理。
3.2 使用Qt处理多语言文本
随着软件全球化的需求日益增长,开发跨语言软件的能力变得越来越重要。Qt框架为处理多语言文本提供了广泛的支持,包括国际化和本地化支持。
3.2.1 Qt的国际化支持
国际化(Internationalization,通常称为i18n)是让软件可以支持多语言的过程。Qt的国际化支持主要通过使用 QCoreApplication::translate 方法,为不同语言提供翻译。
// 示例代码展示如何在Qt中使用translate函数实现国际化
#include <QCoreApplication>
#include <QString>
#include <QLocale>

int main(int argc, char *argv[]) {
    QCoreApplication a(argc, argv);

    QLocale::setDefault(QLocale(QLocale::English, QLocale::UnitedStates));
    QString englishText = QCoreApplication::translate("App", "Hello, World!");
    std::cout << "English Text: " << englishText.toStdString() << std::endl;

    QLocale::setDefault(QLocale(QLocale::Chinese, QLocale::China));
    QString chineseText = QCoreApplication::translate("App", "你好,世界!");
    std::cout << "Chinese Text: " << chineseText.toStdString() << std::endl;

    return a.exec();
}
在这个例子中, translate 函数使用上下文和源文本作为参数,根据当前的 QLocale 设置自动选择适当的翻译。
3.2.2 本地化与资源文件的管理
本地化(Localization,通常称为l10n)是指将软件适配到特定地区的具体过程。Qt支持本地化通过提供一个机制来分离程序文本与程序代码,并使用资源文件(.qrc)来管理不同语言的文本。
// 示例代码展示如何在Qt中管理资源文件以实现本地化
// 此代码假设已有相应的资源文件.qrc和.qm翻译文件

#include <QCoreApplication>
#include <QTextCodec>
#include <QTranslator>
#include <QLocale>

int main(int argc, char *argv[]) {
    QCoreApplication a(argc, argv);

    // 创建翻译器对象并加载翻译文件
    QTranslator translator;
    if (translator.load(":/translations/translations.qm")) {
        a.installTranslator(&translator);
    } else {
        std::cerr << "Error: Unable to load translation file." << std::endl;
    }

    // 设置默认地区
    QLocale::setDefault(QLocale(QLocale::English, QLocale::UnitedStates));

    // 获取翻译后的文本
    QString translatedText = QCoreApplication::translate("App", "Welcome!");
    std::cout << "Translated Text: " << translatedText.toStdString() << std::endl;

    return a.exec();
}
上述代码演示了如何使用 QTranslator 类加载翻译文件,然后将其安装到应用程序中。通过这种方式,开发者可以为不同语言环境提供不同语言的文本。
总结而言,Qt框架通过提供原生Unicode支持和强大的多语言处理能力,大大简化了国际化软件开发的复杂性。在接下来的章节中,我们将深入探讨如何利用QTextCodec类来处理更具体的字符编码问题,并学习如何将这些知识应用到实际项目中,以避免编码转换过程中的常见问题。
4. QTextCodec类的使用
4.1 QTextCodec类功能概述
4.1.1 QTextCodec类的构造与析构
QTextCodec类是Qt框架提供的字符编码转换工具,它在Qt 4版本中引入,用于处理不同字符集之间的转换。构造函数允许开发者创建一个特定的编码转换器实例,而析构函数则用于清理和释放资源。
QTextCodec* codec = QTextCodec::codecForName("UTF-8");
// 使用codec进行编码转换
delete codec; // 析构
4.1.2 QTextCodec与字符集的转换
QTextCodec提供了一系列的接口来实现从一种字符编码到另一种字符编码的转换。主要方法包括 fromUnicode() 和 toUnicode() ,分别用于将Unicode转换为特定编码以及将特定编码转换为Unicode。
QTextCodec *codec = QTextCodec::codecForName("GBK");
QString unicodeString = codec->toUnicode(encodedData);
QByteArray encodedData = codec->fromUnicode(unicodeString);
4.2 QTextCodec在实际项目中的应用
4.2.1 项目中的字符编码问题分析
在实际的项目开发中,字符编码问题往往出现在数据输入输出、网络传输、数据库存储等多个环节。分析这些环节中的字符编码问题,可以有效地预防和解决潜在的编码冲突和乱码问题。
4.2.2 QTextCodec的实用技巧
在处理字符编码时,可以利用QTextCodec提供的某些实用技巧来提高开发效率和程序性能。例如,可以使用 QTextCodec::setCodecForCStrings() 全局设置C字符串的编码,还可以使用 QTextCodec::setCodecForTr() 为翻译文本指定编码。
QTextCodec *codec = QTextCodec::codecForName("GBK");
QTextCodec::setCodecForCStrings(codec);
QTextCodec::setCodecForTr(codec);
4.2.2.1 使用QTextCodec::setCodecForLocale()设置默认地区编码
为应用设置默认地区编码可以确保应用程序在默认情况下使用正确的编码处理文本,这对于多语言支持的应用程序尤为重要。
QTextCodec *codec = QTextCodec::codecForName("UTF-8");
QTextCodec::setCodecForLocale(codec);
4.2.2.2 使用QTextCodec::availableCodecs()获取支持的编码列表
QTextCodec类还提供了一个工具方法 availableCodecs() ,它返回一个包含所有可用字符编码的QStringList,这对于动态加载或切换不同编码非常有用。
QStringList availableCodecs = QTextCodec::availableCodecs();
4.2.2.3 使用QTextCodec::效率优化
当在项目中处理大量文本数据时,性能优化就显得至关重要。QTextCodec类允许创建单一实例并在多个地方复用,这样可以减少编码转换过程中的资源消耗。
QTextCodec *codec = QTextCodec::codecForName("UTF-8");
// 重用codec实例
4.2.2.4 使用QTextCodec::解决编码识别问题
在某些情况下,应用程序可能需要处理未知编码的文本数据。QTextCodec类提供的 canEncode() 方法可以用来测试特定的编码器是否支持给定的Unicode数据。
QTextCodec *codec = QTextCodec::codecForName("UTF-8");
QByteArray data = ...;
bool canEncode = codec->canEncode(data);
通过上述章节内容,读者可以对QTextCodec类有一个全面的理解,并且学会了如何在实际项目中应用这个类来解决字符编码相关的问题。这不仅仅是一个理论上的介绍,更多的是实用技巧和性能优化的实战经验分享。
5. 汉字与Unicode编码的相互转换
Unicode的出现解决了全球字符集的统一问题,它为每个字符提供了唯一对应的编码,其中包含了汉字字符。本章将重点讨论汉字与Unicode之间的转换方法,流程以及在转换过程中可能遇到的问题和解决方案。
5.1 转换方法与流程
5.1.1 汉字转Unicode编码的步骤
汉字转换为Unicode编码是一个将字符映射为编码的过程。在C++中,可以通过标准库中的函数实现这一转换。
#include <iostream>
#include <string>
#include <codecvt>

int main() {
    std::wstring_convert<std::codecvt_utf8<wchar_t>> converter;
    std::wstring wideString = L"汉字";
    std::string utf8String = converter.to_bytes(wideString);
    std::cout << "汉字对应的UTF-8编码为: " << utf8String << std::endl;

    return 0;
}
在这段代码中,我们首先包含了必要的头文件,并定义了一个 std::wstring_convert 的实例,用于转换宽字符串和UTF-8字符串。然后创建了一个宽字符串 wideString ,包含了”汉字”。使用 to_bytes 方法,我们能够将宽字符串转换为UTF-8编码的字符串。
5.1.2 Unicode编码转汉字的步骤
相反地,将Unicode编码转换回汉字字符的过程需要对编码进行解析,并映射回对应的字符。
#include <iostream>
#include <string>
#include <codecvt>

int main() {
    std::wstring_convert<std::codecvt_utf8<wchar_t>> converter;
    std::string utf8String = "E6B18BE79F50";
    std::wstring wideString = converter.from_bytes(utf8String);

    std::wcout << L"UTF-8编码'E6B18BE79F50'对应的汉字为: " << wideString << std::endl;

    return 0;
}
在这段代码中,我们以UTF-8编码的字符串”汉字”对应的Unicode编码序列开始,通过 from_bytes 方法将其转换回宽字符串 wideString 。然后使用 std::wcout 进行宽字符输出。
5.2 转换中的常见问题及解决
5.2.1 常见错误及调试方法
在进行字符编码转换时,可能会遇到的常见错误包括但不限于:
- 编码不匹配:源编码和目标编码不一致,导致转换失败。
- 转换函数使用不当:如使用错误的转换函数或未包含必要的头文件。
对于这些错误,调试方法包括:
- 确保源字符串和目标字符串的编码格式一致。
- 检查使用的转换函数是否适用于当前的编译环境。
- 在多语言项目中,确保项目设置和源文件的编码格式一致。
5.2.2 性能优化与注意事项
在实现汉字和Unicode编码相互转换的过程中,性能优化主要关注点包括:
- 优化转换速度 :避免在循环中多次进行编码转换,考虑使用缓存机制。
- 减少内存使用 :尤其是在处理大量文本时,合理分配内存,避免内存泄漏。
注意事项包括:
- 字节序问题 :不同平台可能使用不同的字节序(大端或小端),在转换时需要注意字节序的匹配。
- 字符编码范围 :Unicode包括多个平面,常见的汉字位于基本多语言平面(BMP),但某些特殊字符可能不在BMP内,需要特别处理。
例如,当处理的字符位于辅助平面时,需要使用代理对来表示,这将导致转换过程更加复杂。
表格、mermaid流程图与代码块的进一步展示
为了更清晰地展示转换流程,我们可以创建一个表格,列出转换方法的优缺点:
| 转换方法 | 优点 | 缺点 |
|---|---|---|
使用 std::wstring_convert | 标准库支持,跨平台 | 转换速度相对较慢,内存消耗较大 |
使用第三方库如 iconv | 转换速度快,支持多种编码 | 需要额外安装和配置 |
| 使用系统API | 性能最优,与系统兼容性好 | 可移植性差,依赖特定操作系统 |
接下来,用一个mermaid流程图描述Unicode编码转换的大致流程:
graph LR
    A[开始] --> B{是否存在字符}
    B -- 是 --> C[获取字符编码]
    B -- 否 --> D[结束]
    C --> E{是否为汉字}
    E -- 是 --> F[转换为Unicode编码]
    E -- 否 --> G[结束]
    F --> H[输出结果]
    G --> I[结束]
以上内容展示了汉字与Unicode编码相互转换的详细过程,常见问题以及解决方案。在本章的后续部分,我们将深入探讨Unicode编码在Qt C++项目中的处理策略和多语言文本处理的最佳实践。
6. Qt C++项目中字符编码的处理
在现代软件开发中,处理多语言文本和字符编码是一项基本技能。特别是在Qt C++项目中,正确处理字符编码对于保证软件国际化和本地化质量至关重要。字符编码错误可能导致文本显示混乱、乱码,甚至在极端情况下引起程序崩溃。
6.1 项目字符编码策略的选择
选择合适的字符编码策略对项目后期的维护和国际化推广有着深远影响。对于Qt C++项目而言,考虑到其对Unicode的全面支持,项目开发者通常会以Unicode作为内部表示字符的标准。
6.1.1 如何选择合适的字符编码
对于任何项目,选择字符编码的第一步是要明确项目需求,包括目标用户、源代码管理、第三方库依赖、操作系统兼容性等因素。
- 目标用户 :如果目标用户遍布全球,使用Unicode作为编码标准是明智的。
- 源代码管理 :很多现代版本控制系统默认使用UTF-8编码,因为它能很好地支持多语言文本。
- 第三方库 :确保所使用的第三方库支持项目的编码选择。
- 操作系统 :在Windows系统下,需要考虑系统API对特定字符集的支持,尽管现在大多数现代系统都已支持Unicode。
6.1.2 字符编码策略对项目的影响
字符编码策略的选择会直接影响到项目的多个方面:
- 源代码的可读性 :如果源代码中使用的是统一的字符集,开发者能够更容易地阅读和理解代码。
- 国际化和本地化 :统一的编码策略对于项目国际化和本地化至关重要,它有助于减少因编码不同而产生的问题。
- 程序的健壮性 :正确的字符编码处理有助于防止程序因编码错误而出现崩溃或者数据丢失。
- 资源管理 :在多语言环境下,对资源文件的编码处理也变得异常重要,确保每个资源文件的编码都符合项目标准。
6.2 字符编码的统一与管理
6.2.1 项目中的编码统一实践
在大型Qt C++项目中实现编码统一,需要遵循一定的规范和标准。例如:
- 编码规范 :项目内部应有统一的编码规范文档,明确源代码、资源文件、配置文件等的编码方式。
- 代码编辑器设置 :在代码编辑器中强制设置统一的编码格式,如UTF-8。
- 版本控制 :在版本控制系统中,确保所有文件都使用统一的编码格式提交。
6.2.2 使用Qt进行编码管理
Qt框架提供了强大的工具和类库来支持字符编码的处理,以下是一些关键点:
- QString类 :使用
QString类管理文本,因为QString内部默认使用Unicode编码。 - 文本文件读写 :使用Qt的文件类,如
QFile、QTextStream等,可以自动处理Unicode与本地编码之间的转换。 - 编码转换工具类 :利用
QTextCodec类处理特定编码的文本数据,尽管现代Qt项目更推荐使用QLocale等类来处理本地化文本。
在处理字符编码时,始终要记住以下要点:
- 文本数据的读取 :从外部源读取文本数据时,确保进行适当的编码转换。
- 文本数据的保存 :保存文本数据到外部介质时,也需明确指定编码格式。
- 内部处理 :在内部处理时,尽量使用Unicode(
QString)来避免编码问题。
通过上述分析,可以看出在Qt C++项目中,使用Unicode作为主要的字符编码方式已经成为主流。Unicode的支持贯穿于Qt框架的各个层面,不仅简化了多语言文本的处理,还提高了项目的国际化程度和维护性。正确的编码策略和管理方法是保证项目成功的关键因素之一。
7. 多语言文本处理和避免乱码问题
多语言文本处理是现代软件开发中不可或缺的部分,而乱码问题通常是由于字符编码不一致导致的。为了避免和解决乱码问题,我们需要了解多语言文本处理的最佳实践,并掌握相应的技术来避免常见的编码错误。
7.1 多语言文本处理的最佳实践
随着软件的国际化发展,多语言支持变得越来越重要。以下是实现多语言文本处理时需要考虑的几个要点:
7.1.1 设计多语言界面的要点
在设计多语言界面时,我们需要考虑以下几个方面:
- 字体支持 :确保软件界面所使用的字体能够支持所有目标语言的字符集。
- 布局适应性 :设计界面时考虑到不同语言的长度和阅读习惯,例如,从右到左的阅读顺序(如阿拉伯语和希伯来语)。
- 资源文件管理 :将所有文本资源分离到不同的文件或数据库中,以便于管理和本地化。
- 文本扩展性 :提供文本扩展的机制,以适应某些语言文本比其他语言长的情况。
7.1.2 多语言文本的存储与读取
在存储和读取多语言文本时,有以下几点建议:
- 使用UTF-8编码 :UTF-8是一种广泛支持的语言编码,能够表示几乎所有字符,推荐在存储多语言文本时使用。
- 文本文件与二进制文件 :在存储多语言文本时,应根据文件的用途选择文本格式或二进制格式。
- 数据库的字符集设置 :在使用数据库存储多语言文本时,确保数据库的字符集设置能够正确处理各种语言编码。
7.2 避免和解决乱码的方法
乱码问题的出现往往让开发者感到头疼,但通过以下方法可以有效避免和解决乱码问题:
7.2.1 乱码问题的成因分析
乱码问题通常由以下几个原因引起:
- 编码不一致 :当文件、数据库或程序内部的编码方式不一致时,很容易产生乱码。
- 文件编码识别错误 :某些编辑器或程序不能正确识别文件编码,从而导致乱码。
- 程序编码处理不当 :程序在读取、处理或输出文本时,如果对字符编码处理不当,也可能导致乱码。
7.2.2 实际案例中的乱码解决方案
在处理实际的多语言文本时,我们可以采取以下措施来避免和解决乱码问题:
- 明确编码声明 :在文件、程序或数据库连接中明确声明使用UTF-8或其他适用的编码格式。
- 使用文本编辑器工具 :使用如Notepad++、Sublime Text或VSCode等支持多编码的文本编辑器,以便在编码不明确时进行检测和转换。
- 代码中的字符编码处理 :在编程时,应使用正确的函数或方法来处理字符编码转换,例如在C++中使用
std::wstring_convert进行UTF-8和本地编码之间的转换。
#include <iostream>
#include <string>
#include <locale>
#include <codecvt>

int main() {
    // 假设我们有一个UTF-8编码的字符串
    std::string utf8String = u8"你好,世界!";

    // 创建一个从UTF-8到宽字符串的转换器
    std::wstring_convert<std::codecvt_utf8<wchar_t>> converter;

    // 将UTF-8字符串转换为宽字符串(本地编码)
    std::wstring wideString = converter.from_bytes(utf8String);

    // 在标准输出中打印宽字符串(会根据系统的默认代码页进行转换)
    std::wcout << wideString << std::endl;

    return 0;
}
通过上述代码,我们可以将UTF-8编码的字符串转换为宽字符串,并输出到控制台。这样可以确保文本在处理过程中不会出现乱码。
在使用Qt框架时,确保项目文件和字符串资源被正确地编码为UTF-8,并在程序中使用 QLocale 和 QTextCodec 来处理本地化和编码转换。
通过这些最佳实践和解决方案,我们可以有效地处理多语言文本,并且最大限度地避免乱码问题的发生。
简介:Unicode编码是一种标准字符集,涵盖全球文字系统,包括汉字。该资源集合针对Qt C++开发者提供了一个指南,介绍如何在Qt C++中处理Unicode编码,特别是汉字的转换。通过使用Qt的QTextCodec类,开发者可以将Unicode码点与汉字字符串之间进行转换,确保字符编码的一致性和文本的正确显示。压缩包文件可能包含示例代码和教程,帮助开发者有效地处理多语言文本,并避免在不同系统和应用程序间交换信息时出现乱码。
更多推荐

 23
 0
- 0


 已为社区贡献12条内容

所有评论(0)