
全面掌握字符编码转换:UTF-16、UTF-8、ASCII与Unicode互换

简介:字符编码是IT领域文本处理的根基,本文详细介绍四个主要编码标准:UTF-16、UTF-8、ASCII和Unicode,以及它们的相互转换方法。Unicode为全球文字系统提供唯一码点,UTF-8和UTF-16是其两种实现方式。UTF-8以1到4字节表示字符,与ASCII兼容;而UTF-16通常用2字节,对于常见字符效率较高。ASCII编码是基础,仅适用于英文字符。在多平台和多语言应用中,编码转换是必要技能,本文将指导如何使用C++和相关库来实现编码转换,并提供详细的编码转换资源,帮助开发者深入理解并应用于实际项目中。
1. 字符编码转换,utf16<=> utf8 <=> ascii <=>unicode
在信息技术飞速发展的今天,字符编码扮演着至关重要的角色,它是人与机器沟通的桥梁。字符编码转换是开发与维护过程中不可避免的一个环节,它确保了不同系统、不同编程语言和不同平台间的信息交换不会出现乱码,保持信息的准确性。这一章节将带您深入理解字符编码转换的基础知识,包括UTF-16与UTF-8之间的相互转换,以及与ASCII和Unicode的关系。我们将通过简单的例子演示如何在命令行或编程语言中实现这些转换,帮助开发者更好地处理跨平台兼容性问题,确保数据的准确传递。
2. 字符编码基础知识
2.1 字符、编码与字节的关系
2.1.1 字符的概念及分类
字符是计算机中用于表示文本的基本单位。在不同语言和符号集中,字符的定义有所不同,但通常可以分为三类:字母字符、数字字符和符号字符。字母字符包括了各种语言的字母,比如拉丁字母、希腊字母、阿拉伯字母等。数字字符即我们日常使用的0到9的数字。符号字符则包括了标点符号、运算符号等。
字符集是一个字符的集合,它为每个字符分配一个唯一的代码。字符与代码之间的关系是编码。字符编码则是一个标准,它规定了字符集中的每个字符如何转换为计算机能够理解和处理的数字代码。
2.1.2 字节与字符编码的关系
字节是计算机中最小的可寻址存储单位,由8位二进制数(bit)组成。每个字节的取值范围是从00000000到11111111,即0到255。字符编码将字符映射到一个或多个字节的序列上。不同的字符编码方案决定了如何将字符转换成字节序列。
比如,ASCII编码使用一个字节来表示一个字符,而像UTF-8这样的编码方案会根据字符的不同,使用一个到四个字节来表示。
2.2 常见字符编码的历史和应用
2.2.1 ASCII编码的起源和发展
ASCII(American Standard Code for Information Interchange,美国信息交换标准代码)编码是由美国国家标准学会(ANSI)于1963年制定的字符编码标准。它最初包含128个字符,每个字符用7位二进制数(bit)表示,对应十进制的0到127。ASCII编码支持英文字母、阿拉伯数字、标点符号以及一些控制字符。
随着时间的发展,为了满足更多字符的表示需求,ASCII编码逐渐发展出了扩展ASCII编码。扩展ASCII使用了8位二进制数来表示字符,允许了256个字符的表示,也就是从0到255的范围。然而,扩展ASCII在不同地区和软件中有所不同,导致了编码的不兼容问题。
2.2.2 Unicode的产生背景及其意义
随着计算机技术的全球化,不同的计算机系统需要支持多语言文本的处理。ASCII编码无法满足这种需求,因此Unicode应运而生。Unicode提供了一个单一的字符编码方案,用以表示世界上所有的字符系统。
Unicode的设计目标是为每个字符提供一个统一的、不变的数字码点。这些码点以十六进制形式表示,并且大部分的码点都需要两个到四个字节来存储。Unicode的编码空间极为宽广,可以容纳上百万个字符,因此它被设计为支持几乎所有的历史和现代字符集。
Unicode还推出了几种编码形式,包括UTF-8、UTF-16等,这些编码形式在存储和传输效率上有所区别,但都致力于维护字符在Unicode中的唯一性和一致性。
3. Unicode字符集与码点
3.1 Unicode字符集概述
3.1.1 Unicode的基本原则和设计目标
Unicode字符集是一个旨在为每一个字符提供一个独一无二的编码的国际标准。Unicode的诞生解决了之前字符编码体系不统一,无法涵盖世界上所有语言字符的问题。其基本原则包括:
- 普遍性 :Unicode覆盖了世界上现有的所有文字系统,包括一些已经不再使用的古老文字。
- 唯一性 :每个字符都有一个唯一的码点,避免了字符表示上的歧义。
- 不变性 :一旦一个字符被赋予一个码点,它将永远保持这个码点,不会因为技术和规范的更新而变化。
- 可访问性 :Unicode不仅包括字符,还包括一些控制字符和特殊字符的编码。
- 可实现性 :Unicode设计时考虑了计算机系统的实现需求,支持高效的编码、排序、搜索、索引等操作。
Unicode的设计目标是为计算机提供一个统一的字符编码标准,以解决多语言文本在计算机系统中的表示和处理问题。这使得软件开发者能够在他们的应用中更简单地实现国际化和本地化,同时使得不同语言和文字的文本可以在网络中自由流通,无需担心字符编码的兼容性问题。
3.1.2 Unicode的标准化过程
Unicode的标准化过程是一个持续进行的工作,由Unicode联盟负责管理。Unicode标准的发展经历了多个版本和修订,以适应新的符号、字符以及语言的需求。标准化过程主要包括以下几个步骤:
- 研究和定义 :Unicode联盟会研究全球各种文字系统,定义字符及其对应的码点。
- 委员会决策 :定义好的字符提交给Unicode技术委员会,该委员会由来自全球的专家组成,他们负责决定哪些字符被纳入标准。
- 公开评论 :提出的字符集会公开征求全球社区的评论和反馈,以确保其全面性和准确性。
- 发布版本 :在经过充分讨论和审查后,Unicode标准会发布新的版本,其中包含了最新的字符集。
- 维护和更新 :Unicode联盟持续维护标准,根据需要更新字符集。
每次发布新版本的Unicode标准时,都会有一个版本号来标识,比如 Unicode 13.0。这个版本号反映了当前标准所包含的字符数量和修订内容。开发者和标准化机构可以根据这些版本来更新他们的系统和应用,以支持最新的字符集。
3.2 Unicode码点与编码方式
3.2.1 码点的表示方法
在Unicode中,每个字符对应一个独特的码点,码点以U+形式开始,后跟一组十六进制数字。例如,大写字母”A”的Unicode码点是U+0041。对于某些字符集来说,特别是基本多语言平面(BMP)内的字符,它们的码点范围从U+0000到U+FFFF。
Unicode码点的设计允许它能够编码高达1,114,112个字符,这个数字由20个比特位的码点值(U+0000到U+10FFFF)所限定。这些码点可以分为17个平面,每个平面包含65,536个码点。目前,已经使用的码点只占了其中的一部分,其余的码点保留供将来使用或者作为私人使用区域。
Unicode码点不仅用于表示字符,还用于表示一些特殊功能,比如零宽连接符、语言标记等。这使得Unicode不仅是一个字符集,更是一个功能强大的字符编码系统,可以用于文本处理的各种复杂场景。
3.2.2 Unicode编码的几种形式
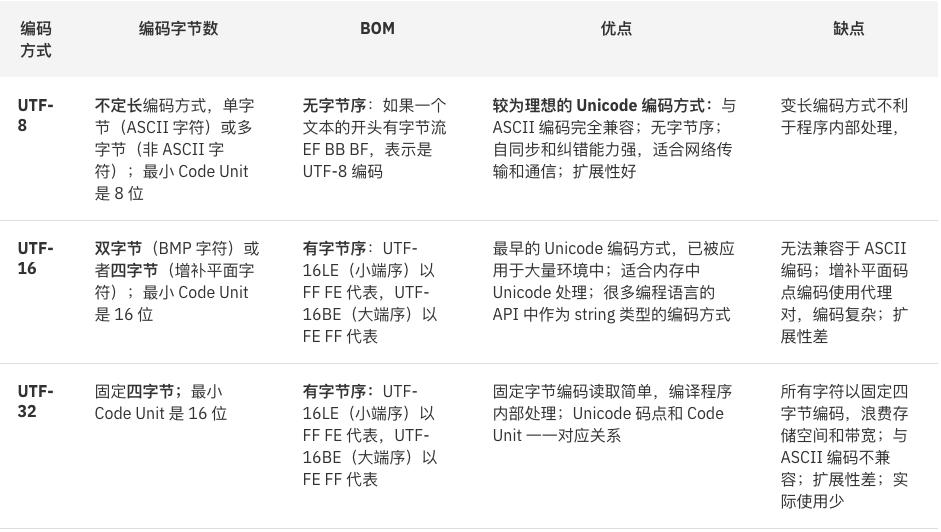
Unicode支持多种不同的编码形式,其中最常用的是UTF-8、UTF-16和UTF-32。
-
UTF-8 是一种变长的编码方式,每个码点可能由1到4个字节表示。它的主要优点是与ASCII兼容,且可以高效地表示常用的字符,同时保持对不常用的字符扩展的灵活性。
-
UTF-16 用2个或4个字节表示一个码点,它为BMP内的字符提供了一个紧凑的表示方式。非BMP字符(即辅助平面内的字符)使用一对代理对表示,每对代理各占用两个字节。
-
UTF-32 每个码点固定使用4个字节表示。这种形式的编码简单直观,便于处理和排序,但相比UTF-8和UTF-16,它显得更加浪费空间。
选择哪种编码形式取决于特定的应用需求和环境。UTF-8由于其兼容性和效率,目前被广泛用于互联网和现代操作系统中。UTF-16则在某些编程语言和系统API中更为常见。UTF-32在需要固定大小编码的应用中可能有其独特的优势。对于大多数开发者来说,理解和掌握至少一种Unicode编码形式是处理文本数据不可或缺的一部分。
4. UTF-8编码特点及兼容性
4.1 UTF-8编码机制
4.1.1 UTF-8编码的字节序标记
UTF-8(8-bit Unicode Transformation Format)编码是一种针对Unicode的可变长度字符编码,它能够用一至四个字节来表示一个字符,根据字符的不同而变化。UTF-8编码的字节序标记是它的一大特色,允许编码能够被方便地读取和解释。
字节序标记(Byte Order Mark,BOM)是一个特殊的字符编码序列,用来表示文本文件的字节顺序。在UTF-8中,通常不需要字节序标记,因为UTF-8是自同步的,也就是说,每个字节的开头就能告诉读取者这个字节的性质(独立字节、起始字节还是继续字节)。
然而,在某些情况下,为了明确文件的编码类型,特别是当文件可能被非UTF-8应用程序读取时,会使用BOM。在UTF-8编码中,BOM是由三个字节组成,其值为 0xEF 0xBB 0xBF 。这三个字节是UTF-8编码中的非法字符序列,因此它们在文本文件中不会出现在其他任何位置。
**UTF-8编码的字节序标记(BOM):**
- EF BB BF (十六进制表示)
- 11101111 10111011 10111111 (二进制表示)
4.1.2 UTF-8编码的变长特性
UTF-8编码的另一个重要特性是它的变长特性。UTF-8可以使用1到4个字节表示一个字符,这种设计使得UTF-8能够兼容ASCII编码,并且能够在单字节字符集中表达所有Unicode字符。
在UTF-8中,字符的字节长度取决于其Unicode码点的范围:
- 对于U+0000至U+007F的字符(基本拉丁字母,即标准ASCII字符集),UTF-8使用一个字节表示。
- 对于U+0080至U+07FF的字符(包括大部分拉丁字母的扩展和希腊字母等),UTF-8使用两个字节表示。
- 对于U+0800至U+FFFF的字符(包括大部分常用字符),UTF-8使用三个字节表示。
- 对于U+10000至U+10FFFF的字符(包括一些辅助平面的字符,如表情符号),UTF-8使用四个字节表示。
**字符Unicode范围与UTF-8编码字节长度对照:**
| Unicode范围        | 字节长度 |
|-------------------|---------|
| U+0000 to U+007F  | 1       |
| U+0080 to U+07FF  | 2       |
| U+0800 to U+FFFF   | 3       |
| U+10000 to U+10FFFF| 4       |
这种变长的编码方式是UTF-8的亮点之一,它既保证了对ASCII的完全兼容,同时也为未来可能出现的扩展字符集预留了空间。
4.2 UTF-8的兼容性和优势
4.2.1 与ASCII编码的兼容性
UTF-8编码与ASCII编码完全兼容。这意味着任何纯ASCII文本文件都可以不经过任何修改直接作为UTF-8编码处理。UTF-8的这一特性极大地促进了其在多种平台和应用中的普及。
UTF-8通过利用ASCII字符集的前128个字符的编码方式,确保了兼容性。在UTF-8编码中,所有U+0000到U+007F范围内的字符,都只使用一个字节,并且与ASCII编码的表示完全相同。这保证了旧的系统在处理新的UTF-8编码的文本时,能够正常显示所有ASCII字符,同时忽略未知的多字节字符。
4.2.2 与其他编码方式相比的优势
UTF-8相比其他编码方式有很多优势,这些优势使得UTF-8成为互联网和现代软件系统中最常用的字符编码之一。
-
效率 : UTF-8的变长特性意味着它可以根据字符的使用频率动态调整编码长度,常用的字符用较短的编码,不常用的字符用较长的编码,这样可以节省存储空间,尤其是在处理大量英文文本时。
-
通用性 : 由于UTF-8的兼容性,它可以用于表示任何Unicode字符,而无需担心字符缺失的问题。这在多语言环境中尤为重要。
-
简明性 : UTF-8的编码规则相对简单,使得程序员在进行编码转换和处理时更为方便,减少了编码错误的可能性。
-
稳定性 : UTF-8与ASCII兼容,保证了在从ASCII转向Unicode的过程中,旧的系统能够平滑过渡,减少了过渡期的混乱和错误。
| 特性 | 说明 |
|------|------|
| 效率 | 用较短的编码表示常用字符,节省存储空间 |
| 通用性 | 能够表示任何Unicode字符,无需担心字符缺失 |
| 简明性 | 编码规则简单,方便处理和转换 |
| 稳定性 | 与ASCII兼容,平滑过渡,减少混乱 |
通过以上分析,可以看出UTF-8编码在现代计算机系统中的重要地位和其无可比拟的优越性。无论是在数据存储、网络通信还是软件开发中,选择UTF-8作为字符编码可以带来极大的便利和可靠性。
5. UTF-16编码优势及其内存管理
5.1 UTF-16编码的特点
5.1.1 UTF-16编码的结构和使用场景
UTF-16编码是一种使用16位无符号整数来表示Unicode字符的编码方式。它能够表示从U+0000到U+10FFFF范围内的字符,涵盖了几乎所有的现代书写系统。UTF-16编码主要设计用来解决编码效率和兼容性的问题。由于它直接使用16位整数,相比于UTF-8,它在处理大量常用字符时占用空间更少,读取效率更高。在Unicode的标准化过程中,UTF-16设计用来取代早期的16位编码系统UCS-2,它通过引入代理对机制来表示超出基本多文种平面(BMP)的字符,从而解决了UCS-2的局限性。
在实际应用中,UTF-16主要在一些需要高效处理大量文本的场景中使用,比如操作系统、数据库系统和内存管理等。由于它的字节序问题在内部处理中可以被控制,这使得UTF-16成为某些环境下的首选编码。
5.1.2 UTF-16与Unicode的关系
UTF-16是Unicode标准中的一种字符编码方案。实际上,Unicode标准支持多种编码形式,包括UTF-8、UTF-16和UTF-32。UTF-16是Unicode编码的首选方案,因为它既可以有效地表示常用的字符,又可以处理扩展字符集,而且它的内存使用效率优于UTF-32。UTF-16编码中的字符分为两个部分:基本字符和辅助字符。基本字符直接映射到Unicode码点,而辅助字符(代理对)则通过一个特定的编码方式来表示更高范围的Unicode码点。
Unicode为每个字符分配了一个唯一的码点,而UTF-16提供了一种将这些码点编码为16位无符号整数的方式。这种紧密的关联使得UTF-16成为处理Unicode字符的理想选择。
5.2 UTF-16在内存中的表现
5.2.1 字节序问题与BOM(Byte Order Mark)
UTF-16编码在内存中的表示会遇到字节序的问题,这主要是因为不同的硬件架构在处理多字节数据时可能采用不同的顺序。UTF-16编码有两种字节序:大端序(Big Endian)和小端序(Little Endian)。大端序意味着在内存中,字符的最高有效字节存储在最低的内存地址上;小端序则相反。
为了避免字节序的混淆,UTF-16编码使用了字节顺序标记(Byte Order Mark,简称BOM)。BOM是一个特殊的非字符序列(U+FEFF),它在文档开头被用来标示字节序。当读取数据时,接收方可以检查BOM来判断接下来的数据是大端序还是小端序。在实践中,操作系统和文本处理软件通常会自动处理BOM。
5.2.2 内存占用及性能考虑
在内存管理方面,UTF-16的内存占用取决于所表示字符的数量和类型。对于基本多文种平面(BMP)内的字符,每个字符占用两个字节;而对于超出BMP范围的字符,需要使用四个字节(一对代理对加上一个辅助字符)。因此,UTF-16的内存占用是可变的,这在处理包含大量扩展字符集的文本时可能不是最优选择。
在性能方面,UTF-16相比于UTF-8,在多数情况下具有更高的读写效率,尤其是对于BMP内的常用字符。UTF-16在大多数现代操作系统和编程语言中被广泛支持,如Windows的内核API、Java虚拟机(JVM)以及.NET框架等。然而,在需要处理大量文本数据,且字符种类复杂多变的场景下,UTF-8可能因为其变长特性,而在实际存储和传输过程中显示出更优的性能。
示例代码块分析
#include <iostream>
#include <locale>
#include <codecvt>
#include <string>

int main() {
    // 使用C++标准库中的codecvt来处理编码转换
    std::wstring_convert<std::codecvt_utf16<char16_t, 0x10ffff, std::little_endian>, char16_t> converter;
    std::string utf8_string = "Hello, UTF-16!"; // UTF-8编码的字符串
    std::u16string utf16_string = converter.from_bytes(utf8_string); // 转换为UTF-16

    // 输出转换后的UTF-16编码字符串,这里为了展示,将16位的char16_t转换为int类型
    for (char16_t c : utf16_string) {
        std::cout << static_cast<int>(c) << " ";
    }
    std::cout << std::endl;

    // 将UTF-16编码的字符串转换回UTF-8
    std::string utf8_converted = converter.to_bytes(utf16_string);
    std::cout << "Converted UTF-8 string: " << utf8_converted << std::endl;

    return 0;
}
代码解释:
上述代码使用C++标准库中的 codecvt_utf16 来进行UTF-8和UTF-16之间的转换。首先,创建一个 wstring_convert 对象,并指定使用 std::codecvt_utf16 和 char16_t 作为模板参数来处理UTF-16数据。然后使用 from_bytes 方法将UTF-8编码的字符串转换为UTF-16编码的 char16_t 类型的字符串。为了输出调试信息,我们将 char16_t 类型的字符转换为整数类型并打印。
在转换回UTF-8时,我们使用 to_bytes 方法进行转换。这个简单的例子展示了如何在C++中进行基本的编码转换操作。
参数说明与代码扩展性
在这个代码示例中, std::codecvt_utf16 负责处理UTF-16和UTF-8之间的编码转换。模板参数 char16_t 指定了使用UTF-16的16位字符表示。另一个模板参数 0x10ffff 设置了UTF-16能表示的字符的最大Unicode码点,这是一个可选参数,用于指示支持的最大字符范围。当省略这个参数时,默认使用基本多文种平面(BMP)内的字符范围,即U+0000到U+FFFF。
需要注意的是,从C++11开始, std::codecvt_utf16 的使用逐渐被其他API所取代,例如使用 char32_t 类型的 std::codecvt_utf8 用于处理UTF-8编码。此外, std::wstring_convert 和相关转换器已经在C++17中被标记为废弃,推荐使用更现代的库,如ICU(International Components for Unicode)进行编码转换和文本处理。ICU提供了更加全面和高效的国际化功能,支持更多的编码格式和操作,包括对UTF-16的高效处理。
6. ```
第六章:ASCII编码简述及局限性
## 6.1 ASCII编码的定义和特点
    ### 6.1.1 ASCII的历史和编码表
    ASCII(American Standard Code for Information Interchange,美国信息交换标准代码)是最早的字符编码标准之一,它由美国国家标准协会(ANSI)在1963年制定。ASCII编码表包含128个字符,涵盖了大小写英文字母、阿拉伯数字、一些标点符号及控制字符。每个字符都对应一个从0到127的整数值,使用7位二进制数即可表示,这使得早期的计算机系统能够高效地处理和存储文本信息。

    ASCII的设计初衷是为了统一计算机系统中的字符表示,它基于拉丁字母,适用于英语环境。由于它仅使用7位二进制数,因此每个字符的表示仅需一个字节。这在计算机内存和存储空间都十分有限的年代,极大提高了处理效率。

    ### 6.1.2 ASCII编码的局限性分析
    尽管ASCII编码在历史上发挥了重要作用,但它也存在明显的局限性。首先,ASCII只能表示128个字符,这对于大多数西欧语言而言已经足够,但对于包含大量非拉丁字母字符的语言(如中文、日文、阿拉伯文等)则完全无法覆盖。其次,即使在拉丁字母体系内,ASCII也无法区分某些特殊字符,如带有重音符号的字符。

    随着计算机和互联网的普及,全球化的交流需要越来越多的字符集支持。这就导致了后来各种扩展字符集的出现,例如ISO-8859系列和Unicode。特别是Unicode的出现,旨在囊括世界上所有的字符集,使得文本信息可以无歧义地在各种语言和文化之间交流。

## 6.2 ASCII与其他编码的兼容问题
    ### 6.2.1 ASCII在现代通信中的地位
    尽管面临多种新编码标准的竞争,ASCII在现代通信中仍然占据着特殊的地位。许多基本的计算机通信协议,如HTTP、FTP、SMTP等,都默认使用ASCII编码进行数据交换。这是由于ASCII的简单性和稳定性,使得数据的交换无需额外的编码转换即可处理。

    此外,ASCII字符集也被广泛用于URL的编码、文件名的命名以及命令行的输入输出等领域。在很多编程语言中,字符串的处理往往默认采用ASCII编码,除非特别指定其他编码。这使得ASCII成为计算机科学和通信领域中不可或缺的一部分。

    ### 6.2.2 兼容性问题及其解决方案
    尽管ASCII的局限性导致它无法处理诸多语言的字符,但由于其广泛的应用基础,ASCII与其它编码系统的兼容性问题成为了实际工作中必须面对的问题。在处理非ASCII字符时,开发者和系统管理员需要采取一些措施来确保字符信息在不同编码系统间可以正确传递和显示。

    其中一种常见的解决方案是使用转义序列。例如,在支持UTF-8编码的系统中,非ASCII字符通过特定的字节序列来表示,这些序列能够被支持UTF-8的系统正确解析。同时,现代编程语言提供了丰富的库函数,可以方便地进行编码转换,比如Python的`str.encode()`和`bytes.decode()`方法,以及Java的`String.getBytes()`和`new String(bytes)`构造函数。

    在一些特定的应用场景中,比如Web开发,还会采用字符实体(Character Entities)的方式来表示特殊字符,如HTML中的`&`表示`&`符号。这些方法虽然不能完全解决编码的兼容性问题,但能够在一定程度上缓解问题,并保证数据的可读性和一致性。
# 7. 编码转换方法与重要性

## 7.1 编码转换的基本原理

在数字信息的世界中,不同编码方式间的转换是必不可少的。理解转换的基本原理,有助于我们更好地管理不同系统间的数据交换和兼容性问题。

### 7.1.1 转换过程中的常见问题

当涉及将字符串从一种编码方式转换为另一种时,常见问题包括数据丢失、乱码或转换错误。例如,从UTF-8转换为ASCII时,非ASCII字符可能无法正确表示,需要特别注意。

```c
// 伪代码示例:将UTF-8字符串转换为ASCII,省略了错误处理
utf8_string = "你好,世界!"; // UTF-8编码的中文字符串
ascii_string = to_ascii(utf8_string);
print(ascii_string); // 输出可能会是乱码或空字符串,因为ASCII不支持中文字符
在这个例子中,如果直接将包含中文的UTF-8编码字符串转换为ASCII,结果可能会出现乱码或丢失信息。
7.1.2 转换工具和方法的选择
选择正确的转换工具或方法取决于具体需求。可以使用编程语言提供的库函数,也可以使用现成的转换工具。
使用编程语言的库函数
大多数现代编程语言如Python、Java和C++都内置了字符编码转换的功能。
# Python中使用内置的encode和decode方法进行转换
utf8_string = "你好,世界!"
ascii_string = utf8_string.encode('ascii', 'ignore')  # 忽略无法编码的字符
print(ascii_string)  # 输出:b'\xe4\xbd\xa0\xe5\xa5\xbd\xef\xbc\x8c\xe4\xb8\x96\xe7\x95\x8c\xef\xbc\x81'
使用专门的编码转换工具
转换工具如iconv(命令行工具)、Notepad++、Visual Studio Code等,均可以进行字符编码的转换工作。
iconv -f UTF-8 -t ASCII//TRANSLIT input.txt > output.txt
这个命令行示例使用iconv命令行工具将UTF-8编码的文件转换为ASCII编码,不支持的字符将会被翻译成相似的字符。
7.2 编码转换在实际应用中的重要性
编码转换在数据交换、存储和网络传输中都扮演着重要角色。
7.2.1 数据交换中的编码转换
在不同系统间交换数据时,如果双方使用的编码不一致,就需要进行转换。例如,在异构系统间通信时,接收方需要将发送方的编码转换为自己的内部编码。
7.2.2 网络传输与编码兼容性问题
在互联网上,HTTP协议默认使用UTF-8编码。为了确保在不支持UTF-8的旧系统上也能显示网页内容,需要对内容进行编码转换。
Content-Type: text/html; charset=UTF-8
HTTP响应头中的 Content-Type 指明了内容的编码方式,这有助于浏览器正确解析内容。
小结
编码转换不仅是技术操作,也是确保信息准确传达的关键步骤。在涉及字符编码的各种场景中,掌握转换原理和方法是必要的,而其在实际应用中的重要性也不言而喻。随着数据交换变得更加频繁和复杂,编码转换的角色将变得越来越重要。
简介:字符编码是IT领域文本处理的根基,本文详细介绍四个主要编码标准:UTF-16、UTF-8、ASCII和Unicode,以及它们的相互转换方法。Unicode为全球文字系统提供唯一码点,UTF-8和UTF-16是其两种实现方式。UTF-8以1到4字节表示字符,与ASCII兼容;而UTF-16通常用2字节,对于常见字符效率较高。ASCII编码是基础,仅适用于英文字符。在多平台和多语言应用中,编码转换是必要技能,本文将指导如何使用C++和相关库来实现编码转换,并提供详细的编码转换资源,帮助开发者深入理解并应用于实际项目中。
更多推荐


 9
 0
- 0


 已为社区贡献16条内容

所有评论(0)