
Python实现获取网页所有超链接的完整教程

简介:本指南详细介绍了如何使用Python编程语言,特别是借助 requests 和 BeautifulSoup 库,来获取目标网页上的所有超链接(HTTP和HTTPS)。文章提供了完整的代码示例,展示了从发送HTTP请求到解析HTML文档并提取超链接的整个过程。同时,也强调了在实际应用中可能遇到的复杂情况,并指出了网络爬虫的道德规范和性能优化的必要性。
1. Python网络爬虫基础知识
在当今的互联网时代,网络爬虫(Web Crawler)已成为数据分析、搜索引擎优化、信息聚合等众多领域的基石。Python凭借其简洁的语法和强大的库支持,成为开发网络爬虫的理想语言。本章将为您介绍网络爬虫的基本概念、工作原理以及Python在这一领域的优势。
网络爬虫基本概念
网络爬虫,也称为网络蜘蛛或网络机器人,是自动访问互联网并从中收集信息的程序。其工作原理是通过模拟用户的网络行为,向服务器发出HTTP请求,接收响应并解析其中内容,从而获取所需的数据。
Python在网络爬虫中的优势
Python因其丰富的第三方库支持,在编写网络爬虫时能大幅提升开发效率。它不仅拥有处理HTTP请求的 requests 库,还有用于解析HTML和XML文档的 BeautifulSoup 库等。这些库的存在,使得Python网络爬虫开发变得简单快捷,同时Python的多平台兼容性和良好的社区支持也为项目提供了强大的后盾。
网络爬虫的工作流程
网络爬虫的基本工作流程通常包括以下几个步骤:
- 发起请求:向目标服务器发送HTTP请求。
- 获取响应:接收服务器返回的响应数据。
- 解析内容:提取响应数据中的有效信息。
- 存储数据:将解析出的信息保存到本地或数据库中。
- 递归爬取:对爬取的页面中的链接进行递归访问。
通过本章的学习,您将对网络爬虫的构成和工作方式有一个初步的理解,并为后续深入学习Python网络爬虫的各项技术打下坚实的基础。
2. requests 库用于HTTP请求
2.1 requests 库概述和安装
2.1.1 requests 库的功能介绍
requests 是一个简单易用的HTTP库,专为人类设计,用于执行各种类型的HTTP请求,如GET、POST、PUT、DELETE等。它支持多种内容编码,能够处理表单数据,提供持久化会话、自动处理重定向、超时、压缩等。这个库是用Python编写的,让开发者可以更加专注于业务逻辑,而无需过分关心底层网络通信的细节。
2.1.2 requests 库的安装方法
安装 requests 库非常简单,只需要一行命令。可以在命令行中输入以下指令:
pip install requests
这行命令会调用Python的包安装工具pip,将 requests 库从Python包索引(PyPI)下载并安装到当前Python环境中。安装完成后,可以在Python脚本中直接导入使用。
2.2 requests 库的基本使用
2.2.1 发送GET请求
发送GET请求是最常见的网络请求方式之一。在 requests 库中,可以通过 get 函数实现:
import requests

response = requests.get('https://api.example.com/data')
print(response.text)
上面的代码会向 https://api.example.com/data 发送一个GET请求,并打印出返回的文本内容。 requests 会自动处理HTTP请求的URL编码,支持Cookie的自动处理,还可以设置认证信息。
2.2.2 发送POST请求
相比GET请求,POST请求通常用于提交数据。使用 requests 发送POST请求,可以利用 post 函数:
import requests

data = {'key': 'value'}
response = requests.post('https://api.example.com/submit', data=data)
print(response.json())
在这个例子中,我们向服务器提交了键值对 {'key': 'value'} 的数据,并且假设服务器返回的是JSON格式的数据。 requests.post 函数会将数据以表单形式发送,如果需要发送JSON数据,则可以使用 json 参数:
response = requests.post('https://api.example.com/submit', json=data)
2.2.3 请求头部和参数处理
在发送请求时,有时需要指定请求头或URL参数。 requests 库允许我们轻松地添加这些信息:
import requests

# 设置请求头
headers = {'User-Agent': 'My User Agent 1.0'}
response = requests.get('https://api.example.com/data', headers=headers)

# 添加URL参数
params = {'search': 'python'}
response = requests.get('https://api.example.com/search', params=params)
2.3 requests 库的高级特性
2.3.1 会话保持与Cookies处理
使用 requests 的 Session 对象,可以跨请求保持某些参数,比如Cookies,这对于登录后的会话管理非常有用:
import requests

# 创建一个会话对象
session = requests.Session()

# 发送请求,会话会自动处理Cookies
session.get('https://api.example.com/login')
session.post('https://api.example.com/submit', data={'key': 'value'})
2.3.2 超时设置与异常处理
为了防止服务器响应过慢或无响应,设置请求超时是一个好习惯。 requests 库提供了超时参数,可以避免程序陷入长时间等待:
import requests

try:
    response = requests.get('https://api.example.com/data', timeout=3)
except requests.exceptions.Timeout:
    print('The request timed out')
在执行网络请求时,可能会遇到各种异常。 requests 通过异常处理机制,让开发者可以捕获并处理这些问题:
try:
    response = requests.get('https://api.example.com/data')
    response.raise_for_status()  # 如果请求返回4XX或5XX错误,将抛出HTTPError异常
except requests.exceptions.HTTPError as e:
    print(f'HTTP Error: {e}')
except requests.exceptions.RequestException as e:
    print(f'Error: {e}')
至此,我们已经对 requests 库有了一个全面的了解,包括其基础使用方法和一些高级特性。在下一章节中,我们将介绍如何使用 BeautifulSoup 库对HTML进行解析。
3. ```
第三章: BeautifulSoup 库用于HTML解析
3.1 BeautifulSoup 库概述和安装
3.1.1 BeautifulSoup 库的功能介绍
BeautifulSoup 是一个非常流行的Python库,它从复杂的HTML或XML文件中提取数据。它创建了一个解析树,使得用户可以方便地遍历文档结构,搜索特定的文本标签等。它提供简单的方法来导航、搜索和修改解析树,使得解析HTML或XML文档变得轻松愉快。它利用了如 lxml 或 html.parser 等底层解析器的强大功能,并且在内部将不同的解析器转换为统一的接口。
主要功能如下:
- 支持多种解析器,如
lxml、html.parser等,便于用户根据需要选择。 - 提供简单的方法来导航、搜索和修改解析树。
- 多种方式可以选择和查找文档中的标签,如通过标签名、属性、类名等。
- 可以方便地提取文档中的一些数据,例如链接、图片、文本内容等。
- 支持输出格式化后的文档,使其易于阅读。
3.1.2 BeautifulSoup 库的安装方法
安装 BeautifulSoup 库非常简单,推荐使用pip进行安装,它会自动安装依赖的 bs4 包和一个解析器。执行以下命令:
pip install beautifulsoup4
BeautifulSoup 4 通常需要一个解析器来解析 HTML 或 XML 输入文档。可用的解析器有 lxml 、 html.parser 和 html5lib 。 lxml 是速度快、容错性好的解析器,不过需要额外安装。 html.parser 是Python的标准库,不需要安装。 html5lib 是另一个优秀的库,用于处理HTML5文档,同样需要安装。
如果安装 lxml 作为解析器,可以使用以下命令:
pip install lxml
3.2 BeautifulSoup 库的基本使用
3.2.1 解析HTML文档结构
首先,通过一个简单的例子来展示如何使用 BeautifulSoup 解析HTML文档的结构:
from bs4 import BeautifulSoup

html_doc = """
<html>
<head>
<title>The Dormouse's story</title>
</head>
<body>
<p class="title"><b>The Dormouse's story</b></p>

<p class="story">Once upon a time there were three little sisters; and their names were
<a href="http://example.com/elsie" class="sister" id="link1">Elsie</a>,
<a href="http://example.com/lacie" class="sister" id="link2">Lacie</a> and
<a href="http://example.com/tillie" class="sister" id="link3">Tillie</a>;
and they lived at the bottom of a well.</p>

<p class="story">...</p>
</body>
</html>

soup = BeautifulSoup(html_doc, 'html.parser')

print(soup.prettify())  # 输出格式化后的HTML文档
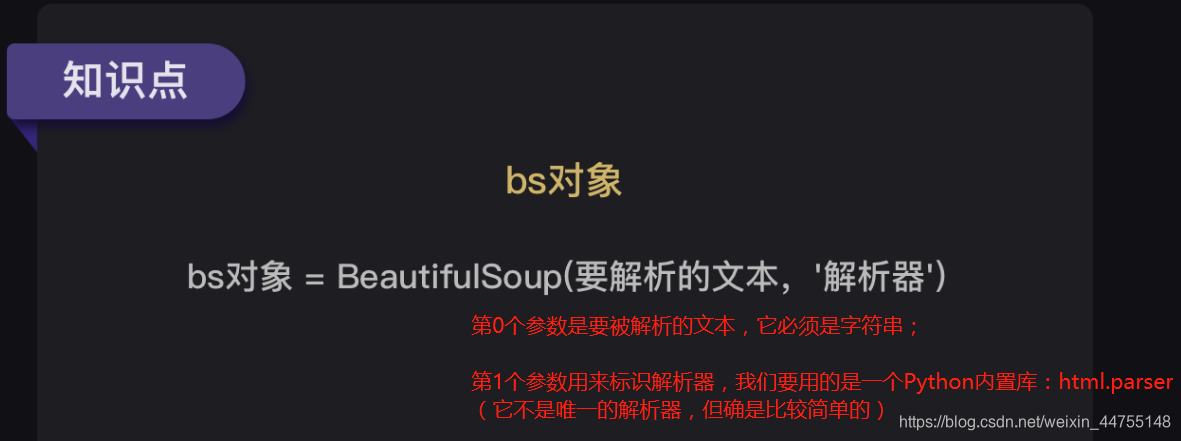
参数 'html.parser' 指定了使用HTML的解析器, prettify() 方法则用于输出格式化后的HTML文档,使得结构一目了然。
3.2.2 搜索和导航HTML元素
接下来,演示如何使用 BeautifulSoup 进行搜索和导航:
# 搜索所有标签为<p>的元素
for p in soup.find_all('p'):
    print(p.text)

# 通过标签名查找
head_tag = soup.find(name="head")

# 通过类名查找
links = soup.find_all(class_="sister")

# 使用CSS选择器查找
link1 = soup.select_one("#link1")

# 获取标签的属性值
link_url = link1.get("href")
在上述代码中, find_all() 和 find() 方法被用来查找页面中特定的标签。 select_one() 方法用来根据CSS选择器选择第一个匹配的元素。 get() 方法用来获取标签的属性值。
3.3 BeautifulSoup 库的高级应用
3.3.1 修改HTML内容
BeautifulSoup 允许修改解析树的结构,比如添加、删除和修改元素。以下是一个修改HTML文档的例子:
# 修改第一个段落的文本
soup.find('p').string = "This is the new text."

# 删除第一个段落中的<b>标签
soup.find('b').decompose()

# 添加一个新的标签
new_tag = soup.new_tag("br")
soup.p.append(new_tag)
通过 string 属性可以改变标签内文本, decompose() 方法用于删除一个标签, new_tag() 方法用来创建一个新标签并添加到文档中。
3.3.2 输出格式化后的HTML
BeautifulSoup 支持输出格式化后的HTML,这在调试时非常有用。可以通过调用 prettify() 方法来实现这一点:
# 输出格式化后的HTML文档
print(soup.prettify())
这个方法会返回一个字符串,里面包含格式化后的HTML文档。它会保持HTML文档的结构,同时使得输出的HTML代码易于阅读。
以上内容为 BeautifulSoup 库在HTML解析方面的基础知识和高级应用。在实际应用中,结合 requests 库及其他工具库,可以构建出功能强大的网络爬虫,用于抓取和解析网页上的数据。在第三章的下一节中,我们将深入探讨如何利用 BeautifulSoup 进行复杂的HTML内容提取,包括表格数据、图片链接、并进行实际案例演示。
# 4. 超链接提取函数的实现

在当今网络信息泛滥的时代,有效的链接提取技术对于网络爬虫构建者来说是十分关键的。链接提取是指从网页中提取出所有超链接的过程,这些链接可以用于爬虫的进一步跳转和数据获取。本章内容将详细介绍如何实现一个超链接提取的函数,并对其实现的需求分析、设计思路、测试与验证进行深入探讨。

## 4.1 超链接提取的需求分析

超链接在网络爬虫中扮演着至关重要的角色。它们不仅构建了互联网上页面之间的链接关系,也为爬虫提供了继续深入网络世界、收集数据的路径。因此,超链接提取的目标和范围是本小节探讨的核心内容。

### 4.1.1 超链接在网络爬虫中的作用

超链接可以被视为网络爬虫在互联网世界中航行的罗盘。每个超链接可能指向一个新的页面、一个新的数据源或新的内容集合。为了保持爬虫的可持续性和数据获取的完整性,准确和高效地提取网页中的超链接显得尤为重要。

超链接提取是爬虫进行数据抓取的起点。利用提取出的链接,爬虫可以进行以下操作:

- **深度优先搜索**:爬虫可以根据链接顺序深入页面结构,逐层抓取内容。
- **广度优先搜索**:爬虫可以先抓取同一层的所有页面,然后再向更深层延伸。
- **特定主题爬取**:通过链接分析,爬虫可以专注于某一主题或网站内的页面。
- **页面更新检测**:通过对比旧链接与新链接,爬虫可以确定页面是否更新。

### 4.1.2 链接提取的目标和范围

链接提取的目标通常分为两个层面:一是提取出页面上所有可见的链接,二是根据特定规则筛选出有价值的链接。链接提取的范围不仅限于页面上的`<a>`标签,也包括了JavaScript生成的动态链接,甚至是`<iframe>`内的内容。

在提取链接时,需要考虑以下因素:

- **链接有效性**:检查链接是否有效,并排除死链接。
- **链接去重**:相同的链接无需多次提取。
- **链接的相对与绝对路径**:将相对路径转换为绝对路径以便于爬取。
- **链接属性**:提取链接的其他属性,如`rel`、`target`等。

## 4.2 函数设计与实现

为了实现超链接提取的功能,我们需要设计一个高效的算法,并将其实现为一个可复用的函数。本小节将详细讨论链接提取函数的设计思路和具体实现。

### 4.2.1 设计思路和算法描述

超链接提取函数的设计需要考虑以下几个关键点:

- **输入输出规范**:定义输入输出的参数格式,如输入为网页源代码,输出为链接列表。
- **解析准确性**:确保HTML解析的准确性,避免误解析其他文本为链接。
- **性能优化**:算法需要足够高效,以支持大规模网页的链接提取。

算法描述如下:

1. **输入**:网页的HTML源代码。
2. **HTML解析**:使用HTML解析库(如`BeautifulSoup`)解析HTML源代码。
3. **链接提取**:利用解析对象查找所有`<a>`标签,并提取`href`属性。
4. **链接过滤**:对提取出的链接进行有效性和去重处理。
5. **输出**:返回处理后的链接列表。

### 4.2.2 编写提取超链接的函数代码

以下是实现链接提取函数的Python代码示例:

```python
from bs4 import BeautifulSoup

def extract_links(html):
    soup = BeautifulSoup(html, 'html.parser')
    links = set()
    for link in soup.find_all('a', href=True):
        href = link['href']
        # 过滤掉非HTTP和HTTPS的链接
        if href.startswith(('http://', 'https://')):
            links.add(href)
    return list(links)

# 示例HTML源代码
html_example = '''
<html>
    <body>
        <a href="http://www.example.com/page1">Page 1</a>
        <a href="/page2">Page 2</a>
        <!-- More content -->
    </body>
</html>

# 使用函数
extracted_links = extract_links(html_example)
print(extracted_links)
该函数首先使用 BeautifulSoup 进行HTML解析,然后遍历所有 <a> 标签,并提取 href 属性。利用集合(set)数据结构可以自动去重。最终返回一个包含所有有效链接的列表。
4.3 函数测试与验证
为了验证超链接提取函数的正确性和稳定性,需要准备测试用例并对函数测试结果进行分析。测试过程能够确保函数在各种情况下均能正确运行。
4.3.1 测试用例的准备
测试用例应覆盖常见情况:
- 包含不同协议(http、https)的链接。
- 包含绝对路径和相对路径的链接。
- 包含特殊字符和编码的链接。
- 包含JavaScript动态生成的链接。
- 包含
<iframe>中的链接。 - 包含无
href属性的<a>标签。 - 包含重复的链接。
4.3.2 函数测试结果分析
在测试过程中,需要对函数输出的链接列表与预期结果进行逐一比对。测试用例应当覆盖上述所有情况,并且测试结果应当满足以下条件:
- 所有有效链接被正确提取。
- 所有无效链接(如错误格式链接、重复链接)被排除。
- 链接顺序不影响测试结果,因为最终结果是一个列表。
- 测试应确保函数在各种异常情况下的鲁棒性。
通过测试,我们可以发现函数可能存在的问题并加以改进,以确保其在实际使用中的稳定性和可靠性。
5. 代码示例及其运行
5.1 完整代码展示
5.1.1 整合请求与解析代码
在本章节中,我们将展示如何将前面章节中学到的知识点整合到一个实际的网络爬虫项目中。以下是一个简单的网络爬虫代码示例,它使用 requests 库来发送HTTP请求,并利用 BeautifulSoup 库来解析网页内容,提取网页上的所有超链接。
import requests
from bs4 import BeautifulSoup

def get_html(url):
    try:
        response = requests.get(url, timeout=30)
        response.raise_for_status()
        response.encoding = response.apparent_encoding
        return response.text
    except requests.HTTPError as http_err:
        print(f'HTTP error occurred: {http_err}')
    except Exception as err:
        print(f'An error occurred: {err}')

def parse_html(html):
    soup = BeautifulSoup(html, 'html.parser')
    links = set()
    for link in soup.find_all('a', href=True):
        links.add(link['href'])
    return links

def main():
    url = 'https://example.com'
    html = get_html(url)
    if html:
        links = parse_html(html)
        print('Found links:', len(links))
        for link in links:
            print(link)

if __name__ == "__main__":
    main()
上述代码首先通过 get_html 函数获取网页的HTML内容。如果请求成功,它会返回网页的HTML字符串;否则,会打印出错误信息。随后, parse_html 函数使用 BeautifulSoup 解析HTML,查找所有的 <a> 标签并提取 href 属性,即超链接。最后, main 函数负责运行整个流程并打印出结果。
5.1.2 美化输出结果的格式
为了让输出结果更易于阅读,我们可以通过添加一些格式化来美化输出的超链接。下面是一个简单的例子,它展示了如何将超链接格式化为带有文本的列表形式。
def format_links(links):
    for link in links:
        print(f'- [{link}]({link})')

# 在main函数中添加下面的代码行
if __name__ == "__main__":
    main()
    print('\nFormatted list of links:')
    format_links(links)
上述代码段在 main 函数成功获取和解析链接后调用 format_links 函数,该函数遍历所有链接并将它们格式化为一个可点击的Markdown链接列表。
5.2 代码运行与调试
5.2.1 运行代码并观察结果
当我们的代码已经整合并格式化后,接下来的步骤是实际运行代码,并观察输出结果是否符合预期。运行上述代码,预期将会看到类似下面的输出:
Found links: 10
https://example.com/page1
https://example.com/page2

Formatted list of links:
- [https://example.com/page1](https://example.com/page1)
- [https://example.com/page2](https://example.com/page2)
如果输出结果中包含了错误或者异常信息,说明可能存在问题。根据错误信息,我们可以进一步分析问题所在并进行调试。
5.2.2 常见错误及调试方法
在运行爬虫代码时,可能会遇到各种类型的错误,以下是一些常见错误及其调试方法:
-
HTTPError:这个错误通常是因为服务器返回了不期望的HTTP响应码。检查get_html函数中是否正确处理了不同的响应码。 -
ConnectionError:这个错误表示连接请求失败。检查URL是否正确,网络连接是否正常。 -
Timeout:请求超时。检查timeout参数设置是否合理,或者目标服务器响应是否过慢。 -
DecodeError:无法解码网页内容。确保response.encoding设置正确,或者网页内容编码不一致时进行适当的异常处理。
针对上述错误,可能需要根据实际情况进行相应的调整和修复。例如,检查 requests.get 函数中的URL是否正确,设置合理的 timeout 值,确保服务器响应能够被正确解析等。通过逐步排查和测试,我们可以提高代码的健壮性和可靠性。
以上是整合使用 requests 和 BeautifulSoup 进行网络爬虫开发的简要介绍。在实际的开发过程中,还应考虑异常处理、日志记录和爬虫的优化策略等因素,以确保爬虫能够在各种环境下稳定运行。
6. 网络爬虫的道德规范和性能优化
在构建网络爬虫时,不仅要关注技术细节,还要重视爬虫行为的合法性和道德性。同时,优化爬虫性能,提高其运行效率,是开发过程中不可或缺的一环。本章将深入探讨网络爬虫的道德规范和性能优化策略。
6.1 网络爬虫的道德规范
在进行网络数据爬取前,了解并遵守相关的道德规范是至关重要的。这不仅关乎个人和企业的法律风险,也是对网络生态负责任的体现。
6.1.1 遵守Robots协议
Robots协议是一个放置在网站根目录下的文件,通常名为robots.txt。它规定了哪些内容可以被爬虫访问,哪些不可以。例如:
User-agent: *
Disallow: /private/
以上协议说明任何爬虫(User-agent: *)都不允许爬取以/private/开头的路径。
编写爬虫时,应先检查目标网站是否有robots.txt文件,如果存在,使用爬虫之前应遵循其规定。不遵守可能会导致法律纠纷或对网站正常运营造成影响。
6.1.2 数据抓取的合法性和隐私保护
抓取的数据必须是公开且合法可获取的,不得侵犯版权或其他法律规定的内容。同时,在处理个人数据时,必须遵守相应的隐私保护法律,如GDPR。
6.2 网络爬虫的性能优化
在确保符合法律法规的前提下,对网络爬虫进行性能优化,可以提高爬取效率,降低对目标服务器的影响。
6.2.1 减少请求次数和带宽占用
有效减少请求次数和带宽占用,可以提高爬虫效率并降低服务器压力:
- 合理设置请求延时 :避免过快地发出请求,给服务器造成不必要的负担。可以使用
time.sleep()函数来设置延时:
import requests
from time import sleep

headers = {'User-Agent': 'Mozilla/5.0'}
url = 'http://example.com'

response = requests.get(url, headers=headers)
sleep(1)  # 休眠1秒
- 利用缓存机制 :通过设置缓存,爬虫可以避免重复请求已访问过的资源。可以使用
requests库的Response.history属性检查页面访问记录。
6.2.2 使用代理和IP池避免封禁
为了避免频繁请求同一IP被网站封禁,可以使用代理IP或构建IP池:
- 代理池 :通过维护一个代理服务器列表,每次请求时随机选择一个代理,可以有效分散请求频率。
import requests
from random import choice

proxies = {
    'http': 'http://10.10.1.10:3128',
    'https': 'http://101.50.20.10:3128',
}
proxy = choice(list(proxies.values()))
response = requests.get('http://example.com', proxies={"http": proxy, "https": proxy})
- IP池 :可以自行维护或者使用第三方服务,周期性更换IP地址进行请求,减少单个IP被封的风险。
通过以上这些措施,可以在保证网络爬虫法律合规的同时,有效提升其运行效率和稳定性。在后续的工作中,进一步探索和实践这些优化策略是十分必要的。
简介:本指南详细介绍了如何使用Python编程语言,特别是借助 requests 和 BeautifulSoup 库,来获取目标网页上的所有超链接(HTTP和HTTPS)。文章提供了完整的代码示例,展示了从发送HTTP请求到解析HTML文档并提取超链接的整个过程。同时,也强调了在实际应用中可能遇到的复杂情况,并指出了网络爬虫的道德规范和性能优化的必要性。
更多推荐

 29
 0
- 0


 已为社区贡献28条内容

所有评论(0)