
深度学习在癌症识别中的应用:从医疗图像分类到前后端集成

简介:本项目提供了一个深度学习解决方案,用于医疗图像分类,尤其关注癌症的早期检测和识别。项目采用Keras框架进行模型训练,并通过Flask后端与Vue.js前端的集成,实现一个端到端的癌症识别系统。项目包括数据预处理、模型训练与验证、以及模型评估等关键环节,为医生提供了一个快速准确的辅助诊断工具。 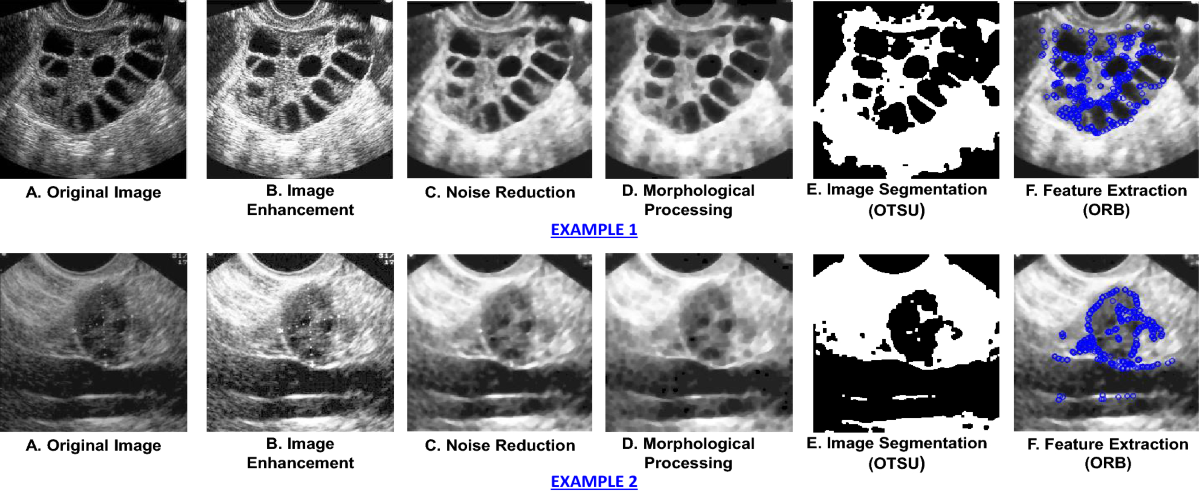
1. 深度学习在医疗图像分类中的应用
1.1 医疗图像分类的挑战与需求
医疗图像分类是深度学习技术在医疗领域的重要应用之一,其主要挑战在于处理大量的医学影像数据,并从中提取出有助于诊断的关键信息。由于医学影像包含的细节非常丰富,且对精度要求极高,传统的图像处理方法很难满足实际需求。深度学习特别是卷积神经网络(CNN)因其在图像识别领域展现出的卓越性能,已经成为解决这一问题的有力工具。
1.2 深度学习模型在医疗图像分类的实践
在实践中,深度学习模型需要经过大量的训练数据来学习识别各种图像特征。利用现代深度学习框架如TensorFlow或PyTorch,可以构建复杂的网络结构,如AlexNet、VGG、ResNet等,它们在众多医疗图像分类任务中都取得了突破性的进展。模型训练完成后,其可以作为智能诊断系统的一部分,辅助医生进行精确快速的疾病检测和分类。
1.3 应用案例与效果评估
例如,在乳腺癌筛查中,深度学习模型可以对乳腺X光片进行分类,帮助识别出可能患有癌症的患者。此类系统在训练集和测试集上的效果评估,通常需要依赖精确的性能指标,如准确率、召回率、F1分数和ROC曲线等。通过与传统诊断方法进行比较,深度学习模型在识别速度和准确性上均显示出显著的优势。
# 示例代码:评估模型在乳腺癌检测上的表现
from sklearn.metrics import classification_report, confusion_matrix

# 假设我们已经完成了模型的训练,以下是评估阶段的代码
y_true = ... # 真实标签
y_pred = model.predict(X_test) # 预测结果

# 计算性能指标
report = classification_report(y_true, y_pred, target_names=["健康", "癌变"])
conf_matrix = confusion_matrix(y_true, y_pred)

print(report)
print(conf_matrix)
以上代码段展示了如何使用scikit-learn库对模型预测结果进行性能评估,并打印出分类报告和混淆矩阵。通过这些评估指标,开发者能够了解模型在各类别上的表现,并据此进行进一步的优化。
2. Keras框架在训练深度学习模型中的使用
2.1 Keras框架的介绍与安装
2.1.1 Keras框架的特点与优势
Keras是一个用Python编写的开源神经网络库,它能够以TensorFlow, CNTK, 或 Theano作为后端运行。它被设计为快速的实验原型和多实验的平台,具有用户友好、模块化、可扩展等特性。
- 用户友好 :Keras的设计原则是用户友好,最小化用户的工作量。它提供了高层次的抽象,可以让你快速地设计和实验新的神经网络架构。
- 模块化 :所有的Keras模块都是可以独立使用的,你也可以混合搭配使用,这使得Keras非常灵活,满足不同复杂度的需求。
- 易于扩展 :你可以通过创建新的模块来添加新的功能,也可以编写自己的可重复使用的模块,无需修改现有的代码。
- 工作流直观 :Keras尽量减少用户的操作,以直觉和最小的动作完成复杂的工作,这使得其学习曲线相对平缓。
2.1.2 Keras框架的安装与环境配置
Keras的安装非常简单。你可以通过Python的包管理工具pip来安装。推荐在虚拟环境中进行安装,以便于管理不同项目之间的依赖关系。
pip install keras
安装完成后,你可以通过导入Keras来验证安装是否成功。
import keras
print(keras.__version__)
如果你打算使用TensorFlow作为Keras的后端,还需要安装TensorFlow:
pip install tensorflow
选择不同的后端需要在 ~/.keras/keras.json 中设置 backend 选项。以下是Keras支持的后端:
{
    "image_data_format": "channels_last",
    "epsilon": 1e-07,
    "backend": "tensorflow"
}
此外,配置好你的开发环境,如IDE(集成开发环境),比如PyCharm或VSCode,并配置好Python解释器路径。
在进行环境配置时,确保Python版本与Keras和后端库兼容,并考虑安装其他库,如numpy、pandas和matplotlib,这些库在数据分析和可视化时非常有用。
2.2 Keras模型构建基础
2.2.1 Keras模型的结构与层类型
Keras中构建模型的基础结构包括顺序模型(Sequential)和函数式API(Functional API)。我们先从顺序模型开始。
顺序模型是最简单的模型类型,可以创建一个线性堆叠的层序列。
from keras.models import Sequential
from keras.layers import Dense

model = Sequential()
model.add(Dense(units=64, activation='relu', input_shape=(100,)))
model.add(Dense(units=10, activation='softmax'))
在这个例子中,我们创建了一个有两个全连接层的简单神经网络模型。每层都定义了神经元的个数 units 和激活函数 activation 。第一个层还定义了输入数据的形状 input_shape 。
函数式API提供了更多的灵活性和能力,允许构建任意的模型图。以下是一个使用函数式API的简单例子:
from keras.layers import Input, Dense
from keras.models import Model

input_tensor = Input(shape=(100,))
x = Dense(64, activation='relu')(input_tensor)
output_tensor = Dense(10, activation='softmax')(x)
model = Model(inputs=input_tensor, outputs=output_tensor)
在这个例子中,我们使用 Input 来创建一个输入层,并通过链式调用 Dense 层来建立复杂的连接。
2.2.2 Keras模型的损失函数和优化器
损失函数用于衡量模型的预测值与真实值之间的差异,优化器用于调整模型的权重,以便最小化损失函数。
常见的损失函数包括均方误差( mean_squared_error )用于回归问题和交叉熵损失( categorical_crossentropy 或 sparse_categorical_crossentropy )用于分类问题。
from keras import losses

loss = losses.categorical_crossentropy
Keras提供了多种优化器,比如SGD(随机梯度下降)、Adam、RMSprop等。通常情况下,Adam优化器是一个不错的选择。
from keras.optimizers import Adam

optimizer = Adam(lr=0.001)
在定义模型时,你需要将损失函数和优化器指定在 compile 方法中:
model.compile(loss=loss, optimizer=optimizer, metrics=['accuracy'])
在 metrics 参数中,我们可以指定模型训练过程中需要监控的指标,如准确率( accuracy )。
2.3 Keras高级应用技巧
2.3.1 Keras回调函数的使用与自定义
回调函数(Callbacks)在训练的不同阶段被调用,可用于实现模型检查点保存、早停(early stopping)和学习率调整等功能。
Keras默认提供了一些常用的回调函数,例如ModelCheckpoint用于保存模型:
from keras.callbacks import ModelCheckpoint

checkpoint = ModelCheckpoint('model-{epoch:03d}.h5', save_best_only=True)
callbacks_list = [checkpoint]
我们还可以自定义回调函数。比如,创建一个简单的回调函数来记录每次迭代后的损失值:
from keras.callbacks import Callback

class LossHistory(Callback):
    def on_train_begin(self, logs={}):
        self.losses = []

    def on_batch_end(self, batch, logs={}):
        self.losses.append(logs.get('loss'))

loss_history = LossHistory()
callbacks_list.append(loss_history)
2.3.2 Keras模型的保存与加载
在训练完模型后,我们通常希望保存模型的结构和权重。这可以通过 save 方法轻松完成:
model.save('my_model.h5')
之后,你可以通过 load_model 函数来加载保存的模型:
from keras.models import load_model

model = load_model('my_model.h5')
加载模型后,你可以继续使用模型进行预测或进一步训练。
2.4 Keras的模型微调与迁移学习
在深度学习项目中,模型的微调和迁移学习是常见的高级技巧。微调是使用在其他任务上预先训练好的模型作为起点,调整模型在新的数据集上进行训练。迁移学习则是将预训练模型的一部分作为新模型的基础,并根据需要对这些层进行训练。
Keras通过提供一系列预训练的模型(如VGG16、VGG19、ResNet等)来简化迁移学习的过程。以下是使用预训练模型VGG16进行微调的一个例子:
from keras.applications import VGG16
from keras.models import Model
from keras.layers import Dense, Flatten

# 加载预训练模型,但不包含顶层
base_model = VGG16(weights='imagenet', include_top=False)

# 冻结预训练模型的权重
for layer in base_model.layers:
    layer.trainable = False

# 添加新层
x = Flatten()(base_model.output)
x = Dense(1024, activation='relu')(x)
predictions = Dense(num_classes, activation='softmax')(x)

# 构建最终的模型
model = Model(inputs=base_model.input, outputs=predictions)

# 编译模型
model.compile(optimizer='adam', loss='categorical_crossentropy', metrics=['accuracy'])
在这个例子中,我们使用了VGG16模型的卷积层作为新模型的基础,并在顶部添加了两个全连接层。我们首先冻结预训练层的权重,之后再进行训练。一旦我们的新层在特定数据集上训练好,我们可以解冻预训练层并继续训练来进一步微调模型。
3. Flask后端服务的实现与功能
3.1 Flask基础与路由机制
3.1.1 Flask框架介绍与安装
Flask是一个广泛使用的Python微框架,专为Web开发而设计。它的轻量级和模块化使得它成为一个快速搭建Web应用和API的极佳选择。Flask的核心是基于Werkzeug WSGI工具包和Jinja2模板引擎。Werkzeug负责处理Web服务器与WSGI之间的交互,而Jinja2则负责渲染动态网页。
安装Flask是相对简单的步骤。您可以使用Python的包管理器pip进行安装:
pip install Flask
确保安装成功后,可以创建一个简单的Flask应用来测试安装:
from flask import Flask

app = Flask(__name__)

@app.route('/')
def hello_world():
    return 'Hello, Flask!'

if __name__ == '__main__':
    app.run(debug=True)
上述代码创建了一个基本的Flask应用,它会在本地服务器的5000端口运行。当用户访问根URL(即'/')时,会返回一个简单的欢迎信息。
3.1.2 Flask路由与视图函数
在Flask中,路由是通过装饰器@app.route来实现的,它告诉Flask哪些URL可以触发哪个函数。视图函数是一个返回响应的函数,它被路由装饰器装饰以关联一个特定的URL。
@app.route('/greet/<name>')
def greet(name=None):
    return f"Hello, {name}!"
在上述例子中,装饰器@app.route定义了一个新的路由/greet/,该路由包含一个参数name。任何符合这种模式的URL都会被路由到greet视图函数,并将URL路径中紧跟/greet/后的部分作为name参数的值传递给该函数。
为了更加灵活地处理参数,Flask支持转换器类型,例如 、 等。这些转换器可以限制参数的类型,并确保传入的值满足要求。
3.2 Flask数据处理与RESTful API设计
3.2.1 Flask数据接收与响应处理
Flask提供了多种方式来接收客户端发送的数据,包括表单数据、JSON数据等。这些数据可以通过Flask的request对象访问。
- 使用request.args来获取URL中的查询字符串参数。
- 使用request.form来获取POST表单数据。
- 使用request.json来获取JSON格式的数据。
下面是一个处理JSON数据的例子:
from flask import Flask, request, jsonify

app = Flask(__name__)

@app.route('/api/data', methods=['POST'])
def handle_data():
    data = request.json
    # 对data进行处理
    return jsonify({'success': True, 'data': data})
在这个例子中,我们定义了一个名为 /api/data 的路由,并设置它只接收POST请求。Flask的 jsonify 函数用于将Python字典转换为JSON格式的响应。
3.2.2 RESTful API设计原则与实践
RESTful API是一种Web服务架构风格,其核心原则是使用HTTP协议的动词(GET, POST, PUT, DELETE等)来定义操作资源的行为,并通过URL来指定资源。
在设计RESTful API时,Flask提供了一个非常灵活的方式来处理不同的HTTP方法。以下是一些基本实践:
- 使用GET方法来请求资源。
- 使用POST方法来创建新资源。
- 使用PUT方法来更新资源。
- 使用DELETE方法来删除资源。
举个例子,创建一个处理用户资源的RESTful API:
from flask import Flask, request, jsonify

app = Flask(__name__)

# 获取所有用户
@app.route('/api/users', methods=['GET'])
def get_users():
    # 实现获取逻辑
    pass

# 创建新用户
@app.route('/api/users', methods=['POST'])
def create_user():
    # 实现创建逻辑
    pass

# 更新用户
@app.route('/api/users/<int:user_id>', methods=['PUT'])
def update_user(user_id):
    # 实现更新逻辑
    pass

# 删除用户
@app.route('/api/users/<int:user_id>', methods=['DELETE'])
def delete_user(user_id):
    # 实现删除逻辑
    pass
3.3 Flask进阶应用与性能优化
3.3.1 Flask中间件与日志管理
Flask中间件是一种在请求处理到视图函数之前插入代码的方式。Flask的上下文全局变量允许你存储数据,这样在整个请求的生命周期中,Flask能够访问这些变量。
一个典型的中间件可能如下所示:
from flask import request, g

@app.before_request
def before_request():
    g.start_time = time.time()
日志管理是任何后端服务的关键组成部分。Flask使用Python的内置日志库,你可以如下配置:
import logging

logging.basicConfig(filename='app.log', level=logging.INFO)

@app.route('/')
def index():
    logging.info('Access to index page')
    return 'Hello, World!'
3.3.2 Flask性能优化策略
Flask虽然轻量,但有些优化策略可以帮助提升性能:
- 使用缓存来减少数据库查询的次数。
- 使用异步请求处理。
- 启用Gunicorn或uWSGI等WSGI服务器,这些服务器提供了更加高效的工作方式。
一个简单的缓存策略是使用Flask-Caching扩展:
pip install Flask-Caching
然后在你的Flask应用中配置缓存:
from flask_caching import Cache

app.config['CACHE_TYPE'] = 'simple'
cache = Cache(app)

@cache.cached(timeout=50)
def expensive_function(a, b):
    # 这个函数将只计算一次,结果被缓存50秒
    return a + b
通过使用这些策略,你将能够提升Flask应用的性能,使其更加高效地处理请求。
4. Vue.js前端界面的设计与用户体验
在构建现代的Web应用时,用户体验至关重要。Vue.js作为一款流行的JavaScript框架,它的响应式数据绑定和组件化设计使得开发交互式用户界面变得更加简单和高效。本章将深入探讨Vue.js的基础知识、组件化开发、状态管理、路由控制以及高级应用和性能优化的策略。
4.1 Vue.js基础与组件化开发
4.1.1 Vue.js框架介绍与安装
Vue.js是一种渐进式JavaScript框架,主要用于构建用户界面。它的核心库只关注视图层,易于上手,同时通过组件化方式可以高效构建复杂的单页应用。Vue.js的设计哲学是尽可能地让开发者摆脱繁琐的工作,专注于业务逻辑。
在开始使用Vue.js之前,你需要先在项目中安装它。可以通过CDN的方式直接在HTML文件中引入Vue.js,或者使用npm包管理器在项目中安装它。
<!-- 通过CDN引入Vue.js -->
<script src="https://cdn.jsdelivr.net/npm/vue@2.6.12"></script>
# 使用npm安装Vue.js
npm install vue
4.1.2 Vue.js组件化设计与实现
组件化是Vue.js中的核心概念。组件允许我们将界面分割成独立的部分,每个部分都可以独立地开发和维护。Vue.js的组件可以扩展HTML元素,封装可重用的代码。组件之间的通信是通过prop传递数据,通过自定义事件实现。
在Vue.js中创建一个简单的计数器组件示例如下:
// 定义一个名为counter的Vue组件
Vue.component('counter', {
  template: '<div>{{ count }}</div>',
  data: function() {
    return {
      count: 0
    }
  },
  methods: {
    increment: function() {
      this.count++;
    },
    decrement: function() {
      this.count--;
    }
  }
});

// 创建Vue根实例
new Vue({
  el: '#app',
  components: { Counter }
});
<!-- 在HTML中使用counter组件 -->
<div id="app">
  <counter></counter>
</div>
在Vue.js中,每个组件都是一个独立的Vue实例,它们拥有自己的选项对象。组件可以定义自己的模板、数据、方法和生命周期钩子等。
4.2 Vue.js状态管理和路由控制
4.2.1 Vue.js状态管理Vuex的使用
当应用变得更加复杂时,组件间共享状态的问题就会变得越来越明显。在Vue.js中,我们通常使用Vuex来管理状态。Vuex是一个专为Vue.js应用程序开发的状态管理模式和库。它采用集中式存储管理应用的所有组件的状态,并以相应的规则保证状态以可预测的方式发生变化。
安装Vuex并配置状态管理的基本步骤如下:
npm install vuex --save
import Vue from 'vue';
import Vuex from 'vuex';

Vue.use(Vuex);

const store = new Vuex.Store({
  state: {
    count: 0
  },
  mutations: {
    increment(state) {
      state.count++;
    },
    decrement(state) {
      state.count--;
    }
  }
});

new Vue({
  el: '#app',
  store
});
4.2.2 Vue.js路由控制Vue Router的实现
随着Web单页应用的发展,页面的路由管理成为了前端框架的一个重要组成部分。Vue.js通过Vue Router插件来实现路由控制。Vue Router是官方推荐的用于构建单页应用的路由插件。
安装Vue Router并配置基本路由的步骤如下:
npm install vue-router --save
import Vue from 'vue';
import VueRouter from 'vue-router';
import Home from './components/Home';
import About from './components/About';

Vue.use(VueRouter);

const routes = [
  { path: '/', component: Home },
  { path: '/about', component: About }
];

const router = new VueRouter({
  routes
});

new Vue({
  el: '#app',
  router
});
通过以上代码,我们定义了两个页面路由:首页和关于页面。在Vue组件中,可以使用 <router-link> 标签定义导航链接, <router-view> 用于渲染匹配的组件。
4.3 Vue.js高级应用与性能优化
4.3.1 Vue.js动态样式绑定与混合
Vue.js允许开发者通过动态样式绑定来改变元素的样式。这通常通过使用 :class 和 :style 指令来实现。动态样式绑定为Vue.js应用带来了极大的灵活性和动态性。
<div :class="{'active': isActive}">This is active if isActive is true.</div>
data: {
  isActive: true
}
以上代码将 isActive 状态绑定到 div 的 active 类上。当 isActive 的值改变时,元素的类也会相应地改变。
在Vue.js中还可以使用 <style> 标签的 scoped 属性,来确保组件的样式只应用于当前组件。这避免了样式的全局污染,实现了样式的局部化。
4.3.2 Vue.js单页面应用性能优化技巧
当构建复杂的应用时,性能优化就显得尤为重要。Vue.js提供了一些工具和方法来帮助开发者优化其应用性能。
- 使用
v-show或v-if来控制元素的显示与隐藏,避免不必要的DOM操作。 - 使用
v-for时加上:key属性,帮助Vue追踪每个节点的身份,从而重用和重新排序现有元素。 - 使用
v-once指令绑定的元素只渲染一次,不再随数据变化而更新,适用于静态内容。 - 使用Vue Devtools进行开发时的性能调试。
- 利用生产模式下的构建工具,如webpack的UglifyJS插件,压缩代码和减小体积。
- 通过分析应用中哪些组件是不需要响应式的,可以在
Vue.prototype中预先定义这些组件,提高初始化效率。
通过以上方法,可以有效减少Vue应用的加载时间和运行时的资源消耗,从而提升用户体验。
在本章中,我们详细探讨了Vue.js在前端界面设计和用户体验方面的基本概念、组件化开发、状态管理以及高级应用和性能优化。下一章节将关注Flask后端服务的实现与功能。
5. 癌症识别的自动化处理流程
5.1 项目自动化流程概述
5.1.1 自动化流程设计的重要性
在现代IT项目中,自动化流程的设计是提高效率、减少人为错误的关键。特别是在医疗图像分类等需要高度精确和重复性的领域,自动化流程可以确保每个步骤都按照预定的标准执行,从而提升整体项目的可复现性和可靠性。
自动化流程设计涉及到的主要方面包括数据收集、数据处理、模型训练、模型评估、模型部署等。通过自动化流程,开发者可以解放双手,将更多的时间投入到创新和优化中,而不是重复繁琐的手动操作。
5.1.2 自动化流程的设计原则与实践
设计有效的自动化流程需要遵循一定的原则。首先,流程应该简单明了,易于理解和维护。其次,它应该是模块化的,这意味着流程中的每个步骤都可以独立于其他步骤进行调整或替换。最后,流程应该是可扩展的,以支持新的需求和技术的发展。
在实践中,自动化流程往往依赖于一系列工具和脚本的配合,例如使用GitHub Actions、GitLab CI/CD或其他持续集成/持续部署(CI/CD)工具来自动化代码的构建、测试和部署。
5.2 自动化处理流程中的关键技术
5.2.1 自动化数据预处理技术
数据预处理是机器学习和深度学习项目中一个关键步骤。在医疗图像分类领域,自动化数据预处理可以包括图像的裁剪、缩放、归一化以及图像增强等步骤。通过编写脚本或使用图像处理库(如OpenCV或Pillow),可以实现数据的标准化和优化,为后续的模型训练打下良好的基础。
例如,使用Python中的Pillow库自动化处理图像:
from PIL import Image

# 自动调整图像大小至统一尺寸
def resize_image(image_path, target_size=(128, 128)):
    image = Image.open(image_path)
    resized_image = image.resize(target_size, Image.ANTIALIAS)
    return resized_image

# 调用函数,处理图像
resized_image = resize_image('path/to/image.jpg')
resized_image.save('path/to/resized_image.jpg')
5.2.2 自动化模型训练与部署技术
自动化模型训练涉及到编写脚本来执行模型的训练过程,包括模型的选择、训练数据的加载、训练的执行以及模型的保存。自动化部署则涉及到将训练好的模型部署到生产环境,包括设置服务器、配置负载均衡、确保模型的高性能运行等。
例如,使用Python的 keras 库自动化模型训练过程:
from keras.models import Sequential
from keras.layers import Dense, Dropout, Flatten
from keras.layers.convolutional import Conv2D, MaxPooling2D
from keras.optimizers import Adam
from keras.preprocessing.image import ImageDataGenerator

# 模型结构定义
model = Sequential()
model.add(Conv2D(32, (5, 5), input_shape=(128, 128, 3), activation='relu'))
model.add(MaxPooling2D(pool_size=(2, 2)))
model.add(Flatten())
model.add(Dense(128, activation='relu'))
model.add(Dropout(0.5))
model.add(Dense(1, activation='sigmoid'))

# 编译模型
model.compile(loss='binary_crossentropy', optimizer=Adam(lr=0.0001), metrics=['accuracy'])

# 使用ImageDataGenerator进行图像增强
train_datagen = ImageDataGenerator(
    rescale=1. / 255,
    shear_range=0.2,
    zoom_range=0.2,
    horizontal_flip=True)

test_datagen = ImageDataGenerator(rescale=1. / 255)

# 加载训练和测试数据集
train_generator = train_datagen.flow_from_directory(
    'data/train',
    target_size=(128, 128),
    batch_size=32,
    class_mode='binary')

validation_generator = test_datagen.flow_from_directory(
    'data/validation',
    target_size=(128, 128),
    batch_size=32,
    class_mode='binary')

# 训练模型
model.fit(
    train_generator,
    steps_per_epoch=2000 // 32,
    epochs=50,
    validation_data=validation_generator,
    validation_steps=800 // 32)
5.3 自动化流程的监控与日志管理
5.3.1 自动化流程监控工具与实践
自动化流程的监控是确保系统稳定运行的重要组成部分。可以采用如Prometheus、Grafana等工具来监控系统性能、资源使用情况、服务可用性等关键指标。这些工具通常与自动化部署流程相结合,以提供实时的性能反馈和警报机制。
使用Prometheus和Grafana监控自动化流程的一个基本示例:
graph LR
A[Prometheus] -->|抓取| B[目标服务]
B -->|暴露指标| A
A -->|数据存储| C[时序数据库]
C -->|查询| D[Grafana]
D -->|可视化监控| E[监控仪表板]
5.3.2 自动化流程日志管理策略
日志管理是自动化流程中不可或缺的一部分,它帮助开发者追踪系统行为、快速定位问题并收集必要的运行数据。一个好的日志管理策略包括日志的格式化、级别划分、归档以及长期存储。在Python中,可以使用如 logging 模块来配置日志系统:
import logging

# 配置日志系统
logging.basicConfig(level=logging.INFO,
                    format='%(asctime)s %(levelname)-8s %(message)s',
                    datefmt='%Y-%m-%d %H:%M:%S',
                    filename='app.log',
                    filemode='a')

# 记录一条信息
logging.info('This is an info message')
通过结合上述工具和技术,医疗图像分类项目中的自动化处理流程可以被有效地设计和实现,从而提升整个项目的效率和可靠性。
6. 医疗图像的数据预处理技术
医疗图像处理是深度学习在医疗领域应用的关键步骤之一,其准确性和效率直接影响最终模型的性能。在这一章节中,我们将深入探讨医疗图像数据预处理的策略和技巧,以及如何应用这些技术来提升模型的准确性。
6.1 医疗图像数据预处理概论
6.1.1 医疗图像的特点与挑战
医疗图像,比如X射线、CT扫描、MRI以及超声波图像,具有高维数、小样本以及类别不平衡等特点。图像数据量通常较大,且在不同设备或不同扫描协议下可能存在较大差异。这些挑战使得直接应用原始数据进行深度学习模型训练时,效果往往不佳。
6.1.2 数据预处理的重要性与步骤
预处理医疗图像以提高数据质量对模型性能至关重要。预处理步骤一般包括图像标准化、归一化、增强等,目的是减少数据的噪声,提高模型对数据特征的识别能力。预处理后的图像数据应当保持原有的医学特征信息,同时去除不相关的变异性。
6.2 医疗图像增强与标准化
6.2.1 图像增强技术
图像增强是提高图像质量的关键步骤,可以增强图像的特定特征,如对比度、边缘细节等。在医疗图像处理中,增强技术有助于医生识别疾病的征兆。
举例说明,下面的代码展示了如何使用Python的OpenCV库进行对比度和亮度调整,以增强CT扫描图像。
import cv2
import numpy as np

def adjust_brightness_contrast(image, alpha=1.0, beta=0):
    """
    Adjusts the brightness and contrast of an image.
    Args:
    - image: the original image in numpy array format.
    - alpha: scaling factor for image intensity.
    - beta: intensity shift for image intensity.
    Returns:
    - The brightness and contrast adjusted image.
    """
    adjusted = cv2.convertScaleAbs(image, alpha=alpha, beta=beta)
    return adjusted

# 读取医疗图像
image = cv2.imread('path/to/medical_image.png')

# 应用调整
adjusted_image = adjust_brightness_contrast(image, alpha=1.2, beta=30)

# 显示原图和调整后的图像
cv2.imshow('Original image', image)
cv2.imshow('Adjusted image', adjusted_image)
cv2.waitKey(0)
cv2.destroyAllWindows()
6.2.2 图像标准化方法
图像标准化是数据预处理中用于确保输入数据具有统一的格式和规模的标准过程。在医疗图像处理中,标准化有助于消除由于成像设备和协议不同带来的差异。
例如,我们可以将图像像素值统一映射到0-1范围,具体方法如下:
import numpy as np

def normalize_image(image):
    """
    Normalize the image to the range [0, 1].
    Args:
    - image: the input medical image in numpy array format.
    Returns:
    - The normalized image.
    """
    min_val = np.min(image)
    max_val = np.max(image)
    normalized_image = (image - min_val) / (max_val - min_val)
    return normalized_image

# 假设image是一个已经加载的医疗图像数组
# normalized_image = normalize_image(image)
6.3 数据增强与过采样技术
6.3.1 数据增强策略与实现
数据增强是在有限的数据集上人为增加样本的多样性,以提高模型的泛化能力。常用的数据增强方法包括旋转、缩放、翻转等。以Keras为例,我们可以这样实现数据增强:
from keras.preprocessing.image import ImageDataGenerator

datagen = ImageDataGenerator(
    rotation_range=40,
    width_shift_range=0.2,
    height_shift_range=0.2,
    shear_range=0.2,
    zoom_range=0.2,
    horizontal_flip=True,
    fill_mode='nearest'
)

# 假设train_data_gen是一个包含图像和标签的数据生成器
# for x, y in datagen.flow(train_data_gen, batch_size=32):
#     # 生成一批增强后的图像和标签
#     # 在这里进行模型训练等操作
6.3.2 过采样技术与类不平衡问题解决
类不平衡是医疗图像分类中的常见问题,指的是某一类别的样本远多于其他类别。过采样是解决这个问题的一种方法,通过增加少数类别的样本数量来平衡类别分布。以下是一个简单的过采样方法示例:
from imblearn.over_sampling import RandomOverSampler

# 假设X和y是包含医疗图像数据和对应标签的特征和标签数组
ros = RandomOverSampler()
X_resampled, y_resampled = ros.fit_resample(np.array(X), np.array(y))

# 现在X_resampled和y_resampled包含了平衡后的数据集
在医疗图像数据预处理中,合理选择和应用预处理技术,能够显著提升模型训练的效果。下一节,我们将继续探讨模型训练的优化方法与部署实现。
7. 模型训练的优化方法与部署实现
7.1 模型训练的交叉验证与参数调优
在医疗图像分类领域,模型的准确性和泛化能力至关重要。交叉验证是一种强大的技术,用于评估模型在独立数据集上的表现,从而减少模型过拟合的风险。选择合适的交叉验证方法至关重要。
7.1.1 交叉验证的方法与选择
在实践中,常用的交叉验证技术包括K-Fold、Leave-One-Out和Stratified K-Fold。K-Fold交叉验证将数据集分成K个互斥的子集,每个子集轮流作为验证集,其余作为训练集。这种方法适用于数据量较大的情况。Leave-One-Out交叉验证则是将每一条数据单独作为一次验证集,其余数据作为训练集,适用于数据量较小的情况。Stratified K-Fold交叉验证则是考虑到数据的分布,确保每个子集中的标签分布与整个数据集的分布一致,这对于保持类别的平衡尤其重要。
在实际操作中,你可以使用scikit-learn库来实现交叉验证。例如,使用K-Fold交叉验证的代码如下:
from sklearn.model_selection import KFold
from sklearn.metrics import accuracy_score

# 假设 X 是输入数据,y 是目标标签,model 是你的深度学习模型
kf = KFold(n_splits=5)
for train_index, test_index in kf.split(X):
    X_train, X_test = X[train_index], X[test_index]
    y_train, y_test = y[train_index], y[test_index]
    # 训练模型
    # model.fit(X_train, y_train)
    # 预测测试集
    # y_pred = model.predict(X_test)
    # 评估模型准确率
    # accuracy = accuracy_score(y_test, y_pred)
7.1.2 超参数调优的策略与工具
深度学习模型的性能很大程度上依赖于超参数的设置。超参数如学习率、批大小、网络层数和激活函数等都需要通过实验来调整以达到最佳性能。超参数调优的策略包括网格搜索(Grid Search)、随机搜索(Random Search)和贝叶斯优化等。
网格搜索是最简单直观的方法,它遍历一个超参数的预定义集合,评估每一种组合的效果。随机搜索则从定义的超参数分布中随机选择超参数组合进行评估,相比网格搜索在计算效率上有所提升。贝叶斯优化方法则是利用贝叶斯统计原理,智能选择下一步要评估的超参数组合。
一个使用scikit-optimize库实现贝叶斯优化的简单示例代码如下:
from skopt import BayesSearchCV
from skopt.space import Real, Categorical, Integer

# 假设已经有一个创建模型的函数
def create_model(learning_rate, num_layers):
    model = ... # 创建并返回模型
    return model

# 定义超参数空间
search_space = {
    'learning_rate': Real(1e-5, 1e-3, 'log-uniform'),
    'num_layers': Integer(1, 5),
    # 其他超参数
}

# 调用贝叶斯优化进行搜索
opt = BayesSearchCV(create_model, search_space, n_iter=32, random_state=0)
opt.fit(X, y)

# 输出最佳参数
print("Best parameters found: ", opt.best_params_)
7.2 学习率调度与模型性能评估
学习率是深度学习训练中的关键参数,决定了模型更新的速度。动态调整学习率可以帮助模型更好地收敛。
7.2.1 学习率调度方法
学习率调度是根据训练阶段动态调整学习率的一种策略。常见的学习率调度方法包括学习率衰减(Learning Rate Decay)、周期性调整(Cyclical Learning Rates)和自适应学习率算法(如Adam, RMSprop等)。
例如,使用学习率衰减的方法,可以在训练过程中逐步降低学习率。在Keras中,可以简单地通过回调函数 LearningRateScheduler 来实现:
from keras.callbacks import LearningRateScheduler

# 定义学习率调整函数
def step_decay(epoch):
    initial_lr = 0.01
    drop = 0.5
    epochs_drop = 10.0
    lr = initial_lr * np.power(drop, np.floor((1+epoch)/epochs_drop))
    return lr

# 将调整函数绑定到训练过程中
callbacks = [LearningRateScheduler(step_decay)]
model.fit(X_train, y_train, epochs=50, callbacks=callbacks)
7.2.2 模型性能评估指标与医疗领域特有要求
模型性能评估是模型训练的关键环节,通过评估可以了解模型的泛化能力。在医疗图像分类中,除了常规的准确率(Accuracy)、精确率(Precision)、召回率(Recall)、F1分数(F1 Score)之外,还需要考虑特定于医疗领域的评估指标,比如ROC-AUC和混淆矩阵等。
例如,混淆矩阵可以帮助我们了解模型在不同类别上的表现,尤其在处理多分类问题时。ROC-AUC则是一个综合指标,它考虑了不同阈值下的真正例率和假正例率。
使用scikit-learn库进行混淆矩阵计算的示例代码如下:
from sklearn.metrics import confusion_matrix, roc_auc_score
import seaborn as sns
import matplotlib.pyplot as plt

# 假设 y_true 是真实标签,y_pred 是模型预测的标签
y_true = [0, 1, 1, 0, 1]
y_pred = [0, 0, 1, 0, 1]

# 计算混淆矩阵
conf_matrix = confusion_matrix(y_true, y_pred)
sns.heatmap(conf_matrix, annot=True, fmt='d')
plt.show()

# 计算ROC-AUC
roc_auc = roc_auc_score(y_true, y_pred)
print('ROC-AUC:', roc_auc)
7.3 模型部署与前后端系统集成
一旦模型被训练并评估,接下来的工作就是将它部署到生产环境中,并与前后端系统进行集成。
7.3.1 模型的部署策略与工具选择
模型部署策略和工具的选择依赖于应用场景。在云计算环境下,可以使用Docker容器化模型,并使用Kubernetes进行管理。对于一些轻量级部署,可以使用ONNX或TensorFlow Serving来导出模型,并使用服务器进行模型推理。另外,还可以直接在服务器上使用Flask或FastAPI等框架搭建一个RESTful API来提供模型服务。
模型部署的一个基本示例,使用TensorFlow Serving和Docker,步骤如下:
- 使用
SavedModelBuilder将训练好的模型保存为一个兼容TensorFlow Serving的格式。 - 构建一个Docker镜像,包含TensorFlow Serving及其模型服务。
- 运行Docker容器,并将模型目录挂载到容器内。
- 配置TensorFlow Serving的模型服务器,以便能够正确加载和推理模型。
7.3.2 前后端系统集成与癌症识别应用实现
前后端系统集成是将模型部署为实际应用的关键步骤。前端Vue.js应用可以通过HTTP请求向后端Flask服务器查询模型的预测结果。后端服务器接收到请求后,将用户提供的图像数据发送到部署的深度学习模型,然后将模型的预测结果返回给前端。
这里是一个简化的后端处理流程示例:
# Flask后端示例代码
from flask import Flask, request, jsonify
import tensorflow as tf
import numpy as np

app = Flask(__name__)

# 加载模型
model = tf.keras.models.load_model('path_to_model.h5')

@app.route('/predict', methods=['POST'])
def predict():
    data = request.get_json(force=True)
    img_data = np.array(data['image'])
    # 适当的预处理步骤
    prediction = model.predict(img_data[np.newaxis, ...])
    return jsonify({'prediction': prediction.tolist()})

if __name__ == '__main__':
    app.run(debug=True)
在这个例子中,前端Vue.js应用需要发送一个包含图像数据的JSON请求到 /predict 路由。后端将处理请求,使用加载的模型进行预测,并将结果返回给前端。最终,前端展示预测结果给用户,完成一个完整的癌症识别应用流程。
简介:本项目提供了一个深度学习解决方案,用于医疗图像分类,尤其关注癌症的早期检测和识别。项目采用Keras框架进行模型训练,并通过Flask后端与Vue.js前端的集成,实现一个端到端的癌症识别系统。项目包括数据预处理、模型训练与验证、以及模型评估等关键环节,为医生提供了一个快速准确的辅助诊断工具。
更多推荐


 22
 0
- 0


 已为社区贡献12条内容

所有评论(0)