
【PDF内容提取】使用LangChain和PyPDFLoader提取PDF文本内容——附示例代码
在当今信息爆炸的时代,PDF文档已成为存储和共享知识的重要格式。无论是学术论文、技术报告还是商业文档,PDF无处不在。本文将介绍如何使用Python中的LangChain库和PyPDFLoader工具,高效地从PDF文件中提取文本内容。
一、为什么需要PDF文本提取?
PDF文本提取在许多场景下都非常有用:
-
构建文档搜索引擎
-
进行自然语言处理分析
-
创建知识库系统
-
自动化文档处理流程
二、准备工作
首先,确保你已经安装了必要的Python库:
pip install langchain-community pypdf
三、代码解析
让我们逐步分析提供的代码,了解其工作原理:
1. 导入必要模块
import os
from langchain_community.document_loaders import PyPDFLoader
-
os模块用于处理文件路径 -
PyPDFLoader是LangChain提供的PDF加载器
2. 构建PDF文件路径
script_dir = os.path.dirname(os.path.abspath(__file__))
pdf_file = "2311.05556.pdf"
pdf_path = os.path.join(script_dir, pdf_file)
这段代码确保了无论脚本在什么位置运行,都能正确找到PDF文件:
-
获取当前脚本的绝对路径目录
-
定义PDF文件名
-
组合成完整的文件路径
3. 验证文件存在性
try:
    loader = PyPDFLoader(pdf_path)
    pages = loader.load()
    result = "\n".join([p.page_content for p in pages])
    print(result[:])  # 打印pdf全部字符
except Exception as e:
    print(f"加载失败:{str(e)}")
这是核心功能部分:
-
创建
PyPDFLoader实例并传入PDF路径 -
调用
load()方法加载文档 -
将各页内容合并为一个字符串
-
打印结果
四、PyPDFLoader的工作原理
PyPDFLoader的load()方法将PDF的每一页解析为一个Document对象,返回由这些对象组成的列表。每个Document包含两个关键属性:
-
page_content:存储PDF页面的纯文本内容(字符串类型) -
metadata:包含元数据,如页码等(代码中未使用)
五、代码优化建议
-
添加日志记录:替代简单的print语句
-
处理特殊字符:PDF中可能包含需要清理的特殊字符
-
分页处理:对于大文档,考虑分批处理
-
错误处理细化:捕获特定异常而非通用Exception
六、扩展应用
提取文本后,你可以:
-
使用LangChain的其他组件进行文本分割和嵌入
-
将内容存入向量数据库构建问答系统
-
进行文本摘要或关键词提取
-
与其他文档类型处理流程集成
七、完整代码示例
import os
from langchain_community.document_loaders import PyPDFLoader

def extract_pdf_text(pdf_file):
    """提取PDF文本内容的函数"""
    # 构建完整路径
    script_dir = os.path.dirname(os.path.abspath(__file__))
    pdf_path = os.path.join(script_dir, pdf_file)

    # 验证文件存在性
    if not os.path.exists(pdf_path):
        raise FileNotFoundError(f"PDF文件未找到:{pdf_path}")

    try:
        # 加载并处理PDF
        loader = PyPDFLoader(pdf_path)
        pages = loader.load()
        return "\n".join([p.page_content for p in pages])
    except Exception as e:
        raise RuntimeError(f"PDF处理失败:{str(e)}")

if __name__ == "__main__":
    try:
        pdf_text = extract_pdf_text("2311.05556.pdf")
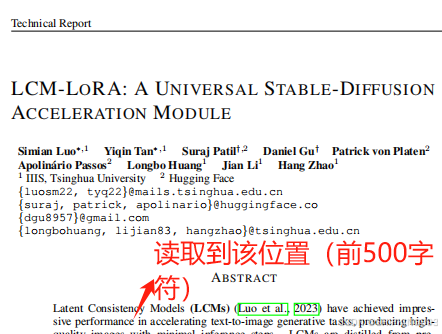
        print(pdf_text[:500])  # 打印前500字符作为示例
    except Exception as e:
        print(f"错误:{str(e)}")
运行效果:

pdf文档内容:
八、结语
使用LangChain的PyPDFLoader可以轻松实现PDF文本提取,为后续的文档处理和分析奠定基础。这种方法简单高效,适合各种规模的PDF处理需求。随着LangChain生态的不断发展,将有更多强大的文档处理功能可供探索。
更多推荐

 24
 0
- 0


 已为社区贡献12条内容

所有评论(0)