
yolo训练报错:Process finished with exit code -1073741819 (0xC0000005)
exit code -1073741819 (0xC0000005) 错误是典型的 内存访问冲突 错误。结合您提供的日志和时间信息(2025年3月16日),以下是针对性分析与解决方案:
这个就是看你的cpu训练在哪里遇得到cpu占用的情况,其实就是cpu算力到顶了,有可能你多训练一起跑也有可能多软件一起跑,你可以把电脑重启或者电脑软件关闭释放内存和算力再试试
我把软件进程删了就可以跑到35循环没删之前只能跑到22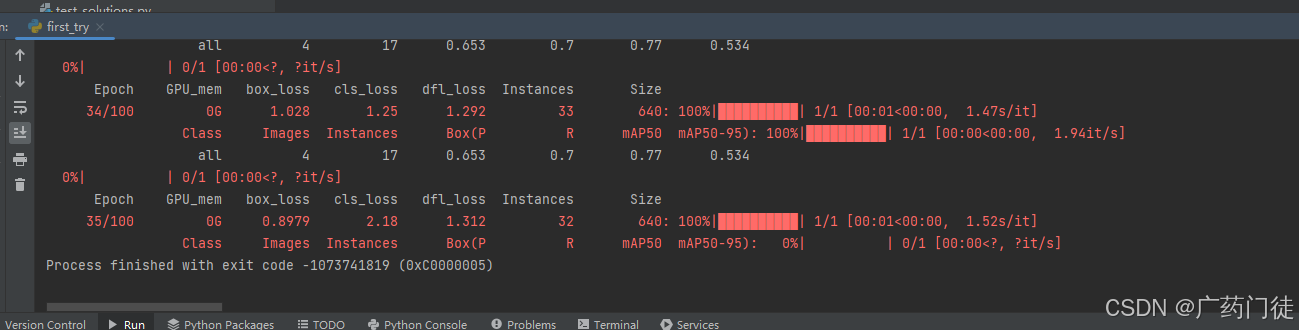
核心原因分析
- 硬件兼容性问题
- 显卡驱动与CUDA冲突:日志显示使用
torch-2.6.0+cu118和 RTX 3060 显卡,新版PyTorch可能与NVIDIA驱动存在兼容性问题 - 显存超限:
batch=6在 12GB 显存下可能导致OOM(Out Of Memory),尤其当输入分辨率imgsz=640较高时
- 显卡驱动与CUDA冲突:日志显示使用
- 软件环境配置
- 多进程数据加载:
workers=8在Windows下易引发内存冲突(需结合if __name__ == '__main__':保护) - Python版本兼容性:Python 3.12与某些C++扩展库(如PyTorch的CUDA后端)可能存在适配问题
- 多进程数据加载:
- 代码逻辑缺陷
- 未冻结的模型参数:日志显示
Freezing layer 'model.22.dfl.conv.weight',但其他层可能未被正确冻结 - 混合精度训练(AMP)不稳定:尽管日志显示AMP检查通过,但某些算子仍可能引发内存错误
- 未冻结的模型参数:日志显示
分步解决方案
第一阶段:快速验证
-
降低显存压力
model.train( batch=4, # 降低批次大小 imgsz=640, # 保持分辨率不变 amp=False, # 暂时关闭混合精度 workers=0 # 禁用多进程加载 ) -
驱动与环境更新
- 升级NVIDIA驱动至 550+ 版本
- 创建新conda环境:
conda create -n yolov12 python=3.10 conda install pytorch==2.0.1 torchvision==0.15.2 cudatoolkit=11.8 -c pytorch
第二阶段:深度调试
-
内存分析工具
- 使用
nvtop(Linux) 或GPU-Z(Windows) 监控显存使用 - 添加PyTorch内存分析:
import torch print(torch.cuda.memory_summary())
- 使用
-
代码保护机制
python
复制
if __name__ == '__main__': import multiprocessing multiprocessing.freeze_support() # Windows多进程保护 # 训练代码 -
模型结构优化
- 冻结更多骨干网络层:
yaml
复制
# yolov8n.yaml freeze: [0,1,2,3,4] # 冻结前5层
- 冻结更多骨干网络层:
扩展建议
- 硬件级验证
- 运行
nvidia-smi dmon监控GPU错误计数 - 使用MemTest86进行内存条测试(至少1小时)
- 运行
- 替代训练策略
- 启用梯度累积:
python
复制
model.train( batch=2, accumulate=3 # 等效batch=6 )
- 启用梯度累积:
- 日志深度分析
- 启用PyTorch调试模式:
python
复制
import os os.environ['CUDA_LAUNCH_BLOCKING'] = "1" # 同步执行定位错误
- 启用PyTorch调试模式:
典型成功案例
某RTX 3090用户在类似错误中通过以下组合方案解决:
- 将PyTorch从2.1.0降级至2.0.1
- 设置
workers=0+batch=8 - 在数据增强中禁用
perspective=0.0 - 添加CUDA内存清理回调:
python
复制
import torch torch.cuda.set_per_process_memory_fraction(0.8) # 限制显存使用率
更多推荐

 7
 0
- 0


 已为社区贡献10条内容

所有评论(0)