
C语言的编译和链接(包含宏等内容)
目录
1.环境
在ANSI定义的c语言国际标准中,存在两个不同的环境:翻译环境和执行环境

机器只能理解二进制语言,翻译环境就让源代码变成二进制文件(后缀为.exe的文件,如果强制用记事本打开会看到一堆乱码)
2.翻译环境

Windows中,从.c文件生成目标文件(.obj)(linux环境下的目标文件后缀是.o)的过程叫编译,VS使用的编译器名字是cl
目标文件中的内容已经是二进制了。
• 多个.c⽂件单独经过编译出编译处理⽣产对应的⽬标⽂件。
• 多个⽬标⽂件和链接库⼀起经过链接器处理⽣成最终的可执⾏程序。
• 链接库是指运⾏时库(⽀持程序运⾏的基本函数集合)或者第三⽅库。
2.1编译
编译可分为 预处理(预编译) 编译 汇编 三个步骤。
a.预处理
预处理生成的是临时文件(后缀为.i),使用完后会删除
预编译的文本操作包括但不限于:处理所有的条件编译指令,如: #if、#ifdef、#elif、#else、#endif (#是C语言预处理的标志,会在下文介绍) ,把头文件的内容包含进去,并且替换#define的内容,删除掉所有的注释。整个过程可能是递归进行的(头文件里包含了其他的头文件)。
被预编译的文件应当不再包含宏,头文件都被插入,注释也已经被删除。
接下来我们对预处理详细介绍(包含宏等内容,可直接跳过阅读编译相关内容)。
1.#define 定义常量
先名字后内容 如:#define name stuff的意思就是name代表stuff了
预处理之后stuff就会被换成name了。还可以写成 #define str "hiehiehie"
#define m 100+2 等写法,预处理之后都是进行单纯的文本替换
注意:#define之后不建议加上分号,因为分号也会被当作文本内容替换进去。
2.#define 定义宏(参数)
#define机制包括了⼀个规定,允许把参数替换到⽂本中,
如下图
#define SQUARE(X) X*X

int main()
{
   int a=5;
   printf("%d",SQUARE(a));
//预处理之后就应该是printf("%d",a*a);

   return 0;
}
但是注意,这样的话会有宏的通病:宏是简单的文本代换,并不会对参数进行计算。
如下例:
#define Square(x) x*x

int main(){

int a=5;
printf("%d\n",Square(a+1));


return 0;
}
预处理之后就会被翻译为
int main(){

int a=5;
printf("%d\n",a+1*a+1);

return 0;
}在之后编译的词法扫描语法分析阶段就会由于运算优先级的问题而出错。
//可以改为
#define Square(x)  (x)*(x)
也就是宏的参数中的操作符和宏的内容中的操作符可能因为优先级的问题而导致运算顺序不达预期,尽量给参数都带上括号来有效解决 。
更进一步:
#define Double(x)  x+x

//一个求参数双倍的宏

int main(){
 int x=3;
printf("%d",3*Double(3));

return 0;
}
又出现了优先级的问题。
所以我们建议不仅每个参数要上括号,整体表达式也加上括号,不要吝啬你的括号
#define Double(x) ((x)+(x))3.使用宏时不合适参数的副作用
如,求两数最大值的宏:

此时确实能正常工作,但如果我们更换max的参数:
int m=MAX(a++,b++); 预处理替换后就变成
a与b的值就产生了我们不希望的变化。
4.宏替换的规则
在程序中扩展#define定义符号和宏时,需要涉及⼏个步骤。

5.宏与函数
是不是感觉宏与函数功能很像?
一般宏会用来进行简单的运算,原因有二:
6.两个奇葩的操作符# 和 ##
#define PRINT(n) printf("the value of "  #n  "is %d", n);

int main(){

int a=5;
PRINTF(a);

return 0;
}
因为宏的替换不会搜索字符串中的内容,所以如果写成
#define PRINT(n) printf("the value of n is %d", n); 双引号中的n就不会被替换
而#a就会被理解成"a", 从而被理解为第二个字符串而打印出来了。(c语言允许多个字符串贴在一起进行打印,如:
printf("hello" "world" "\n");)
换句话说就是把宏的真实参数名称替换成字符串。
##被称为记号粘合。
比如我们任然想写一个与比较大小有关的函数,希望他能比较多种类型
int int_max(int x, int y)
{
return x>y?x:y;
}


float float_max(float x, float y)
{
return x>yx:y;
}

//还有很多类型...........
过于繁琐,
如果使用宏来作为函数的模版:
#define GENERIC_max(type)  \
type  type_max(type x,type y); \
{\
       return (x>y?x:y);\
}
我们就可以通过GENERIC_max(int) GENERIC_max(float) GENERIC_max(double)等形式得到不同的函数,但是预处理(生成.i文件)之后并没有完全变成我们想要的样子:

#define GENERIC_max(type)  \
type  type##_max(type x,type y); \
{\
       return (x>y?x:y);\
}
使用##连接两边的符号形成同一个符号,就能生成
int int_max(int x,int y){return (x>y?x:y);} 正确的使用了语法,得到了期望的函数名称。
##可以把位于它两边的符号合成⼀个符号,它允许宏定义从分离的⽂本⽚段创建标识符。 ## 被称为记号粘合,这样的连接必须产⽣⼀个合法的标识符。否则其结果就是未定义的。
7.命名 与函数的不同
⼀般来讲函数的宏的使⽤语法很相似。所以语⾔本⾝没法帮我们区分⼆者。
一般的,我们平时的⼀个习惯是:
把宏名全部⼤写(上文的代码多有不规范)
函数名不要全部⼤写
(也有例外,比如·包含在<stddef.h>中的offsetof就是全小写,用于计算结构体成员相对于起始位置的偏移量)
这是命名的“潜规则”,这样使用能更加规范化自己的代码。
8.#undef
这条指令⽤于移除⼀个宏定义。
#define NAME 5

#undef NAME
NAME此时就是未定义的。
9.命令行定义
在linux中实现。
10.条件编译
在大型代码中常见。
顾名思义,满足条件参与编译,不满足条件不参与编译。
在编译⼀个程序的时候我们如果要将⼀条语句(⼀组语句)编译或者放弃,就使用条件编译。
比如在一段代码中出现了一个错误,你写了一些调试语句来找bug,使用完之后又不希望删除(下次还可能遇到相同的问题,需要相同的调试代码),留着又碍事,就使用#ifdef和#endif来进行条件编译。
#include<stdio.h>
#define __DEBUG__

int main()
{

   int i=0;
int arr=[0];
for(int i=0;i<10;i++){

*(arr+i)=i;

    #ifdef __DEBUG__
printf("%d",arr[i]);
#endif

}

return 0;

}
预处理阶段,如果满足条件就留下并被编译,不满足条件就直接干掉。
常用的预处理指令:
1.
#if 常量表达式
//...
#endif
//常量表达式由预处理器求值。
如:
#define __DEBUG__ 1
#if __DEBUG__
//..
#endif
2.多个分⽀的条件编译
#if 常量表达式
//...
#elif 常量表达式
//...
#else
//...
#endif
3.判断是否被定义
#if defined(symbol)
#ifdef symbol
//上下两组各自表示一样的意义
#if !defined(symbol)
#ifndef symbol

4.嵌套指令
#if defined(OS_UNIX)
#ifdef OPTION1
unix_version_option1();
#endif
#ifdef OPTION2
unix_version_option2();
#endif
#elif defined(OS_MSDOS)
#ifdef OPTION2
msdos_version_option2();
#endif
#endif

总的来说,写法与c语言的基本语法很相似
注意,#if #ifdef等后面的语句不需要加分号。
但是写成如下形式是一个经典的错误
#define M 4
int main()
{
   int a=4;
#if M==a
//调试代码
#endif

return 0;
}因为这个的判断在预处理阶段,预处理阶段没法判断a。(所以上面强调了是常量表达式,不要使用变量)
11.头文件的包含
本地文件的包含
#include "filename.h" 先在源⽂件所在⽬录下查找,如果该头⽂件未找到,编译器就像查找库函数头⽂件⼀样在
标准位置(如vs的默认路径就是C:\Program Files (x86)\Microsoft Visual Studio 12.0\VC\include)
查找头⽂件。
如果找不到就提⽰编译错误。
#include <stdlib.h>这样的<>直接去标准位置查找,不会在项目路径下查找
那么是不是说明,我们直接用双引号包含所有的头文件就行了呢??
当然不是的,首先,对于标准库里的文件,先在项目路径下找降低了效率(对于成千上百万行的大项目来说,这样的小细节会影响整体的效率),其次,这样也不便于区分标准库与自己写的头文件。
12.嵌套包含
一个头文件h被包含进头文件a和头文件b,我们的一个项目既需要a也需要b,那么重复编译h
就会降低整体的效率,浪费时间和空间 我们有以下两种解决方法:
#ifndef __TEST_H__
#define __TEST_H__
//头文件的内容
#endif
或者
#pragma once
//头文件内容
b.编译
生成汇编代码文件:词法分析 (扫描) 语法分析(产生语法树) 语义分析(包括声明和类型的匹配,并且会报错),生成后缀为.s
c.汇编
按照机器指令的对照表,将编译时汇编代码翻译成二进制,生成后缀为.o(linux)
2.2链接
链接解决一个项目中多个文件和模块相互调用的过程
链接过程主要包括:地址和空间分配,符号决议和重定位等这些步骤。
具体我们只以下例进行学习:

编译的过程中还有一步叫符号汇总,就是在生成的add.c和test.c中抽取出我们自定义的函数符号:

然后会在汇编的过程中形成符号表:将抽取出的函数名称和其对应的地址进行匹配

地址的合并:由于extern的函数并不是真实创造一个函数,所以在单独进行编译时不能从右侧的.c的文件中找到add函数在哪里,故为无效地址0x000。合并后只使用各函数的有效地址,达到修正无效地址的目的。
可以说,没有链接器,多个.c后缀的文件就不能很好的在同一个项目下工作。

但是如果注释左边的add,就失去了有效地址,找不到add时编译器就会报错(如上图左下角)。
同时,也不是必须用extern才能在源文件a中使用源文件b中声明的函数,如以下情况:

当我在一个工程中有这么三个文件,
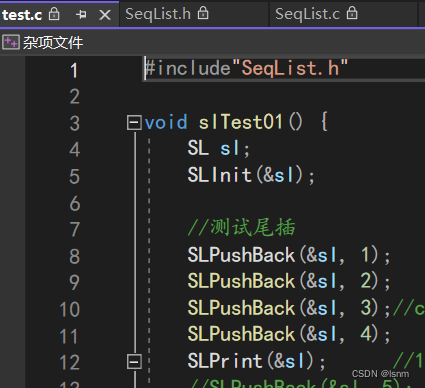
我在test.c里面使用SLInit函数,在SeqList.h中声明了各个函数
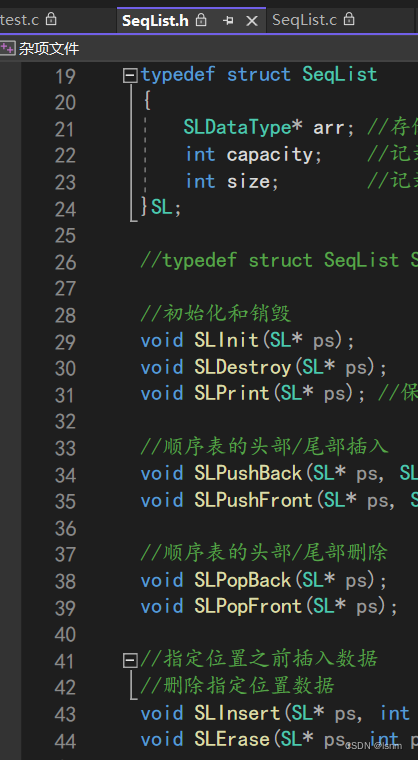
但是在SeqList.c中中实现的各个函数的具体功能。
那么此时我就不再需要extern,根据以上编译和预处理中头文件的知识,预处理步骤中头文件中的内容都会被复制进入test.c,所以一系列以下函数声明

都进入了test.c
编译时不会报错,而是在最后链接的过程中(如上文)再更正 各个函数的真实地址和数据,得意使用。
3.运行环境
1. 任何一个程序都需要先载入内存,所以所有程序都占用内存,这也是为什么一台机器同时多开过多程序会卡的原因。在有操作系统的环境中:⼀般这个由操作系统完成。在独⽴的环境中,程序 的载⼊必须由⼿⼯安排,也可能是通过可执⾏代码置⼊只读内存来完成。
2. 程序的执⾏便开始。接着便调⽤main函数。
更多推荐

 26
 0
- 0


 已为社区贡献3条内容

所有评论(0)