
【IROS 2026】OWMDrive:以 4D 占用世界模型实现因果感知的端到端自动驾驶|从世界模型自动驾驶视角
摘要
本文解读 IROS 2026 论文《OWMDrive: Causality-Aware End-to-End Autonomous Driving via 4D Occupancy World Model》。该论文提出 OWMDrive——一个以 4D 占用世界模型预测未来多步 3D 场景、并将预测结果作为扩散规划器条件先验的生成式端到端自动驾驶框架,通过融合占用世界模型、扩散轨迹生成与 GRPO 强化学习,把驾驶决策从"看现状"升级为"想未来"。实验表明,OWMDrive 在 nuScenes 开环评测拿到平均 L2 0.18 m、平均碰撞率 0.05% 双最优,在 NAVSIM 闭环评测以 PDMS 90.8 大幅领先 DiffusionDrive(88.1)等全部基线;3 秒前瞻消融把平均 L2 从 0.59 m 压到 0.18 m,证明"预测未来场景"是真实起负载作用的设计,而非锦上添花。该工作为端到端自动驾驶的因果感知规划提供了一个可复用的"世界模型 → 条件扩散 + 强化"范本。
视频讲解:点击观看 B 站视频
论文基本信息
| 项目 | 内容 |
|---|---|
| 标题(英文) | OWMDrive: Causality-Aware End-to-End Autonomous Driving via 4D Occupancy World Model |
| 标题(中文) | OWMDrive:以 4D 占用世界模型实现因果感知的端到端自动驾驶 |
| 作者 | Junjie Cheng, Ruiqi Song, Ye Wu, Nanxing Zeng, Ximiao Li, Yunfeng Ai |
| 机构 | 中国科学院大学人工智能学院 · 中科院自动化所(多模态AI系统国重)· Waytous Inc. · 同济大学 |
| 会议 | IROS 2026 |
| arXiv | https://arxiv.org/abs/2606.30421 |
| 项目网站 | 论文未提供公开项目页 |
为什么端到端自动驾驶需要"看得见未来"?
主流数据驱动端到端方法(如 UniAD、VAD、DiffusionDrive)在推理时依赖的感知信号都来自当前与历史观测:目标检测、占据栅格、相对空间关系。问题在于,这种"静态表示 → 立即决策"的范式没有显式建模交通交互中的时序因果动态:谁在刹车、谁要切入、遮挡后可能藏着什么——这些信息只存在于"未来"里。论文指出,其后果是严重遮挡与突发场景下规划不稳定或过度保守(原文:unstable or overly conservative planning under high-uncertainty conditions)。
换个角度看现有工作格局(这也是附录 D 完整基线表背后的故事):世界模型线(OccWorld、OccSora、OccProphet、I²-World)把 3D/4D 占用预测做得越来越准,但止步于"预测任务"或感知中心式地接下游;生成式规划线(DiffusionDrive、GenAD、DriveGPT4、GPVL)把轨迹建模成分布采样,但条件只用当前场景特征。两条线都缺一半:预测没有直接指导决策,决策没有消费预测。OWMDrive 的贡献正是把"未来 3 秒占用预测"写进扩散去噪的条件里,让两条线第一次以"预测即条件"的方式缝合。
研究主线:从问题到结论
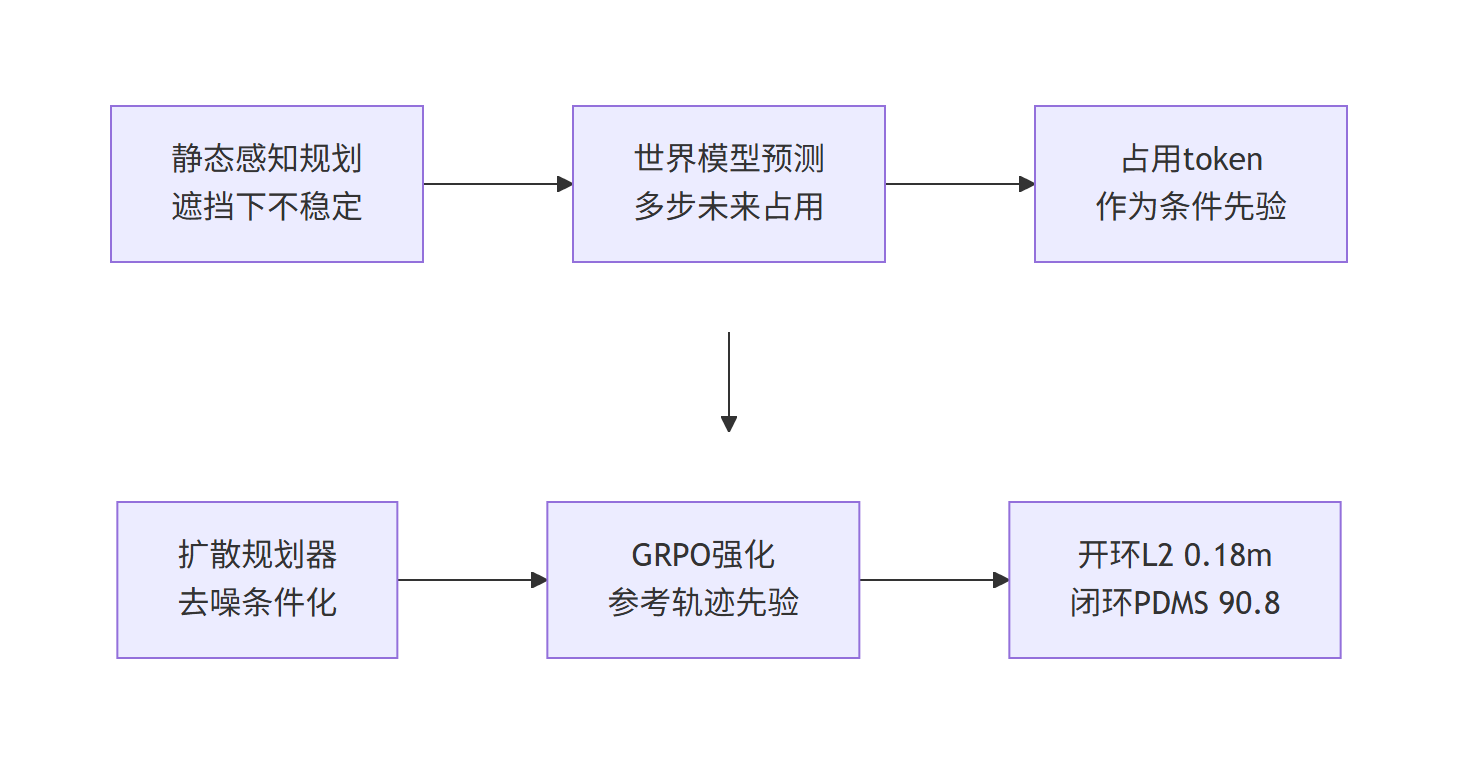
图 4:OWMDrive 研究主线:问题→世界模型→条件扩散→GRPO→双基准验证(Mermaid 流程图)
OWMDrive 整体设计:两大组件如何协作
OWMDrive 是一个两段式生成框架,数据流为:环视图像 → 感知 token → 自回归占用世界模型(预测 $\hat F_{t+1:t+f}$)→ 因果感知扩散规划器(条件去噪出 waypoints)。第一段是语义场景 Tokenizer + 自回归时空世界模型:把高维 3D 占用压缩成紧凑离散 token(VQ-VAE + VAR 式多尺度残差量化 + 时间对齐队列),再基于当前特征 $F_t$ 与历史 $F_{t-H:t-1}$ 逐帧预测未来 $f$ 步占用。第二段是扩散规划器:轨迹规划被建模为条件生成问题 $p_\theta(\tau \mid \bar{s}t, \hat F{t+1:t+f})$,去噪的每一步 latent $\bar{s}_t^k$ 都用交叉注意力吸收未来占用序列的信息。
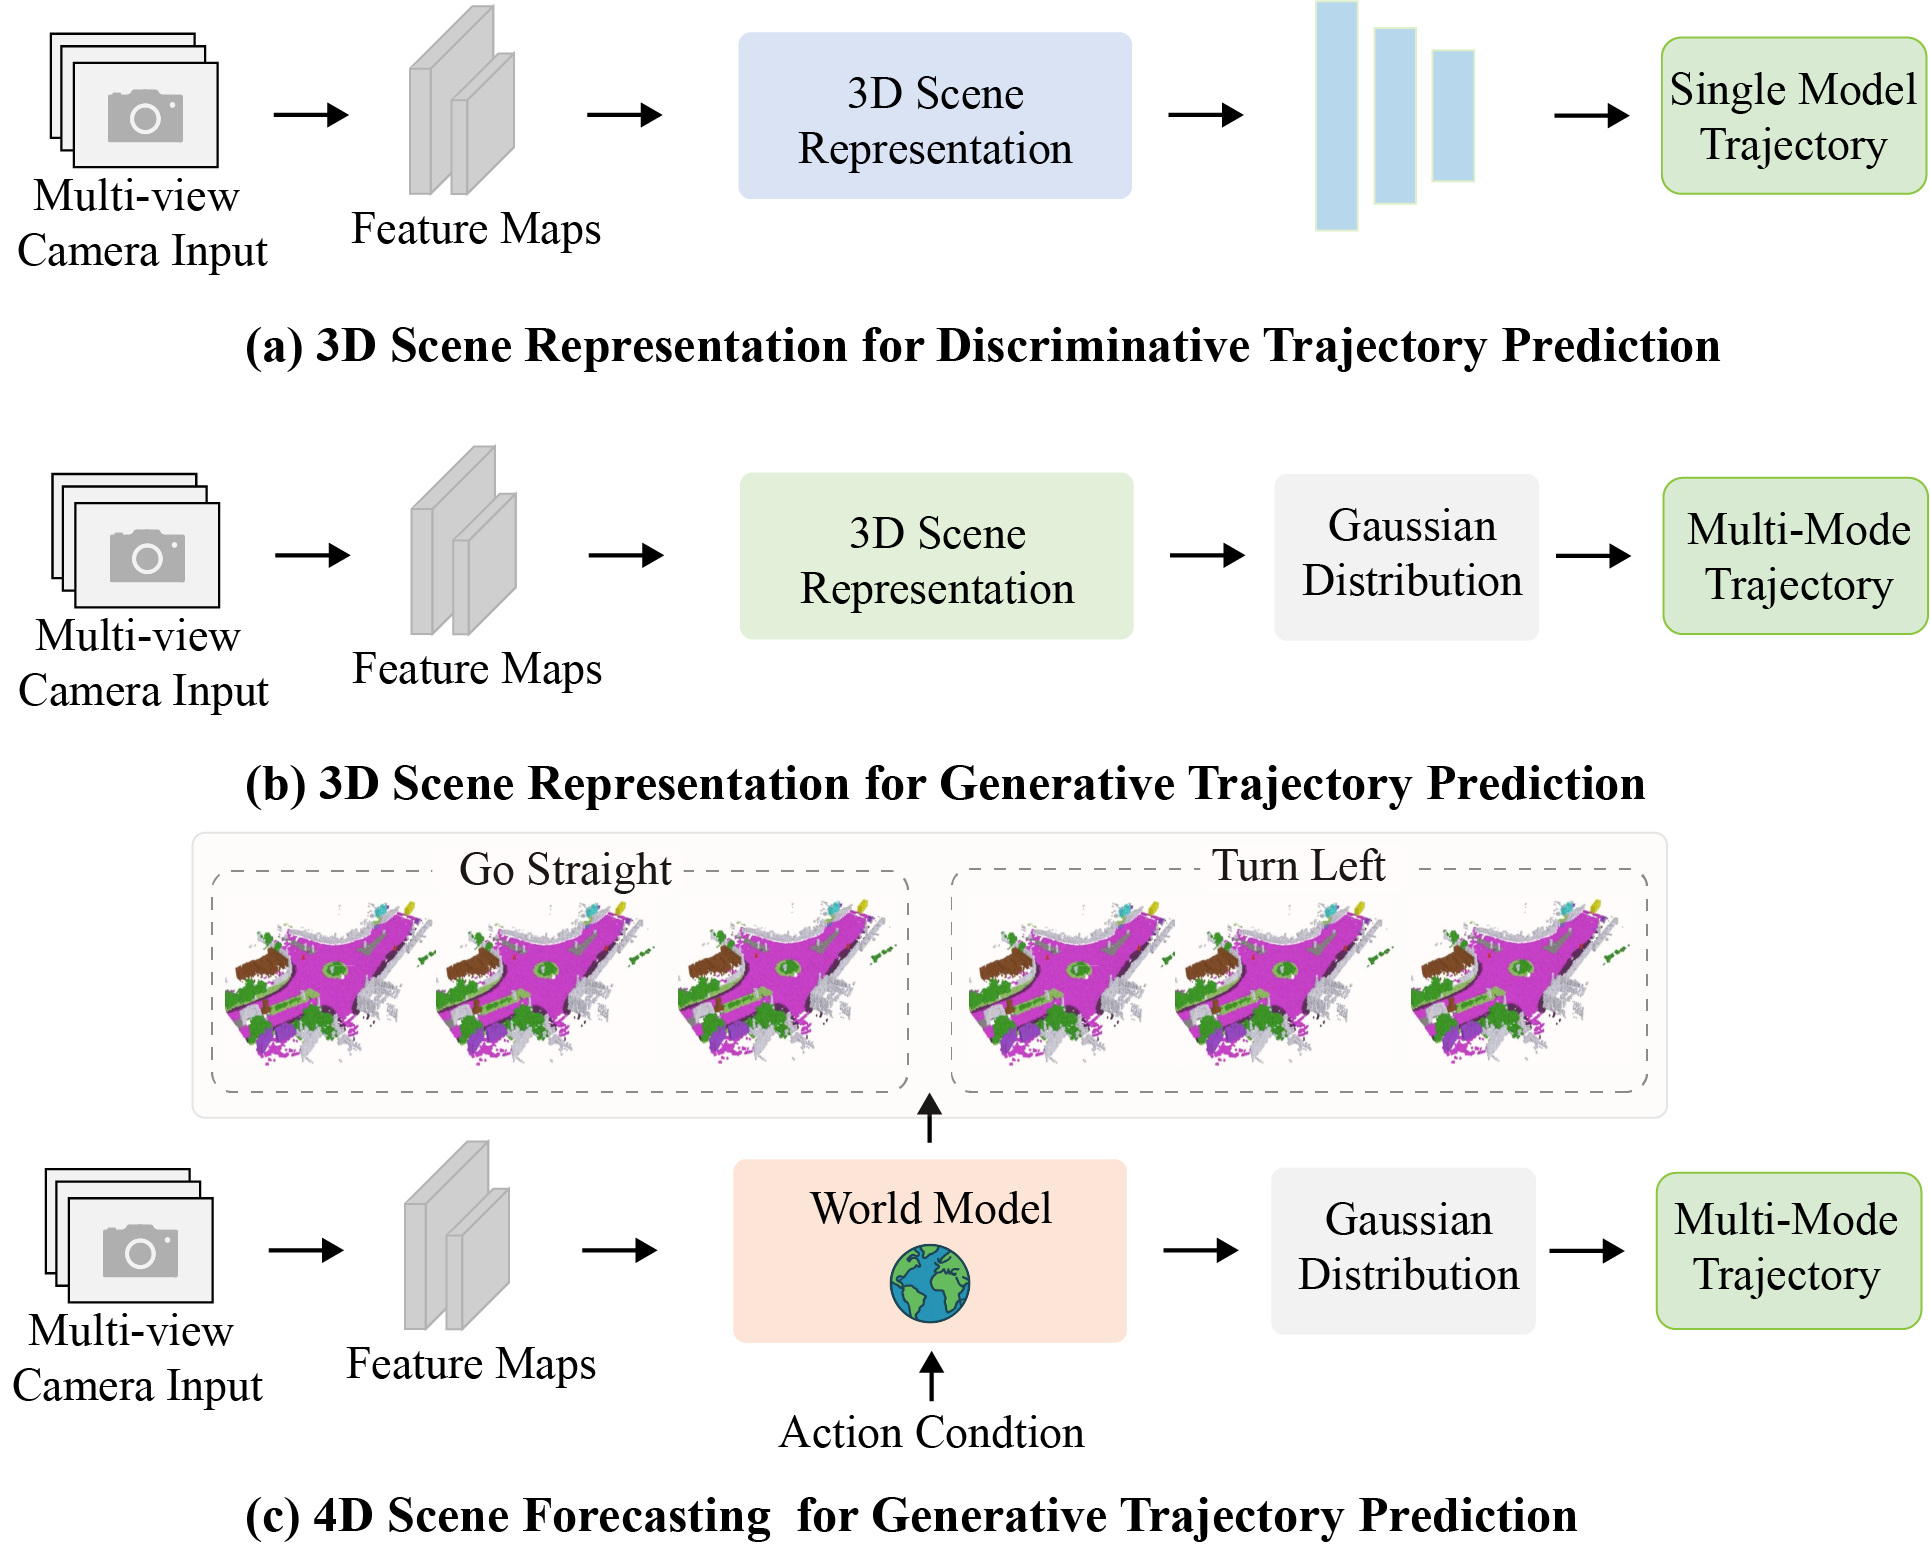
图 1:生成式端到端自动驾驶范式演化(引自论文 Fig. 1)——OWMDrive 处在"预测未来 → 因果感知规划"的最新一环。
与既有关键基线的差异一句话说清:OccWorld 预测后不参与策略优化;DiffusionDrive 用扩散但条件缺未来;DriveWorld 用 4D 占用但规划非生成式;OWMDrive = 生成式规划 × 未来占用条件 × 强化学习。
相关工作的两条技术线
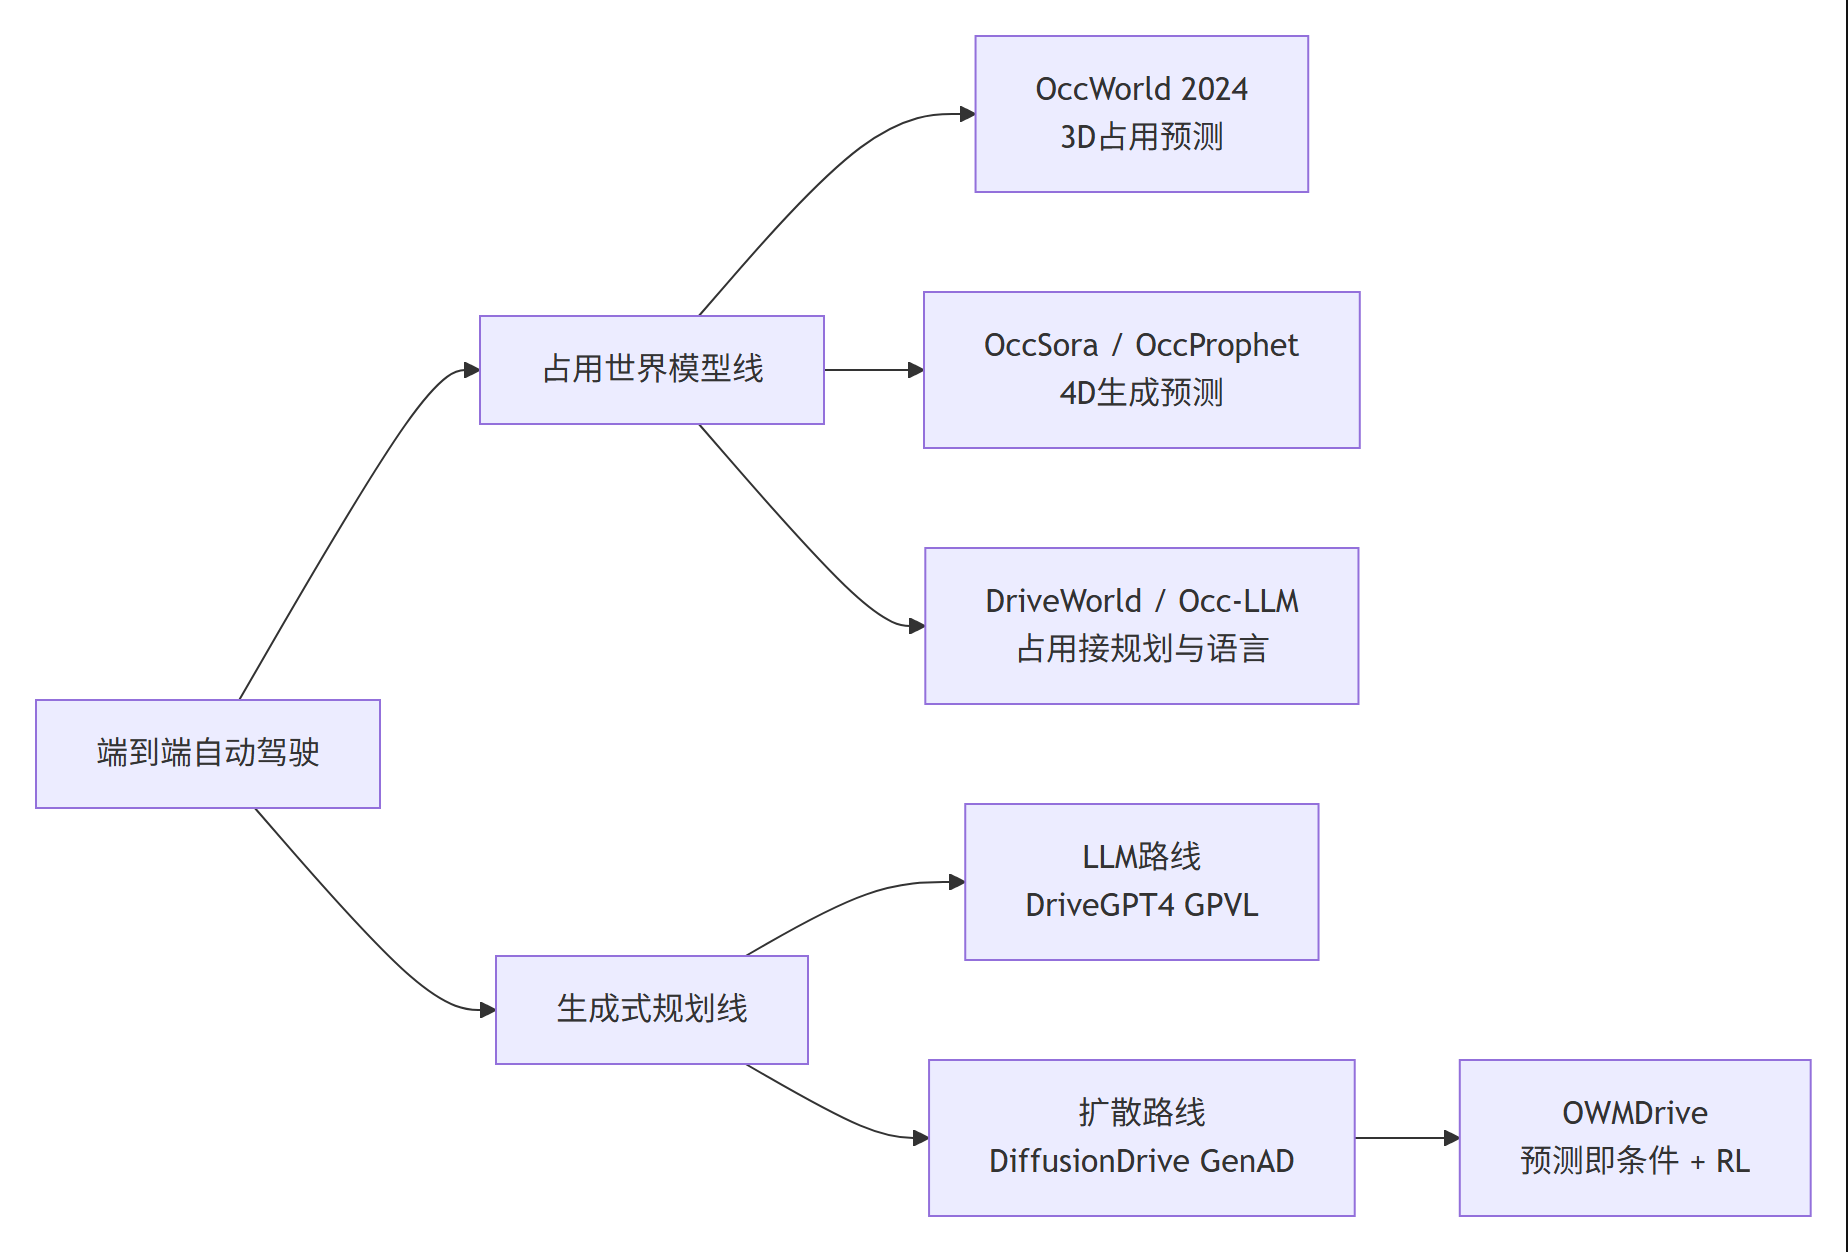
图 5:相关工作的两条技术线——占用世界模型线、生成式规划线与 OWMDrive 的位置(Mermaid 分类图)
方法细节:四个关键设计
① 多尺度残差量化 Tokenizer(空间 + 时间)。 空间上,编码器把占用 $O_t$ 映射为多尺度特征图 $F_t^1,\dots,F_t^Z$,用共享码本做粗到细的残差量化:$R_t^{z+1}=F_t^{z+1}-\mathrm{Up}(Q_t^z)$,重建 $\hat F_t=\sum_z Q_t^z$,逐级残差编码保住细粒度几何。时间上维护历史特征记忆队列 $M_t={F_{t-H},\dots,F_{t-1}}$,先经变换矩阵对齐到当前坐标系,再按历史步迭代量化 $Q_t^{(h)}(i)=\arg\min_{c\in\mathcal{C}\lVert (R_t^{(h-1)}+\tilde{F}{t-h})(i)-c\rVert_2$,其中 $\tilde{F}{t-h}$ 为对齐到当前坐标系后的历史特征——只用少量卷积层就捕获运动模式,显著降低 4D 建模成本。
② 自回归 encoder–decoder 世界模型。 与纯 decoder 架构不同,encoder 用可变形空间自注意力(每查询稀疏采样 $M$ 个位置:$\psi(q_{x,y},v)=\sum_{m=1}^M\omega_m v(p+\Delta p_m)$)聚合空间上下文,金字塔式下采样出多尺度特征;decoder 把预测的变换矩阵嵌入场景 latent,与历史 token 做轻量时间融合(通道拼接 + 单层 MLP),逐帧自回归输出 $\hat F_{t+1:t+f}$。
③ 因果感知条件扩散。 4D 场景条件融合写成:$\bar{s}t^k \leftarrow \mathrm{LN}\big(\bar{s}_t^k + \psi(\bar{s}_t^k, \hat F{t+1:t+f})\big)$——去噪 latent 在每一步都被未来占用序列增强,形成"因果感知状态";训练目标是最小化噪声预测误差 $\mathcal{L}{\mathrm{diff}=\mathbb{E}[\lVert \epsilon-\epsilon\theta(\tau_k,\hat F_{t+1:t+f},k)\rVert_2^2]$。
④ 强化扩散(参考轨迹先验 + GRPO)。 推理不再从纯高斯噪声起步:训练时先对数据聚类出多模态参考轨迹集合 $\mathcal{A}={a_1,\dots,a_K}$,加噪调度为 $\tau_k=\sqrt{\alpha_k}\,a_i+\sqrt{1-\alpha_k}\,\epsilon$,并做幅度自适应探索 $\tau'=(1+\epsilon_{mul})\tau$ 保持轨迹平滑。RL 采用组相对优势 $\hat A_i=(R(\tau_i)-\mu_R)/(\sigma_R+\epsilon_c)$,并做安全感知截断:无碰撞(NC)或驾驶能力检查(DAC)不达标时 $A_i=-\beta$,其余取 $\max(0,\hat A_i)$;策略更新 $\mathcal{L}{\mathrm{GRPO}=-\frac{1}{G}\sum_i A_i\ell_i$,其中 $\ell_i=\sum{t=1}^{T}\gamma^{t-1}\log\pi_\theta(\tau_{t-1}^i\mid\tau_t^i,\hat F_{t+1:t+f})$,$\gamma$ 衰减早期去噪步。
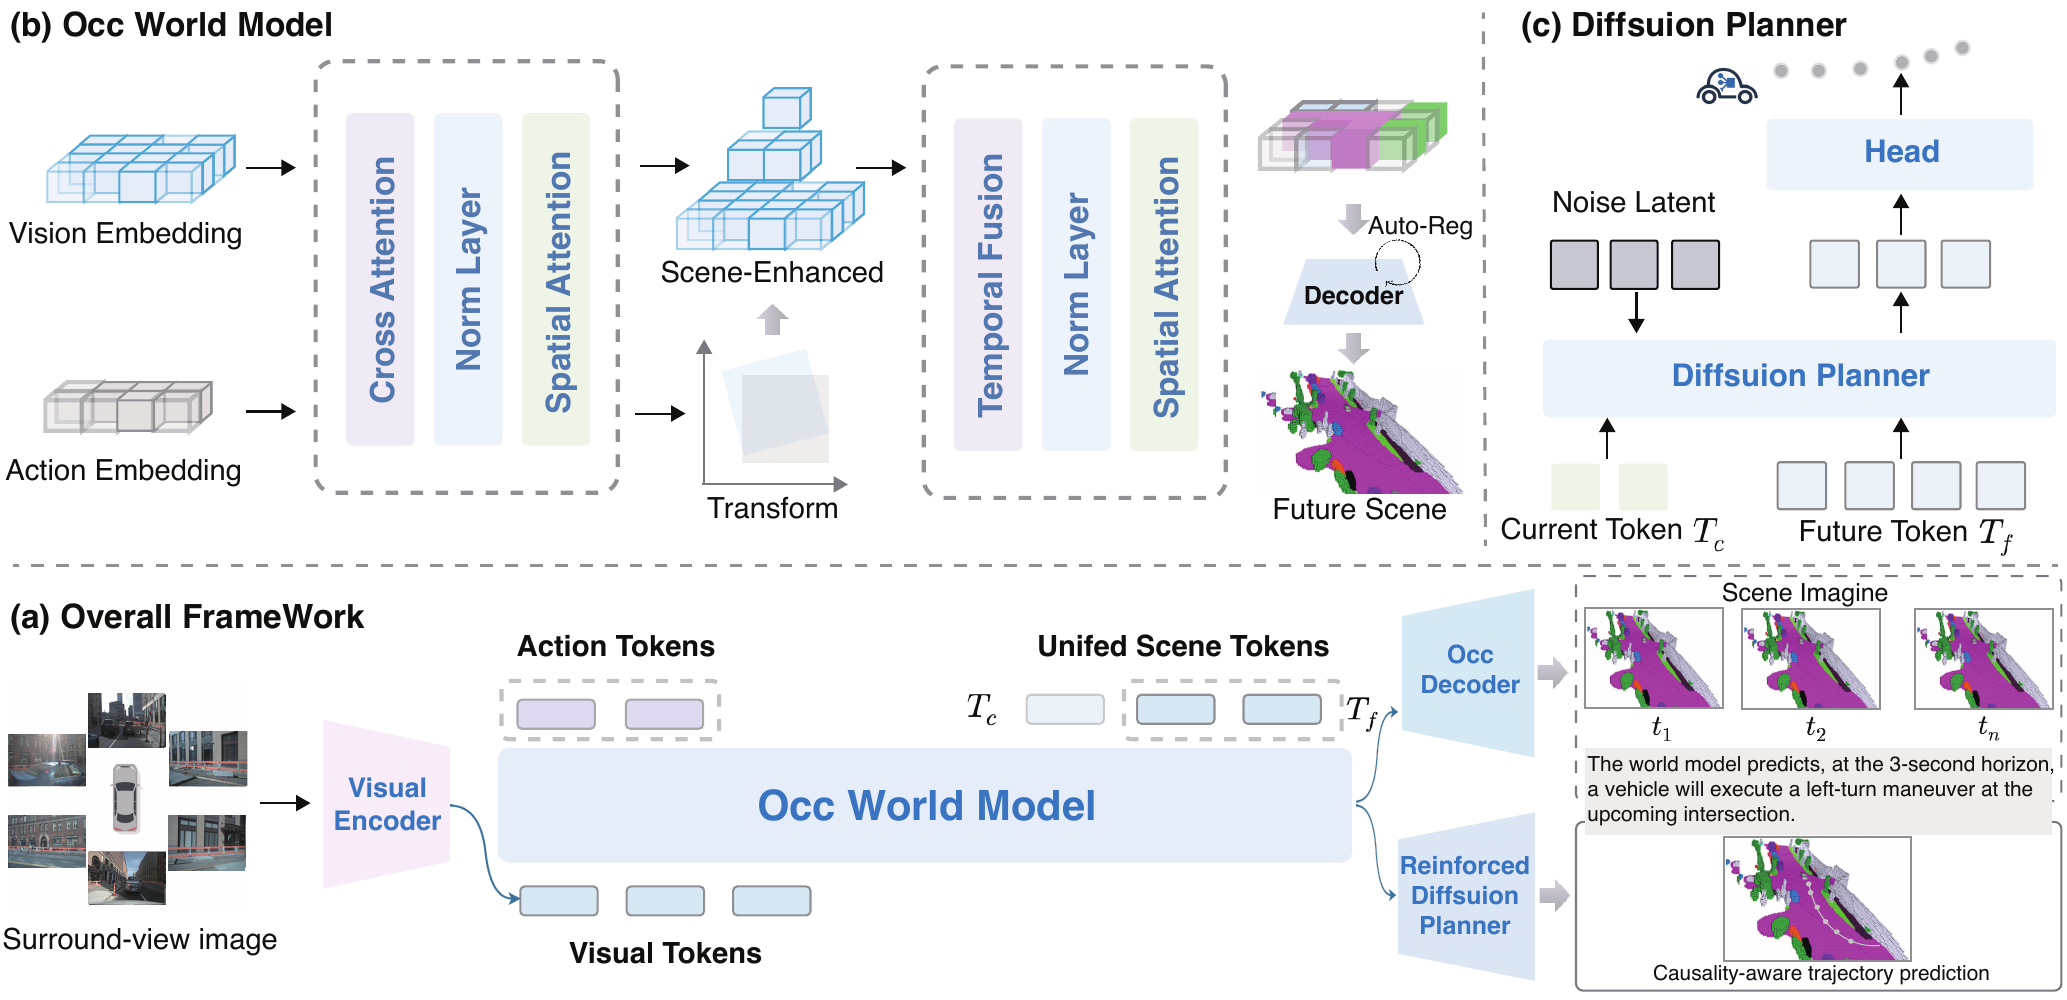
图 2:OWMDrive 框架总览(引自论文 Fig. 2)——(a) 感知编码;(b) 时空融合与自回归解码预测多步占用;(c) 条件扩散细化轨迹。
实验设置与结果:两个基准如何验证"前瞻"的价值
评测协议。 nuScenes 开环:1,000 段 20 秒真实场景,指标为 1/2/3 s 的 L2 距离与碰撞率;NAVSIM navtest 闭环:基于 nuPlan 的挑战场景集,指标为 PDM 分数体系(NC、DAC、TTC、Comfort、EP 与总分 PDMS)。实现上沿用 TransFuser 的 ResNet-34 主干,8 块 NVIDIA L20;开环 10 epochs(lr $3\times10^{-4}$/$3\times10^{-5}$),闭环 100 epochs(lr $6\times10^{-4}$/$6\times10^{-5}$)。
主结果(NAVSIM 闭环 navtest,最高分加粗):
| 方法 | NC↑ | DAC↑ | EP↑ | PDMS↑ |
|---|---|---|---|---|
| Hydra-MDP-𝒱8192 | 97.9 | 91.7 | 77.6 | 83.0 |
| UniAD | 97.8 | 91.9 | 78.8 | 83.4 |
| TransFuser | 97.7 | 92.8 | 79.2 | 84.0 |
| PARA-Drive | 97.9 | 92.4 | 79.3 | 84.0 |
| DiffusionDrive | 98.2 | 96.2 | 82.2 | 88.1 |
| OWMDrive (ours) | 98.2 | 97.6 | 87.3 | 90.8 |
OWMDrive 的 PDMS 90.8 为 navtest 全场第一:DAC 97.6、EP 87.3 均领先所有基线,NC 98.2 与 DiffusionDrive 并列(全场最高为 Hydra-MDP-W-EP 的 98.3)。差距集中在长时程任务进展——这正是未来场景条件应该发力的地方。
nuScenes 开环 L2(m)完整对比(附录 D 织入):
| 方法 | 1s↓ | 2s↓ | 3s↓ | 平均↓ |
|---|---|---|---|---|
| UniAD | 0.44 | 0.67 | 0.96 | 0.69 |
| GenAD | 0.28 | 0.58 | 0.96 | 0.52 |
| BEV-Planner | 0.28 | 0.42 | 0.68 | 0.46 |
| VAD | 0.41 | 0.70 | 1.05 | 0.72 |
| PARA-Drive | 0.25 | 0.46 | 0.74 | 0.48 |
| OccWorld | 0.39 | 0.73 | 1.18 | 0.77 |
| SparseDrive | 0.29 | 0.58 | 0.96 | 0.61 |
| DiffusionDrive | 0.27 | 0.54 | 0.90 | 0.57 |
| OWMDrive (ours) | 0.12 | 0.18 | 0.25 | 0.18 |
开环碰撞率同样每时域最低:1s/2s/3s 分别 0.01%/0.04%/0.11%,平均 0.05%,而 DiffusionDrive 为 0.03%/0.05%/0.16%(平均 0.08%)、OccWorld 平均高达 0.32%。长时程优势最大:3 s 误差 0.25 m,只有次优 PARA-Drive(0.74 m)的三分之一。
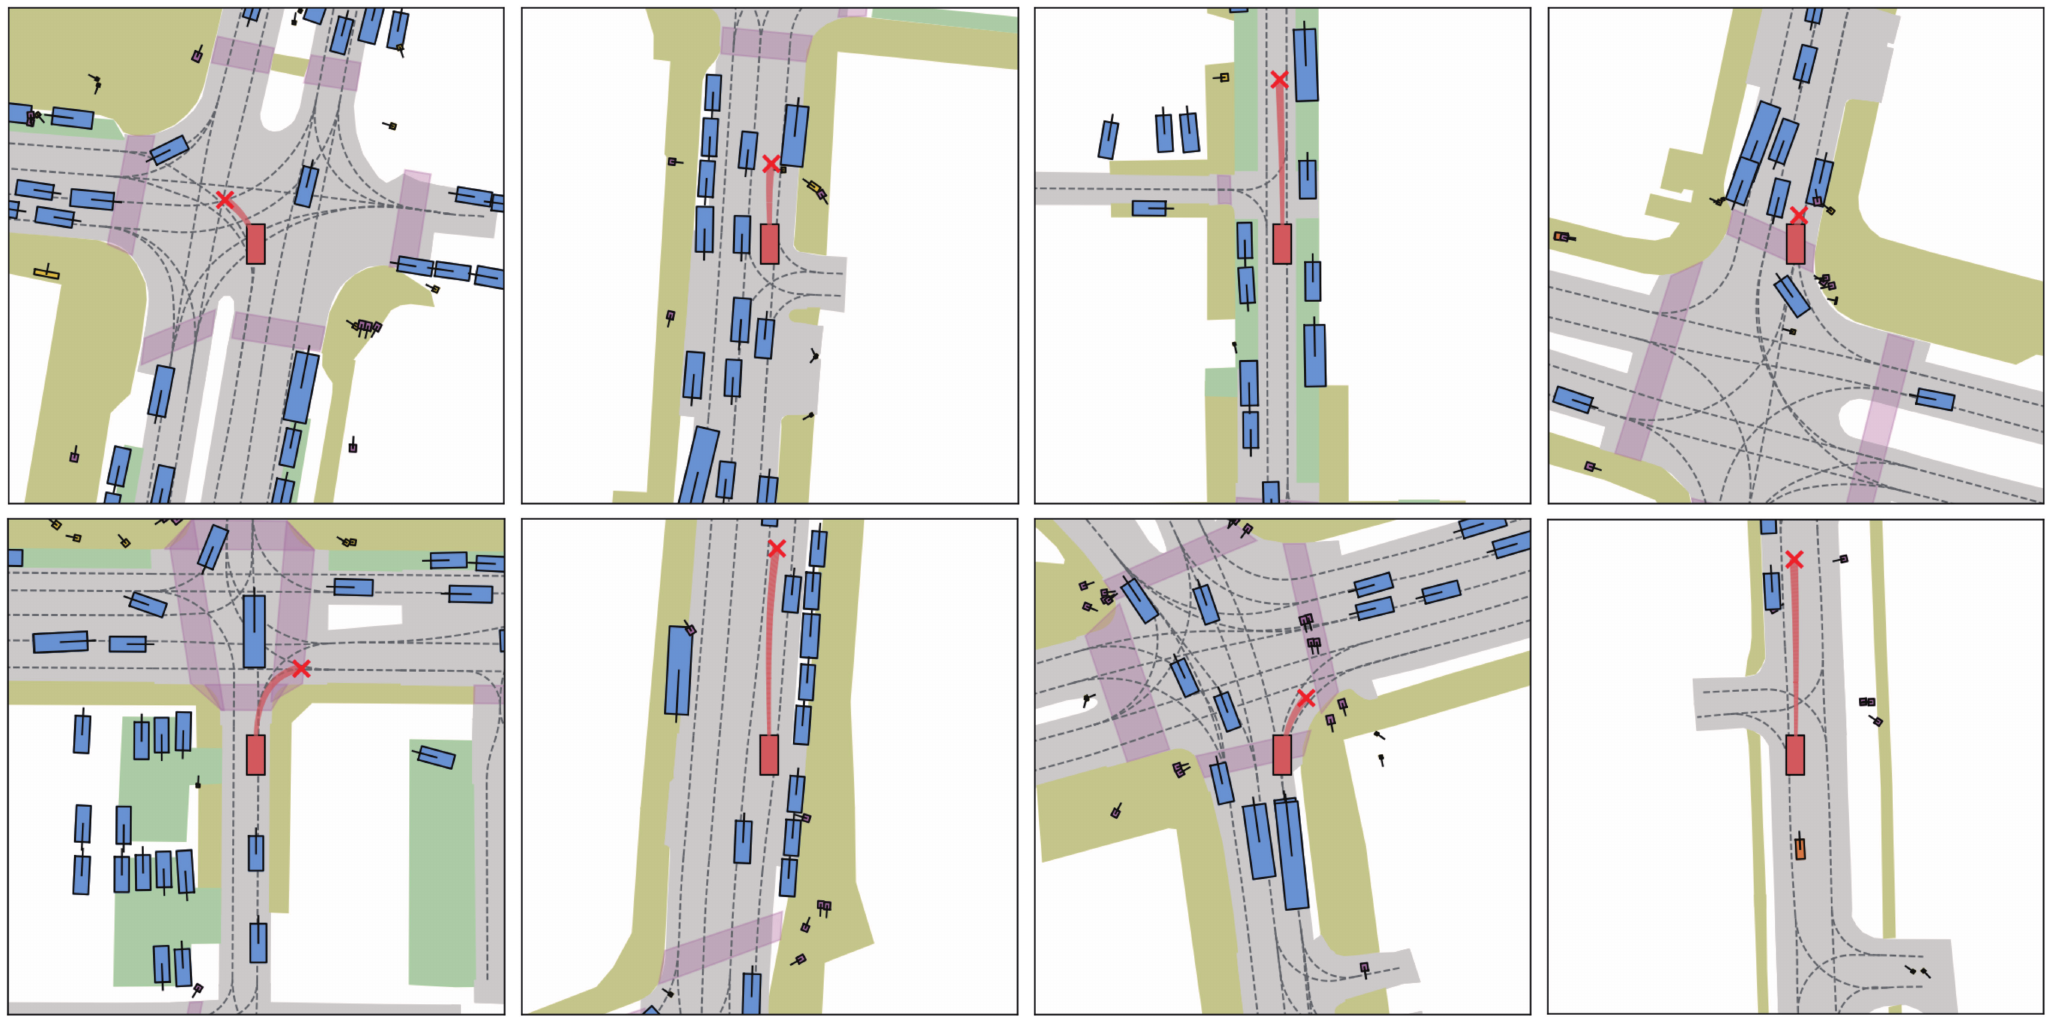
图 3:NAVSIM 闭环可视化(引自论文 Fig. 3)——复杂交互下轨迹保持平滑安全。
消融实验:3 秒前瞻与 GRPO 各自贡献多少?
前瞻时长消融(nuScenes 开环,附录 E 织入): 只用当前观测(0 s 未来)平均 L2 0.59 m、碰撞率 0.09%;加 1 s 预测降到 0.38 m / 0.07%;2 s 到 0.23 m / 0.06%;3 s 全模型 0.18 m / 0.05%——单调改善,说明"预测时长"是干净的连续自变量,性能随视野线性变好,而不是一个开关效应。
闭环侧(NAVSIM,无 RL): 0 s → 3 s,DAC 从 95.8 升到 96.6、EP 从 81.9 升到 82.6、PDMS 从 87.6 升到 88.4。
强化扩散消融: 同样 3 s 前瞻下,加 GRPO 后 DAC 96.6→97.6、EP 82.6→87.3(+4.7)、PDMS 88.4→90.8(+2.4)——RL 主要提升任务进展与复杂交互决策质量,而非无碰撞率(NC 持平 98.2)。
结果对比总结
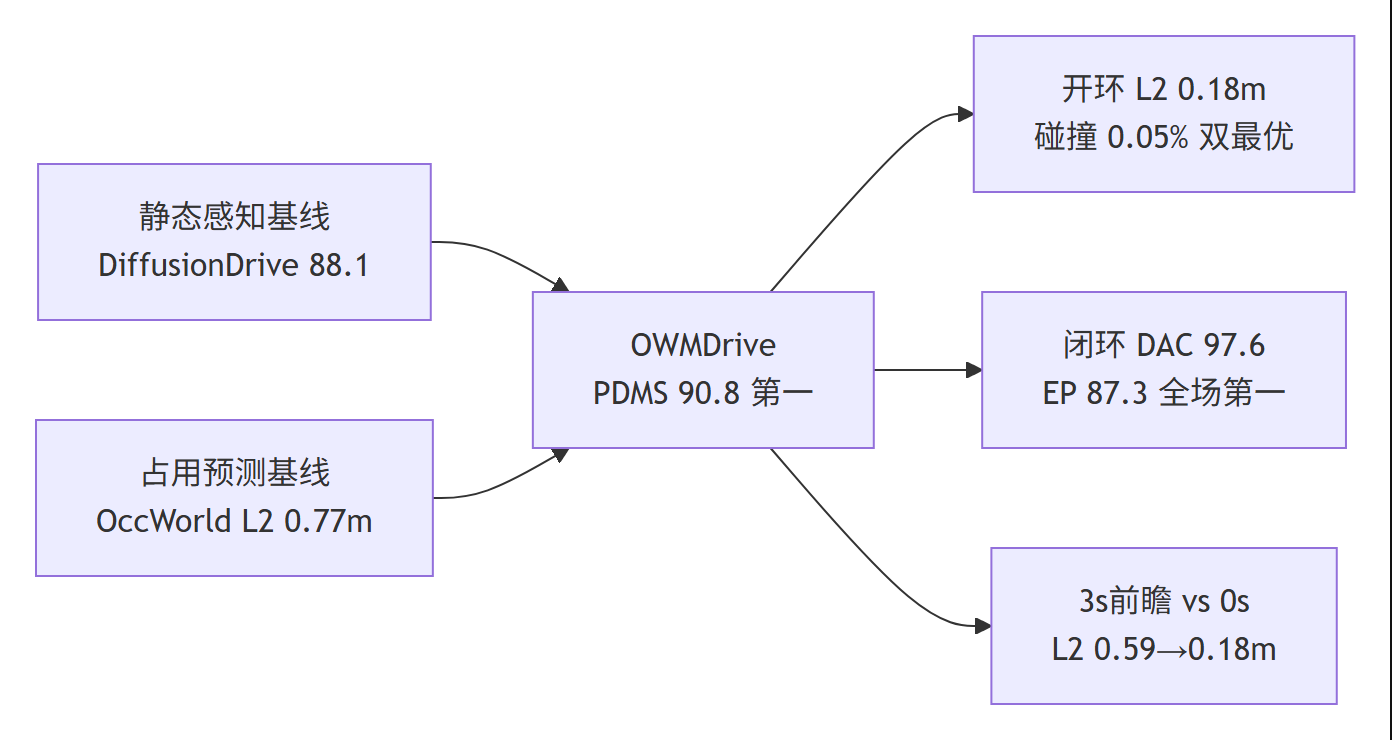
图 6:结果对比总结:双基准第一与前瞻消融收益(Mermaid 流程图)
关键发现
- 开环双最优:nuScenes 平均 L2 0.18 m、平均碰撞率 0.05%,在 9 个基线(UniAD、GenAD、VAD、PARA-Drive、OccWorld、SparseDrive、DiffusionDrive 等)中全面第一。
- 闭环总分第一:NAVSIM navtest PDMS 90.8,比最强的生成式基线 DiffusionDrive(88.1)高 2.7 分。
- 长时程一致性:EP 87.3 大幅领先(DiffusionDrive 82.2、TransFuser 79.2)——"隐式场景演化(Imp)"让遮挡与不确定下的连贯规划成为可能。
- 前瞻单调有效:预测视野 0→1→2→3 s,平均 L2 0.59→0.38→0.23→0.18 m 单调下降,3 s 相对 0 s 误差减半以上。
- RL 强化的是"进展"而非"安全":GRPO 后 EP +4.7、DAC +1.0,NC 不变——强化扩散让规划器在守住安全底线的前提下更敢推进任务。
- 可复用的配方:世界模型预测 + 条件扩散 + 组相对优势强化,三种组件可分别替换升级,框架本身不依赖特定检测器或 BEV 网格。
局限性与未来方向
- 预测误差传播:规划质量受占用世界模型精度制约,高不确定与长尾场景下预测误差会传导到轨迹生成。
- 隐式因果:因果依赖通过未来 rollout 隐式建模,而非显式因果干预,复杂多智能体交互下的可解释性有限。
- 缺不确定性感知:世界模型没有置信度输出,规划器无法区分"预测得很确定"与"预测在瞎猜"。
- 验证范围:NAVSIM 是数据驱动非反应式仿真,还需在更 reactive、更 safety-critical 的场景(真实路测、对抗式仿真)中验证。
作者展望:提升世界模型的可靠性与不确定性感知,并扩展更长预测视野与更丰富语义交互建模。
写作技巧观察:这篇论文的叙事与措辞(附录 F 织入)
- 问题后果前置:摘要先用 "unstable or overly conservative planning" 把"不看未来"的代价讲清楚,再给方案。
- 首尾呼应:引言承诺 "causality-aware conditioning",结论回收 "causality-aware end-to-end trajectory generation",关键词闭环。
- 证据框架:结果段每条结论紧跟数字("lowest average L2 distance of 0.18 m and the lowest collision rate of 0.05%"),不做无数据断言。
- 需要注意的小瑕疵:正文存在 "Evalution metric" 拼写错误;两处插图共用重复标签;正文消融叙述数字(如 0.57 m)与表格口径(0.59 m)不一致——转写数值时以表为准。
常见问题(FAQ)
OWMDrive 和 DiffusionDrive 的核心区别是什么?
DiffusionDrive 的扩散规划器只以当前感知特征为条件;OWMDrive 额外把占用世界模型预测的多步未来 3D 占用序列作为条件注入每一步去噪,并叠加 GRPO 强化——闭环 PDMS 从 88.1 提升到 90.8,EP 从 82.2 提升到 87.3。
为什么用 3D 占用而不是直接预测未来视频或 BEV?
占用表示几何与语义统一、支持遮挡推理,且比像素级预测误差累积更小、计算更省;token 化后的占用序列可以方便地嵌入任意生成式策略,成为规划器的"通用未来接口"。
3 秒前瞻是怎么"喂"给扩散模型的?
世界模型先自回归预测未来 $f$ 步占用序列 $\hat F_{t+1:t+f}$,规划器在去噪的每一步用 temporal cross-attention 把该序列融合进轨迹 latent:$\bar{s}t^k \leftarrow \mathrm{LN}(\bar{s}_t^k + \psi(\bar{s}_t^k, \hat F{t+1:t+f}))$。
GRPO 在这里和 LLM 后训练里的用法有什么不同?
相同的是组相对优势:$\hat A_i=(R(\tau_i)-\mu_R)/(\sigma_R+\epsilon_c)$。不同的是这里作用在扩散去噪策略上,并加了安全截断——NC 或 DAC 不达标时优势直接置为 $-\beta$,避免强化探索产生不安全轨迹;奖励来自导航闭环仿真(PDMS 分量)。
没有未来标注数据,世界模型怎么训练?
占用预测是自监督的:用 nuScenes/NAVSIM 历史序列,当前与历史占用预测未来占用,真实未来占用即监督;规划器与感知骨干则沿用 TransFuser 的 ResNet-34 设定,不依赖额外人工标注。
这个方法能直接上车吗?
论文在 NAVSIM 非反应式闭环中验证,距离实车还有差距:需要更高效的推理(扩散多步去噪 + 世界模型自回归)、世界模型不确定性估计,以及在反应式仿真与真实路测中的验证。
参考链接
- 论文 arXiv 页面:https://arxiv.org/abs/2606.30421
- 论文视频讲解(B 站):https://www.bilibili.com/video/BV1jTbT6XEaU
- OccWorld(3D 占用世界模型,ECCV 2024):https://arxiv.org/abs/2311.16038
- UniAD(Planning-oriented Autonomous Driving,ECCV 2023):https://github.com/OpenDriveLab/UniAD
- TransFuser(端到端传感器融合基线):https://github.com/autonomousvision/transfuser
- NAVSIM(非反应式闭环仿真基准):https://github.com/autonomousvision/navsim
给大家推荐一款自用写文献综述、无虚构文献的 AI:
🌟 复旦大学 FudanNLP 团队自研 切问学术
覆盖 3.6 亿篇可溯源真实中英文文献,能自动整合文献观点生成规范综述
还能挖掘研究创新点、复现实验,配合视频教学,新手快速上手文献综述写作
🍀后记🍀
博客的关键词集中在编程、算法、机器人、人工智能、数学等等,持续高质量输出中。
🌸讨论QQ群:白拾的小屋 (750365700)
⭐B站账号:白拾的物理AI组会(活跃于知识区和动画区)
✨GitHub主页:YhbCode000(工程文件)
更多推荐

 5
 0
- 0


 已为社区贡献2条内容

所有评论(0)