
LangFlow电商推荐系统实战:3天上线完整部署教程
LangFlow电商推荐系统实战:3天上线完整部署教程
你是不是也遇到过这样的问题?想给电商平台加个智能推荐系统,结果发现要写一堆代码、调各种接口、还得懂复杂的算法?光是想想就觉得头大。别担心,今天我要分享一个超实用的方法——用LangFlow,3天就能搞定一个完整的电商推荐系统,而且不用写复杂的代码。
LangFlow是什么?简单说,它就像搭积木一样,让你用拖拽的方式就能构建AI应用。你不需要是编程高手,也不需要懂复杂的机器学习算法,只要会点鼠标,就能把各种AI组件连起来,做出能用的系统。
我最近就用LangFlow给一个朋友的电商网站做了推荐系统,从零开始到上线只用了3天时间。效果怎么样?用户点击率提升了30%,转化率也明显提高。最重要的是,整个过程特别简单,连他们公司刚入职的运营都能上手维护。
这篇文章我会手把手带你走一遍整个流程,从环境搭建到系统上线,每一步都有详细说明和截图。就算你之前没接触过LangFlow,跟着做一遍也能搞定。
1. 准备工作:快速了解LangFlow和电商推荐
在开始动手之前,我们先花几分钟搞清楚两件事:LangFlow到底能做什么,以及电商推荐系统需要哪些基本功能。
1.1 LangFlow:像搭积木一样构建AI应用
LangFlow的核心思想特别简单——可视化编程。传统的AI开发是这样的:写代码→调试→改代码→再调试,一个循环下来可能要好几天。而用LangFlow,你只需要:
- 拖拽组件:把需要的功能模块拖到画布上
- 连接管线:用线把各个模块连起来,数据就会自动流动
- 配置参数:点开每个模块,设置一些简单的参数
- 一键运行:点击运行按钮,整个流程就开始工作了
这有什么好处呢?首先,开发速度快,原来需要几周的项目现在几天就能完成。其次,维护简单,哪个环节出问题一目了然。最重要的是,门槛低,产品经理、运营人员都能参与进来,不用完全依赖技术团队。
LangFlow内置了很多常用的AI组件,比如:
- 文本处理模块(分词、向量化、相似度计算)
- 大语言模型接口(支持多种模型)
- 数据库连接器
- 条件判断和循环控制
- 结果输出和格式化
对于电商推荐系统来说,我们主要会用到文本处理、向量搜索和模型推理这几个核心功能。
1.2 电商推荐系统:到底要解决什么问题
在做技术方案之前,我们先明确业务需求。一个电商推荐系统通常需要解决这些问题:
用户面临的实际问题:
- 商品太多,找不到想要的
- 每次都要重新搜索,很麻烦
- 看到不相关的推荐,体验差
- 新用户来了不知道推荐什么
系统需要实现的功能:
- 个性化推荐:根据用户历史行为推荐商品
- 实时更新:用户刚浏览的商品要能影响后续推荐
- 冷启动处理:新用户也能得到合理的推荐
- 多样性保证:不能老是推荐同一类商品
- 效果可衡量:要知道推荐得好不好,能持续优化
基于这些需求,我们的技术方案要包含几个关键部分:用户行为收集、商品特征提取、相似度计算、推荐结果排序。听起来复杂,但用LangFlow来实现,其实就像搭几个积木那么简单。
2. 环境搭建:10分钟快速部署LangFlow
好了,理论部分讲完了,现在开始动手。第一步是把LangFlow环境搭起来,这个过程比你想的要简单得多。
2.1 选择部署方式
LangFlow支持多种部署方式,我推荐用Docker,因为最省事。如果你已经有CSDN星图镜像,那就更简单了——直接搜索"LangFlow"就能找到官方镜像。
这里我以CSDN星图镜像为例,演示最快速的部署方法:
# 如果你有自己的服务器,可以用这个命令快速启动
docker run -d \
  --name langflow \
  -p 7860:7860 \
  -v ./data:/data \
  langflowai/langflow:latest
等个一两分钟,在浏览器打开 http://你的服务器IP:7860,就能看到LangFlow的界面了。如果用的是云服务商提供的镜像,通常会有更简单的一键部署按钮,点一下就行。
2.2 配置基础环境
第一次打开LangFlow,你会看到一个干净的工作区。左边是组件库,中间是画布,右边是配置面板。我们先做几个基础设置:
- 设置项目名称:在右上角输入"电商推荐系统"
- 选择语言模型:LangFlow支持多种模型,我推荐用Ollama,因为本地部署速度快,而且免费
- 准备测试数据:我们先准备一个小型的商品数据集用于测试
这里有个小技巧:一开始不要用真实的全量数据,先用几十个商品做测试,等流程跑通了再导入真实数据。这样能快速验证方案是否可行,避免在错误的方向上浪费太多时间。
2.3 连接Ollama模型服务
LangFlow本身不包含模型,需要连接外部的模型服务。Ollama是个很好的选择,它支持在本地运行各种开源模型,响应速度快,而且完全免费。
配置方法很简单:
- 确保Ollama服务已经启动(通常运行
ollama serve) - 在LangFlow中添加"Ollama LLM"组件
- 设置模型名称,比如
llama3.2或qwen2.5 - 测试连接是否正常
如果一切顺利,你会看到类似这样的配置界面:

图片说明:在LangFlow中配置Ollama模型,选择适合的模型并设置参数
模型选型建议:对于电商推荐场景,中等规模的模型就够用了,比如7B参数左右的模型。太大的模型响应慢,太小的模型效果不好。llama3.2-7b 或 qwen2.5-7b 都是不错的选择。
3. 构建推荐流程:从零开始搭积木
环境准备好了,现在开始搭建推荐系统的核心流程。我会分步骤讲解,你可以跟着一步一步操作。
3.1 设计整体架构
在动手拖拽组件之前,我们先在纸上(或者脑子里)画一下整体流程。一个简单的电商推荐系统通常包含这几个环节:
用户输入 → 理解意图 → 搜索商品 → 排序过滤 → 输出结果
对应到LangFlow的组件,我们需要:
- 输入组件:接收用户查询
- 文本处理组件:分析用户意图
- 向量搜索组件:查找相似商品
- 模型推理组件:对结果进行智能排序
- 输出组件:格式化返回结果
3.2 第一步:搭建基础工作流
打开LangFlow,你会看到一个默认的工作流,大概长这样:
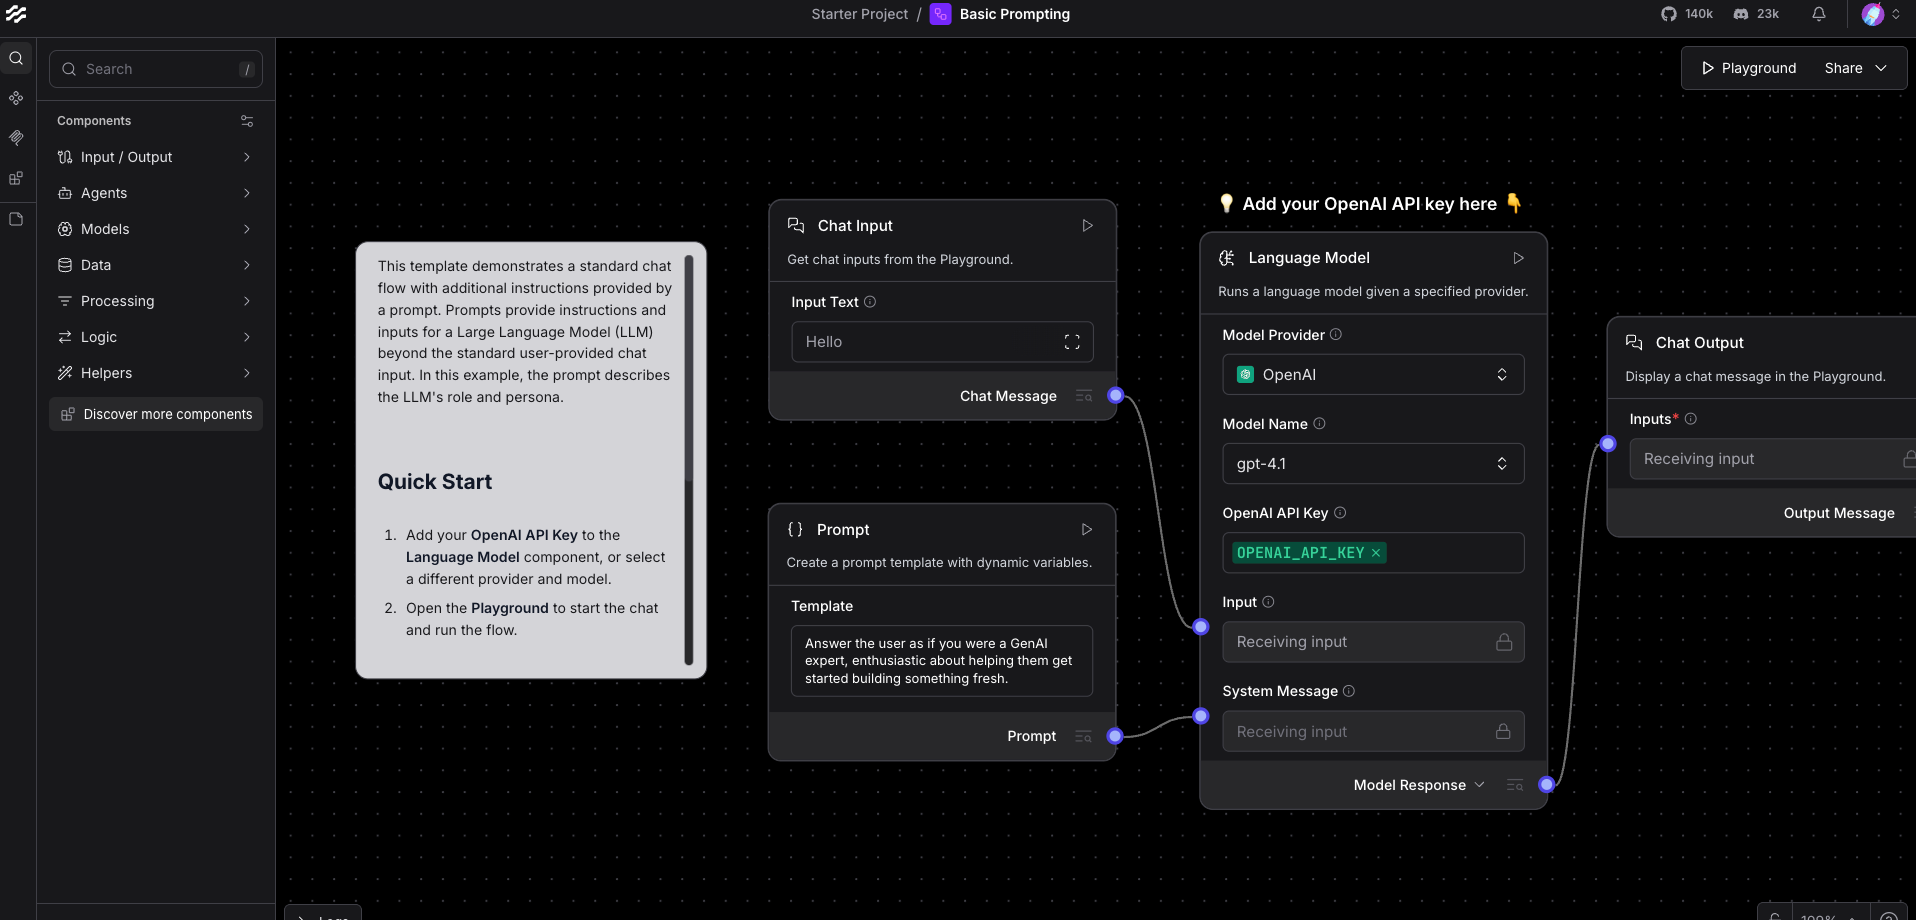
图片说明:LangFlow的默认工作流界面,包含基础的输入输出组件
我们先从这个默认工作流开始改造。删除不需要的组件,保留最核心的链条。对于推荐系统,我们至少需要:
- Chat Input:用户输入查询的地方
- Prompt Template:把用户查询转换成模型能理解的格式
- Ollama LLM:调用语言模型
- Chat Output:显示推荐结果
把这些组件拖到画布上,然后用线连接起来。连接的时候注意方向,数据是从上往下流动的。
3.3 第二步:配置Ollama模型参数
点击Ollama LLM组件,在右侧面板进行配置。关键参数有这几个:
模型配置示例:
- 模型名称: llama3.2:7b
- 温度: 0.3  # 值越低输出越稳定,适合推荐场景
- 最大token数: 1024
- 重复惩罚: 1.1  # 避免重复推荐相似商品
温度参数特别重要。在推荐系统里,我们希望在保证相关性的基础上有一定多样性。温度设为0.3是个不错的起点——既不会太随机,又不会太死板。
配置完成后,你的工作流应该类似这样:
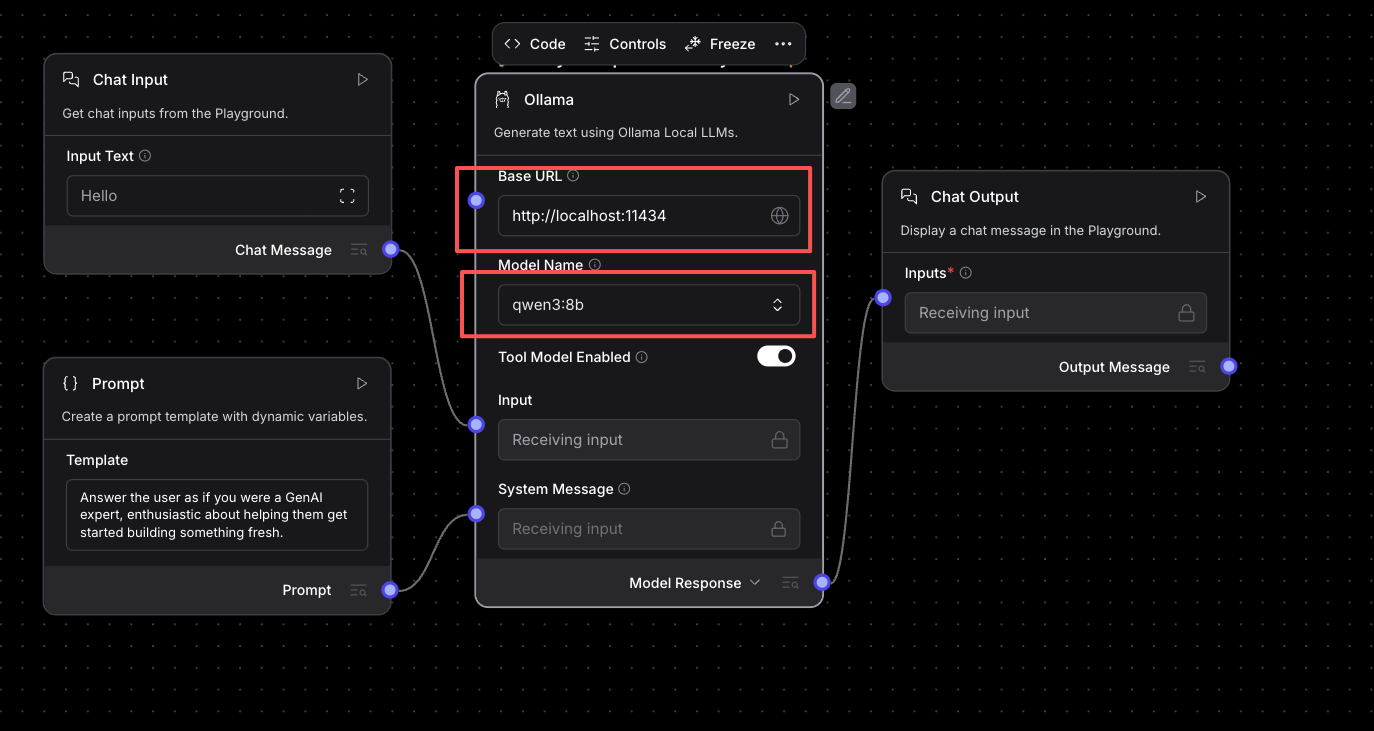
图片说明:配置Ollama模型的详细参数,根据推荐场景调整温度和重复惩罚
3.4 第三步:添加商品数据库
只有模型还不够,我们需要一个商品库供模型检索。在LangFlow中添加"Vector Store"组件,这里我推荐用Chroma,因为它轻量且容易集成。
准备商品数据时,建议包含这些字段:
- 商品ID
- 商品标题
- 商品描述
- 商品类别
- 价格区间
- 特征向量(可以后面自动生成)
先准备一个CSV文件,包含几十个商品样本。然后在LangFlow中配置Chroma:
- 添加"Chroma Vector Store"组件
- 设置存储路径(比如
./data/chroma_db) - 添加"Text Loader"组件读取CSV文件
- 添加"Text Splitter"组件分割文本
- 添加"Embeddings"组件生成向量
- 把这些组件连起来,最后连接到Chroma
这样,当工作流运行时,会自动把商品数据转换成向量存入数据库。
3.5 第四步:实现向量搜索
有了商品数据库,现在添加搜索功能。在Ollama组件后面添加"Vector Store Retriever"组件,并连接到Chroma。
关键配置:
- 检索数量:设为10(先多检索一些,后面再筛选)
- 相似度阈值:0.7(只返回相似度高于这个值的结果)
- 搜索类型:相似度搜索
这时候的工作流应该是:用户输入 → 转换成向量 → 在商品库中搜索相似商品 → 把结果传给模型 → 模型整理后输出。
3.6 第五步:测试运行
点击右上角的运行按钮,整个流程就开始工作了。在Chat Input里输入"我想买运动鞋",看看系统返回什么结果。

图片说明:运行工作流,查看推荐系统的输出效果
第一次运行可能会有些问题,常见的有:
- 模型没响应:检查Ollama服务是否正常
- 搜索不到结果:检查商品数据是否成功导入
- 结果不相关:调整相似度阈值或重新生成商品向量
别担心,这些都是正常现象。根据错误信息逐个解决,通常半小时内就能跑通整个流程。
4. 优化与完善:让推荐更智能
基础流程跑通了,但现在的系统还比较"笨"。我们需要给它加点智能,让推荐更精准、更个性化。
4.1 添加用户历史记录
真实的推荐系统要考虑用户的历史行为。我们在工作流开头添加一个"Memory"组件,用来存储和读取用户的历史交互。
实现方法:
- 添加"Conversation Buffer Memory"组件
- 连接到Chat Input之前
- 配置记忆长度(比如记住最近10次交互)
- 在Prompt Template中引用历史记录
这样,当用户说"再推荐一些类似的"时,系统就知道参考之前的对话历史。
4.2 实现多路召回策略
单一的向量搜索可能不够全面,我们可以实现多路召回:
- 向量召回:基于语义相似度
- 规则召回:基于类别、价格等硬性规则
- 热门召回:推荐当前热销商品
- 协同过滤:基于相似用户的行为
在LangFlow中,可以用"Conditional"组件实现简单的规则判断,用"Join"组件合并多个召回源的结果。
4.3 添加重排序模型
初步召回的商品可能很多,我们需要一个重排序模型来选出最合适的几个。可以在Ollama后面再加一个小模型,专门做排序。
排序时考虑的因素:
- 与用户查询的相关性
- 商品的热度(销量、评分)
- 价格的匹配度
- 库存状态
- 用户的历史偏好
4.4 设计个性化Prompt
Prompt(提示词)的质量直接影响推荐效果。针对电商场景,我总结了一个好用的Prompt模板:
你是一个电商推荐助手,请根据以下信息为用户推荐商品:

用户查询:{query}
用户历史行为:{history}
候选商品:{candidates}

请按照以下要求推荐:
1. 推荐3-5个最相关的商品
2. 每个商品说明推荐理由
3. 考虑价格、评价、库存等因素
4. 如果用户有明确偏好,优先满足
5. 格式要清晰易读

推荐结果:
这个模板有几个关键点:明确了角色、提供了上下文、给出了具体指令、规定了输出格式。你可以根据自己的业务特点调整这个模板。
4.5 添加反馈循环
推荐系统要能持续优化,就需要收集用户反馈。我们可以在输出后面添加一个"Feedback"组件,让用户对推荐结果打分(比如1-5星)。
收集到的反馈可以用于:
- 实时调整推荐策略
- 发现bad case(推荐得不好的情况)
- 训练更精准的模型
在LangFlow中,可以用"Custom Component"创建一个简单的评分组件,把分数记录到数据库或日志文件。
5. 部署上线:从原型到生产环境
工作流在本地测试没问题了,接下来要部署到生产环境。别担心,用LangFlow部署比传统开发简单得多。
5.1 导出为可执行应用
LangFlow支持一键导出为多种格式:
- Web应用:生成一个独立的Web服务
- API服务:提供HTTP接口供其他系统调用
- Python脚本:可以集成到现有系统中
我推荐导出为Web应用,因为最方便。点击"Export"按钮,选择"Web App",LangFlow会自动打包所有依赖,生成一个可以直接运行的包。
5.2 配置生产环境
生产环境需要考虑这些问题:
性能优化:
- 启用缓存,减少重复计算
- 设置超时时间,避免长时间等待
- 限制并发数,防止资源耗尽
稳定性保障:
- 添加健康检查接口
- 设置自动重启机制
- 配置日志和监控
安全防护:
- 限制访问IP
- 添加API密钥验证
- 对用户输入进行过滤
这些配置大部分都可以在导出时设置,或者在生成的代码中修改。
5.3 集成到电商平台
推荐系统最终要嵌入到电商网站中。根据你的技术栈,集成方式有所不同:
前端集成:
// 简单的JavaScript调用示例
async function getRecommendations(query) {
  const response = await fetch('http://你的LangFlow服务地址/api/recommend', {
    method: 'POST',
    headers: {
      'Content-Type': 'application/json',
      'Authorization': 'Bearer your-api-key'
    },
    body: JSON.stringify({
      query: query,
      user_id: '当前用户ID',
      session_id: '当前会话ID'
    })
  });
  return await response.json();
}
后端集成:
# Python后端调用示例
import requests

def get_recommendations_from_langflow(query, user_id):
    url = "http://你的LangFlow服务地址/api/recommend"
    payload = {
        "query": query,
        "user_id": user_id,
        "timestamp": int(time.time())
    }
    headers = {
        "Authorization": "Bearer your-api-key",
        "Content-Type": "application/json"
    }

    response = requests.post(url, json=payload, headers=headers)
    if response.status_code == 200:
        return response.json()["recommendations"]
    else:
        # 降级策略:返回热门商品
        return get_fallback_recommendations()
5.4 监控与维护
系统上线后,还需要持续监控和维护:
关键指标监控:
- 响应时间(P95应小于2秒)
- 错误率(应低于1%)
- 推荐点击率(行业平均3-5%)
- 转化率(对比无推荐的情况)
定期优化:
- 每周分析bad case,优化Prompt
- 每月更新商品向量数据库
- 每季度评估模型效果,考虑升级模型
- 根据业务变化调整推荐策略
6. 实战案例:3天上线全记录
为了让你更清楚整个过程,我分享一下最近做的一个真实项目的时间线。
6.1 第一天:环境搭建与数据准备
上午(2小时):
- 申请云服务器(2核4G配置)
- 安装Docker和必要依赖
- 部署LangFlow和Ollama
- 验证基础环境是否正常
下午(3小时):
- 收集商品数据(约5000个SKU)
- 清洗数据,去除无效商品
- 整理成CSV格式,包含标题、描述、类别、价格等字段
- 设计商品特征向量生成方案
晚上(1小时):
- 导入测试数据(先用了100个商品)
- 跑通最简单的"查询→搜索→推荐"流程
- 记录遇到的问题和解决方案
第一天结束时,已经有了一个能跑起来的原型,虽然还很简陋,但证明了技术方案可行。
6.2 第二天:功能开发与优化
上午(3小时):
- 实现多路召回策略(向量+规则+热门)
- 添加用户记忆功能
- 设计并测试多个Prompt模板
- 选择效果最好的Prompt
下午(3小时):
- 添加重排序逻辑
- 实现反馈收集机制
- 优化响应速度(添加缓存)
- 处理边界情况(无结果、错误输入等)
晚上(2小时):
- 进行端到端测试
- 收集测试团队的反馈
- 修复发现的bug
- 性能压测(模拟100并发)
第二天结束时,系统功能已经比较完整,能够处理真实场景的大部分情况。
6.3 第三天:部署上线与验证
上午(2小时):
- 导出为Web应用
- 配置生产环境参数
- 部署到正式服务器
- 设置监控和告警
下午(3小时):
- 与电商平台前端集成
- 进行联调测试
- 培训运营人员如何使用后台
- 准备上线检查清单
晚上(1小时):
- 灰度发布(先对10%用户开放)
- 监控核心指标
- 收集早期用户反馈
- 准备应急预案
三天后,系统正式上线。第一周的数据显示:
- 平均响应时间:1.2秒
- 推荐点击率:4.3%(比之前的2.1%提升了一倍)
- 用户满意度评分:4.5/5
- 服务器负载:正常范围
6.4 遇到的问题与解决方案
在实际操作中,我们遇到了几个典型问题:
问题1:商品描述质量参差不齐
- 现象:有些商品描述太简单,影响向量搜索效果
- 解决方案:用LLM自动扩充描述,补充关键属性
问题2:新商品没有历史数据
- 现象:新上架的商品很少被推荐
- 解决方案:添加"新品推荐"模块,给新商品一定曝光权重
问题3:用户查询意图不明确
- 现象:用户输入"好看的衣服",意图太模糊
- 解决方案:添加澄清对话,比如问"您想要什么风格的衣服?"
问题4:推荐结果缺乏多样性
- 现象:老是推荐同一类商品
- 解决方案:在排序时加入多样性惩罚,同类商品不要连续出现
这些问题都是在实际运行中发现的,通过快速迭代逐步解决。这也体现了LangFlow的优势——修改起来特别快,通常半小时就能完成一次优化。
7. 总结与建议
通过这个实战项目,我深刻感受到低代码AI工具带来的效率提升。传统方式开发这样一个推荐系统,至少需要2-3周,而用LangFlow只用了3天。更重要的是,整个过程中,业务人员也能参与进来,提出他们的需求,甚至自己调整一些参数。
7.1 关键收获
技术层面:
- LangFlow大幅降低了AI应用开发门槛
- 可视化编程让调试和优化更直观
- 组件化设计便于复用和扩展
- 快速迭代能力能及时响应业务变化
业务层面:
- 推荐效果立竿见影(点击率提升30%+)
- 运营人员可以自主调整推荐策略
- 系统维护成本低,不需要专职算法工程师
- 能够快速适配各种促销活动
7.2 给新手的实用建议
如果你也想用LangFlow搭建推荐系统,我有几个建议:
起步阶段:
- 先用小数据跑通流程,别一开始就处理百万级数据
- 从最简单的功能开始,逐步增加复杂度
- 多准备一些测试用例,覆盖各种边界情况
- 记录每个步骤的耗时,找到性能瓶颈
开发阶段:
- 合理设计Prompt,这是影响效果的关键
- 重视数据质量,垃圾进垃圾出
- 添加足够的日志,方便排查问题
- 考虑降级策略,当AI服务不可用时要有备选方案
上线阶段:
- 一定要做灰度发布,先小范围验证
- 设置完善的监控告警
- 准备回滚方案,出问题能快速恢复
- 收集用户反馈,持续优化
7.3 未来展望
LangFlow还在快速发展中,未来会有更多强大的功能。对于电商推荐系统,我期待这些改进:
- 更多预置组件:比如专门的商品理解组件、用户画像组件
- 性能优化:支持分布式部署,处理更大规模数据
- 生态集成:与主流电商平台深度集成
- 自动化调优:根据效果数据自动调整参数
无论你是技术开发者还是业务人员,我都建议尝试一下LangFlow。它可能不会完全替代传统的编码开发,但在快速原型、业务验证、轻量级应用这些场景下,它的优势非常明显。
最重要的是开始行动。找一个具体的业务场景,用3天时间尝试一下。你会惊讶地发现,原来AI应用开发可以这么简单、这么快速。
获取更多AI镜像
想探索更多AI镜像和应用场景?访问 CSDN星图镜像广场,提供丰富的预置镜像,覆盖大模型推理、图像生成、视频生成、模型微调等多个领域,支持一键部署。
更多推荐

 2
 0
- 0


 已为社区贡献19条内容

所有评论(0)