
KERAG_R:面向推荐系统的知识增强型检索增强生成(Knowledge-Enhanced Retrieval-Augmented Generation for Recommendation)论文阅读
Abstract(摘要)
翻译
大型语言模型(LLMs)凭借其强大的上下文学习和泛化能力,在包括推荐系统在内的各类任务中显著提升了性能。现有基于 LLM 的推荐方法通常通过设计专用提示词(prompt)来利用其上下文能力,并使输出与人类偏好紧密对齐,从而获得更好的推荐效果。然而,LLM 在推荐任务中的应用受限于缺乏领域特定知识 ——LLM 预训练语料中缺少待推荐物品的相关关系型知识,可能导致预测不准确或产生 “幻觉”(hallucinations),进而生成错误或误导性的推荐。此外,直接使用知识图谱中的信息会引入冗余和噪声,可能影响 LLM 的推理过程或超出其输入上下文长度,从而降低基于 LLM 的推荐性能。
为解决领域特定知识缺失的问题,我们提出一种新型模型 —— 面向推荐系统的知识增强型检索增强生成(KERAG_R)。具体而言,我们利用图检索增强生成(GraphRAG)组件,将知识图谱(KG)中的额外信息整合到提示词中,使 LLM 能够协同利用基于文本的用户交互信息和知识图谱中的推荐信号,在推荐场景中更准确地估计用户偏好。特别地,我们通过预训练一个图注意力网络(GAT)来执行图 RAG,为目标用户选择与 LLM 最相关的三元组(triple),从而在增强 LLM 能力的同时减少冗余和噪声。此外,我们采用知识增强的指令微调(instruction tuning)方法,在 LLM 的微调阶段融入关系型知识,提升 LLM 在推荐系统中的适应性。
我们在三个公开数据集上进行了大量实验,结果表明,所提出的 KERAG_R 模型显著优于十种现有最先进的推荐方法。特别是在 Amazon-Book 数据集上,KERAG_R 比最优基线模型(基于 LLM 的推荐模型 RecRanker)性能提升高达 14.89%。我们还发现:使用图 RAG 检索最相关的 KG 信息比使用额外的 KG 三元组更有效;在提示词中,知识图谱的关系型三元组表示优于自然语句表示。
详细解释
摘要是论文的 “浓缩版”,核心信息拆解如下:
-
背景与问题:
- 优势:LLMs 的上下文学习 + 泛化能力让推荐系统性能提升;
- 核心缺陷 1:缺 “领域特定知识”(比如推荐书籍时,LLM 可能不知道某本书的作者、题材关联等 KG 信息),导致 “幻觉”(比如推荐一本不存在的书籍关联);
- 核心缺陷 2:直接用 KG 信息会引入冗余 / 噪声(比如把与用户无关的书籍三元组都塞进提示词),还可能超出 LLM 的输入长度限制(比如 GPT-3.5 输入上限是 4k token)。
-
KERAG_R 的解决方案:
- 核心组件 1:GraphRAG(图检索增强生成)—— 从 KG 中选 “最相关” 的三元组,避免冗余;
- 核心组件 2:GAT(图注意力网络)—— 负责筛选 KG 三元组,找到和用户 / 物品最相关的;
- 核心组件 3:知识增强指令微调 —— 在 LLM 微调时就融入 KG 的关系知识,让 LLM 更适配推荐任务。
-
实验结果:
- 对比 10 种 SOTA(最先进)方法,全优;
- 关键对比:比 RecRanker(最好的 LLM 推荐基线)在 Amazon-Book 上高 14.89%;
- 两个重要发现:① 选 “相关三元组” 比堆 “更多三元组” 好;② 三元组格式(如 “书籍 A - 作者 - 张三”)比句子格式(“书籍 A 的作者是张三”)好。
-
专业术语注解:
- Hallucinations(幻觉):LLM 生成不存在 / 错误的信息(比如推荐 “《三体》的作者是刘慈欣” 是正确的,生成 “《三体》的作者是莫言” 就是幻觉);
- Knowledge Graph(KG,知识图谱):由 “实体 - 关系 - 实体” 的三元组组成的图结构(比如 “书籍 - 题材 - 科幻”“作者 - 创作 - 书籍”);
- Triple(三元组):KG 的基本单元,格式为(头实体 h, 关系 r, 尾实体 t),比如(《三体》, 题材,科幻);
- Instruction Tuning(指令微调):用 “任务指令 + 示例” 训练 LLM,让它听懂特定任务(比如 “根据用户历史推荐 top5 书籍”);
- SOTA(State-of-the-Art):当前领域内最先进的方法。
CCS Concepts & Keywords(学科分类与关键词)
翻译
CCS Concepts(学科分类):信息系统 → 推荐系统
Keywords(关键词):检索增强生成(Retrieval-Augmented Generation)、知识图谱(Knowledge Graph)、大型语言模型(Large Language Model)、推荐系统(Recommender System)
详细解释
这部分是论文的 “主题标签”,帮助学术数据库分类和检索:
- CCS Concepts:明确论文属于 “信息系统” 学科下的 “推荐系统” 子方向,划定研究领域;
- Keywords:4 个核心关键词覆盖了论文的 3 大技术核心(RAG、KG、LLM)和 1 个应用场景(推荐系统),是理解论文核心的快速入口。
ACM Reference Format(参考文献格式)
翻译
Zeyuan Meng, Zixuan Yi, and Iadh Ounis. 2024. KERAG_R: Knowledge-Enhanced Retrieval-Augmented Generation for Recommendation. In Proceedings of x (x ’XX). ACM, New York, NY, USA, 10 pages. https://doi.org/XXXXXXX.XXXXXXX
详细解释
这是论文的 “标准引用格式”:
- 格式规范:作者 → 年份 → 标题 → 会议集 → 出版社 → 页码 → DOI(数字对象唯一标识符);
- 用途:其他研究者引用该论文时需遵循此格式,DOI 可直接定位到论文(原文中 DOI 为占位符 XXXXXXX.XXXXXXX,正式发表后会有真实编号);
- 会议信息:“x ’XX” 是占位符,代表论文将发表的会议(根据上下文推测是信息检索 / 推荐系统领域的顶级会议,如 SIGIR、RecSys)。
1 Introduction(引言)
第 1 段翻译
大型语言模型(LLMs)[1, 54, 82] 在文本理解 [41]、生成 [35] 和推理 [2] 方面展现出卓越能力。凭借其强大的泛化能力,LLMs 已被积极整合到各个领域,包括推荐系统,以提升个性化服务和用户体验 [48, 83]。推荐系统 [14, 37, 56, 72, 75] 是一种广泛应用的应用程序,旨在为各类在线服务中的目标用户推荐潜在感兴趣的物品。具体而言,LLMs 已被用于多种推荐任务,包括协同过滤和序列推荐 [60, 66, 77]。早期基于 LLM 的推荐模型通过历史交互信息编码用户特征 [50, 79],但由于 LLM 的输入 token 长度限制 [13, 49],往往难以在单个提示词中处理完整的交互历史。为解决这一限制,后续的基于 LLM 的推荐模型提出筛选物品和用户的最相关文本信息输入 LLM,从而提升推荐性能 [6, 57]。尽管有这些改进,这些增强方法仍然直接使用 LLM,未针对推荐任务进行特定微调。这种未适配具体任务的 LLM 通用应用可能导致模型与实际推荐任务错位,进而限制这些模型的性能 [50, 57]。相反,近期研究 [39, 68, 69, 71, 77] 提出使用自然语言指令适配(natural language instruction adaptation),使 LLMs 更好地对齐特定推荐任务。RecRanker [39] 是一个典型例子,它通过自适应用户采样(adaptive user sampling)构建具有代表性的提示词进行指令微调,使 Llama-2 模型 [54] 对齐当前的 top-k 推荐任务。
第 1 段详细解释
这一段的核心是 “铺垫 LLM 在推荐系统中的发展历程与现有问题”,拆解如下:
-
LLM 的核心能力与应用场景:
- 三大能力:文本理解(比如读懂用户评论)、生成(比如生成推荐理由)、推理(比如推断用户喜欢 “科幻小说” 可能也喜欢 “太空探索” 书籍);
- 应用:推荐系统的目标是 “个性化推荐潜在物品”(比如电商推荐商品、视频平台推荐电影)。
-
LLM 推荐模型的发展阶段:
- 早期:用历史交互编码用户特征(比如用户看过的电影列表),但受限于 LLM 的输入长度(比如用户看了 100 部电影,无法全部塞进提示词);
- 中期:筛选 “最相关” 的交互信息(比如只保留用户最近看的 10 部电影),解决输入长度问题,但没做任务微调;
- 近期:用 “指令适配”(比如明确告诉 LLM “根据用户历史推荐 top5 电影”),代表模型是 RecRanker—— 通过 “自适应用户采样”(选有代表性的用户构建提示词)让 Llama-2 适配 top-k 推荐(推荐前 k 个物品)。
-
关键术语注解:
- Token:LLM 处理文本的基本单位(比如 “推荐” 是 1 个 token,“《三体》” 是 1 个 token),输入长度限制即 “最多能输入多少个 token”(比如 Llama-2 7B 的输入上限是 4096 token);
- 协同过滤(Collaborative Filtering):基于 “用户相似性” 或 “物品相似性” 推荐(比如 A 和 B 都喜欢《三体》,给 A 推荐 B 喜欢的《流浪地球》);
- 序列推荐(Sequential Recommendation):基于用户交互的时间顺序推荐(比如用户先看《射雕英雄传》,再推荐《神雕侠侣》);
- Top-k 推荐:推荐前 k 个最可能让用户感兴趣的物品(k 通常是 3、5、10,比如推荐 top5 书籍);
- 自适应用户采样:从海量用户中选 “能代表不同偏好的用户”(比如选喜欢科幻、言情、历史的用户各一批),避免提示词只偏向某一类用户。
第 2 段翻译
然而,现有基于 LLM 的推荐模型仍然主要依赖用户交互内容和 LLM 的预训练语料,可能因缺乏支持当前推荐任务所需的领域特定知识而受影响。尽管 LLMs 具有出色的上下文表示能力,但预训练语料中缺少待推荐物品的相关关系型知识,可能导致这些 LLM 产生 “幻觉”,进而生成错误或误导性的推荐。我们认为,将外部知识源充分整合到基于 LLM 的推荐模型中,对于提升 LLM 在推荐场景中学习特定领域知识的能力至关重要。
第 2 段详细解释
这一段是 “点出核心问题”:现有 LLM 推荐模型缺 “领域特定知识”,导致幻觉。
- 举例:用户想找 “刘慈欣的科幻小说”,LLM 预训练语料中可能没有 “《球状闪电》是刘慈欣写的科幻小说” 这个 KG 三元组,就可能推荐 “《球状闪电》是莫言的言情小说”(幻觉);
- 核心观点:必须把 “外部知识”(比如 KG)整合进 LLM,才能解决这个问题。
第 3 段翻译
近年来,检索增强生成(RAG)被提出,通过查询外部源并将相关事实知识整合到生成的响应中,以缓解 LLM 缺乏领域特定知识的问题 [25, 44]。一些研究 [5, 17] 使用 RAG 捕捉文本语料中的文本内容和信息,为 LLM 补充领域特定知识。然而,这些基于 RAG 的方法通常依赖输入文本查询来检索文本信息,忽略了文本内容之间的结构化关系信息 [34]。为填补这一空白,图检索增强生成(GraphRAG)[8, 25] 被提出用于从图中获取关系信息。与传统 RAG 方法不同,GraphRAG 将图学习融入 RAG,能够从预构建的图数据库中检索与给定查询相关的、包含关系知识的图元素(如节点、三元组或子图)[44]。这种 GraphRAG 方法可以利用多种类型的图数据进行检索和生成,包括知识图谱 [65]。知识图谱(KGs)[16, 59] 富含与物品相关的实体关系三元组,提供了领域特定知识 —— 我们认为这些知识可以增强 top-k 推荐系统中的用户 / 物品表示。基于 GraphRAG 方法,我们提出一种新型推荐模型,名为面向有效推荐的知识增强型检索增强生成(KERAG_R)。具体而言,我们利用 GraphRAG 组件将 KG 中的外部知识整合到 LLM 提示词中,使所用 LLM(如 Llama 3.1)能够学习适配 top-k 推荐任务的领域特定知识,从而提升 LLM 捕捉上下文和推断用户偏好的能力。此外,为减少提示词中可能存在的冗余和噪声关系信息,我们在 GraphRAG 组件中融入了基于图注意力网络(GAT)的 KG 三元组选择方法。该选择方法筛选与用户交互最相关的知识图谱三元组,减少噪声和冗余信息,进而提升基于 LLM 的模型的推荐性能。另外,我们提出知识增强的指令微调方法,使 LLM 在微调阶段能够融入 KG 中物品关系的结构化知识。
第 3 段详细解释
这一段是 “介绍解决方案的技术背景”:RAG→GraphRAG→KERAG_R 的设计思路。
-
RAG 的作用与缺陷:
- RAG:从外部文本语料中找相关信息补充 LLM(比如用户问 “刘慈欣的小说”,RAG 从语料中找 “刘慈欣作品列表”);
- 缺陷:只找 “文本信息”,忽略 “结构化关系”(比如不知道 “刘慈欣 - 创作 -《三体》” 这种 KG 中的关系)。
-
GraphRAG 的改进:
- 核心:把 “图学习” 和 RAG 结合,能从 KG 中检索 “结构化关系”(比如节点 = 书籍 / 作者,边 = 创作 / 题材);
- 可检索元素:节点(如《三体》)、三元组(如(《三体》, 题材,科幻))、子图(如《三体》→刘慈欣→《流浪地球》)。
-
KERAG_R 的核心设计:
- 设计 1:用 GraphRAG 把 KG 知识塞进 LLM 提示词,让 LLM 学领域知识(比如书籍的作者、题材关系);
- 设计 2:用 GAT 选 “最相关” 的 KG 三元组(比如用户喜欢《三体》,只选 “《三体》- 题材 - 科幻”“《三体》- 作者 - 刘慈欣”,不选无关的 “《三体》- 出版时间 - 2008”);
- 设计 3:知识增强指令微调 —— 微调时就把 KG 的结构化知识加进去,让 LLM 更懂推荐。
第 4 段翻译
总之,我们工作的贡献总结如下:(1)我们提出的新型 KERAG_R 模型利用 GraphRAG 组件将 KG 中的外部知识整合到 LLM 提示词中,从而增强 LLM 在 top-k 推荐任务中的推理能力。为减少 KG 引入的冗余和噪声信息,我们使用 KG 三元组选择方法为目标用户筛选最相关的三元组。为提升 LLM 在推荐系统中的适应性,我们在 LLM 的微调阶段通过知识增强的指令微调方法融入关系型知识;(2)我们在三个公开数据集上进行了大量实验来评估所提出的 KERAG_R 模型。结果表明,KERAG_R 显著优于十种现有最先进的推荐方法,特别是在三个使用的公开数据集上都优于最强基线模型 RecRanker;(3)我们进行了消融实验(ablation study),验证了 KERAG_R 的 GraphRAG 组件和 KG 三元组选择方法的有效性;(4)此外,我们发现:为每个用户的每次交互检索最相关的三元组比使用额外的 KG 三元组效果更好;在提示词中,知识图谱的关系型三元组表示优于自然语句表示。
第 4 段详细解释
这是论文的 “核心贡献清单”,是作者的核心成果,必须吃透:
-
贡献 1(方法创新):设计了 KERAG_R,包含 3 个关键模块(GraphRAG 整合 KG、GAT 选相关三元组、知识增强指令微调);
-
贡献 2(实验优势):在 3 个数据集上打败 10 种 SOTA 方法,尤其是比 RecRanker 还强;
-
贡献 3(组件验证):消融实验 —— 验证每个模块都是 “有用的”(比如去掉 GraphRAG 后性能下降,说明 GraphRAG 必要);
-
贡献 4(关键发现):两个实用结论(① 选 “相关三元组” 比堆数量好;② 三元组格式比句子格式好),可指导后续研究。
-
术语注解:消融实验(Ablation Study)—— 通过 “移除 / 替换模型的某个组件”,观察性能变化,判断该组件的必要性(比如去掉 GAT,用随机选三元组,看性能是否下降)。
2 Related Work(相关工作)
2.1 LLM-based Recommendation(基于 LLM 的推荐系统)
翻译
近年来,大型语言模型(LLMs)展现出强大的推理能力,并已应用于各个领域,包括推荐系统 [13, 43, 52, 70, 71, 73, 74]。在推荐模型中,LLM 的应用通常采用零样本(zero-shot)或微调(fine-tuned)方法。零样本方法利用 LLM 的固有能力处理推荐任务,无需任何特定模型训练。这些方法通常使用从用户交互数据中衍生的提示词,引导 LLM 预测用户偏好。例如,Sileo 等人 [50] 从文本描述中提取用户 / 物品的辅助信息(如电影名称)来构建提示词,然后使用 GPT-2 [45] 为目标用户预测潜在物品。然而,由于 LLM 的通用能力与特定推荐任务的具体需求之间存在根本性错位,零样本方法可能面临挑战,通常需要额外的模型调整。另一方面,微调方法涉及将 LLM 明确适配到特定推荐任务,并且通常被证明比零样本方法更有效 [6, 30]。例如,Zhang 等人 [77] 设计了一种指令模板,用于在微调阶段为 LLM 组织任务输入 —— 通常包括任务定义、输入上下文和输出规范 —— 有效引导 LLM 执行特定推荐任务。RecRanker [39] 进一步增强了这种指令格式,通过融入自适应用户采样,在指令微调阶段生成更有效的提示词,特别是使 LLM 适配 top-k 排序任务(如列表式排序任务 [62])。然而,这些微调模型仍然主要依赖用户交互数据和 LLM 预训练语料的广泛知识库,可能缺乏准确推荐所需的领域特定信息。这种固有局限性也可能导致错误,例如众所周知的 “幻觉” 问题,即 LLM 为目标用户生成错误的推荐 [28]。为解决领域特定知识的缺失,我们提出一种知识增强的指令微调方法,在 LLM 的微调阶段融入关系型知识(即物品 - 实体三元组),从而为 LLM 提供额外知识以处理特定推荐任务。据我们所知,我们是第一个在指令微调中融入关系型知识,以构建有效的基于 LLM 的推荐模型的研究。
详细解释
这一部分的核心是 “梳理 LLM 推荐的两类方法,突出本文的创新点”:
-
零样本方法(Zero-shot):
- 定义:不用专门训练,直接用 LLM 的通用能力做推荐;
- 例子:Sileo 等人用 GPT-2,把电影名称当提示词,让模型推荐;
- 缺点:LLM 的通用能力和推荐任务 “不对齐”(比如 LLM 知道电影名称,但不知道用户喜欢的题材),容易出错。
-
微调方法(Fine-tuned):
- 定义:专门训练 LLM 适配推荐任务;
- 例子 1:Zhang 等人设计指令模板(比如 “任务:推荐电影;输入:用户喜欢的电影;输出:top5 电影”);
- 例子 2:RecRanker 用自适应用户采样 + 指令模板,适配 top-k 排序;
- 缺点:还是缺领域特定知识(比如不知道电影的导演、演员关联),导致幻觉。
-
本文创新点:
- 首次在 “指令微调” 中融入 “KG 的关系型三元组”(比如(电影 A, 导演,张艺谋)),让 LLM 在微调阶段就学到领域知识,解决幻觉问题。
2.2 Retrieval-Augmented Generation(检索增强生成)
翻译
近年来,检索增强生成(RAG)已展现出其从外部源捕捉大量文本的能力,将领域特定知识整合到大型语言模型生成的响应中,从而使 LLM 能够生成更连贯、上下文相关的响应 [9, 12, 26, 44]。事实上,RAG 旨在捕捉与给定文本查询上下文相关的文本内容和信息 [17, 25, 61]。例如,REALM [17] 采用 RAG 方法从外部源为每个输入查询检索相关文档,从而提升其在开放域问答(Open-QA)任务上的性能。然而,这些 RAG 方法主要依赖基于查询 - 文本匹配的文本内容检索,忽略了文本内容之间潜在的结构化和关系型信息。这种疏忽可能导致 LLM 生成不准确的响应 [34, 36]。为解决这一局限性,图检索增强生成(GraphRAG)[8, 25] 最近被提出,用于在 LLM 的提示词中捕捉文本内容之间的结构化关系信息。与传统 RAG 不同,GraphRAG 考虑文本内容中关键实体之间的相互联系,从而通过利用这些结构化关系提升生成响应的质量 [42, 44]。例如,GRetriever [22] 提出了第一个用于文本图的 RAG 方法,允许微调 LLM 以增强开放域问答任务中的图理解能力。因此,我们提出将 GraphRAG 方法与知识图谱结合,在 top-k 推荐场景中为 LLM 整合领域特定知识。据我们所知,我们是第一个将 GraphRAG 方法应用于基于 LLM 的 top-k 推荐任务的研究。此外,为减少所用 KG 可能引入的噪声和冗余信息,我们利用预训练的图注意力网络(GAT)模型执行 KG 三元组选择方法,从而为每个给定用户的交互物品获取最相关的三元组。
详细解释
这一部分的核心是 “梳理 RAG→GraphRAG 的发展,突出本文的另一个创新点”:
-
传统 RAG 的作用与缺陷:
- 作用:从外部文本中找相关信息补充 LLM(比如开放域问答 “刘慈欣的代表作”,RAG 检索刘慈欣的作品列表);
- 缺陷:只做 “文本匹配”,忽略 “结构化关系”(比如不知道 “刘慈欣 - 创作 -《三体》” 这种 KG 关系),导致 LLM 生成的信息不准确。
-
GraphRAG 的改进:
- 核心:考虑实体之间的 “结构化关系”(比如电影 - 导演 - 演员的关联);
- 例子:GRetriever 用 GraphRAG 增强 LLM 的图理解能力,让开放域问答更准确(比如问 “《活着》的导演还拍过什么”,能通过 KG 找到导演张艺谋,再找到他的其他作品)。
-
本文创新点:
- 首次将 GraphRAG 应用于 “LLM-based top-k 推荐”;
- 用 GAT 筛选 KG 三元组,解决 KG 引入的噪声 / 冗余问题(比如只选和用户相关的三元组)。
3 Methodology(方法论)
3.1 Preliminaries(预备知识)
翻译
推荐系统中的标准指令微调过程通常包括三个关键步骤:(i)指令提示词构建(instruction prompt construction);(ii)LLM 指令微调(instruction tuning the LLM);(iii)top-k 排序(top-k ranking)。
指令提示词构建(instruction prompt construction):top-k 推荐任务的指令提示词由用户 - 物品交互信息、目标用户的候选物品列表、任务描述和输出规范组成。
我们定义 U 和 I 分别表示用户集合和物品集合: 和
,其中 M 和 N 分别表示用户数和物品数。
我们还定义用户 - 物品交互矩阵为(
表示实数集)。
在基于 LLM 的方法中,我们还需要通过提示词将用户 u 的推荐任务转换为自然语言,以匹配所用 LLM 的输入要求。
具体而言,我们根据高评分和低评分,分别从用户的历史交互中获取每个采样用户的喜好和厌恶物品。为构建每个用户 的候选物品列表
,
我们遵循 RecRanker [39] 的训练和推理策略:训练阶段,我们将喜好物品、厌恶物品与通过负采样 [47,67] 生成的未交互物品结合;推理阶段,我们采用传统推荐模型 LightGCN [21] 检索候选集。
然后,我们将用户 - 物品交互信息以及对应的候选物品列表用自然语言表示,作为任务描述。最后,我们在指令提示词中用输出规范约束 LLM 的输出,确保为目标用户生成潜在的 top-k 物品。
LLM 指令微调(instruction tuning the LLM):构建指令提示词后,我们将作为输入查询执行指令微调,通过交叉熵损失 [80] 有效微调所用 LLM(如 Llama 3)以适应列表式排序任务。这种微调过程将模型参数从预训练状态 θ 更新到微调状态
,使 LLM 适配 top-k 推荐场景。
top-k 排序任务(top-k ranking):通过基于 LLM 的推荐模型 (如 Llama-3)估计用户偏好,为目标用户 u 推荐 top-k 物品。LLM 模型经过指令微调后,我们得到更新后的 LLM
—— 专门针对列表式排序任务训练,且已被证明比成对排序(pairwise)和点式排序(pointwise)方法更有效 [39]。然后,我们将提示词
输入该更新后的 LLM,基于候选物品列表
为每个用户
生成 top-k 物品列表
。
详细解释
这一部分是 “基础铺垫”,讲解 LLM 推荐中指令微调的标准流程,为后续 KERAG_R 的设计做准备:
-
核心符号定义(必须记牢,后续公式都用):
- U:用户集合(比如 U={用户 1, 用户 2, ..., 用户 M});
- I:物品集合(比如 I={书籍 1, 书籍 2, ..., 书籍 N});
- M:用户总数,N:物品总数;
- Y:用户 - 物品交互矩阵(M 行 N 列,Y [u][i] 表示用户 u 对物品 i 的评分,比如 1-5 分);
:给用户 u 的提示词;
- θ:LLM 预训练的参数,θ':微调后的参数;
- Su:用户 u 的候选物品列表,Su':为 u 推荐的 top-k 物品列表。
-
三个关键步骤详解:
-
步骤 1:构建提示词(Prompt)
- 内容:① 任务描述(比如 “推荐用户喜欢的电影”);② 用户交互(喜欢的电影 + 厌恶的电影);③ 候选物品列表(比如 10 个待选电影);④ 输出规范(比如 “输出 top5 电影”);
- 候选列表构建:
- 训练时:喜欢的(高评分)+ 厌恶的(低评分)+ 未交互的(负采样,比如用户没看过的电影,随机选一些当负例);
- 推理时:用 LightGCN(传统图推荐模型)选候选集(LightGCN 擅长捕捉用户 - 物品的协同信号,选出来的候选集更靠谱)。
-
步骤 2:LLM 指令微调
- 目标:让 LLM 学会 “根据提示词中的信息,给候选物品排序”;
- 损失函数:交叉熵损失(衡量模型预测的 top-k 列表和真实用户喜好的差距);
- 结果:LLM 参数从 θ 变成 θ' ,专门适配推荐任务。
-
步骤 3:top-k 推荐
- 排序方式:列表式排序(直接对整个候选列表排序),比 “成对排序”(两两物品比高低)和 “点式排序”(单个物品打分)效果好;
- 流程:输入Prompt _u → 微调后的 LLM → 输出S_u'(top-k 物品)。
-
-
术语注解:
- 负采样(Negative Sampling):从 “用户未交互的物品” 中选一些作为负例(比如用户没看过的电影,假设用户不喜欢),用于训练模型区分 “喜欢” 和 “不喜欢”;
- LightGCN:一种轻量级的图卷积推荐模型,核心是通过图卷积捕捉用户和物品之间的关联(比如用户 A 喜欢物品 X,用户 B 也喜欢 X,那么 A 和 B 是相似用户);
- 交叉熵损失(Cross-Entropy Loss):模型训练中常用的损失函数,值越小,模型预测越准。
3.2 Model Overview(模型概述)
翻译

图 1 展示了所提出的 KERAG_R 模型的架构,它包含三个主要组件:图检索增强生成(GraphRAG)、知识增强提示词构建(knowledge-enhanced prompt construction)和知识增强指令微调(knowledge-enhanced instruction tuning)。这些组件按顺序执行,分别对应图 1(a)、(b)、(c)。
图检索增强生成(GraphRAG):GraphRAG 组件(如图 1(a)所示)首先为每个物品检索 top-Q 个相关实体,以构建指令提示词(如图 1(b)所示)。具体而言,我们使用图注意力网络(GAT)预训练 KG 的物品 / 实体嵌入。利用这些物品 / 实体嵌入,我们计算点积相似度得分(dot product similarity scores)对候选实体排序,并为每个用户的交互物品选择最相关的三元组。
知识增强提示词构建:如图 1(b)所示,通过 GraphRAG 组件找到每个用户交互物品的最相关三元组后,我们将这些选中的三元组、用户的喜好 / 厌恶物品列表以及来自推荐模型(即 LightGCN)的初始排序列表整合到指令提示词中。
知识增强指令微调:然后,我们使用构建好的指令提示词(包含来自 GraphRAG 组件的物品 - 实体三元组作为关系型知识)微调所用 LLM,以适应 top-k 推荐任务(如图 1(c)所示)。具体而言,我们选择 Llama-3.1-8B-Instruct [7] 作为骨干模型,因为它在各类任务中表现有效 [11, 38]。微调阶段,我们采用参数高效调优方法 LoRA [23] 优化 Llama-3,以适应所提出的知识增强指令微调。经过选中的三元组微调后,我们得到一个指令微调后的 LLM,可为目标用户生成列表式物品推荐。
详细解释
这一部分是 KERAG_R 的 “整体框架介绍”,结合图 1(模型架构图)理解:
-
模型三大组件(顺序执行):
- 组件 1:GraphRAG(图 1(a))→ 核心任务:从 KG 中为每个物品选 “最相关的 top-Q 个三元组”;
- 工具:GAT(预训练 KG 的物品 / 实体嵌入);
- 方法:计算嵌入的点积相似度(相似度越高,三元组越相关);
- 组件 2:知识增强提示词构建(图 1(b))→ 核心任务:把 “相关三元组 + 用户交互 + LightGCN 初始排序” 塞进提示词;
- 组件 3:知识增强指令微调(图 1(c))→ 核心任务:用 LoRA 微调 Llama-3.1,让它结合 KG 知识做推荐;
- 组件 1:GraphRAG(图 1(a))→ 核心任务:从 KG 中为每个物品选 “最相关的 top-Q 个三元组”;
-
关键工具 / 模型注解:
- Llama-3.1-8B-Instruct:Meta 发布的开源 LLM,“8B” 表示 80 亿参数,“Instruct” 表示经过指令微调的版本(天生更懂任务指令);
- LoRA(Low-Rank Adaptation,低秩适应):参数高效调优方法 —— 不用微调 LLM 的所有参数(80 亿参数微调成本太高),只微调少量低秩矩阵参数(比如几十万参数),大幅降低计算成本;
- 点积相似度(Dot Product Similarity):计算两个向量相似度的方法,公式为 \(a·b = a_1b_1 + a_2b_2 + ... + a_nb_n\),值越大,向量越相似(比如物品嵌入和实体嵌入的点积越大,说明二者关联越紧密)。
-
图 1(模型架构图)详细解释:
- 图 1(a):GraphRAG 流程 → 输入 KG 三元组 → GAT 预训练生成嵌入 → 计算相似度 → 选 top-Q 三元组;
- 图 1(b):提示词构建 → 整合 “用户喜欢 / 厌恶物品”“LightGCN 初始排序”“top-Q 三元组” → 生成知识增强提示词;
- 图 1(c):指令微调 → 输入提示词 → LoRA 微调 Llama-3 → 输出 top-k 推荐列表;
- 核心逻辑:通过 GraphRAG 筛选 KG 知识,通过提示词注入知识,通过 LoRA 微调让 LLM 学会用知识做推荐。
3.3 GraphRAG for LLM-based Recommendation(面向 LLM 推荐的 GraphRAG)

如 2.2 节所述,我们旨在为每个物品检索最相关的 KG 三元组,并将其整合到 LLM 中,以缓解领域特定知识的缺失。为实现这一目标,我们首先使用 GAT 模型预训练物品 / 实体嵌入,用于后续检索。随后,我们通过 KG 三元组选择方法,比较更新后的物品和实体嵌入之间的点积相似度,为每个物品检索 top-Q 个相关三元组。
这里的 item 和 entity 是知识图谱(KG)里的两类元素:
- item:指作为 “主体” 的对象,比如具体的电影、商品(对应三元组里的头节点
h);- entity:指和 item 相关联的 “关联对象”,比如电影的导演、商品的品牌(对应三元组里的尾节点
t)三元组是
(《流浪地球2》, 导演, 郭帆)
- 这里 item 是 “《流浪地球 2》”(具体电影);
- entity 是 “郭帆”(和这个电影关联的导演实体)
先明确 GraphRAG 的核心目标
GraphRAG 的作用是:从知识图谱(KG)里,给每个电影(Item)选最相关的 KG 三元组,避免冗余 / 噪声,最后把这些三元组塞进 LLM 的提示词里,帮 LLM 更懂电影的关系知识(比如 “《流浪地球》的导演是郭帆”)。
步骤 1:知识图谱输入(图左侧的 “Knowledge graph”)
知识图谱里包含两类元素:
- Items(物品):这里是电影,比如《流浪地球》《满江红》《唐探 3》;
- Entities(实体):和电影相关的信息,比如 “郭帆(导演)”“科幻(题材)”“沈腾(主演)”“悬疑(题材)”;
- 这些元素通过 “关系” 连成三元组,比如:
- (《流浪地球》,导演,郭帆)
- (《流浪地球》,题材,科幻)
- (《满江红》,题材,悬疑)
- (《满江红》,主演,沈腾)
步骤 2:GAT 模块处理(图中间的 “GAT”)
GAT 的目标是:学习物品(电影)和实体(导演 / 题材)的高质量嵌入(向量),并计算 “实体对电影的重要性”(注意力权重)。
对应图里的模块 + 论文公式 1、2,拆解成 4 个小步骤(用《流浪地球》举例):
小步骤 2.1:嵌入初始化
给每个电影、实体分配初始的 “嵌入向量”(可以理解为用一串数字代表这个电影 / 实体):
- 《流浪地球》的初始嵌入:hi=[0.2,0.5,0.1](简化为 3 维向量);
- “郭帆(导演)” 的初始嵌入:ej=[0.6,0.3,0.8];
- “科幻(题材)” 的初始嵌入:ek=[0.4,0.7,0.2]。
小步骤 2.2:嵌入拼接 + 权重映射
把 “电影嵌入” 和 “实体嵌入” 拼接(图里的 “||”),再乘以可学习的权重矩阵 W(统一向量维度):
- 拼接《流浪地球》和郭帆的嵌入:[0.2,0.5,0.1]∣∣[0.6,0.3,0.8]=[0.2,0.5,0.1,0.6,0.3,0.8];
- 乘以权重矩阵 W 后,得到新向量:[0.3,0.6,0.4](W 是模型训练中学习的,这里简化)。
小步骤 2.3:计算注意力权重(对应公式 1)
用 “注意力向量 β”(模型学习的)和上一步的向量做内积,再通过LeakyReLU 激活,最后 softmax 得到 “实体对电影的重要性(α)”:
- 比如计算 “郭帆” 对《流浪地球》的注意力权重αi,j:经过计算后,郭帆(表示郭帆对《流浪地球》的重要性是 0.7);同理,“科幻” 对《流浪地球》的科幻。
小步骤 2.4:嵌入聚合(对应公式 2)
用注意力权重对 “实体嵌入” 加权求和,得到更新后的电影嵌入(让电影嵌入包含实体的信息):
- 《流浪地球》的更新嵌入郭帆郭帆科幻科幻;
- 代入数值:0.7×[0.6,0.3,0.8]+0.3×[0.4,0.7,0.2]=[0.54,0.38,0.62]。
步骤 3:KG 三元组选择(图右侧的 “KG triplet selection”)
目标是:计算 “电影 - 实体” 的相似度得分,选Top-Q 个最相关的三元组(对应公式 4、5)。
小步骤 3.1:计算相似度得分 S_ij(对应公式 4)
用 “更新后的电影嵌入” 和 “实体嵌入” 做点积,再乘以 “注意力权重 α”,得到最终得分:
- 《流浪地球》和郭帆的得分:郭帆郭帆;代入数值:0.7×([0.54,0.38,0.62]⋅[0.6,0.3,0.8])=0.7×0.92=0.644;
- 《流浪地球》和科幻的得分:S1,2=0.3×([0.54,0.38,0.62]⋅[0.4,0.7,0.2])=0.3×0.58=0.174;
- 假设《流浪地球》还有个实体 “2023 年上映”,得分S1,3=0.2×0.4=0.08。
小步骤 3.2:排序选 Top-Q 三元组(对应公式 5)
对得分排序,选 Top-Q(论文里 Q=1 最优):
- 《流浪地球》的得分排序:S1,1(0.644)>S1,2(0.174)>S1,3(0.08);
- 选 Top-1:保留三元组 (《流浪地球》,导演,郭帆),丢弃其他冗余三元组。
用一个完整的电影推荐例子串起来
假设用户喜欢《流浪地球》,GraphRAG 的流程是:
- 知识图谱输入:拿到《流浪地球》相关的三元组(导演郭帆、题材科幻、上映时间 2023);
- GAT 处理:计算出 “郭帆” 对《流浪地球》的重要性(α=0.7),更新电影嵌入;
- 三元组选择:算出 “郭帆” 的得分最高,选(《流浪地球》,导演,郭帆)这个三元组;
- 最终把这个三元组塞进 LLM 提示词:“用户喜欢《流浪地球》(导演是郭帆),请推荐类似的电影”。
3.3.1 GAT Pre-training for Triple Retrieval(用于三元组检索的 GAT 预训练)
翻译
如 3.2 节所述,我们旨在利用图注意力网络(GAT)[55] 为目标用户的交互物品检索 top-Q 个相关三元组。
首先,我们输入知识图谱中的三元组数据 ,其中 h、r、t 分别表示头实体(head item)、关系(relation)和尾实体(tail entity)。
我们将物品和实体映射到唯一索引,并使用 Xavier 初始化器(Xavier initialiser)初始化嵌入矩阵。随后,我们通过自注意力机制(self-attention mechanism)为每个物品 i 的邻居实体 j 自适应分配权重,执行图聚合操作(graph aggregation operation),公式如下:

其中,h_i 和 e_j 分别表示物品嵌入和实体嵌入;
W 是可学习权重矩阵;
表示物品节点 i 的邻居集合;
h_i' 是更新后的物品嵌入;
|| 表示向量拼接操作(vector concatenation);
是可学习注意力权重向量(用于计算注意力权重);
d 是嵌入维度。
通过这种图聚合操作,能够从相关邻居物品中获得更丰富、上下文感知的实体嵌入。此外,我们使用对比损失(contrastive loss)优化 GAT 预训练过程 [18]。
具体而言,我们将 KG 中存在的三元组选为正样本对(h_i, e_k),将 KG 中不存在的三元组选为负样本对(h_i, e_j),对比损失公式如下:

其中, 表示内积(inner product),用于计算正样本对和负样本对之间的相似度;E 是所有正样本的集合。通过这种方式,我们可以利用训练良好的 GAT 模型生成有效的物品 / 实体嵌入,用于后续的三元组选择。
详细解释
这一部分是 GraphRAG 的核心:用 GAT 预训练嵌入,为后续选三元组做准备。需要逐公式拆解:
-
GAT 的核心作用:
- GAT 是 “图注意力网络”,专门处理图结构数据(如 KG);
- 目标:学习物品和实体的 “高质量嵌入”(向量表示),让相似的物品 / 实体嵌入更接近(比如《三体》和《流浪地球》的嵌入相似度高)。
-
符号注解(公式 1-3):
:KG 的三元组(比如 h=《三体》,r = 题材,t = 科幻);
- 嵌入初始化:Xavier 初始化器 —— 让嵌入向量的均值和方差合理,避免训练时梯度消失 / 爆炸;
:物品 i 的邻居实体集合(比如物品《三体》的邻居实体是 “刘慈欣”“科幻”“2008 年出版”);
- LeakyReLU:激活函数(让模型能学习非线性关系);
- exp:指数函数;
- max (0, x):ReLU 函数(确保损失非负);
- N:正样本对的总数;
- E:正样本集合(KG 中存在的三元组)。
-
公式 1:计算注意力权重
- 作用:判断 “物品 i 的邻居实体 j” 对 i 的重要性(权重越大,越重要);
- 计算逻辑:
- 对物品嵌入
和实体嵌入
分别乘以可学习权重矩阵 W(统一维度);
- 拼接两个向量(|| 操作),得到 2d 维度的向量;
- 用注意力向量
做内积,再通过 LeakyReLU 激活;
- 对所有邻居实体的结果做 softmax(指数归一化),得到权重
(所有邻居权重和为 1);
- 对物品嵌入
- 例子:物品《三体》的邻居实体 “科幻”(重要)权重 0.8,“2008 年出版”(不重要)权重 0.05。
-
公式 2:更新物品嵌入
- 作用:将邻居实体的信息 “聚合” 到物品 i 的嵌入中,得到更丰富的嵌入;
- 计算逻辑:对每个邻居实体 j 的嵌入
- 例子:《三体》的更新嵌入 = 0.8ד科幻” 嵌入 + 0.05ד2008 年出版” 嵌入 + ...,突出重要邻居的贡献。
-
公式 3:对比损失
- 作用:优化 GAT 的训练,让 “真实存在的三元组(正样本)” 相似度高,“不存在的三元组(负样本)” 相似度低;
- 计算逻辑:
:正样本对的相似度(比如《三体》和 “科幻” 的内积);
:负样本对的相似度(比如《三体》和 “言情” 的内积);
- 损失 = 平均(max (0, 正样本相似度 - 负样本相似度));
- 训练目标:最小化损失 → 让正样本相似度 > 负样本相似度(比如《三体》和 “科幻” 的相似度远大于和 “言情” 的相似度)。
-
核心输出:训练好的 GAT 能生成 “有意义的物品 / 实体嵌入”—— 相关的物品和实体嵌入相似度高,为后续选三元组打下基础。
3.3.2 Knowledge Graph Triple Selection(知识图谱三元组选择)
翻译
下一步是从知识图谱(KG)中选择与物品最相关的三元组。这种选择基于物品和实体的嵌入,以及从 GAT 中得到的注意力权重。具体而言,我们计算物品和实体嵌入之间的点积相似度,然后通过应用注意力权重进行优化,公式如下:

基于计算出的相似度得分,我们为每个物品选择 top-Q 个实体,得到最终的三元组集合:

其中, 表示与每个物品相关的 Q 个得分最高的实体。通过这种方式,我们通过相似度计算检索每个物品的 top-Q 个相关三元组,从而减轻 KG 中的噪声和冗余信息。
详细解释
这一部分是 “筛选三元组”,解决 KG 的噪声和冗余问题:
-
公式 4:计算最终相似度得分
- 作用:综合 “注意力权重” 和 “嵌入点积相似度”,判断三元组的相关性;
- 组成:
:更新后的物品嵌入和实体嵌入的点积相似度(物品和实体的关联紧密程度);
- 逻辑:重要性越高(
越高,三元组越相关。
-
公式 5:选择 top-Q 三元组
- 作用:只保留得分最高的 Q 个三元组,丢弃低得分的噪声 / 冗余三元组;
- 例子:物品《三体》的 Q=1,得分最高的三元组是(《三体》, 题材,科幻),就只选这个,不选其他无关三元组;
- 关键:Q 是超参数(后续实验会验证 Q=1 时效果最好)。
-
核心效果:通过 “GAT 预训练嵌入→计算综合得分→选 top-Q”,从 KG 中筛选出 “最相关” 的三元组,避免把无关信息塞进 LLM 提示词。
3.4 Knowledge-Enhanced Prompt Construction(知识增强提示词构建)
3.4.1 User Sampling and Candidate Items Selection(用户采样与候选物品选择)
翻译
如引言部分所述,LLM 的输入 token 长度限制导致无法直接输入大量用户交互和完整的候选物品集。因此,我们的目标是通过选择性用户采样获得有代表性的用户,并简化候选物品集,以满足 LLM 的输入约束。
我们遵循 [39] 中的方法执行用户采样和候选物品选择。具体而言,用户采样阶段:首先,我们优先从交互次数多的用户中采样(这些用户提供更可靠、一致的数据);其次,我们使用 K-Means [20] 聚类算法对用户嵌入进行聚类,并从每个聚类中按比例采样,从而避免某些用户群体过度集中,从不同聚类中获得有代表性的用户;最后,我们对通过聚类采样选择的用户执行概率衰减 [40],以降低其重复采样率。
详细解释
这一部分是 “准备提示词的输入素材”,解决 LLM 输入长度限制:
-
用户采样策略(选有代表性的用户):
- 策略 1:优先选 “交互多的用户”(比如用户看了 100 部电影,比只看 2 部的用户更能反映偏好);
- 策略 2:K-Means 聚类采样(把用户按偏好分成几类,比如科幻爱好者、言情爱好者,每类选一些用户);
- 策略 3:概率衰减(避免同一用户被反复采样,保证采样的多样性);
- 目标:用少量有代表性的用户构建提示词,既满足 LLM 输入长度,又能覆盖不同用户偏好。
-
候选物品选择:和 3.1 节一致(训练时:喜欢 + 厌恶 + 负采样;推理时:LightGCN 检索),确保候选集的质量。
3.4.2 Instruction Prompt Construction(指令提示词构建)
翻译
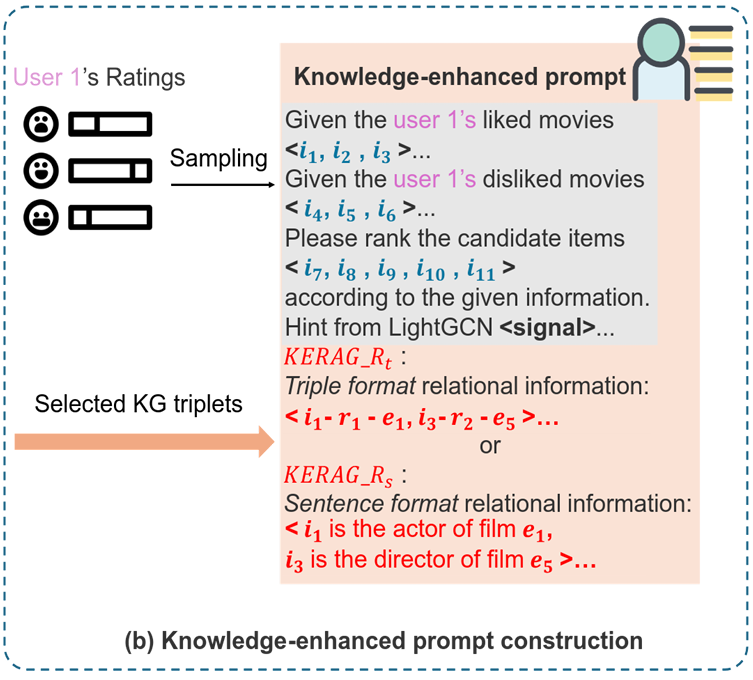
获得采样用户后,我们可以将其与之前从 GraphRAG 组件检索到的 top-Q KG 三元组集合结合,构建提示词。表 1 展示了我们设计的列表式提示词示例以及两个变体(KERAG_Rt) 和 KERAG_Rs)。
一般而言,我们构建的知识增强提示词包含以下部分:top-k 任务描述、用户的历史交互、任务目标、来自另一个推荐模型的排序结果,以及 KG 信息。
具体而言,如图 1(a)所示,我们从 GraphRAG 中为用户的交互物品和候选物品检索得分较高的 top-Q 三元组,并将这些三元组整合到提示词中。
此外,为了将传统推荐模型的协同信号整合到 LLM 中以实现 top-k 推荐,我们使用 LightGCN [21](它能有效捕捉协同信号并保持计算效率)预测用户偏好,然后将这些预测转换为自然语言描述,并作为提示(hint)整合到提示词中。
如图 1(b)所示,为了确定在指令提示词中整合 KG 三元组的最佳表示格式,我们设计了两种包含物品和实体之间关系知识的知识增强提示词:
第一种提示词以三元组格式将知识增强 GraphRAG 获得的 KG 信息整合到提示词中,表示为 “物品文本 - 关系文本 - 实体文本”(例如,Cameron - director_film - The Terminator);
第二种变体提示词以自然语言句子格式整合 KG 信息(例如,Cameron is the director of The Terminator)。通过这种方式,我们构建包含关系信息的知识增强提示词,并将其用于后续的指令微调(见图 1(c))。
翻译(表 1:排序任务的指令示例)
| 变体(Variant) | 指令(Instruction) |
|---|---|
| Original(原始) | 用户的历史交互包括:<历史交互>。 用户会如何对 < 候选物品列表 > 排序? |
| KERAG_R t(三元组格式) | 你是一个电影推荐系统。 你的任务是根据用户偏好对给定的候选电影列表排序,并返回 top5 推荐。 用户喜欢的电影:<喜欢的历史交互>。 用户不喜欢的电影:<不喜欢的历史交互>。 问题:用户会如何对候选物品列表排序:<候选物品列表>? 提示 1:另一个推荐模型的建议:<排序列表>。 提示 2:上述模型推荐的对应实体和关系(补充上下文信息):<KG 三元组格式信息>。 |
| KERAG_R s(句子格式) | 你是一个电影推荐系统。 你的任务是根据用户偏好对给定的候选电影列表排序,并返回 top5 推荐。 用户喜欢的电影:<喜欢的历史交互>。 用户不喜欢的电影:<不喜欢的历史交互>。 问题:用户会如何对候选物品列表排序:<候选物品列表>? 提示 1:另一个推荐模型的建议:<排序列表>。 提示 2:上述模型推荐的对应实体和关系(补充上下文信息):<KG 句子格式信息>。 |
详细解释
这一部分是 “构建最终提示词”,核心是 “整合 KG 知识” 和 “选择合适的 KG 表示格式”,结合表 1 理解:
-
提示词的组成部分(所有变体都包含):
- 角色定义:“你是一个电影推荐系统”(明确 LLM 的身份);
- 任务描述:“根据用户偏好排序,返回 top5”(明确任务);
- 用户交互:喜欢的电影 + 不喜欢的电影(用户偏好信息);
- 候选列表:待排序的候选电影;
- 提示 1:LightGCN 的排序结果(传统推荐模型的协同信号,辅助 LLM);
- 提示 2:KG 信息(核心差异点,分两种格式)。
-
三个提示词变体对比(表 1 核心):
- Original(原始):无 KG 信息,无 LightGCN 提示,是基础版本;
- KERAG_Rt(三元组格式):提示 2 是 “物品 - 关系 - 实体” 三元组(如 “Cameron - director_film - The Terminator”);
- KERAG_Rs(句子格式):提示 2 是自然语句(如 “Cameron is the director of The Terminator”);
- 后续实验证明:KERAG_Rt 效果更好(三元组格式更简洁,无冗余文本,LLM 更容易提取关系知识)。
-
核心设计:通过 “角色 + 任务 + 用户交互 + 传统模型提示 + KG 知识”,构建 “知识增强提示词”,让 LLM 在排序时能用到 KG 的关系知识。
3.5 Knowledge-Enhanced Instruction Tuning(知识增强指令微调)

翻译
如 2.1 节所述,指令微调使 LLM 能够更好地捕捉和遵循特定任务指令,提升其在各种下游应用中的适应性和性能 [53, 78]。在本文中,我们采用轻量级调优方法 ——LoRA [23]—— 在保持有效性的同时,仅用三个参数高效调优大型语言模型(LLMs)。这种轻量级调优方法的核心前提是:当前 LLMs 的参数数量过多,信息集中在较低的内在维度 [3, 82]。为了高效适配 Llama-3.1-8B-Instruct [7],我们应用 LoRA 引入低秩矩阵约束权重更新,在显著降低计算开销的同时保持模型的有效性。
一般而言,我们的目标是通过指令微调微调 Llama-3.1-8B-Instruct [7],最小化交叉熵损失:

其中,Θ 表示 LLM 的参数;
D_train是训练数据;|y| 是目标序列 y 的长度;
P_Θ 表示给定输入 x 和前一个 token y_[1: t-1] 时,生成目标输出 y 中第 t 个 token y_t}的概率。
我们通过最小化这个损失函数微调 LLM 参数 Θ,使 LLM 能够捕捉自然语言中表达的用户偏好和结构化关系知识。这种训练有效使 LLM 适配推荐系统任务。通过这一过程获得的指令微调 LLM 能够将领域特定知识整合到推荐任务中,生成更具上下文感知、更符合用户偏好的推荐,从而提升推荐性能。
详细解释
这一部分是 “微调 LLM”,核心是用 LoRA 实现高效调优,让 LLM 学会用 KG 知识做推荐:
-
LoRA 的核心原理:
- 问题:LLM 参数太多(Llama-3.1-8B 有 80 亿参数),全量微调成本极高(需要多块 GPU,训练时间长);
- 解决方案:LLM 的参数信息集中在 “低内在维度”(比如 80 亿参数的信息可以用 100 维的矩阵表示),LoRA 只微调低秩矩阵(比如秩 r=16),参数数量大幅减少(从 80 亿→几十万);
- 效果:计算开销低,训练快,且性能接近全量微调。
-
公式 6:交叉熵损失函数
- 作用:衡量 LLM 生成的推荐列表(目标序列 y)和真实用户偏好(训练数据\(D_{train }\))的差距,目标是最小化损失;
- 符号注解:
- x:输入的知识增强提示词;
- y:目标输出(真实的 top-k 推荐列表,比如 “《流浪地球》《球状闪电》《三体》”);
:目标序列的第 t 个 token(比如 “《流浪地球》” 是第 1 个 token,“《球状闪电》” 是第 2 个 token);
:LLM 在输入 x 和前 t-1 个 token 的条件下,生成第 t 个 token 的概率;
:对数概率(概率越大,log 值越大,-log 值越小);
- 逻辑:LLM 生成的推荐列表越接近真实列表,每个 token 的概率越大,损失越小,模型越优。
-
微调的核心目标:让 LLM 学会 “结合提示词中的 KG 知识(如三元组)、用户交互、LightGCN 排序,生成符合用户偏好的 top-k 推荐列表”。
3.6 Efficiency Analysis(效率分析)
翻译
我们通过报告核心组件(GraphRAG 和知识增强指令微调)的训练时间、推理时间和模型大小,分析 KERAG_R 模型的效率。对于知识增强指令微调,我们在单个 A6000 GPU 上用 1000 个指令训练 Llama-3.1(8B),耗时约 74 小时,每个指令的平均推理时间约为 6.2 秒。相比之下,在相同硬件上,RecRanker 训练 1000 个指令耗时约 68 小时,每个指令的推理时间约为 4.2 秒。这表明我们的模型保持了相当的计算开销。
我们的骨干 LLM(Llama-3.1)包含 80 亿参数,而 GraphRAG 中使用的额外 GAT 模型仅引入 0.68 百万可训练参数,相比之下,其对总模型大小的贡献微乎其微。因此,总体计算成本仍然由 LLM 主导。总之,KERAG_R 保持了与 RecRanker 相当的训练和推理效率,同时融入了一个轻量级的基于 GAT 的检索模块,该模块仅需要少量额外参数。
详细解释
这一部分是 “验证模型效率”,证明 KERAG_R 在性能提升的同时,没有显著增加计算成本:
-
硬件环境:单个 A6000 GPU(专业计算 GPU,显存 48GB,常用于 LLM 训练);
-
训练效率对比:
- KERAG_R:1000 个指令→74 小时;RecRanker:1000 个指令→68 小时;
- 结论:KERAG_R 训练时间略长,但差距不大(多了 GAT 的预训练),在可接受范围内。
-
推理效率对比:
- KERAG_R:每个指令 6.2 秒;RecRanker:每个指令 4.2 秒;
- 结论:推理时间略长(提示词中多了 KG 三元组,LLM 处理时间增加),但仍在实用范围内。
-
模型大小对比:
- KERAG_R:80 亿(Llama-3.1)+ 0.68 百万(GAT)≈80.0068 亿参数;
- RecRanker:仅 80 亿参数;
- 结论:GAT 的参数占比极小(0.68 百万 / 80 亿≈0.00085%),几乎不增加模型存储成本。
-
核心结论:KERAG_R 在 “性能大幅提升” 的同时,保持了与现有模型(RecRanker)相当的效率,不会因为加入 GraphRAG 而变得难以部署。
4 Experiments(实验)
4.1 Experimental Settings(实验设置)
4.1.1 Datasets(数据集)
翻译
遵循 [3, 39],我们在三个公开且广泛使用的数据集上评估 KERAG_R 模型:MovieLens-1M(ML-1M)、MovieLens-10m(ML-10M)和 Amazon-book 。
MovieLens 数据集是电影推荐的标准基准,包含用户对电影的评分。我们使用 MovieLens 的两个数据集 [19]:MovieLens-1M(ML-1M)包含约 100 万条用户对电影的评分;ML-10M(ML-10M)扩展到超过 1000 万条评分。Amazon-book 数据集包含 1-5 分的用户评分,常用于书籍推荐任务。
对于这三个数据集,我们遵循 [39] 的设置,移除历史交互信息中交互次数少于 10 的用户和物品,以提高数据集质量。这些数据集的统计信息(也广泛用于基于 KG 的推荐)如表 2 所示。对于这三个数据集,我们通过标题匹配将所有物品映射到 Freebase 实体 [4, 81],以获得相应的知识图谱。
翻译(表 2:所用数据集的统计信息)
| 统计指标 | ML-1M | ML-10M | Amazon-book |
|---|---|---|---|
| 用户数(Users) | 6,040 | 71,567 | 28,104 |
| 物品数(Items) | 3,952 | 10,681 | 24,903 |
| 交互数(Interactions) | 1,000,209 | 10,000,054 | 582,321 |
| 交互密度(Interaction density, %) | 0.0419 | 0.0131 | 0.0008 |
| 实体数(Entities) | 31,380 | 32,754 | 23,780 |
| 关系数(Relations) | 31 | 31 | 10 |
| 三元组数(Triples) | 70,444 | 133,245 | 102,149 |
详细解释
这一部分是 “实验数据准备”,表 2 是核心,必须理解每个指标的含义:
-
数据集介绍:
- ML-1M/ML-10M:电影推荐数据集,用户对电影评分(1-5 分),ML-10M 比 ML-1M 大 10 倍;
- Amazon-book:书籍推荐数据集,用户对书籍评分(1-5 分);
- 数据预处理:移除 “交互次数 < 10” 的用户和物品(比如只看了 2 部电影的用户,偏好不明确,移除后数据质量更高)。
-
表 2 指标解释:
- 交互密度(Interaction density):实际交互数 /(用户数 × 物品数)×100%,反映数据的稀疏程度(数值越小越稀疏);
- 例子:ML-1M 的交互密度 = 0.0419%,说明用户和物品的交互非常稀疏(大多数用户没看过大多数电影)—— 推荐系统的核心挑战就是 “稀疏性”;
- 实体数(Entities):KG 中的实体总数(比如电影、导演、演员、书籍、作者等);
- 关系数(Relations):KG 中的关系类型总数(比如 “电影 - 导演 - 导演名”“书籍 - 作者 - 作者名” 等);
- 三元组数(Triples):KG中的三元组数量
- 交互密度(Interaction density):实际交互数 /(用户数 × 物品数)×100%,反映数据的稀疏程度(数值越小越稀疏);
4.1.2 Data Preprocessing(数据预处理)
翻译
我们采用留一法(leave-one-out strategy)[24, 39] 评估所有模型,数据集划分方式与先前研究一致。该策略通常基于时间戳划分数据集:对于每个用户,最近的一次交互作为测试样本(test instance),倒数第二次交互作为验证样本(validation instance),所有更早的交互构成训练集(training set)。
在本研究中,遵循 RecRanker [39] 的方法,从每个数据集中采样 1000 条用户交互作为指令,用于微调 LLM。在指令微调过程中,我们同样遵循 [39] 构建候选列表:随机选择 3 个最高评分物品、2 个第二高评分物品和 5 个未评分物品,然后将前 5 个最高评分物品选为真实标签(ground truth)。我们使用的预处理脚本已上传至摘要中链接的匿名代码仓库。
详细解释
这一部分是 “数据集划分与训练数据准备”,核心是让实验设置符合行业标准,确保结果可信:
-
留一法划分数据集:
- 目的:模拟真实推荐场景(预测用户 “下一次” 会喜欢什么),避免数据泄露(比如用未来的交互预测过去的偏好);
- 具体划分:
- 测试集:用户最近一次交互(比如用户昨天看的电影,预测用户是否喜欢);
- 验证集:用户倒数第二次交互(用于调整模型超参数,比如学习率、LoRA 的秩 r);
- 训练集:用户更早的所有交互(用于模型训练)。
-
训练数据构建:
- 指令采样:每个数据集选 1000 条用户交互(避免训练数据过多导致计算成本过高,同时保证覆盖足够的用户偏好);
- 候选列表构建:3 个高评分(用户喜欢)+2 个中高评分(用户较喜欢)+5 个未评分(用户可能不喜欢)→ 共 10 个候选物品;
- 真实标签(ground truth):前 5 个最高评分物品(模型的目标是从 10 个候选中选出这 5 个,排序越准性能越好)。
-
术语注解:
- 数据泄露(Data Leakage):训练过程中使用了测试集的信息,导致模型性能虚高(比如用用户最近的交互训练,再预测该交互,结果肯定好,但无实际意义);
- 真实标签(Ground Truth):模型需要预测的 “正确答案”(比如用户真正喜欢的 5 个物品)。
4.1.3 Evaluation Protocol and Implementation Details(评估协议与实现细节)
翻译
遵循先前研究 [3, 39],我们使用两个代表性指标 —— 命中率(Hit Ratio, HR)和归一化折损累积增益(Normalized Discounted Cumulative Gain, NDCG)—— 评估 KERAG_R 模型相对于基线的有效性。由于 LLM 的输入 token 长度限制,现有基于 LLM 的模型 [39, 77] 通常将 top-k 评估指标中的 k 设置为 3 和 5,我们的实验采用相同设置。
我们选择 Llama-3.1-8B-Instruct [7] 作为实验模型,因为它在开源模型中表现优异。事实上,我们也测试了多个开源 LLM(如 Llama-2(7B)和 Llama-2(13B)[54]),但 Llama-3.1-8B-Instruct 的性能始终最优。
对于 GAT 预训练,我们设置输入嵌入维度为 16,批次大小(batch size)和块大小(chunk size)分别为 10 和 50。在 Llama-3.1(8B)的训练阶段,我们统一采用 2e-5 的学习率(learning rate)和 2048 的上下文长度(context length),按轮次(epochs)训练,并采用余弦调度器(cosine scheduler),包含 50 步的预热阶段(warm-up phase)。我们使用 LoRA [23] 高效训练这些模型,LoRA 的秩(rank size r)和缩放因子(scaling factor alpha)在 {8, 16, 32, 64} 中取值。
在推理阶段,我们遵循 [39] 使用 vLLM [33] 框架,设置温度参数(temperature)为 0.1,top-k 采样为 40,核采样(nucleus sampling)为 0.1。我们使用 Adam 优化器 [31] 优化 KERAG_R 模型和基线,嵌入初始化采用 Xavier 初始化 [15]。
详细解释
这一部分是 “实验的具体执行细节”,确保实验可复现,结果可信,核心拆解如下:
-
评估指标(HR 和 NDCG):推荐系统的核心指标,必须理解其含义:
- 命中率(HR@k):测试集中的真实物品(用户最近交互的物品)是否出现在模型推荐的 top-k 列表中,取值范围 [0,1],越接近 1 越好;
- 例子:用户最近看了《流浪地球》,模型推荐的 top-5 列表中包含《流浪地球》,则 HR@5=1,否则 = 0;
- 归一化折损累积增益(NDCG@k):不仅关注 “是否命中”,还关注 “命中的位置”—— 命中位置越靠前(比如第 1 名),得分越高,取值范围 [0,1],越接近 1 越好;
- 例子:同样命中《流浪地球》,排在第 1 名的 NDCG 得分高于排在第 5 名的得分。
- 命中率(HR@k):测试集中的真实物品(用户最近交互的物品)是否出现在模型推荐的 top-k 列表中,取值范围 [0,1],越接近 1 越好;
-
模型选择理由:
- 选 Llama-3.1-8B-Instruct:开源、性能强(比 Llama-2 更优)、支持指令微调(Instruct 版本天生适配任务指令);
- 不选闭源模型(如 GPT-4):无法进行全量微调,不符合实验中 “知识增强指令微调” 的需求。
-
超参数设置(必须明确,否则实验不可复现):
- GAT 预训练:嵌入维度 16(平衡性能和计算成本)、batch size=10(避免 GPU 显存溢出);
- LLM 训练:学习率 2e-5(LLM 微调的常用学习率,过大导致过拟合,过小导致训练缓慢)、上下文长度 2048(Llama-3.1-8B 的默认输入长度,适配提示词长度);
- 余弦调度器:学习率先随轮次增加(预热 50 步,避免初始学习率过高破坏预训练参数),再随轮次衰减(后期稳定收敛);
- LoRA 参数:秩 r∈{8,16,32,64}(低秩矩阵的维度,r 越小计算成本越低,r 越大适配能力越强,实验中会选择最优 r)、缩放因子 alpha(控制 LoRA 权重的贡献度);
- 推理参数:temperature=0.1(越低生成越确定,避免推荐结果随机波动)、vLLM 框架(高效推理 LLM 的框架,解决推理速度慢的问题)。
-
优化器与初始化:
- Adam 优化器:LLM 微调的常用优化器,收敛快、稳定性好;
- Xavier 初始化:让嵌入向量的均值和方差均匀,避免训练时梯度消失或爆炸。
4.1.4 Baselines(基线模型)
翻译
我们将 KERAG_R 模型与四类现有基线模型对比:(1)协同过滤推荐模型(Collaborative Filtering):
- MF [32]:首个将用户 - 物品交互矩阵分解为两个低维矩阵的模型,用于捕捉驱动用户偏好和物品特征的隐藏特征;
- LightGCN [21]:通过移除非线性激活和转换矩阵,简化用户与物品之间信息传播的卷积操作,提升效果;
- MixGCF [27]:通过聚合原始负样本邻域中不同层的嵌入生成合成负样本,从隐式反馈中有效提取负信号。
(2)序列推荐模型(Sequential Recommendation):
- SASRec [29]:利用掩码多头注意力机制(masked multi-head attention)建模用户的序列交互;
- BERT4Rec [51]:首个使用深度双向自注意力(deep bidirectional self-attention)捕捉用户交互的序列信息;
- CL4SRec [63]:从原始用户行为序列中获取自监督信号,与 SASRec 和 BERT4Rec 不同,它使用三种数据增强方法增强用户表示。
(3)知识图谱推荐模型(Knowledge Graph Recommendation):
- CKE [76]:采用异质网络嵌入方法,通过考虑节点和关系的异质性提取物品的结构表示,从而改进用户偏好学习;
- KGAT [58]:与 CKE 的区别在于通过注意力机制强调知识图谱中相邻节点的重要性,并通过聚合物品相邻节点的信息丰富物品表示学习。
(4)基于 LLM 的推荐模型(LLM-based Recommendation):
- P5 [13]:基于 T5 [46] 的编码器 - 解码器生成模型,将多种推荐任务统一到单一 LLM 框架中;我们采用 P5 的开源实现 OpenP5 [64],并使用为 top-k 推荐任务设计的变体作为基线;
- RecRanker [39]:通过自适应用户采样构建提示词,并利用指令微调后的 LLM 执行推荐,结合了 top-k 推荐中的三种排序任务。
我们未与其他基于 LLM 的推荐模型(如 TALLRec [3]、InstructRec [77]、LLMRec [60])对比,原因如下:任务设置差异显著、模型不可用或缺乏开源实现。具体而言,TALLRec 使用 Llama-7B 作为骨干模型,在序列推荐场景中建模用户交互序列,与我们的 top-k 推荐任务不同;InstructRec 依赖闭源 GPT 模型,不支持指令微调,与我们需要全量适配模型的实验设置不兼容;LLMRec 缺乏公开的实现细节和关键预处理脚本,无法完全复现其流程。
详细解释
这一部分的核心是 “说明对比的基线模型为什么合理”,让用户明白 KERAG_R 的性能提升是 “真优势”,而非 “对比的基线太弱”:
-
四类基线的选择逻辑:
- 协同过滤:推荐系统的经典方法(MF 是基础,LightGCN 是当前主流图协同过滤模型);
- 序列推荐:针对 “用户交互顺序” 的推荐方法(SASRec、BERT4Rec 是序列推荐的标杆模型);
- 知识图谱推荐:同样使用 KG 的推荐方法(CKE、KGAT 是 KG 推荐的经典模型,对比可验证 GraphRAG 的优势);
- LLM-based 推荐:当前最先进的推荐方法(P5 是统一框架,RecRanker 是 top-k 推荐的 SOTA 模型,是核心对比对象)。
-
每类基线的核心特点(帮用户区分差异):
- MF:矩阵分解,无 KG、无序列信息;
- LightGCN:图卷积,无 KG、无序列信息;
- SASRec:单方向序列(只看过去交互);
- BERT4Rec:双向序列(看过去和未来交互);
- CKE/KGAT:用 KG,但不用 LLM;
- P5/RecRanker:用 LLM,但 P5 无 KG,RecRanker 无 GraphRAG 和知识增强指令微调。
-
不选其他模型的原因:
- 任务不同:TALLRec 是 “序列推荐”(预测下一个物品),KERAG_R 是 “top-k 推荐”(从候选集中选前 k 个);
- 闭源不可用:InstructRec 用 GPT(闭源),无法进行指令微调;
- 无法复现:LLMRec 没有开源代码,无法对比。
4.2 Performance Comparison (RQ1)(性能对比)

翻译
表 3 报告了 KERAG_R 的两个变体 KERAG_Rt 和 KERAG_Rs 与 4.1.4 节所有基线的对比结果。我们将这两个变体与四类推荐方法对比:协同过滤模型、序列模型、KG 模型和基于 LLM 的模型。需注意: KERAG_Rt 以三元组格式将关系信息整合到提示词中,而 KERAG_Rs 以句子格式整合。
表 3 中,最优性能用粗体标注,次优性能用下划线标注;上标∗表示通过 Holm-Bonferroni 校正的配对 t 检验(p 值 < 0.05),该结果与 KERAG_Rt 存在显著差异。
从表 3 结果中,我们观察到以下结论:
(1)在所有三个数据集上, KERAG_Rt 和 KERAG_Rs 均显著优于所有基线模型(∗标记证明统计显著)。性能提升归因于 GraphRAG 组件和知识增强指令微调方法 —— 将 KG 中的领域特定知识整合到 LLM 提示词中,提升了 LLM 对用户偏好的估计能力。
(2)KERAG_R 的两个变体均大幅优于最强的基于 LLM 的基线 RecRanker。例如,在 Amazon-Book 数据集上,KERAG_Rt 的 HR@5 比 RecRanker 提升 14.89%,证明在指令微调阶段融入关系型知识(物品 - 实体三元组)能有效改进基于 LLM 的推荐。
(3)对比 KERAG_Rt 和 KERAG_Rs,KERAG_Rt 在所有指标上均更优。这表明三元组格式的关系信息比自然语句格式更有效 —— 三元组简洁,无冗余信息,能为用户交互物品提供更丰富的上下文,帮助 LLM 更准确地估计用户偏好。近期研究 [10] 在问答任务中也发现类似结论:KG 三元组比句子提供更准确的关系知识。
(4)表 3 还显示,KG 模型(CKE、KGAT)和基于 LLM 的模型(RecRanker)总体优于协同过滤模型和序列模型。这表明引入额外知识(如 KG)能丰富用户 / 物品表示,对 top-k 推荐有益。
针对 RQ1,我们得出结论:KERAG_R 的两个变体均成功利用 GraphRAG 和知识增强指令微调提升了推荐性能,显著优于所有现有强基线。
详细解释:
表 3 是论文的核心实验结果,必须逐行逐列解读,确保用户理解每个数值的意义和性能差异:
-
表 3 结构说明:
- 行:10 个基线模型 + KERAG_R 两个变体 + 提升率(KERAG_ \(R_{t}\) 相对于 RecRanker 的提升);
- 列:三个数据集(ML-1M、ML-10M、Amazon-Book)× 四个指标(HR@3、NDCG@3、HR@5、NDCG@5);
- 标记:粗体 = 最优,下划线 = 次优,∗= 与 KERAG_ \(R_{t}\) 有显著差异(p<0.05,说明性能提升不是偶然)。
-
关键结果解读:
- 所有基线模型都带∗:说明 KERAG_ \(R_{t}\) 的性能提升是 “统计显著” 的,不是随机波动;
- KERAG_ \(R_{t}\) 全列粗体:在所有数据集、所有指标上都是最优;
- KERAG_ \(R_{t}\) > KERAG_ \(R_{s}\):三元组格式(t)比句子格式(s)好,验证了 “简洁无冗余” 的优势;
- 提升率峰值:Amazon-Book 数据集的 HR@5 提升 14.89%,这是最显著的提升 —— 因为 Amazon-Book 的交互密度最低(0.0008%,表 2),用户偏好更难捕捉,而 KG 知识的补充效果更明显;
- 基线性能排序:LLM-based(RecRanker)> KG 模型(CKE/KGAT)> 协同过滤(LightGCN)> 序列模型(SASRec/BERT4Rec),证明 “LLM+KG” 是当前推荐的最优组合方向。
-
数值含义举例(以 Amazon-Book 的 HR@5 为例):
- RecRanker 的 HR@5=0.0188:100 个测试样本中,有 1.88 个样本的真实物品出现在 top-5 推荐中;
- KERAG_ \(R_{t}\) 的 HR@5=0.0216:100 个测试样本中,有 2.16 个样本命中,提升了(0.0216-0.0188)/0.0188≈14.89%;
- 数值看似小:因为推荐系统的数据集极其稀疏(Amazon-Book 交互密度 0.0008%),能提升 0.28 个百分点已非常显著。
4.3 Ablation Study (RQ2)(消融实验)
翻译
在本节中,我们通过引入四个变体,消融 KERAG_R 模型的每个关键组件,以验证其有效性:(i)w/o-GraphRAG:移除 GraphRAG 组件;
(ii)w/o-instruction:移除知识增强指令微调组件;
(iii)w/o-selection:用 KG 中随机选择的三元组替换知识增强三元组选择方法;
(iv)w/o-Llama3:用 Llama-2(7B)替换所用 LLM(Llama-3.1-8B-Instruct)。
我们将这些变体与 KERAG_Rt 对比(因其性能更优);
KERAG_Rs 得出相同结论。
消融实验结果

核心分析
(1)GraphRAG 的影响:移除 GraphRAG 后 (w/o-GraphRAG),所有数据集的性能均下降。这表明在提示词中融入领域特定知识,能有效引导 LLM 估计用户潜在交互。
(2)三元组选择方法的影响:用随机选择替换 top-Q 选择(w/o-selection),KERAG_R 在所有数据集上均显著优于该变体。这证明为目标用户的交互物品选择最相关的三元组,能提升 LLM 在 top-k 推荐中的推理能力。
(3)知识增强指令微调的影响:移除该组件后(w/o-instruction),LLM 以零样本方式执行 top-k 推荐,性能下降。这表明指令微调能引导 LLM 利用额外知识,提升其对推荐场景的适应性。
(4)LLM 选择的影响:用 Llama-2 替换 Llama-3.1(w/o-Llama3),性能显著下降。这证明指令微调后的 Llama-3.1 更适合 top-k 推荐中的推理任务。
针对 RQ2,我们得出结论:KERAG_R 的每个组件均对推荐性能有积极影响,共同构成了有效的基于 LLM 的 top-k 推荐方法。
详细解释
消融实验的核心是 “逐个移除组件,看性能是否下降”—— 下降则说明该组件必要,表 4 需重点解读 “性能下降幅度” 对应的组件重要性:
-
四个变体的设计逻辑:
- \(w/o-Llama3\):验证 “LLM 本身的性能” 是否影响结果(替换为更弱的 Llama-2);
- \(w/o-GraphRAG\):验证 “GraphRAG(融入 KG 知识)” 是否必要;
- \(w/o-instruction\):验证 “知识增强指令微调” 是否必要;
- \(w/o-selection\):验证 “GAT 选相关三元组” 是否必要(vs 随机选)。
-
性能下降幅度分析(以 Amazon-Book 的 HR@5 为例):
- \(w/o-Llama3\):HR@5 从 0.0216→0.0175,下降 19%—— 说明 Llama-3.1 比 Llama-2 更适合推荐任务;
- \(w/o-GraphRAG\):HR@5 从 0.0216→0.0203,下降 6%—— 说明 KG 知识的融入有必要,但影响不如 LLM 本身;
- \(w/o-instruction\):HR@5 从 0.0216→0.0210,下降 2.8%—— 说明指令微调能轻微提升性能,但核心增益来自 KG 知识;
- \(w/o-selection\):HR@5 从 0.0216→0.0214,下降 0.9%—— 说明 GAT 选相关三元组的增益虽小,但能避免噪声,稳定性能。
-
关键结论:
- 所有变体均带∗:说明移除任何组件后,性能均显著低于 KERAG_ \(R_{t}\);
- 组件重要性排序:LLM 选型(Llama-3.1)> GraphRAG > 知识增强指令微调 > 三元组选择方法;
- 核心逻辑:好的 LLM 是基础,KG 知识是核心增益来源,指令微调和三元组选择是优化细节。
4.4 Impact of the Number of Retrieved KG Triples (RQ3)(检索的 KG 三元组数量的影响)
翻译
我们现在分析 GraphRAG 组件中,检索的 KG 三元组数量(Q)对 KERAG_R 性能的影响。为简洁,我们仅报告 KERAG_Rt 的结果(KERAG_Rs 得出相同结论)。如 3.3.2 节所述,我们用 GAT 为每个物品检索 top-Q 三元组;Q 的取值范围为 {0,1,2,3}(初始实验中,Q>4 时因输入序列过长,单 GPU 出现内存溢出错误)。

图 2 显示,在所有三个数据集上,KERAG_R 在 Q=1 时性能达到峰值;当每个物品的三元组数量增加时,性能反而下降。这表明单个三元组已能提供足够的关系知识,有效增强 LLM 在 top-k 推荐中的推理能力;相反,GraphRAG 中整合更多三元组可能引入噪声和冗余,干扰 LLM 的决策过程。
针对 RQ3,我们得出结论:每个用户交互物品对应 1 个三元组时效果最佳;额外的三元组会阻碍 LLM 在 top-k 推荐中的推理。
图 2(KERAG_R 模型在不同三元组数量下的性能)详细解释
图 2 结构说明
- 横坐标(X 轴):三元组数量 Q(0、1、2、3);
- 纵坐标(Y 轴):性能提升百分比(相对于 Q=0 的提升,Q=0 即不使用任何 KG 三元组);
- 子图:三个数据集(ML-1M、ML-10M、Amazon-Book),每个子图包含四个指标(HR@3、NDCG@3、HR@5、NDCG@5)的提升曲线。
核心解读
- Q=0:无 KG 三元组,性能基准(提升率 = 0);
- Q=1:所有指标、所有数据集的提升率最高 —— 比如 Amazon-Book 的 HR@5 提升约 14%,验证了 “单个相关三元组足够”;
- Q≥2:性能提升率下降,甚至部分指标接近 Q=0—— 原因是引入了冗余 / 噪声三元组(比如用户喜欢《三体》,Q=2 时加入 “《三体》- 出版时间 - 2008”,该信息与用户偏好无关,反而干扰 LLM 判断);
- 内存限制:Q>4 时内存溢出 —— 因为每个三元组会增加提示词的 token 长度,超出 LLM 的输入限制(2048 token),进一步证明 “少而精” 的三元组更优。
关键启示
- 推荐系统中,KG 知识的 “相关性” 比 “数量” 更重要;
- 实际部署时,Q=1 是最优选择(平衡性能、计算成本和输入长度)。
5 Conclusions(结论)
翻译
为解决现有基于 LLM 的 top-k 推荐模型中 “领域特定知识缺失” 的问题,我们提出一种新型推荐模型 —— 面向推荐系统的知识增强型检索增强生成(KERAG_R)。具体而言,KERAG_R 包含一个新颖的 GraphRAG 组件和知识增强指令微调方法,将知识图谱(KG)中的外部知识整合到 LLM(如 Llama-3)提示词中,从而增强 LLM 在 top-k 推荐任务中的推理能力。
我们在三个数据集上进行了大量实验,结果表明:KERAG_R 显著优于十种强推荐基线(包括现有最先进的基于 LLM 的模型 RecRanker);消融实验验证了 KERAG_R 每个组件对推荐性能的积极影响;我们还确定了在 LLM 输入 token 长度限制下,每个用户交互物品对应的最优三元组数量。
特别地,我们发现:检索最相关的 KG 信息比使用额外的 KG 三元组更有效;在提示词中,知识图谱的关系型三元组表示优于自然语句表示。
详细解释
结论部分是整篇论文的 “总结与升华”,核心梳理如下:
-
核心贡献回顾:
- 方法创新:提出 GraphRAG + 知识增强指令微调,首次将 GraphRAG 应用于 LLM-based top-k 推荐;
- 性能突破:在三个数据集上击败 10 种 SOTA,Amazon-Book 上比 RecRanker 提升 14.89%;
- 实用发现:Q=1 最优、三元组格式优于句子格式。
-
研究意义:
- 解决了 LLM 推荐的核心痛点(幻觉、缺领域知识);
- 提供了 “KG+LLM” 的有效融合方案(GraphRAG 筛选 + 知识增强微调);
- 为实际部署提供了明确参数(Q=1、Llama-3.1、LoRA 秩 r=16 等)。
-
未来方向(隐含):
- 扩展到多模态推荐(如图片、视频推荐,KG 包含多模态实体);
- 优化 GraphRAG 的检索速度(当前 GAT 预训练需额外时间);
- 适配更长的用户交互历史(结合序列推荐的时序信息)。
更多推荐

 17
 0
- 0


 已为社区贡献1条内容

所有评论(0)