
深入探索C++中的线索二叉树实现

简介:线索二叉树是通过在二叉链表基础上增加线索来改善遍历的二叉树结构。C++实现要求深入理解二叉树的基本概念和链式存储。本文详细探讨了线索二叉树的原理以及如何使用C++进行实现,包括节点结构设计、线索化过程和前序、中序、后序遍历的非递归方法。对于处理大规模数据或内存受限的应用,线索二叉树能够提供有效的遍历解决方案,尽管它会增加一定的存储开销。
1. 线索二叉树概念
在探索计算机科学的深层次数据结构时,线索二叉树(Threaded Binary Tree)是一个极具效率和巧妙性的结构。线索二叉树通过增加线索(Thread),即指针,来改善二叉树的遍历效率。这种线索化可以将原本非线性的树结构转化为某种线性结构,类似于双向链表。线索二叉树主要有两种类型:前驱线索和后继线索,它们分别用于快速访问节点的前一个节点和后一个节点。本章我们将深入浅出地探索线索二叉树的基本概念及其实际应用,为后续更深层次的理解和应用打下坚实的基础。
2. 二叉树基本概念和遍历
2.1 二叉树的基础知识
2.1.1 二叉树的定义和性质
二叉树是数据结构领域的一个重要概念,它是一种每个节点最多有两个子节点的树形数据结构。每个节点有零个、一个或两个子节点,分别称为左子节点和右子节点。二叉树在逻辑上可以被看作是节点的集合,这个集合可以为空,也可以有一个根节点,且它的每个子集合本身也是二叉树,称为该根节点的左子树和右子树。
二叉树具有以下基本性质:
- 第 i 层上的节点数目最多为 2^(i-1)(i ≥ 1)。
- 深度为 k 的二叉树最多有 2^k - 1 个节点(k ≥ 1)。
- 对于任意的二叉树,如果叶子节点数目为 n0,度为 2 的节点数目为 n2,则有 n0 = n2 + 1。
理解这些性质有助于我们在处理二叉树问题时,对树的结构有一个清晰的认识,为后续的遍历和操作提供理论基础。
2.1.2 完全二叉树与满二叉树的区别
满二叉树是指所有层的节点数都达到最大,即每一层的节点数都是上一层的两倍,直到最后一层。换句话说,一个深度为 k 且有 2^k - 1 个节点的二叉树被称为满二叉树。
完全二叉树则是指除了最后一层外,其它每一层的节点数目都是满的,并且最后一层的节点都靠左排列。这意味着,一个深度为 k 的完全二叉树,其节点总数可能在 2^(k-1) 到 2^k - 1 个之间。
满二叉树和完全二叉树的区别主要体现在最后一层的节点排列上。满二叉树的每个节点都拥有两个子节点,而完全二叉树的最后一层可能不完全被节点填满。
2.2 二叉树的遍历算法
2.2.1 前序、中序和后序遍历原理
二叉树的遍历是指按照某种规则访问树中每个节点一次且仅一次的过程。常见的遍历方法有前序遍历、中序遍历和后序遍历。
- 前序遍历 :先访问根节点,然后递归地进行前序遍历左子树,接着递归地进行前序遍历右子树。
- 中序遍历 :先递归地进行中序遍历左子树,然后访问根节点,最后递归地进行中序遍历右子树。
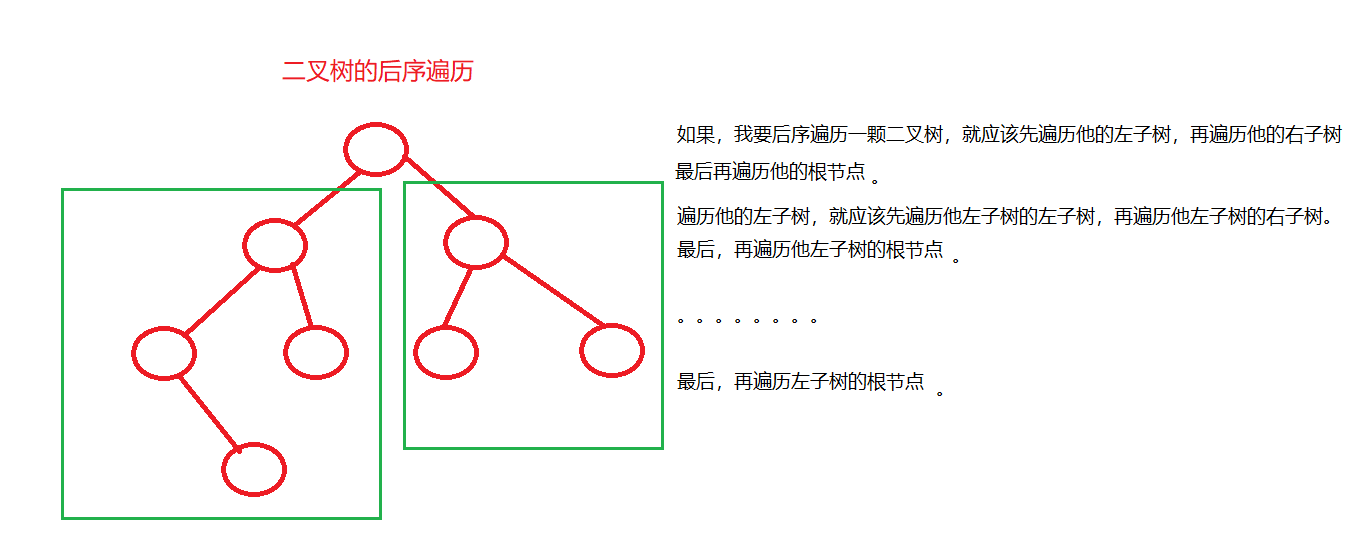
- 后序遍历 :先递归地进行后序遍历左子树,接着递归地进行后序遍历右子树,最后访问根节点。
前序遍历和后序遍历易于递归实现,中序遍历则因为按照“左-根-右”的顺序访问,特别适合二叉搜索树的场景,可以保证访问的节点序列是有序的。
下面是一个简单的中序遍历的伪代码示例:
INORDER-Traverse(T, x)
    if x is not null then
        INORDER-Traverse(T, x.left)
        VISIT(x)
        INORDER-Traverse(T, x.right)
    end if
在这段伪代码中, T 表示当前的二叉树, x 表示当前节点, x.left 和 x.right 分别代表当前节点的左子节点和右子节点。 VISIT(x) 表示对节点 x 的操作,这个操作可以是打印节点值,也可以是其他处理。
2.2.2 层次遍历的实现方法
层次遍历是一种不同于深度优先遍历(前序、中序、后序)的广度优先遍历方法。它按照从上到下、从左到右的顺序逐层访问树中的每一个节点。
实现层次遍历通常需要借助队列这一数据结构。其基本步骤如下:
- 创建一个空队列,并将根节点入队。
- 当队列不为空时:
- 队头元素出队,并访问该节点。
- 如果该节点有左子节点,将左子节点入队。
- 如果该节点有右子节点,将右子节点入队。 - 重复步骤2直到队列为空,此时树中所有节点都已访问完毕。
层次遍历的伪代码示例如下:
LEVEL-ORDER-Traverse(T)
    if T is empty then
        return
    end if
    Q = empty queue
    Q.enqueue(T.root)
    while not Q.isEmpty() do
        node = Q.dequeue()
        VISIT(node)
        if node.left is not null then
            Q.enqueue(node.left)
        end if
        if node.right is not null then
            Q.enqueue(node.right)
        end if
    end while
在此伪代码中, T.root 表示二叉树的根节点, Q 是用于存储节点的队列。 VISIT(node) 表示对节点的操作。
层次遍历特别适合需要按层次处理节点信息的场景,比如树的序列化和反序列化等。
2.2.3 遍历算法的时间复杂度分析
无论是前序、中序、后序遍历,还是层次遍历,它们的时间复杂度都是 O(n),其中 n 是树中节点的总数。这是因为在每种遍历方法中,每个节点都仅被访问一次。遍历算法的空间复杂度取决于树的形态和所采用的遍历方法。对于前序、中序和后序遍历,如果采用递归实现,其空间复杂度为 O(h),其中 h 是树的高度,这是因为每次递归调用都需要在调用栈上保存当前节点。对于非递归实现,空间复杂度通常是 O(n),因为需要使用栈或队列来模拟递归过程。
层次遍历的空间复杂度在最坏的情况下也是 O(n),这发生在树退化为一个链表时,此时队列的大小将达到树中节点的总数。在实际应用中,层次遍历的空间复杂度通常介于 O(log n) 和 O(n) 之间,这取决于树的高度和节点的分布情况。
遍历算法是二叉树操作的基础,理解它们的时间和空间复杂度有助于我们更好地选择适合特定应用场景的遍历方法。
3. 线索化过程与节点结构设计
3.1 线索二叉树的线索化概念
线索化是将二叉树的空指针指向前驱或后继节点的过程,目的是提高二叉树遍历的效率,特别是在没有递归栈支持的情况下。线索化处理后,可以快速遍历二叉树,无需回溯。
3.1.1 线索化的目的和意义
线索化处理的二叉树,其节点结构包含了指向其前驱和后继节点的指针(线索)。这样,即使二叉树没有采用递归遍历方式,也可以通过直接跳转的方式访问到树中的所有节点。这在内存受限的环境下,或需要高效遍历大数据量的二叉树时,具有非常重要的意义。线索化后的二叉树使得遍历变得更为直观和高效。
3.1.2 线索的分类:前驱和后继线索
在线索二叉树中,存在两种类型的线索:前驱线索和后继线索。前驱线索指的是节点的左指针指向其前驱节点,即前一个按某种遍历顺序访问到的节点;同理,后继线索指的是节点的右指针指向其后继节点,即后一个按该遍历顺序访问到的节点。这种结构使得可以在无递归的情况下进行树的遍历,提高了遍历的效率。
3.2 线索二叉树节点的设计
3.2.1 节点结构的定义和扩展
线索二叉树节点的设计通常是在普通二叉树节点的基础上增加了两个标志位,分别用来指示指针是孩子指针还是线索指针。典型的节点设计如下:
typedef struct ThreadNode {
    int data; // 节点数据
    struct ThreadNode *left, *right; // 左右孩子指针
    int ltag, rtag; // 左右标志位,0表示孩子指针,1表示线索指针
} ThreadNode, *ThreadTree;
这里, ltag 和 rtag 分别代表左右指针的类型。当 ltag 或 rtag 为0时,分别表示左孩子或右孩子指针指向实际的左或右子树;当 ltag 或 rtag 为1时,则表示该指针指向的是线索,也就是前驱或后继节点。
3.2.2 静态线索二叉树与动态线索二叉树的比较
静态线索二叉树在树创建的过程中进行线索化处理,一旦线索化完成,树的结构就固定下来,不允许改变。动态线索二叉树允许在二叉树创建后对其进行插入或删除操作,但需要维护线索的一致性,确保每次操作后线索依然有效。动态线索二叉树的操作复杂度和维护成本较高,但提供了更大的灵活性。
3.2.3 线索化过程的递归与非递归实现
线索化过程可以采用递归方法,也可以采用非递归方法。递归方法较为直观,但在某些情况下可能会导致栈溢出。非递归线索化的实现使用栈,可以避免递归方法可能出现的问题,适合处理大规模数据。
以下是使用非递归方式实现的线索化过程的伪代码:
void InOrder线索化(ThreadTree T) {
    stack<ThreadNode*> s;
    ThreadNode *p = T; // p指向根节点
    while (p != NULL || !s.empty()) {
        if (p != NULL) { // 先找前驱
            s.push(p);
            p = p->left;
        } else { // 找后继
            p = s.top();
            s.pop();
            // 调整线索
            if (!p->ltag) {
                p->left = s.top(); // 前驱线索
            }
            if (!p->rtag) {
                p->right = p->right == NULL ? NULL : s.top(); // 后继线索
            }
            p = p->right;
        }
    }
}
在此代码中,我们使用了一个栈 s 来暂时存放访问过的节点,以便于调整节点的线索。这个过程需要保持左标志位 ltag 和右标志位 rtag 的正确性,确保线索的正确设置。非递归线索化的实现通常比递归的实现复杂,但更适合大规模树的处理。
4. 非递归遍历方法实现
4.1 非递归遍历的原理
4.1.1 栈在非递归遍历中的应用
非递归遍历二叉树的关键在于使用栈来模拟系统调用栈的行为,从而避免了递归所需的额外空间。在前序、中序、后序遍历中,节点访问的顺序和返回顺序不同,需要借助栈结构来调整这些顺序。
前序遍历
在前序遍历中,我们首先访问节点,然后将其右孩子和左孩子依次压栈。因为在前序遍历中,当前节点总是先于其孩子节点被访问。栈先进后出的特性保证了左孩子总是能够在右孩子之前被处理。
中序遍历
中序遍历稍复杂一些。在中序遍历中,我们首先尽可能将左孩子压栈,然后访问节点,并将其右孩子压栈。栈内的顺序保证了从左到右的遍历顺序。需要注意的是,我们只有在到达没有左孩子的节点时,才会真正开始访问和弹出栈内的节点。
后序遍历
后序遍历的非递归实现相当复杂。我们不能简单地先左后右压栈,因为那样无法保证节点的后序顺序。通常需要借助两次栈操作,即先按照前序遍历的方式访问节点,但是并不直接访问节点,而是将它们压入栈中。然后再次使用栈,这次是为了按照中序的逆序(即从右至左的中序遍历)遍历,来得到后序遍历。
4.1.2 非递归前序、中序和后序遍历的算法思想
非递归遍历利用栈的特性,通过不断循环执行以下步骤:
- 将当前节点和其左孩子(如果有的话)入栈。
- 弹出栈顶元素,并访问。
- 将弹出节点的右孩子入栈(如果有的话)。
接下来的步骤根据遍历类型的不同略有差异,例如在中序遍历中,由于需要先访问左孩子,所以在入栈右孩子之前,我们需要尽可能地向左走。
4.2 非递归遍历的实现方法
4.2.1 中序遍历的非递归实现
下面是中序遍历的非递归实现代码:
def inorder_traversal(root):
    stack = []
    current = root

    while stack or current:
        # Reach the leftmost node of the current node
        while current:
            stack.append(current)
            current = current.left

        # Current must be None at this point
        current = stack.pop()
        print(current.val, end=' ')

        # We have visited the node and its left subtree.
        # Now, it's right subtree's turn
        current = current.right

# 二叉树节点定义
class TreeNode:
    def __init__(self, x):
        self.val = x
        self.left = None
        self.right = None
4.2.2 前序和后序遍历的非递归算法
前序遍历和后序遍历的非递归算法思路与中序遍历类似,但具体步骤略有不同。
前序遍历
前序遍历首先访问节点,然后将右孩子和左孩子依次压栈。
def preorder_traversal(root):
    if not root:
        return
    stack = [root]
    while stack:
        node = stack.pop()
        print(node.val, end=' ')
        # Since the right child is processed first, it's next in the stack
        if node.right:
            stack.append(node.right)
        if node.left:
            stack.append(node.left)
后序遍历
后序遍历的非递归实现较为复杂,这里提供一个简化的版本。需要注意的是,为了保证访问顺序正确,可能需要在遍历过程中标记节点是否被访问过。
def postorder_traversal(root):
    if not root:
        return
    stack, output = [root], []
    while stack:
        node = stack[-1]
        if node.left is None and node.right is None or \
           (node.left in output or node.left is None) and \
           (node.right in output or node.right is None):
            output.append(stack.pop().val)
        else:
            if node.right:
                stack.append(node.right)
            if node.left:
                stack.append(node.left)
    print(' '.join(map(str, output)))
以上代码段落和解释为非递归遍历方法提供了一个清晰的实现。针对每种遍历,我们都采用了不同的逻辑来模拟递归过程,并使用栈数据结构来实现深度优先搜索。在实际操作中,这些逻辑可以根据具体需求进行调整和优化。
5. 线索二叉树的插入、删除和查找操作
5.1 线索二叉树的插入操作
5.1.1 插入操作对线索的影响
线索二叉树的插入操作与普通二叉树的插入操作存在差异,主要体现在插入节点后,需要调整或重新线索化相关节点以保持线索的正确性。当我们向线索二叉树中插入一个新的节点时,需要检查该节点的父节点和子节点,确定它们是否需要建立新的线索联系。
具体来说,插入节点后,可能需要对以下线索进行调整:
- 如果插入的节点成为某个子树的最左节点,那么它的前驱线索应该指向它的父节点。
- 如果插入的节点在父节点的左孩子位置上,那么它可能会改变父节点左孩子指针的线索状态。
- 如果插入的节点成为某个子树的最右节点,那么它的后继线索应该指向它的父节点。
- 如果插入的节点在父节点的右孩子位置上,那么它可能会改变父节点右孩子指针的线索状态。
5.1.2 插入算法的实现步骤和注意事项
在实现插入算法时,需要遵循以下步骤:
- 找到插入节点位置的父节点。
- 创建新节点,并确定其左右孩子指针。
- 调整父节点及其周围节点的线索。
- 更新线索指针,以便新的插入节点也能正确地参与线索化。
在插入节点时,有以下注意事项:
- 插入节点后的线索调整只可能影响到该节点及其父节点的线索。
- 当插入节点的左右指针指向的是其实际的左右孩子时,需要判断这两个孩子节点是否需要调整线索。
- 如果插入的节点替代了一个父节点的右孩子,且父节点原来右孩子指针为线索(无右孩子),需要将父节点的右孩子线索改为指向插入的节点。
- 如果插入的节点替代了一个父节点的左孩子,且父节点原来左孩子指针为线索(无左孩子),需要将父节点的左孩子线索改为指向插入的节点。
下面是一个插入操作的代码示例:
typedef struct ThreadNode {
    int data;
    struct ThreadNode *left;
    struct ThreadNode *right;
    int ltag;
    int rtag;
} ThreadNode, *ThreadTree;

// 插入操作的辅助函数,用于找到合适的插入位置
ThreadNode* find_position(ThreadTree tree, int data) {
    // 实现细节略
}

// 插入操作主函数
void insert(ThreadTree *tree, int data) {
    ThreadNode *p = find_position(*tree, data);
    if (p == NULL) {
        printf("插入位置不存在。\n");
        return;
    }

    ThreadNode *newNode = (ThreadNode*)malloc(sizeof(ThreadNode));
    newNode->data = data;
    newNode->left = newNode->right = NULL;
    newNode->ltag = newNode->rtag = 0; // 表示是孩子指针

    // 插入新节点逻辑
    // ...
    // 线索调整逻辑
    // ...
}
在这个代码示例中,我们首先定义了线索二叉树节点的结构体,然后实现了插入操作的主函数。在主函数中,我们调用辅助函数 find_position 来找到插入的位置。之后,创建新节点并插入,最后进行线索的调整。需要注意的是,实际的线索调整逻辑需要根据具体情况来实现,这里仅展示了插入操作的框架。
5.2 线索二叉树的删除操作
5.2.1 删除操作的基本原则和分类
线索二叉树的删除操作要比插入更为复杂,主要原因是删除节点后,需要保证树的结构正确以及线索的有效性。删除操作的基本原则是:
- 删除节点后,新的节点必须能够替代被删除节点的位置。
- 删除节点后,应尽可能保持树的平衡。
- 删除节点后,需要调整相关节点的线索。
线索二叉树删除操作的分类:
- 删除叶子节点:直接删除,更新父节点的线索。
- 删除只有一个孩子的节点:用其孩子节点替代它,并更新线索。
- 删除有两个孩子的节点:通常用其右子树的最小值节点或者左子树的最大值节点替代它。
5.2.2 删除算法的实现和线索的维护
实现删除算法时,我们通常采用替换策略:
- 找到需要删除的节点。
- 根据删除节点的子节点个数,决定替换策略。
- 删除节点后,调整相关节点的线索信息。
下面是一个删除操作的代码示例:
// 删除操作的辅助函数,用于找到待删除的节点
ThreadNode* find_delete_node(ThreadTree tree, int data) {
    // 实现细节略
}

// 删除操作主函数
void delete(ThreadTree *tree, int data) {
    ThreadNode *p = find_delete_node(*tree, data);
    if (p == NULL) {
        printf("待删除的节点不存在。\n");
        return;
    }

    // 删除节点逻辑
    // ...

    // 线索维护逻辑
    // ...
}
在这个代码示例中,我们首先定义了删除操作的辅助函数,用于找到待删除的节点。然后实现删除操作的主函数,进行节点的删除以及线索的维护。需要注意的是,具体的删除逻辑和线索维护逻辑需要根据实际情况来编写。
5.3 线索二叉树的查找操作
5.3.1 查找前驱和后继的线索方法
在线索二叉树中,查找一个节点的前驱和后继可以不通过递归或循环遍历,而是直接通过节点中的线索指针来实现。查找一个节点的前驱和后继是线索二叉树中的常见操作,它提高了查找效率。
- 查找前驱节点:
如果当前节点的左标记 ltag 为0,那么它的前驱是左孩子节点;否则,它的前驱是沿着左线索指针所能到达的最右节点。
- 查找后继节点:
如果当前节点的右标记 rtag 为0,那么它的后继是右孩子节点;否则,它的后继是沿着右线索指针所能到达的最左节点。
下面是一个查找前驱和后继节点的代码示例:
// 查找前驱节点的函数
ThreadNode* predecessor(ThreadNode *node) {
    if (node == NULL) return NULL;
    if (node->ltag == 0) {
        // 左孩子存在,前驱是左孩子
        return node->left;
    } else {
        // 左孩子不存在,前驱是左线索指向的节点
        ThreadNode *p = node->left;
        while (p != NULL && p->rtag == 1) {
            p = p->right;
        }
        return p;
    }
}

// 查找后继节点的函数
ThreadNode* successor(ThreadNode *node) {
    if (node == NULL) return NULL;
    if (node->rtag == 0) {
        // 右孩子存在,后继是右孩子
        return node->right;
    } else {
        // 右孩子不存在,后继是右线索指向的节点
        ThreadNode *p = node->right;
        while (p != NULL && p->ltag == 1) {
            p = p->left;
        }
        return p;
    }
}
在上述代码中,我们定义了两个函数 predecessor 和 successor 来查找节点的前驱和后继。这两个函数分别根据左右线索的标志位来确定前驱和后继的位置。
5.3.2 查找特定值的节点操作
在线索二叉树中查找具有特定值的节点与普通二叉树的查找方法类似,但是线索二叉树提供了额外的线索信息,可以提高查找效率。
线索二叉树查找特定值节点的操作步骤如下:
- 从根节点开始,按照线索化规则遍历线索二叉树。
- 在遍历过程中,比较节点值与目标值。
- 如果节点值等于目标值,返回当前节点。
- 如果节点值大于目标值,向左线索化继续查找。
- 如果节点值小于目标值,向右线索化继续查找。
由于线索二叉树在遍历时可以有效利用线索信息,因此查找操作比非线索化的二叉树要快,因为它减少了不必要的递归或循环。
下面是一个查找特定值节点的代码示例:
// 查找具有特定值的节点的函数
ThreadNode* find(ThreadTree tree, int value) {
    ThreadNode *p = tree;
    while (p != NULL) {
        if (p->data == value) {
            return p; // 找到目标值,返回节点
        } else if (p->data > value) {
            if (p->ltag == 1 && p->left != NULL) {
                p = p->left; // 利用线索化信息向左查找
            } else {
                p = p->right; // 向右孩子方向查找
            }
        } else {
            if (p->rtag == 1 && p->right != NULL) {
                p = p->right; // 利用线索化信息向右查找
            } else {
                p = p->left; // 向左孩子方向查找
            }
        }
    }
    return NULL; // 没有找到目标值,返回NULL
}
在上述代码中,我们实现了一个 find 函数,该函数利用线索化的优势来查找具有特定值的节点。通过比较当前节点的值和目标值,我们可以决定是沿着线索查找还是向孩子节点移动。
以上是第五章线索二叉树的插入、删除和查找操作的详细内容。通过本章节的介绍,读者应该能够理解线索二叉树在插入、删除和查找这些基本操作中与普通二叉树的异同,以及如何通过线索化的信息来优化这些操作。在下一章中,我们将探讨线索二叉树在内存受限环境下的应用优势及其实际应用案例。
6. 线索二叉树在内存受限环境的应用优势
6.1 内存受限环境下的数据结构优化
6.1.1 内存受限背景介绍
在计算机系统和嵌入式设备中,内存资源往往是受限的。受限的内存空间会对程序设计和数据存储方式带来挑战。在此背景下,数据结构的选择和优化显得尤为重要。如果数据结构过于复杂或占用过多内存空间,则可能无法在目标硬件上有效运行。这就需要开发出更加精简、占用内存更少的数据结构来适应这种环境。
线索二叉树作为一种优化的数据结构,在内存受限的环境下有着明显的优势。在普通二叉树中,节点只存储了指向左右子树的指针,而线索二叉树通过在节点中增加线索指针来利用那些原本是空指针的位置,从而更高效地存储和访问树中的节点信息。
6.1.2 线索二叉树节省内存的原理
线索二叉树通过线索化的方式,将原本未利用的空指针转化为指向节点的前驱或后继的线索指针。这样的转换可以减少节点的内存开销。例如,对于一棵普通的二叉树,每个节点需要存储两个指针,每个指针通常是4个字节(假设使用32位系统)。线索化后,如果某个节点的左(右)子树为空,则该指针位置可以被用作线索,存储该节点的前驱(后继)节点的引用。这样不仅节省了空间,还能加速遍历和搜索操作。
线索二叉树的一个特殊形式是线索链表,它可以完全用指针来表示二叉树的结构,并且无需额外的存储空间来保存线索,仅通过指针中的空值来判断是子节点还是线索。这进一步减少了内存需求,尤其适合内存非常有限的系统。
6.2 线索二叉树的实际应用案例
6.2.1 线索二叉树在数据库索引中的应用
在数据库管理系统中,索引是提高查询效率的关键机制。线索二叉树由于其高效的遍历和插入特性,在构建数据库索引时有着独特的优势。B+树是一种常用的索引结构,其在内部节点用于导航,在叶子节点存储数据记录或者记录的引用,并且叶子节点之间通过指针链接,形成链表。这种结构在逻辑上与线索二叉树非常相似。
通过线索化的B+树,可以迅速遍历树中的所有元素,实现范围查询等复杂操作。在内存受限的嵌入式数据库系统中,这种结构能够确保数据库索引的操作性能,同时占用更少的内存空间。
6.2.2 线索二叉树在文件系统中的应用
文件系统经常需要维护大量的目录和文件,这就需要一种可以高效维护层次关系的数据结构。线索二叉树在文件系统的目录结构中能够优化文件和目录的查找、遍历操作。
一个典型的线索二叉树文件系统示例是Mac OS的HFS+文件系统。在HFS+文件系统中,目录项使用线索二叉树进行排序和存储,这使得文件系统能够快速定位到特定的目录项,以及高效地实现文件的遍历操作,如列出文件夹中的所有文件或文件夹。线索二叉树结构的应用大幅提升了文件系统的性能,特别是在处理大量文件和深层次目录结构时。
6.2.3 其他线索二叉树应用领域分析
线索二叉树的适用范围很广,除了数据库和文件系统,它在以下领域也有着显著的应用:
- 文本编辑器: 在文本编辑器中,文档可以看作是一棵树,其中每个字符是一个节点。线索二叉树可以用来存储文本结构,快速跳转到文本的任意位置。
-
图形用户界面: GUI框架中,窗口和控件的层次关系可以使用线索二叉树来管理。这样的结构有助于快速地遍历窗口和控件,响应用户的交互操作。
-
网络协议: 在某些网络协议的实现中,线索二叉树用来维护连接状态和路由信息,实现高速的数据转发和路径查找。
线索二叉树的上述应用展示了其在内存受限环境下,如何通过节省空间同时提供高效的访问和管理能力。这使得线索二叉树成为一种值得推广和深入研究的数据结构。
在实现线索二叉树时,根据具体的应用需求,可以进行相应的调整和优化。如在某些情况下,设计特定的内存分配策略来适应不同的使用场景。总体来说,线索二叉树作为数据结构的优化解决方案,在未来有着广阔的应用前景。
7. 线索二叉树的性能优化与扩展应用
7.1 性能优化的重要性
在计算机科学中,性能优化始终是一个核心议题,特别是在数据结构和算法的设计上。线索二叉树作为二叉树的一种高效变体,其性能优化同样不可或缺。性能优化不仅包括时间效率的提升,也包含空间利用率的优化。线索二叉树的优势在于提高了遍历速度和查找效率,减少了一些不必要的递归调用开销。但即便如此,仍有许多细节可以进一步改进。
7.2 线索二叉树优化策略
优化线索二叉树可以从多个层面进行,比如节点设计的改进、线索化过程的优化以及存储密度的提高等。
7.2.1 节点设计的改进
传统的线索二叉树节点中,通常会增加两个标志位来表示节点的线索状态。但在某些情况下,可以通过增加更多的信息来进一步优化。例如,可以在节点中增加子节点数量的计数,这样在遍历时可以快速判断子树是否为空,从而减少不必要的指针访问。
7.2.2 线索化过程的优化
线索化过程的优化主要针对递归和非递归两种方式。递归线索化虽然代码简洁,但可能会因为递归调用导致栈溢出。因此,可以考虑使用迭代的方式进行线索化,同时,采用显式栈结构替代系统调用栈,可以更好地控制过程。
7.2.3 存储密度的提高
存储密度是指数据结构中有效信息所占空间的比例。在线索二叉树中,可以通过减少节点中的冗余信息来提高存储密度。例如,可以只记录指向左子树前驱和右子树后继的指针,而不记录指向左右子树的指针,从而在某些情况下节省空间。
7.3 线索二叉树的扩展应用
线索二叉树的优化不仅在于内部结构的调整,其应用范围的拓展同样重要。对于特定的应用场景,线索二叉树可能会需要特定的改进。
7.3.1 动态调整线索二叉树
在一些应用场景中,二叉树的结构会频繁变化,比如频繁的插入和删除操作。为了保持线索二叉树的高效率,可以实现动态调整线索二叉树的功能,以适应结构的变化。
7.3.2 多线索二叉树
在某些情况下,单线索二叉树可能无法满足需求,此时可以考虑实现多线索二叉树。多线索二叉树除了维护节点的前驱和后继线索外,还可以加入父节点的线索,以及其他辅助线索,从而进一步优化查找和遍历的效率。
7.4 实际案例分析
为了更好地理解线索二叉树在实际应用中的优化与扩展,我们来看一个具体案例。
案例分析:线索二叉树在搜索引擎中的应用
搜索引擎需要处理大量的数据索引,并且要求快速准确地返回搜索结果。线索二叉树因其高效的遍历能力,被广泛应用于搜索引擎的索引构建和管理中。例如,在构建索引时,可以使用线索二叉树来记录每个词根的出现位置,从而加快搜索时的匹配速度。
通过不断地优化和扩展线索二叉树,搜索引擎可以在保持索引结构紧凑的同时,大幅提高搜索效率,实现更快的响应时间和更准确的搜索结果。
(注:本案例为说明性内容,并非真实的搜索引擎实现细节。)
代码和数据结构示例
为了进一步说明线索二叉树的性能优化,下面提供一个线索化二叉树节点的数据结构和线索化算法的简单示例代码:
typedef struct ThreadedTreeNode {
    int data;
    struct ThreadedTreeNode *left;
    struct ThreadedTreeNode *right;
    int ltag; // 左标志位,表示左指针是指向左子节点还是前驱
    int rtag; // 右标志位,表示右指针是指向右子节点还是后继
} ThreadedTreeNode;

// 中序线索化函数示例
void InOrderThreading(ThreadedTreeNode *p, ThreadedTreeNode **pre) {
    if (p) {
        InOrderThreading(p->left, pre); // 线索化左子树
        if (!p->left) {
            p->left = *pre; // 前驱线索
            p->ltag = 1;
        }
        if (*pre && !(*pre)->right) {
            (*pre)->right = p; // 后继线索
            (*pre)->rtag = 1;
        }
        *pre = p;
        InOrderThreading(p->right, pre); // 线索化右子树
    }
}
在上述代码中, ltag 和 rtag 分别表示左右指针的线索类型,当它们被设置为 1 时,分别表示该指针是指向前驱或后继节点。这种方式减少了在遍历过程中需要的额外条件判断,提高了遍历的效率。
结论
线索二叉树的性能优化和扩展应用,可以提升数据结构的实用性,满足特定场景下的性能需求。通过分析线索二叉树的内部结构和操作特性,可以在多个方面进行改进和创新,从而为解决实际问题提供更有效的数据结构支持。
简介:线索二叉树是通过在二叉链表基础上增加线索来改善遍历的二叉树结构。C++实现要求深入理解二叉树的基本概念和链式存储。本文详细探讨了线索二叉树的原理以及如何使用C++进行实现,包括节点结构设计、线索化过程和前序、中序、后序遍历的非递归方法。对于处理大规模数据或内存受限的应用,线索二叉树能够提供有效的遍历解决方案,尽管它会增加一定的存储开销。
更多推荐

 3
 0
- 0


 已为社区贡献16条内容

所有评论(0)