
数据结构PPT课件:图解与实例相结合的详细教程

简介:数据结构是计算机科学的核心课程,它涉及数据的存储、组织和操作,以便高效地进行数据检索和管理。本PPT课件详细介绍了数据结构的基础概念、关键类型及其应用,并通过图解和实例使学习者更易理解。内容包括数据结构的基本概念、线性结构、树形结构、图结构、集合数据结构、排序和查找算法以及优化策略。学生将通过课件中的深入讲解来掌握数据结构的核心知识。
1. 数据结构基础概念
数据结构是计算机存储、组织数据的方式,它是算法实现的基石。理解数据结构,首先要区分数据、数据元素、数据项与数据结构之间的关系。数据是信息的载体,数据元素是数据的基本单位,数据项是构成数据元素的不可分割的最小单位,而数据结构则是指这些数据元素相互之间存在的一种或多种特定的关系。
在处理数据时,需要通过某种结构将这些数据元素组织起来,以便能更高效地进行数据操作,如增加、删除、查找和修改等。数据结构通常可以分为两大类:基本数据结构和高级数据结构。基本数据结构包括数组、字符串等,它们直接由编程语言提供,而高级数据结构如链表、栈、队列、树、图等,则是通过组合基本数据结构而实现的更复杂的结构。
接下来,我们将深入探讨数据结构的核心概念,并逐步进入数据结构的逻辑结构与物理结构的讨论。首先,我们将从数据结构的逻辑结构出发,理解其分类与特性,这是深入学习任何数据结构的起点。
2. 逻辑结构与物理结构
2.1 逻辑结构的分类与特性
逻辑结构是数据在计算机中的抽象表示,它与数据的存储方式无关,而是取决于数据之间的逻辑关系。逻辑结构主要分为以下四种:
2.1.1 集合结构的特点
集合结构是一种最基本的逻辑结构,它仅要求元素之间没有明显的次序关系,也没有其他结构特征。在集合中,一个元素可以独自出现,也可以与一个或多个元素相关联。这种结构强调的是数据的“归属”关系,如数学中的集合概念。
graph TD
    A[集合结构] -->|表示数据| B[元素]
    A -->|表示关系| C[元素之间的联系]
    B -->|可能| D[元素A]
    B -->|可能| E[元素B]
    C -->|无明显次序| D
    C -->|无明显次序| E
集合结构在编程中常用于实现类似集合的数据类型,如Python中的 set 类型。
2.1.2 线性结构的定义与应用
线性结构具有一个起点和一个终点,数据元素之间是一对一的关系。线性结构包括线性表、栈、队列等。线性表中的元素依次排列,每个元素都有一个前驱和一个后继(除了第一个和最后一个元素)。
graph LR
    A[起点] -->|前驱| B[元素1]
    B -->|后继| C[元素2]
    C -->|...| D[...]
    D -->|后继| E[元素n-1]
    E -->|后继| F[终点]
线性表可以顺序存储也可以链式存储,栈和队列是两种特殊类型的线性表,适用于解决特定的问题,如表达式计算和任务调度等。
2.1.3 树形结构的特征
树形结构是一种非线性结构,它模拟了一棵树的结构,具有分支、层次的特点。树形结构中的元素被称为节点,节点之间有明确的父子关系,没有父节点的节点称为根节点,没有子节点的节点称为叶子节点。
graph TD
    A[根节点] --> B[子节点1]
    A --> C[子节点2]
    B --> D[孙子节点1]
    B --> E[孙子节点2]
    C --> F[孙子节点3]
树形结构在数据库、文件系统等领域中得到广泛应用,如表示组织结构、数据目录等。
2.1.4 图结构的组成要素
图结构是包含一组顶点(节点)和一组连接顶点的边的结构。图可以表示元素之间的复杂关系,例如,社交网络中的好友关系就可以用图来表示。
graph LR
    A[节点1] -->|边| B[节点2]
    A -->|边| C[节点3]
    B -->|边| D[节点4]
    C -->|边| E[节点5]
图结构分为有向图和无向图,可以用来解决诸如路径搜索、网络流等问题。
2.2 物理结构的存储方式
物理结构是指数据在计算机存储设备中的具体存储方法,它涉及数据元素在存储介质上的位置关系和管理方式。物理结构主要分为四种:
2.2.1 顺序存储结构
顺序存储结构是指数据元素在内存中连续存放,每个数据元素的存储地址可以通过计算得到。这种结构的优点是存取速度快,但不易于插入和删除操作。
flowchart LR
    A[起始地址] -->|地址计算| B[元素1]
    B -->|地址计算| C[元素2]
    C -->|...| D[...]
    D -->|地址计算| E[元素n]
数组是顺序存储结构的典型应用,适合处理大量固定大小且连续访问的场景。
2.2.2 链式存储结构
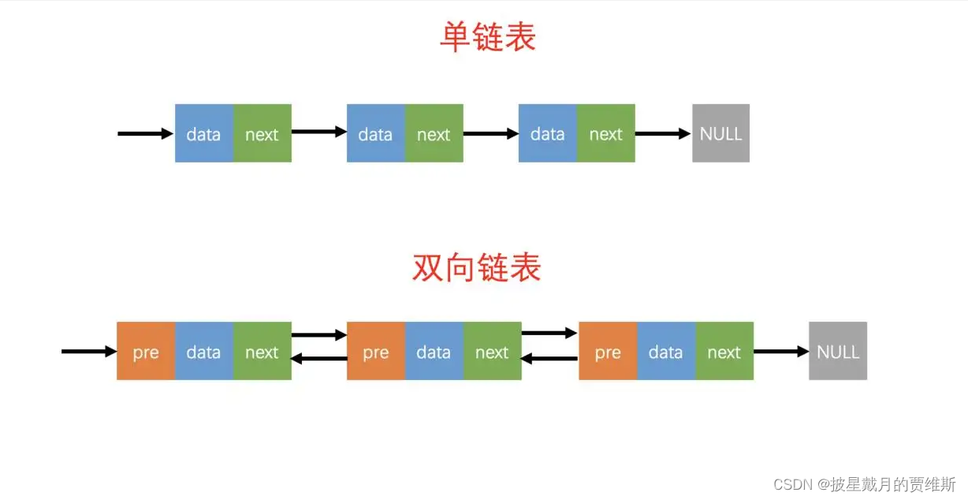
链式存储结构是指数据元素在内存中不必连续存放,每个数据元素由一个存储单元存储,这个存储单元除了存储数据本身外,还存储了一个指向下一个元素的指针(或引用)。
graph LR
    A[头节点] -->|指针| B[节点1]
    B -->|指针| C[节点2]
    C -->|...| D[...]
    D -->|指针| E[节点n]
链表是最常见的链式存储结构,它适合插入和删除操作频繁的场景。
2.2.3 索引存储结构
索引存储结构是对数据元素进行排序,并建立索引表,索引表中的每个索引项通常由数据元素的关键码和指向该数据元素所在位置的指针组成。
graph LR
    A[索引表] -->|索引1| B[数据元素1]
    A -->|索引2| C[数据元素2]
    A -->|...| D[...]
    A -->|索引n| E[数据元素n]
索引存储结构结合了顺序存储和链式存储的优势,适用于快速查找和访问。
2.2.4 散列存储结构
散列存储结构是通过散列函数计算出元素的存储地址,将元素存储在表中的对应位置。散列存储的关键是设计一个好的散列函数,以及处理可能出现的冲突。
graph LR
    A[散列表] -->|散列函数| B[数据元素1的位置]
    A -->|散列函数| C[数据元素2的位置]
    A -->|...| D[...]
    A -->|散列函数| E[数据元素n的位置]
散列存储结构具有非常高的存取效率,适合于符号表等快速查找和更新的应用场景。
3. 操作集合定义
3.1 数据结构操作的定义
数据结构操作是数据组织和管理的核心,它定义了数据结构的行为和功能。任何数据结构在设计时都必须考虑其支持的基本操作集合,这些操作通常包括数据的插入、删除、查找、修改等。
3.1.1 基本操作与辅助操作
基本操作是直接改变数据结构状态的操作。例如,对于线性表,插入和删除元素是其基本操作;而对于树状结构,增加节点、删除节点和节点定位是基本操作。辅助操作则提供了对数据结构的访问和维护功能,但不直接改变结构状态。如获取树的高度或线性表的长度等。
3.1.2 操作的抽象性与封装性
操作的抽象性确保了数据结构能够独立于具体的数据实现,封装性则保证了操作的内部细节对外部隐藏。例如,在Java中,List接口定义了添加、删除、获取元素等操作,但具体如何实现这些操作则取决于List的实现类。
public interface List<E> {
    void add(E element);      // 插入操作
    E remove(int index);      // 删除操作
    E get(int index);         // 获取操作
    int size();               // 辅助操作:获取列表长度
}
在上述Java代码中, List 接口定义了数据结构操作,而这些操作的具体实现依赖于具体的 ArrayList 或 LinkedList 类。这样做的好处是,无论底层是如何存储和管理数据的,只要外部调用方式一致,就能保证程序的稳定性。
3.2 数据类型与抽象数据类型
3.2.1 数据类型的概念
数据类型是数据的分类,它定义了数据的取值范围和能够进行的操作。在编程中,基本数据类型包括整型、浮点型、字符型等,复杂数据类型则是由基本数据类型组合而成,如结构体、类等。
3.2.2 抽象数据类型的定义与实现
抽象数据类型(Abstract Data Type, ADT)是一种数据结构的抽象表示,它不仅包括数据类型的操作,还包括数据类型的属性。ADT的实现依赖于某种编程语言,但对用户来说,ADT是透明的,只需要知道如何使用它提供的接口。
class Stack:
    def __init__(self):
        self._items = []
    def push(self, item):
        """将元素压入栈顶"""
        self._items.append(item)
    def pop(self):
        """从栈顶移除元素"""
        return self._items.pop()

    def peek(self):
        """返回栈顶元素但不移除它"""
        return self._items[-1]

    def is_empty(self):
        """检查栈是否为空"""
        return len(self._items) == 0
以上是Python语言中栈(Stack)的ADT实现。通过封装操作,隐藏了数据结构的内部表示,只对外公开了接口,使我们可以利用栈的特性进行编程任务,而无需知道其内部实现细节。
通过第三章的介绍,我们已经理解了数据结构操作的定义和数据类型与抽象数据类型的概念。在接下来的章节中,我们将深入探讨线性结构的表示与操作,以及栈和队列在实际应用中的具体实例。
4. 线性结构讲解
线性结构是数据结构中最简单、最直观的一类,包括线性表、堆栈、队列等。它们的特点是元素之间存在着一对一的关系,可以看作是数据元素排成一列。理解线性结构的基本概念和操作是掌握更复杂数据结构的基础。
4.1 线性表的表示与操作
4.1.1 数组与链表的区别
数组和链表是最常见的线性结构。数组的物理存储是连续的,每个元素通过下标可以直接访问,时间复杂度为O(1)。但数组的大小在创建时就固定了,因此在动态变化的场合使用起来不太灵活。
链表的物理存储则是分散的,通过指针将各元素链接在一起。链表的大小可动态调整,但访问任一元素都需要从头开始遍历,时间复杂度为O(n)。
struct Array {
    int *arr;     // 指向连续存储空间的指针
    int size;     // 数组大小
    int capacity; // 容量
};

struct Node {
    int data;     // 数据域
    struct Node* next; // 指针域,指向下一个节点
};
数组适合频繁随机访问,而链表则更适合频繁的插入和删除操作。
4.1.2 堆栈的结构与操作
堆栈是一种特殊的线性表,其操作受到限制,只能在表的一端进行插入和删除,这一端称为栈顶,另一端称为栈底。堆栈的操作有“后进先出”(LIFO)的特性,因此它能够用于解决括号匹配、表达式求值等问题。
struct Stack {
    int top; // 栈顶指针
    int capacity; // 栈的容量
    int *array; // 存储空间
};

void push(struct Stack* s, int item) {
    if(s->top == s->capacity) {
        return; // 栈满,无法插入
    }
    s->array[++s->top] = item; // 元素入栈
}

int pop(struct Stack* s) {
    if(s->top == -1) {
        return -1; // 栈空,无法删除
    }
    return s->array[s->top--]; // 元素出栈
}
4.1.3 队列的特性与应用
队列是一种先进先出(FIFO)的线性表,它有两个操作端,一端为队尾(rear)用于插入数据,另一端为队首(front)用于删除数据。
队列可以用来模拟现实生活中排队的场景,如计算机系统中的进程调度、缓冲区管理等。
struct Queue {
    int front, rear, size;
    int capacity;
    int* array;
};

void enqueue(struct Queue* q, int value) {
    if(q->size == q->capacity) {
        return; // 队列满
    }
    q->rear = (q->rear + 1)%q->capacity;
    q->array[q->rear] = value;
    q->size = q->size + 1;
}

int dequeue(struct Queue* q) {
    if(q->size == 0) {
        return -1; // 队列空
    }
    q->front = (q->front + 1)%q->capacity;
    int value = q->array[q->front];
    q->size = q->size - 1;
    return value;
}
4.2 栈和队列的应用实例
4.2.1 表达式求值中的栈应用
表达式求值常使用两个栈,一个用于存储操作符,另一个用于存储操作数。当遇到操作符时,比较其优先级,根据优先级决定是将操作符压入栈还是从栈中弹出进行运算。
4.2.2 队列在任务调度中的应用
在操作系统中,队列用于实现进程调度。不同的进程按照到达时间或者优先级排队,调度器从队列中取出一个进程并为其分配CPU时间。这种策略被称为“先来先服务”(FCFS)。
下一章节将深入探讨二叉树及其在实际中的应用,包括二叉搜索树的构建、平衡树的原理以及树结构在算法设计中的核心应用。
5. 二叉树及其应用
5.1 二叉树的概念与性质
二叉树是一种重要的数据结构,具有节点最多有两个子树的特性,通常子树被称作“左子树”和“右子树”。它在算法设计和计算机科学中扮演了至关重要的角色,特别是在数据库索引、搜索算法等领域。
5.1.1 完全二叉树与满二叉树
满二叉树指的是除了叶子节点外,每个节点都具有两个子节点。而完全二叉树则对节点的添加顺序有要求:若一个二叉树的最后一层不满,则其所有节点都靠左排列。
5.1.2 二叉树的遍历算法
二叉树的遍历算法包括前序遍历、中序遍历和后序遍历。具体遍历顺序如下:
- 前序遍历:根节点 -> 左子树 -> 右子树
- 中序遍历:左子树 -> 根节点 -> 右子树
- 后序遍历:左子树 -> 右子树 -> 根节点
二叉树的遍历可以递归实现,也可以利用栈进行非递归实现。
5.2 二叉搜索树与平衡树
二叉搜索树(BST)是二叉树中的一种,具有有序的性质,即左子树中所有节点的值都小于其根节点的值,右子树中所有节点的值都大于其根节点的值。平衡二叉树(AVL)是一种自平衡的二叉搜索树,任何节点的两个子树的高度最大差别为1,从而保证了在增删查改操作中的高效性。
5.2.1 二叉搜索树的定义与特性
二叉搜索树能够保证在树的结构中查找效率较高,其结构使得每次查找都能够排除一半的可能位置,因此其平均时间复杂度为O(log n)。
5.2.2 平衡二叉树的原理与实现
平衡二叉树通过旋转操作来保持平衡状态。旋转分为四种:左旋、右旋、左右旋和右左旋。每种旋转都是为了减少某节点的左子树与右子树的高度差。
5.3 二叉树的算法应用
二叉树在数据结构中的应用非常广泛,尤其在决策过程中扮演着重要的角色。
5.3.1 最优二叉树的构建
最优二叉树又称哈夫曼树,是一种带权路径长度最短的树,通常用于数据压缩。构建最优二叉树的过程涉及多个步骤,包括统计各数据点的权重,然后根据权重构建二叉树。
5.3.2 二叉树在决策过程中的应用
在决策树中,二叉树可以用来表示问题的决策过程。每个内部节点代表一个属性上的判断,每个分支代表一个判断输出,每个叶节点代表一种分类结果。这种应用常见于机器学习中的分类问题。
graph TD;
    A[根节点] -->|属性A| B[分支1]
    A -->|属性B| C[分支2]
    B --> D[叶节点1]
    B --> E[叶节点2]
    C --> F[叶节点3]
    C --> G[叶节点4]
在上面的mermaid格式流程图中,我们可以看到一个决策树的简单示例,展示了根据属性进行决策的树状结构。
代码示例:构建一个简单的二叉树
class TreeNode:
    def __init__(self, value):
        self.value = value
        self.left = None
        self.right = None

def insert(root, value):
    if root is None:
        return TreeNode(value)
    else:
        if value < root.value:
            root.left = insert(root.left, value)
        else:
            root.right = insert(root.right, value)
    return root
以上代码块定义了一个二叉树节点类 TreeNode ,以及插入节点到二叉树中的 insert 函数。通过这个函数我们可以构建一个简单的二叉树,并且插入新的元素。
二叉树的概念和应用广泛,其在IT领域中的应用也非常多样化,例如在数据库索引、优先队列、数据压缩等方面都有其身影。通过本章节的介绍,希望读者能够掌握二叉树的构建、遍历、应用等基础知识,并在实践中深入探索。
6. 图结构与遍历方法
图是一种复杂的数据结构,它由节点(也称为顶点)和连接这些节点的边组成。在计算机科学中,图结构广泛应用于各种领域,如社交网络分析、地图导航、网络设计、数据组织等。本章将探讨图的基本概念、图的表示方法、图的遍历算法以及图的算法应用。
6.1 图的基本概念与表示
在图结构中,节点可以代表任何实体,而边则代表实体间的某种关系。图分为无向图和有向图,而节点间的连接可以有或没有权重。
6.1.1 图的定义与分类
图 G 可以定义为一个二元组 (V, E),其中 V 是顶点的有限集合,E 是无序对 (u, v) 的有限集合,称为边,表示顶点之间的连接。在有向图中,每条边都有一个方向,称为弧。
- 无向图 :如果图中的每条边都没有方向,则称为无向图。例如,两个人之间的电话通话记录可以表示为无向图,因为通话是双向的。
- 有向图 :如果图中的每条边都有方向,则称为有向图。例如,网页之间的链接关系可以表示为有向图,因为链接指向目标页面。
6.1.2 图的邻接矩阵与邻接表表示
图可以用不同的数据结构来表示。常用的表示方法包括邻接矩阵和邻接表。
- 邻接矩阵 :是一个二维数组,用来表示图中各个顶点之间的连接关系。对于无向图,邻接矩阵是对称的,即 A[i][j] = A[j][i]。对于有向图,邻接矩阵则不一定是对称的。
// 无向图的邻接矩阵示例
  A B C D
A 0 1 1 0
B 1 0 1 1
C 1 1 0 1
D 0 1 1 0
- 邻接表 :是一个顶点数组,每个顶点对应一个链表,链表中包含与该顶点相连的所有顶点。邻接表可以节省空间,特别是对于稀疏图。
graph LR
  A --> B
  A --> C
  B --> A
  B --> C
  B --> D
  C --> A
  C --> B
  C --> D
  D --> B
  D --> C
6.2 图的遍历算法
图的遍历是指从一个顶点出发,访问图中每个顶点且仅访问一次的过程。常见的图遍历算法有深度优先搜索(DFS)和广度优先搜索(BFS)。
6.2.1 深度优先搜索(DFS)
深度优先搜索(DFS)是一种用于遍历或搜索树或图的算法。该算法沿着图的分支进行深入,直到无法再深入为止,然后回溯并探索下一个分支。
def DFS(v, visited):
    # 标记当前顶点为已访问
    visited[v] = True
    print(v)
    # 遍历当前顶点的所有邻接顶点
    for i in adj_list[v]:
        if not visited[i]:
            DFS(i, visited)

# 邻接表表示的图
adj_list = {
    'A': ['B', 'C'],
    'B': ['A', 'D', 'E'],
    'C': ['A', 'F'],
    'D': ['B'],
    'E': ['B', 'F'],
    'F': ['C', 'E']
}

visited = {vertex: False for vertex in adj_list}
# 从顶点 A 开始深度优先搜索
DFS('A', visited)
6.2.2 广度优先搜索(BFS)
广度优先搜索(BFS)是一种从根节点开始,逐层向外扩展的算法,直到所有节点都被访问。
from collections import deque

def BFS(v, visited):
    queue = deque([v])
    visited[v] = True
    while queue:
        s = queue.popleft()
        print(s, end=' ')
        for i in adj_list[s]:
            if not visited[i]:
                queue.append(i)
                visited[i] = True

# 使用相同的邻接表和未访问状态的字典
BFS('A', visited)
6.3 图的算法应用
图结构算法在解决实际问题中有着广泛的应用,如最短路径、最小生成树、网络流、拓扑排序等。
6.3.1 最短路径问题
最短路径问题是图论中的经典问题,目标是在加权图中找到两个顶点之间的最短路径。Dijkstra算法是一种广泛使用的算法,用于解决具有非负权重的图的最短路径问题。
import sys

def Dijkstra(graph, start):
    # 初始化距离表,所有节点的距离都设置为无穷大
    distances = {vertex: float('infinity') for vertex in graph}
    # 起点到起点的距离为零
    distances[start] = 0
    # 用于记录路径的节点
    previous_nodes = {vertex: None for vertex in graph}
    # 需要处理的节点队列
    nodes = set(graph.keys())

    while nodes:
        # 选择距离最小的节点
        current_node = min(nodes, key=lambda node: distances[node])
        nodes.remove(current_node)
        # 遍历当前节点的所有邻接节点
        for neighbour, weight in graph[current_node].items():
            distance = distances[current_node] + weight
            # 如果找到更短的路径,则更新
            if distance < distances[neighbour]:
                distances[neighbour] = distance
                previous_nodes[neighbour] = current_node

    return distances, previous_nodes

# 示例图
graph = {
    'A': {'B': 1, 'C': 4},
    'B': {'A': 1, 'C': 2, 'D': 5},
    'C': {'A': 4, 'B': 2, 'D': 1},
    'D': {'B': 5, 'C': 1}
}

distances, previous_nodes = Dijkstra(graph, 'A')
print(distances)
print(previous_nodes)
6.3.2 关键路径与拓扑排序
在有向图中,关键路径是指在一个项目计划网络图中,从起点到终点的最长路径。这条路径上的任何活动的延迟都会导致整个项目的延迟。拓扑排序是对有向图的一种排序,使得对于任何一条从顶点 U 到顶点 V 的边 U->V,U 在排序中都出现在 V 之前。
from collections import deque

def topological_sort(graph):
    indegree = {u: 0 for u in graph}  # 所有顶点的入度初始化为0
    for u in graph:
        for v in graph[u]:
            indegree[v] += 1

    queue = deque([k for k in indegree if indegree[k] == 0])  # 所有入度为0的顶点入队列
    top_order = []  # 存储拓扑排序的结果

    while queue:
        u = queue.popleft()
        top_order.append(u)  # 出队列的顶点加入到拓扑排序的结果中
        for v in graph[u]:
            indegree[v] -= 1  # 出队列顶点的邻接点的入度减1
            if indegree[v] == 0:  # 若减1后入度为0,则入队列
                queue.append(v)

    return top_order if len(top_order) == len(graph) else "图存在环,无法进行拓扑排序"

# 示例图
graph = {
    'A': ['B', 'C'],
    'B': ['D'],
    'C': ['D', 'E'],
    'D': ['F'],
    'E': ['F'],
    'F': []
}

print(topological_sort(graph))
图结构和遍历方法对于处理复杂关系和路径分析至关重要,它们为各种算法提供了一种强大的框架,可以在多个行业和领域中找到应用。
7. 集合数据结构、排序和查找算法、动态规划与贪心算法
集合数据结构、排序和查找算法、动态规划与贪心算法是数据结构与算法领域中关键的核心概念。它们不仅在计算机科学理论中占据重要位置,而且在实际应用中也扮演着至关重要的角色。本章节将深入探讨这些概念,从实现到应用层面,为大家提供全面的理解和实用知识。
7.1 集合数据结构的实现
集合数据结构是存储唯一元素的集合,允许进行如并集、交集、差集等操作。集合操作的封装是实现这一数据结构的关键。
7.1.1 集合操作的封装
集合操作的封装需要定义好基础的操作方法,如:
-
add(item): 添加一个元素到集合中。 -
remove(item): 从集合中移除一个元素。 -
contains(item): 判断集合中是否存在该元素。 -
union(set): 并集操作,返回包含两个集合中所有元素的新集合。 -
intersection(set): 交集操作,返回同时属于两个集合的元素组成的集合。 -
difference(set): 差集操作,返回属于第一个集合但不属于第二个集合的元素组成的集合。
7.1.2 布尔运算在集合中的应用
布尔运算是集合操作的重要组成部分,主要包括并、交、差三种运算。这些运算的符号和含义如下:
-
|: 表示并集运算。 -
&: 表示交集运算。 -
-: 表示差集运算。
假设我们有两个集合A和B:
-
A | B将会产生包含A中所有元素和B中所有元素(不重复)的集合。 -
A & B将会产生一个只包含A和B共有的元素的集合。 -
A - B将会产生一个只包含在A中但不在B中的元素的集合。
在编码实现时,可以利用已有的数据结构,如Python中的 set 数据类型,来直观地表示这些操作。
A = set([1, 2, 3, 4])
B = set([3, 4, 5, 6])

print(A | B)  # 输出并集
print(A & B)  # 输出交集
print(A - B)  # 输出差集
布尔运算是很多数据处理和分析问题的基石,理解并熟练运用这些基础操作,是处理更复杂数据结构和算法的前提。
7.2 排序算法的原理与实现
排序算法是将一组数据按照特定顺序重新排列的过程。本节将讨论几种常见排序算法,并进行比较。
7.2.1 常见的排序算法比较
常见的排序算法包括:
- 冒泡排序:通过比较相邻元素的大小并交换顺序,进行多轮排序直到没有需要交换的元素。
- 选择排序:在每一轮中选出最小(或最大)的元素,放到已排序序列的末尾。
- 插入排序:构建有序序列,对于未排序数据,在已排序序列中从后向前扫描,找到相应位置并插入。
- 快速排序:通过一趟排序将待排记录分隔成独立的两部分,其中一部分记录的关键字均比另一部分的关键字小,然后分别对这两部分记录继续进行排序,以达到整个序列有序。
- 归并排序:采用分治法的一个典型应用。将已有序的子序列合并,得到完全有序的序列。
这些排序算法各自有其特点和适用场景。例如,冒泡排序和插入排序简单易懂但效率较低,适用于小规模数据;快速排序和归并排序效率高,适用于大规模数据。
7.2.2 排序算法的时间复杂度分析
时间复杂度是排序算法效率的重要指标。下面是几种常见排序算法的平均时间复杂度比较:
- 冒泡排序:O(n^2)
- 选择排序:O(n^2)
- 插入排序:O(n^2)
- 快速排序:O(nlogn)
- 归并排序:O(nlogn)
快速排序和归并排序由于其较好的时间复杂度,成为处理大数据量时的首选算法。对于快速排序来说,其性能依赖于分区操作,而在最坏情况下其时间复杂度也会退化到O(n^2),但这种情况较为少见。
7.3 查找算法的分类与应用
查找算法用于从给定的数据集合中找到特定的数据项。按照是否涉及数据结构的不同,查找算法主要分为静态查找和动态查找。
7.3.1 静态查找表的实现
静态查找表只进行查找操作。最简单的实现方式是使用顺序存储结构,如数组。对于一个有序数组,可以使用二分查找算法来提高查找效率。
7.3.2 动态查找表与平衡查找树
动态查找表不仅支持查找操作,还支持插入和删除操作。平衡查找树如AVL树和红黑树是支持动态查找操作的重要数据结构。它们通过旋转和平衡操作保持树的平衡状态,从而保证了查找、插入和删除操作的时间复杂度为O(logn)。
7.4 动态规划与贪心算法
动态规划和贪心算法是解决优化问题的两种重要策略。它们在决策过程中的应用广泛,可以用于求解最优化问题。
7.4.1 动态规划的基本思想
动态规划是通过把原问题分解为相对简单的子问题的方式来求解复杂问题的方法。它将每个子问题的解保存起来,当该子问题再次被需要时,直接查表获得解而不再重新计算,从而避免了大量重复计算。
7.4.2 贪心算法的适用场景与局限性
贪心算法在每一步选择中都采取在当前状态下最好或最优的选择,从而希望导致结果是最好或最优的算法。贪心算法的适用场景是问题的最优子结构特性,即局部最优解能决定全局最优解的情况。但是,贪心算法并不适用于所有情况,因为它不考虑全局最优解,所以只在特定问题上有效。
7.4.3 实际问题中的动态规划与贪心策略
在实际问题中,如背包问题,动态规划能够给出最优解,因为背包问题具有最优子结构和重叠子问题的特点。贪心算法则可能无法达到最优解。例如,著名的0-1背包问题,贪心策略通常不能获得整体的最优解。
在解决实际问题时,我们应根据问题的性质选择合适的方法。在问题可以分解为独立子问题时,可以考虑动态规划;而当问题具备贪心选择性质时,则应优先选择贪心算法。
通过本章的探讨,我们了解了集合数据结构的实现、排序算法的原理与实现、查找算法的分类与应用,以及动态规划与贪心算法在实际问题中的应用。这些知识为解决各种复杂的数据结构与算法问题提供了坚实的基础。
简介:数据结构是计算机科学的核心课程,它涉及数据的存储、组织和操作,以便高效地进行数据检索和管理。本PPT课件详细介绍了数据结构的基础概念、关键类型及其应用,并通过图解和实例使学习者更易理解。内容包括数据结构的基本概念、线性结构、树形结构、图结构、集合数据结构、排序和查找算法以及优化策略。学生将通过课件中的深入讲解来掌握数据结构的核心知识。
更多推荐


 22
 0
- 0


 已为社区贡献12条内容

所有评论(0)