
【Python时序预测系列】建立Transformer 与小波变换融合模型实现单变量时序预测(案例+源码)
这是我的第423篇原创文章。
一、引言
Transformer 与小波变换的融合方法
-
对原始时间序列X[n]做小波分解,得到不同频率分量;
-
将多个分量作为多通道输入送入 Transformer;
-
Transformer 学习各频段之间的时序关系。
利用小波提取“频率特征”,再通过 Transformer 提取“序列依赖”,或在注意力机制中引入小波思想,使模型更加适用于复杂的时间序列预测任务。
二、实现过程
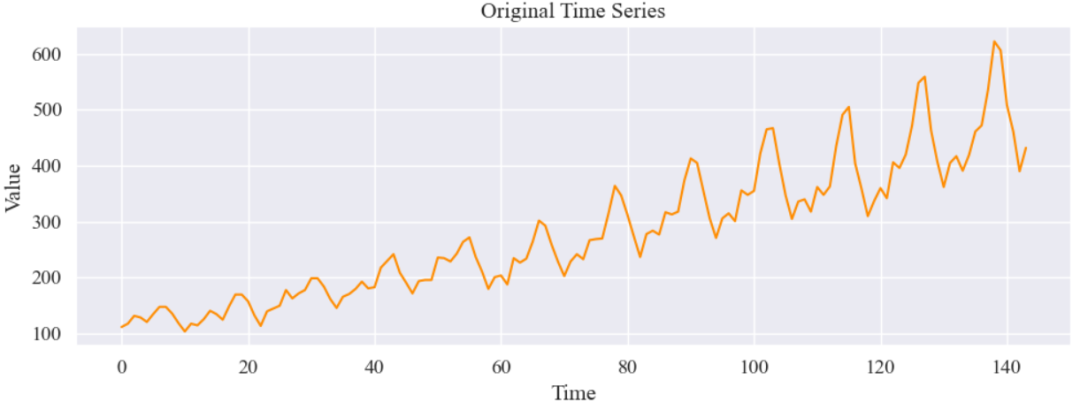
2.1 数据读取
核心代码:
data = pd.read_csv('data.csv')
# 将日期列转换为日期时间类型
data['Month'] = pd.to_datetime(data['Month'])
# 将日期列设置为索引
data.set_index('Month', inplace=True)
data = np.array(data['Passengers'])
T = len(data)
x = np.arange(len(data))
# 可视化:原始时间序列
plt.figure(figsize=(10, 4))
plt.plot(x, data, color='darkorange')
plt.title('Original Time Series')
plt.xlabel('Time')
plt.ylabel('Value')
plt.grid(True)
plt.tight_layout()
plt.show()
结果:
2.2 小波分解与标准化处理
核心代码:
wavelet = 'db4'
coeffs = pywt.wavedec(data, wavelet, level=2)
a2, d2, d1 = coeffs
# 重构原始信号
low_freq  = pywt.waverec([a2, np.zeros_like(d2), np.zeros_like(d1)], wavelet)
mid_freq  = pywt.waverec([np.zeros_like(a2), d2, np.zeros_like(d1)], wavelet)
high_freq = pywt.waverec([np.zeros_like(a2), np.zeros_like(d2), d1], wavelet)
print(low_freq.shape, mid_freq.shape, high_freq.shape)
# 统一长度
min_len = min(len(low_freq), T)
components = np.stack([low_freq[:min_len], mid_freq[:min_len], high_freq[:min_len]], axis=1)
# 标准化
scaler = MinMaxScaler()
components_scaled = scaler.fit_transform(components)
target = data[1:1+min_len]  # 滞后2步预测,避免数据泄露
采用Daubechies-4(db4)小波函数对原始数据进行2层分解,提取出低频(趋势)、中频(周期)和高频(噪声)三类信息。每个频率成分经过重构并对齐,统一组成三维输入特征,再利用MinMaxScaler将数据缩放到[0, 1]范围,防止模型训练不稳定。
三个频率成分的曲线变化:低频平稳、中频有节奏变化、高频震荡剧烈,体现数据中蕴含的多尺度特征。
2.3 构造PyTorch数据集
核心代码:
window_size = 7
offset = 1
dataset = TimeSeriesDataset(X_all, y_all, window_size)
train_size = int(len(dataset) * 0.8)
train_dataset, test_dataset = torch.utils.data.random_split(dataset, [train_size, len(dataset) - train_size])
train_loader = DataLoader(train_dataset, batch_size=32, shuffle=True)
test_loader = DataLoader(test_dataset, batch_size=32)
2.4 Transformer 模型设计
核心代码:
class WaveletTransformer(nn.Module):
    def __init__(self, input_dim, d_model=64, nhead=4, num_layers=2):
        super().__init__()
        self.linear_in = nn.Linear(input_dim, d_model)
        encoder_layer = nn.TransformerEncoderLayer(d_model=d_model, nhead=nhead, batch_first=True)
        self.transformer = nn.TransformerEncoder(encoder_layer, num_layers=num_layers)
        self.decoder = nn.Sequential(
            nn.Linear(d_model, 32),
            nn.ReLU(),
            nn.Linear(32, 1)
        )
    def forward(self, x):
        x = self.linear_in(x)
        x = self.transformer(x)
        x = x[:, -1, :]
        out = self.decoder(x).squeeze(-1)
        return out
model = WaveletTransformer(input_dim=3)
构建了一个包含两个编码器层的Transformer模型,输入为三维(代表三个频段)的时间序列。模型结构包含:线性映射、Transformer 编码器(多头注意力)、以及一个回归解码器,用于预测下一个时间点的真实值。
2.5 模型训练与损失分析
核心代码:
criterion = nn.MSELoss()
optimizer = optim.Adam(model.parameters(), lr=0.001)
epochs = 500
train_losses = []
test_losses = []
for epoch in range(epochs):
    model.train()
    total_loss = 0
    for X_batch, y_batch in train_loader:
        optimizer.zero_grad()
        output = model(X_batch)
        loss = criterion(output, y_batch)
        loss.backward()
        optimizer.step()
        total_loss += loss.item()
    train_losses.append(total_loss / len(train_loader))
    model.eval()
    with torch.no_grad():
        test_loss = sum(criterion(model(X), y).item() for X, y in test_loader) / len(test_loader)
        test_losses.append(test_loss)
使用均方误差(MSE)作为损失函数,Adam优化器进行500轮训练。
plt.figure(figsize=(8, 4))
plt.plot(train_losses, label='Train Loss', color='royalblue')
plt.plot(test_losses, label='Test Loss', color='tomato')
plt.title('Loss Curve')
plt.xlabel('Epoch')
plt.ylabel('MSE')
plt.legend()
plt.grid(True)
plt.tight_layout()
plt.show()
结果

训练过程可视化图像显示训练集与测试集的损失随轮数的变化曲线,两者都趋于收敛,表明模型稳定、无明显过拟合。
2.6 预测结果分析与可视化
核心代码:
使用测试集进行模型推理,获得真实值与预测值的对比。
model.eval()
preds = []
y_true = []
with torch.no_grad():
    for X, y in test_loader:
        pred = model(X)
        preds.extend(pred.numpy())
        y_true.extend(y.numpy())
预测效果图清晰展示模型对未来值的预测能力,预测曲线基本贴合真实曲线,说明模型提取了有效特征。
plt.figure(figsize=(10, 4))
plt.plot(y_true, label='True', color='green')
plt.plot(preds, label='Predicted', color='purple')
plt.title('Prediction vs Ground Truth')
plt.xlabel('Sample Index')
plt.ylabel('Value')
plt.legend()
plt.tight_layout()
plt.show()
结果:

三个频率成分的曲线变化:低频平稳、中频有节奏变化、高频震荡剧烈,体现数据中蕴含的多尺度特征。
plt.figure(figsize=(10, 6))
plt.subplot(3, 1, 1)
plt.plot(components[:min_len, 0], color='blue')
plt.title('Low Frequency Component')
plt.subplot(3, 1, 2)
plt.plot(components[:min_len, 1], color='orange')
plt.title('Mid Frequency Component')
plt.subplot(3, 1, 3)
plt.plot(components[:min_len, 2], color='red')
plt.title('High Frequency Component')
plt.tight_layout()
plt.show()
结果:

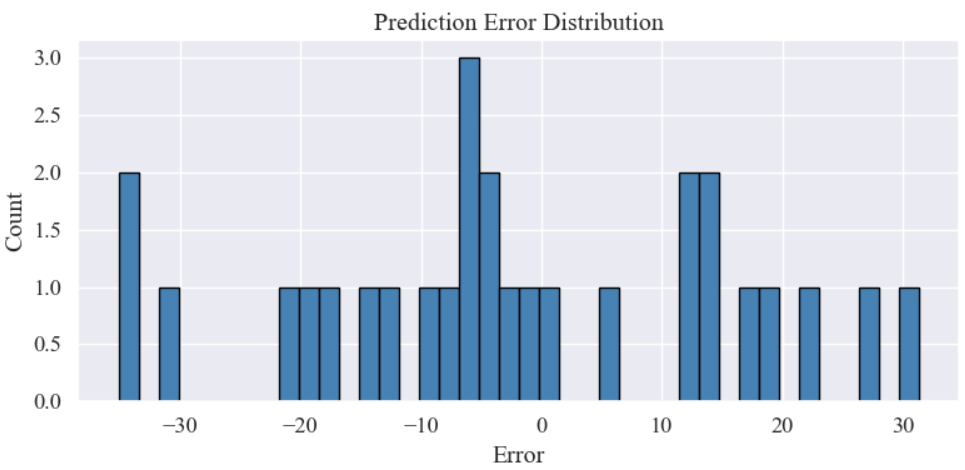
预测误差分布图:
errors = np.array(preds) - np.array(y_true)
plt.figure(figsize=(8, 4))
plt.hist(errors, bins=40, color='steelblue', edgecolor='black')
plt.title('Prediction Error Distribution')
plt.xlabel('Error')
plt.ylabel('Count')
plt.grid(True)
plt.tight_layout()
plt.show()
结果:
作者简介:
读研期间发表6篇SCI数据挖掘相关论文,现在某研究院从事数据算法相关科研工作,结合自身科研实践经历不定期分享关于Python、机器学习、深度学习、人工智能系列基础知识与应用案例。致力于只做原创,以最简单的方式理解和学习,关注我一起交流成长。需要数据集和源码的小伙伴可以关注底部公众号添加作者微信。
更多推荐


 11
 0
- 0


 已为社区贡献9条内容

所有评论(0)