
API 接口自动化
目录
urllib.parse.urlparse urlunparse
urllib.parse.parse_qs urllib.parse.parse_qsl
urllib.parse.urlsplit urllib.parse.urlunsplit
HTTP协议 - 白月黑羽
HTTP协议简介
如果客户端是浏览器,如何在chrome浏览器中查看 请求和响应的HTTP消息?按f12-》network


清除当前信息

响应的消息体在Response里看

点preview,可以看响应的消息体展开的格式

HTTP请求消息
请求头 request headers
请求头(Request Header)是啥?
当你访问一个接口/网站时,可以简单理解成你在给对方寄一封信:
-
请求行:我想 “干啥”(比如:GET / POST 哪个地址)
-
请求头(Header):一些“信封上的说明”,比如:
-
我是谁(User-Agent)
-
我发的是什么格式(Content-Type)
-
我带了什么身份信息(Authorization(授权))
-
Authorization 是啥?
Authorization 是请求头中的一个字段名,意思是“授权信息”“凭证”。


“认证方式 = 告诉服务器:后面这串凭证应该用哪种规则来理解。”

就会说:
这是 Bearer 令牌,那我就把后面这串按 Bearer 方式验证


在 Authorization: Bearer ... 里,Bearer 后面那一串东西,通常就是一个 token,而这个 token 往往采用 JWT 这种格式。
token 是什么?
服务器发给你的“临时身份证 / 通行证”

提供信息给服务端
User-Agent:
客户端的类型。客户端不一定是浏览器。客户端和服务端(HTTP协议)不仅是浏览器和服务器之间,任何两个软件之间都可以使用HTTP协议。
Accept-Language
客户端希望服务端使用中文
请求体 /消息体

状态行 status line
以前的url 可能是a/b/c,后面可能变成了a/b/d,当再用以前的url访问时,就会返回3XX,代表重定向,相应的响应消息头里会告诉新的url是哪一个
抓包工具 fiddler
只有url中包含customer才显示

requests库 和 session
构建请求URL参数

URL 参数的结构是 key=value&key2=value2,
里面的值 该编码的地方(中文、空格、特殊符号)会按 urlencoded 规则编码


response = requests.get('https://www.baidu.com/s',params=urlpara)
params 会自动按 urlencoded 规则编码到 URL 后面,作为url参数


构建请求消息体
将要发送的网址加到fiddler

xml消息体
Requests库的post方法,参数data指明了,消息体中的数据是什么。
如果传入的是字符串类型,Requests 会使用缺省编码 latin-1 编码为字节串放到http消息体中,发送出去。
而上面的例子里面包含中文,不能用缺省 latin-1编码.
所以我们将字符串对象,用 utf8 编码为字节串对象Bytes 传入给data参数,Requests就会直接把这个字符串放到 http消息体中,发送出去。
urlencoded 格式消息体
和前面的url参数的格式是一样的,都是键值对&隔开,唯一的不同就是,现在是请求体
如果data中放的不是字符串 也不是字节串,而是一个字典,那么resquest库那么就知道这个消息体的格式是urlencoded的格式。会按照urlencoded进行编码

json 格式消息体
dumps把python中的对象序列化为json格式的字符串
dumps会把 中文会变成对应的unicode。
json.dumps() 默认的行为是用 unicode-escape 这种编码形式来表示非 ASCII 字符。
data=json.dumps(payload)吧python对象序列化为json格式的字符串,没有对字符串进行编码,那么就会采用缺省的.latin-1 编码.由于已经把中文变成unicode了,所以不会报错
import requests,json

payload = {
    "Overall":"良好",
    "Progress":"30%",
    "Problems":[
        {
            "No" : 1,
            "desc": "问题1...."
        },
        {
            "No" : 2,
            "desc": "问题2...."
        },
    ]
}

r = requests.post("http://httpbin.org/post", data=json.dumps(payload))
中文会变成对应的unicode

如果不想中文变成对应的unicode,可以 写成
data=json.dumps(payload, ensure_ascii=False) 这个就是直接包含中文字符的字符串。
但是这样的话,字符串带有中文,编码方式就得是utff8了,不然ascill码不够用,不能用缺省的latin-1 编码(有中文使用这个会报错)
data=json.dumps(payload, ensure_ascii=False).encode("utf-8")。
dumps把python中的对象序列化为json格式的字符串
loads把json格式的字符串反序列化为python中的对象

这样写有点麻烦
也可以将 数据对象 直接 传递给post方法的 json参数(json=payload 会让 requests:先把 payload用 json.dumps(payload) 变成 JSON 字符串,而dumps默认是用 unicode-escape 这种编码形式来表示非 ASCII 字符,所以中文是对应的unicode),如下
r = requests.post("http://httpbin.org/post", json=payload)虽然中文变成对应的unicode但是接收端会处理

检查响应消息体
发出去的是字节串,接收的原始消息也是字节串
text获取文本内容,也就是字符串。从字节串到字符串意味着其中有一个解码的过程。
那么,requests是 以什么编码格式 把HTTP响应消息体中的 字节串 解码 为 字符串的呢?
requests 会根据响应消息头(比如 Content-Type)对编码格式做推测。
但是有时候,服务端并不一定会在消息头中指定编码格式,这时, requests的推测可能有误(打印 response.encoding 可以看到推测的解码方式),需要我们指定编码格式。
url编码(urlencoded)
什么是url?(好文)
url编码:
URL 中不允许直接包含空格、中文和某些特殊符号(比如 #, ?, & 等)——这是 URL 标准规定的。
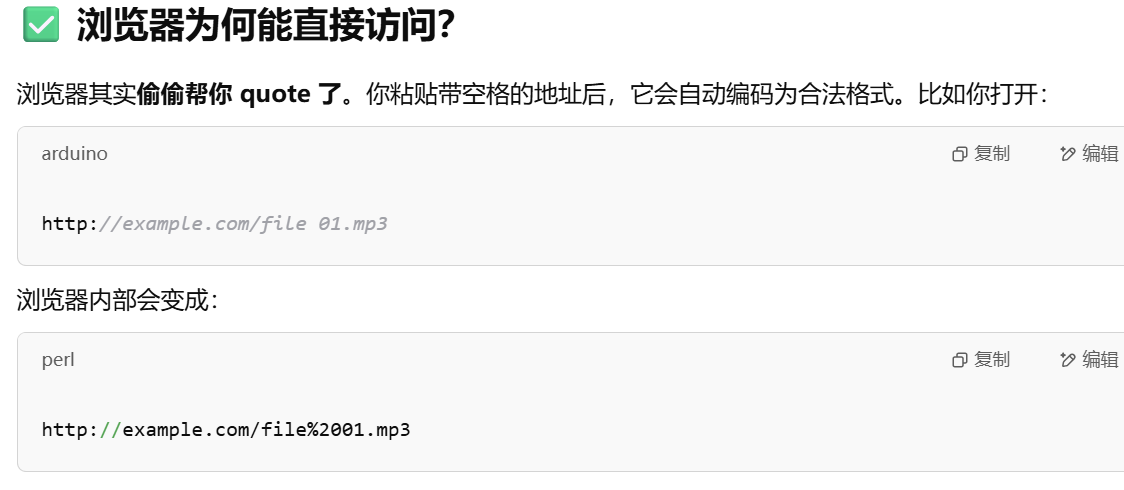
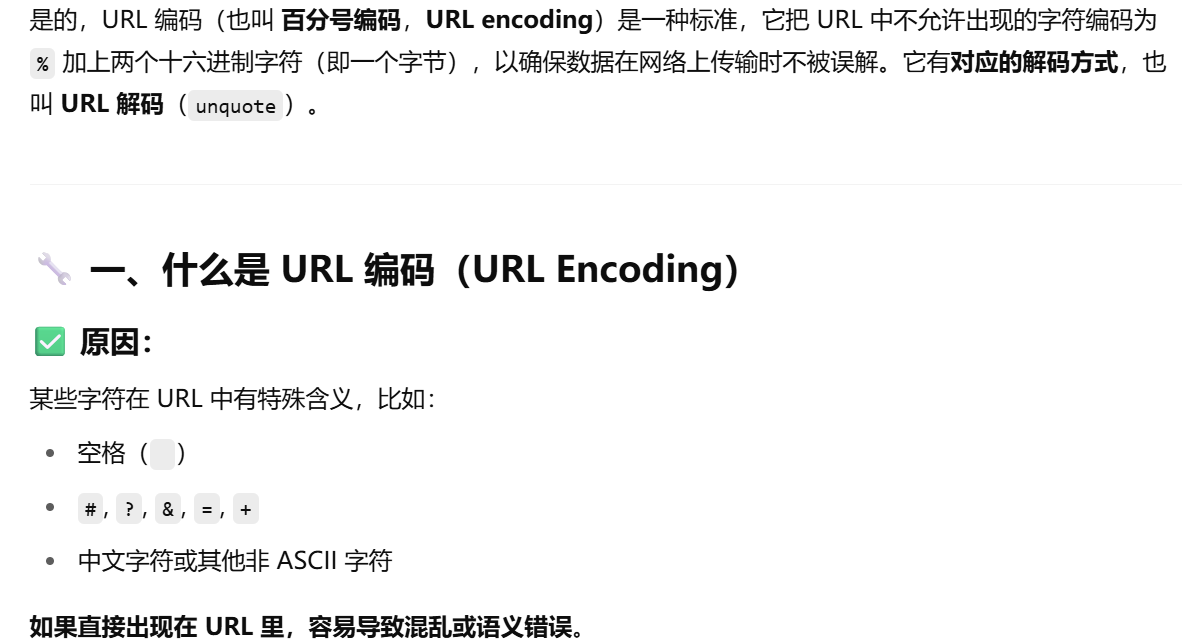 常见字符的 URL 编码
| 字符 | 编码 | 说明 |
|---|---|---|
| 空格 | %20 | 或者有时是 + |
" | %22 | 双引号 |
# | %23 | URL 锚点标识 |
% | %25 | 百分号自身 |
& | %26 | 参数分隔符 |
/ | %2F | 路径分隔符(一般不编码) |
中 | %E4%B8%AD | 中文 UTF-8 编码后 |
Web开发须知:URL编码与解码 - 刘哥聊技术 - 博客园
Python 中编码/解码方法
可以使用标准库 urllib.parse中的quote quote_plus urlencode 对url进行编码
urlencode 对字典或由两元素元组组成的列表进行码编码,将其转换为符合url规范的查询字符串。
quote() 只能对字符串编码,而 urlencode() 可以直接对查询字符串字典进行编码。
python中quote函数是什么意思,怎么用 – PingCode
python 中 quote 与 urlencode 的用法与区别_quoteurl-CSDN博客
python爬虫学习3:urllib.parse中urlencode(),quote()_urllib.parse.quote-CSDN博客
urllib.parse 用于解析 URL — Python 3.11.12 文档
urllib.parse.urlparse urlunparse
import urllib.parse

# 解析url,返回包含url信息的6元元组
url = "https://docs.python.org/3/library/urllib.parse.html#module-urllib.parse"
res = urllib.parse.urlparse(url)
print(res)
print(res.scheme)
print(res.netloc)
print(res.path)
print(res.params)
print(res.query)
print(res.fragment)
"""
ParseResult(scheme='https', netloc='docs.python.org', path='/3/library/urllib.parse.html', params='', query='', fragment='module-urllib.parse')
https
docs.python.org
/3/library/urllib.parse.html


module-urllib.parse
"""
# 从任意包含6元素的可迭代数据结构中构造url字符串并返回
url = urllib.parse.urlunparse(["http", "www.baidu.com", "index", "", "", ""])
print(url)  # http://www.baidu.com/index

url = urllib.parse.urlunparse(res)
print(url)
# https://docs.python.org/3/library/urllib.parse.html#module-urllib.parse
urllib.parse.parse_qs urllib.parse.parse_qsl
import urllib.parse

# url编码,第一个参数为dict,常用来处理url参数
params = {"key1": "编程", "key2": "写作"}
q = urllib.parse.urlencode(params)
print(q)
# key1=%E7%BC%96%E7%A8%8B&key2=%E5%86%99%E4%BD%9C
# url解码,返回字典,与urlencode()相反
params = urllib.parse.parse_qs(q)
print(params)
# {'key1': ['编程'], 'key2': ['写作']}
# 与parse_qs()唯一的不同是返回列表
params = urllib.parse.parse_qsl(q)
print(params)
# [('key1', '编程'), ('key2', '写作')]
urllib.parse.urlsplit urllib.parse.urlunsplit
## urlsplit() 和urlparse()用法一样,只不过返回结果中没有params这个属性.params合并到paths中
使用urllib的parse模块。(4个重要方法)_urllib.parse 用法-CSDN博客
import urllib.parse

# 分割url,返回包含url的元组,可用来替代urlparse()
url = "https://docs.python.org/3/library/urllib.parse.html#module-urllib.parse"
res = urllib.parse.urlsplit(url)
print(res)
# SplitResult(scheme='https', netloc='docs.python.org', path='/3/library/urllib.parse.html', query='', fragment='module-urllib.parse')
# 从任意包含5元素的可迭代数据结构中构造url字符串并返回,可用来替代urlunparse()
url = urllib.parse.urlunsplit(["http", "x.org", "index.html", "", ""])
print(url)
# http://x.org/index.html
urllib.parse.urljoin
Python拼接URL:urllib.parse urljoin使用 - 林风网络
python3 urllib.parse.urljoin()用法_from urlparse import urljoin-CSDN博客
session 服务器用来记住某个客户是谁的机制


session和cookie区别
cookie:
cookie讲解


更多推荐


 12
 0
- 0


 已为社区贡献2条内容

所有评论(0)