
hadoop3.x版本集群部署(万字整理详细图文版)
本篇为hadoop3.x版本的集群部署过程,涵盖从环境搭建、hadoop集群NameNode、DataNone、Secondary NameNode、ResourceManager、JobHistory、HDFS、Yarn的组件服务配置等步骤,其中搭建过程参考尚硅谷的部署资料。
环境准备:Linux服务器3台,系统版本:centos7.5,IP:192.168.216.100、192.168.216.101、192.168.216.102。JDK版本:jdk1.8.0_212Hadoop版本:3.1.3。
1.1.集群环境配置
1、关闭防火墙,避免后面因防火墙问题导致端口范围不通。
systemctl stop firewalld
systemctl disable firewalld
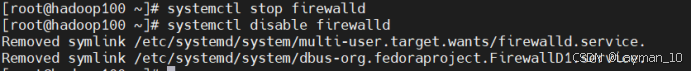
2、创建个用户,赋予sudo权限,后期使用该账号进行安装
useradd newbie
passwd newbie
vim /etc/sudoers
// newbie这一行不要直接放到root行下面,因为所有用户都属于wheel组,先配置了newbie具有免密功能,但是程序执行到%wheel行时,该功能又被覆盖回需要密码。所以newbie要放到%wheel这行下面。
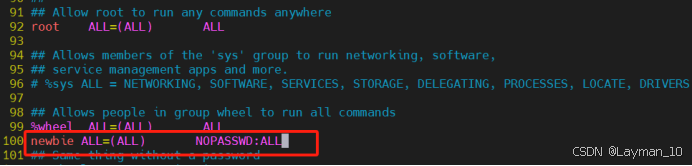
3、创建安装目录,并修改目前的所属主和所属组,后面jdk和hadoop都安装在此目录下
mkdir /opt/module
chown newbie:newbie /opt/module
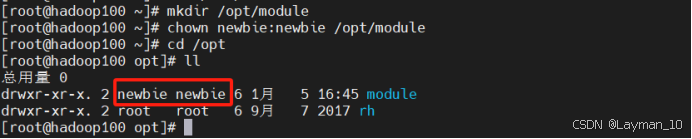
4、卸载虚拟机自带的JDK
rpm -qa | grep -i java | xargs -n1 rpm -e --nodeps
# rpm -qa:查询所安装的所有rpm软件包
# grep -i:忽略大小写
# xargs -n1:表示每次只传递一个参数
# rpm -e --nodeps:强制卸载软件
5、克隆虚拟机,将已完成上述配置的虚拟机关键,克隆两台
“虚拟机—>管理—>克隆”
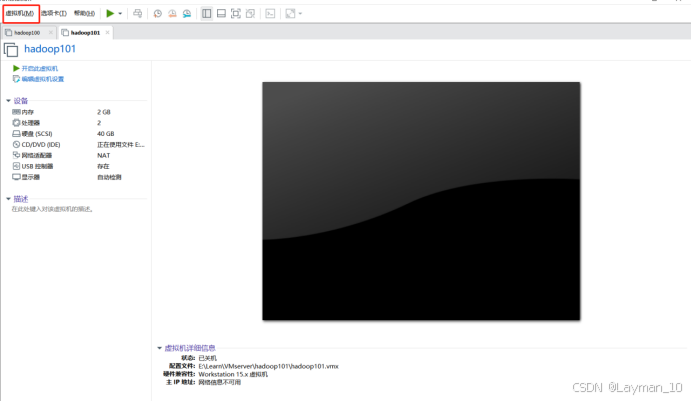
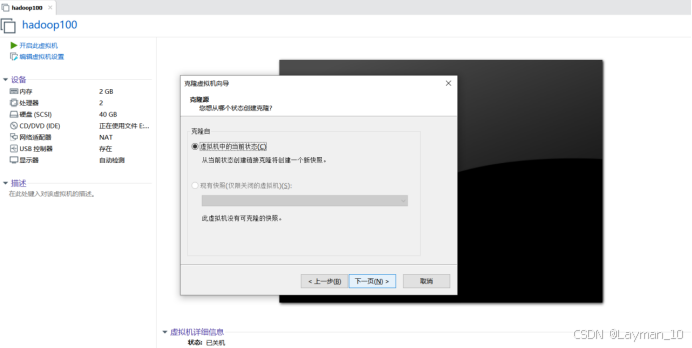
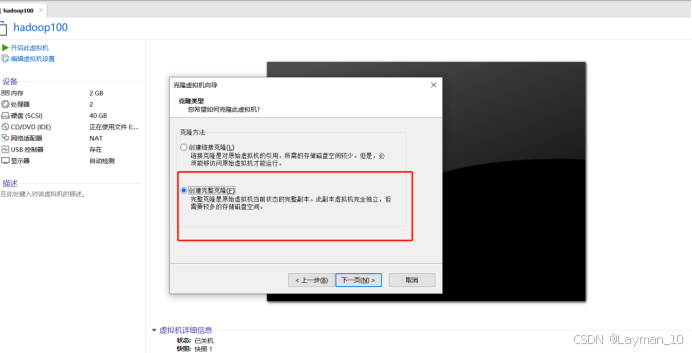
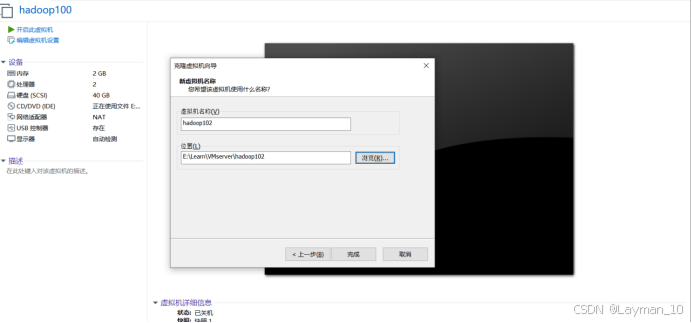
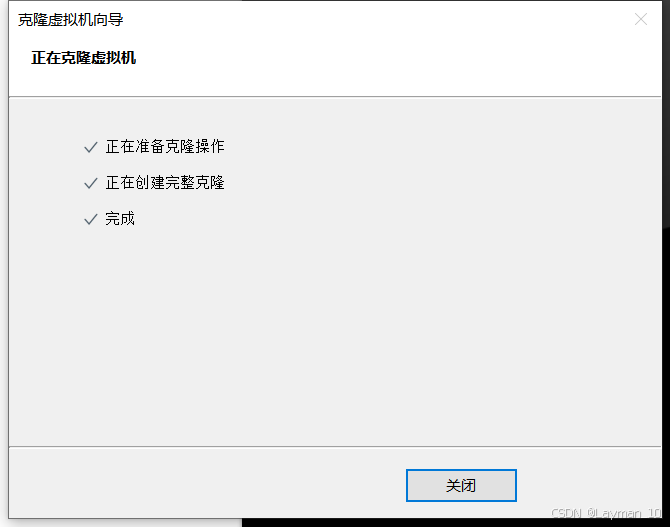
6、分别打开克隆的两台服务,更改IP,这里是克隆100那台主机,所以其他更改为.101、102。
1.2.环境准备在100上安装JDK
1、上传安装包到/tmp目录
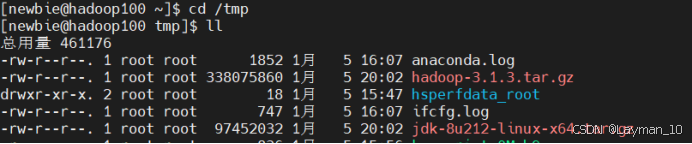
2、解压到/opt/module,并查看是否解压成功
tar -zxvf jdk-8u212-linux-x64.tar.gz -C /opt/module/

3、配置JDK环境变量
新建/etc/profile.d/my_env.sh文件(/etc/profile和/etc/profile.d/两个文件都是设置环境变量文件的,/etc/profile.d/比/etc/profile好维护,不想要什么变量直接删除/etc/profile.d/下对应的shell脚本即可,不用像/etc/profile改动文件。)
sudo vim /etc/profile.d/my_env.sh
#JAVA_HOME
export JAVA_HOME=/opt/module/jdk1.8.0_212
export PATH=$PATH:$JAVA_HOME/bin
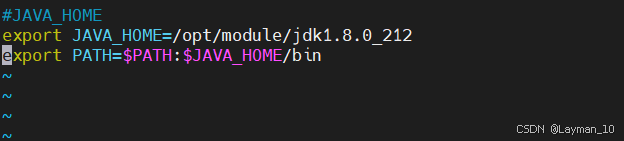
记得每次配置环境变量后要刷新
source /etc/profile
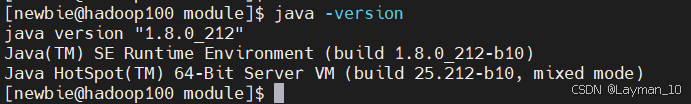
4、测试JDK是否安装成功
java -version
1.3.环境准备在100上安装Hadoop
Hadoop下载地址:https://archive.apache.org/dist/hadoop/common/hadoop-3.1.3/
可以下载对应的版本
1、然后上传到Linux上(/tmp)
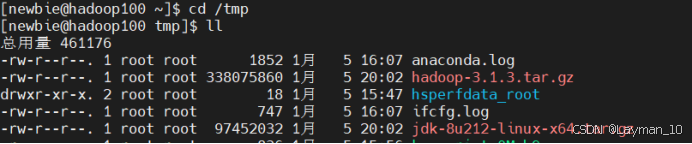
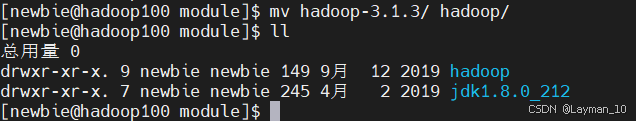
2、解压到/opt/module,并查看是否解压成功,更改hadoop-3.1.3为hadoop(改不改都行),这里因为习惯和便于直观,就更改了
tar -zxvf hadoop-3.1.3.tar.gz -C /opt/module/
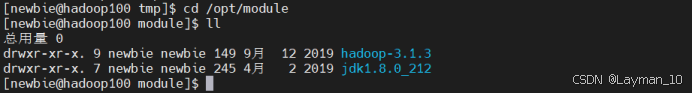
mv hadoop-3.1.3/ hadoop/
3、配置hadoop环境变量
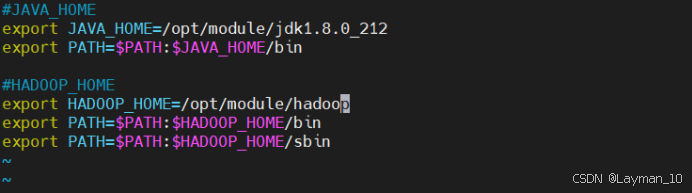
将hadoop的路径加入到环境变量,并使其生效
sudo vim /etc/profile.d/my_env.sh
#HADOOP_HOME
export HADOOP_HOME=/opt/module/hadoop
export PATH=$PATH:$HADOOP_HOME/bin
export PATH=$PATH:$HADOOP_HOME/sbin
source /etc/profile
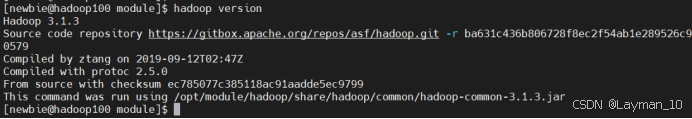
4、测试hadoop是否安装成功,并查看hadoop目录
hadoop version
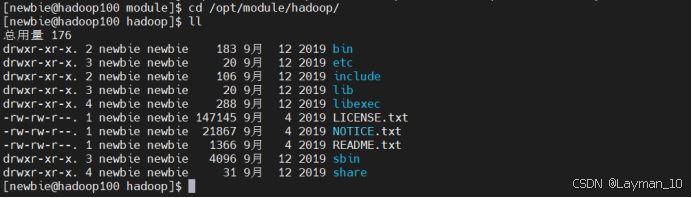
5、hadoop重要目录简述
(1)bin目录:存放对Hadoop相关服务(hdfs,yarn,mapred)进行操作的脚本
(2)etc目录:Hadoop的配置文件目录,存放Hadoop的配置文件
(3)lib目录:存放Hadoop的本地库(对数据进行压缩解压缩功能)
(4)sbin目录:存放启动或停止Hadoop相关服务的脚本
(5)share目录:存放Hadoop的依赖jar包、文档、和官方案例
1.4.环境准备
将三台主机更改好主机名称hostname,便于后期配置及部署
1、更改克隆两台主机的hostname和hosts为hadoop101、hadoop102
vim /etc/hostname
sudo vim /etc/hosts
192.168.216.100 hadoop100
192.168.216.101 hadoop101
192.168.216.102 hadoop102

然后reboot重启系统
2、将JDK拷贝到101、102上,第一次拷贝可以使用scp命令进行不同服务器之间的远程数据拷贝。
(1)scp(secure copy)安全拷贝
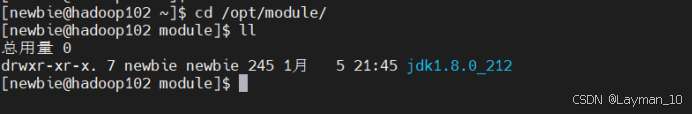
scp可以实现服务器与服务器之间的数据拷贝,在hadoop100上,将hadoop100中/opt/module/jdk1.8.0_212目录拷贝到hadoop101、hadoop102上。
基本语法:
scp -r pdir/pdir/pdir/fname user@user@user@host:pdir/pdir/pdir/fname
// hadoop100
scp -r /opt/module/jdk1.8.0_212/ newbie@hadoop101:/opt/module


在hadoop101上查看

在hadoop102上查看
(2)rsync远程同步工具
rsync主要用于备份和镜像。具有速度快、避免复制相同内容和支持符号链接的优点。
rsync和scp区别:用rsync做文件的复制要比scp的速度快,rsync只对差异文件做更新。scp是把所有文件都复制过去。
基本语法:(-a 归档拷贝,-v 显示复制过程)
rsync -av pdir/pdir/pdir/fname user@user@user@host:pdir/pdir/pdir/fname
后续使用rsync远程同步工具实时更新相关配置,比如在hadoop100上配置更改hadoop的hdfs、core等配置后,直接使用rsync进行同步,使得集群的配置同步,减少需要单台配置出现遗漏情形。
1)期望脚本在任何路径都能使用(脚本放在声明了全局环境变量的路径)
看到变量路径上有个在/home/newbie/bin上,可以直接在本地/home新建bin路径,在此路径/home/newbie/bin下然后创建一个shell脚本,后续通过该执行脚本实现集群内的配置同步,这里创建脚本名称为“xsync”。

mkdir bin
cd bin
vim xsync

#!/bin/bash

#1. 判断参数个数
if [ $# -lt 1 ]
then
    echo Not Enough Arguement!
    exit;
fi

#2. 遍历集群所有机器
for host in hadoop100 hadoop100 hadoop100
do
    echo ====================  $host  ====================
    #3. 遍历所有目录,挨个发送

    for file in $@
    do
        #4. 判断文件是否存在
        if [ -e $file ]
            then
                #5. 获取父目录
                pdir=$(cd -P $(dirname $file); pwd)

                #6. 获取当前文件的名称
                fname=$(basename $file)
                ssh $host "mkdir -p $pdir"
                rsync -av $pdir/$fname $host:$pdir
            else
                echo $file does not exists!
        fi
    done
done
2)修改脚本 xsync 具有执行权限
chmod +x xsync
3)测试脚本
在hadoop100上执行,分别在hadoop101、102上查看
xsync /home/newbie/bin

在hadoop101上查看,可以看到hadoop100上的/home/newbie/bin目录已将完成同步过来

在hadoop102上查看,可以看到hadoop100上的/home/newbie/bin目录已将完成同步过来

4)将脚本复制到/bin中,以便全局调用
sudo cp xsync /bin/
5)同步三台主机的环境变量配置(root所有者),并分别在三台主机上刷新环境变量,使配置生效。
sudo xsync /etc/profile.d/my_env.sh



// 同步过去后不要忘记在另外两台上刷新环境变量,不然不生效
source /etc/profile
1.5.无密钥配置
1、生成公钥和私钥,对三台主机进行无密钥配置
(1)Hadoop101
1)配置ssh无密钥
ssh-keygen -t rsa
# 一直回车

2)将hadoop100的公钥拷贝到要免密登录的目标机器上(hadoop101、hadoop102)
ssh-copy-id hadoop100
ssh-copy-id hadoop101
ssh-copy-id hadoop102

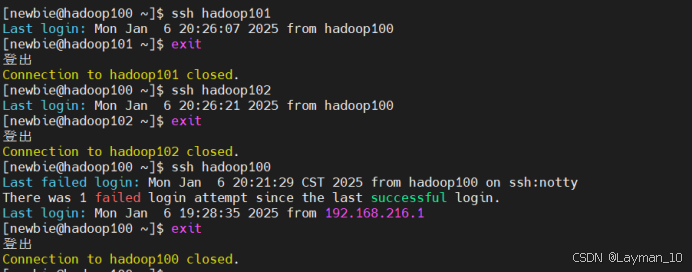
3)验证从hadoop100 ssh无密远程到本机、hadoop101、hadoop101
ssh hadoop100
ssh hadoop101
ssh hadoop101
(2)hadoop101、hadoop103
参考hadoop100无密钥的操作步骤,对hadoop101、hadoop102进行同样的操作,最终的效果是三台主机之间能直接ssh远程访问,不需要输入密码,效果参考如下。


1.6.集群配置
1.6.1.集群部署规划及配置文件的配置
1、集群部署规划
本次集群规划,Namenode部署在hadoop100、SecondaryNameNode部署在hadoop102、ResourceManager部署在hadoop101上,同时三台主机均部署有DataNode和NodeManager组件。
注意:
// NameNode和SecondaryNameNode不要安装在同一台服务器
// ResourceManager也很消耗内存,不要和NameNode、SecondaryNameNode配置在同一台机器上。

3、配置集群文件
配置集群的四大核心配置文件
(1)配置core-site.xml
pwd
/opt/module/hadoop/etc/hadoop
sudo vim core-site.xml

<configuration>
    <!-- 指定NameNode的地址 -->
    <property>
        <name>fs.defaultFS</name>
        <value>hdfs://hadoop100:8020</value>
    </property>

    <!-- 指定hadoop数据的存储目录 -->
    <property>
        <name>hadoop.tmp.dir</name>
        <value>/opt/module/hadoop/data</value>
    </property>

    <!-- 配置HDFS网页登录使用的静态用户为newbie -->
    <property>
        <name>hadoop.http.staticuser.user</name>
        <value>newbie</value>
    </property>
</configuration>

(2)HDFS配置文件
配置hdfs-site.xml
sudo vim hdfs-site.xml

<configuration>
        <!-- nn web端访问地址-->
        <property>
        <name>dfs.namenode.http-address</name>
        <value>hadoop100:9870</value>
    </property>
        <!-- 2nn web端访问地址-->
    <property>
        <name>dfs.namenode.secondary.http-address</name>
        <value>hadoop102:9868</value>
    </property>
</configuration>

(3)YARN配置文件
配置yarn-site.xml
sudo vim yarn-site.xml

<configuration>

<!-- Site specific YARN configuration properties -->

    <!-- 指定MR走shuffle -->
    <property>
        <name>yarn.nodemanager.aux-services</name>
        <value>mapreduce_shuffle</value>
    </property>

    <!-- 指定ResourceManager的地址-->
    <property>
        <name>yarn.resourcemanager.hostname</name>
        <value>hadoop101</value>
    </property>

    <!-- 环境变量的继承 -->
    <property>
        <name>yarn.nodemanager.env-whitelist</name>
        <value>JAVA_HOME,HADOOP_COMMON_HOME,HADOOP_HDFS_HOME,HADOOP_CONF_DIR,CLASSPATH_PREPEND_DISTCACHE,HADOOP_YARN_HOME,HADOOP_MAPRED_HOME</value>
    </property>
</configuration>

(4)MapReduce配置文件
配置mapred-site.xml
sudo vim mapred-site.xml
<configuration>
<!-- 指定MapReduce程序运行在Yarn上 -->
    <property>
        <name>mapreduce.framework.name</name>
        <value>yarn</value>
    </property>
</configuration>

4、在集群上分发配置好的Hadoop配置文件
xsync /opt/module/hadoop/etc/hadoop/
5、去101和102上查看文件分发情况
(1)Hadoop101
cd /opt/module/hadoop/etc/hadoop/
cat core-site.xml

(2)Hadoop102
cd /opt/module/hadoop/etc/hadoop/
cat core-site.xml

1.6.2.群起集群
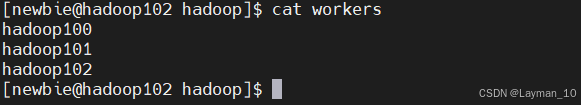
1、配置workers,用于运行集群三台主机
// 注意:该文件中添加的内容结尾不允许有空格,文件中不允许有空行。
cd /opt/module/hadoop/etc/hadoop/
sudo vim workers
cat workers
hadoop100
hadoop101
hadoop102
同步所有节点配置文件
xsync /opt/module/hadoop/etc/


2、启动集群
(1)集群是第一次启动,需要在hadoop100节点格式化NameNode
hdfs namenode -format
(2)启动HDFS
cd /opt/module/hadoop/sbin/
start-dfs.sh
(3)Web端查看HDFS的NameNode
1)浏览器中输入:http://192.168.216.100:9870
2)查看HDFS上存储的数据信息

(4)在配置了ResourceManager的节点(hadoop101)启动YARN
cd /opt/module/hadoop/sbin/
start-yarn.sh
(5)Web端查看YARN的ResourceManager
1)浏览器中输入:http://192.168.216.101:8088
2)查看YARN上运行的Job信息

1.6.3.配置历史服务器
为了查看程序的历史运行情况,需要配置一下历史服务器。具体配置步骤如下:
(1)配置mapred-site.xml
cd /opt/module/hadoop/etc/hadoop
vim mapred-site.xml

    </property>
    <!-- 历史服务器端地址 -->
    <property>
        <name>mapreduce.jobhistory.address</name>
        <value>hadoop100:10020</value>
    </property>

    <!-- 历史服务器web端地址 -->
    <property>
        <name>mapreduce.jobhistory.webapp.address</name>
        <value>hadoop100:19888</value>
    </property>

(2)分发配置
xsync /opt/module/hadoop/etc/hadoop/mapred-site.xml

(3)在hadoop102启动历史服务器
mapred --daemon start historyserver
(4)查看历史服务器是否启动
jps

(5)查看JobHistory
http://192.168.216.100:19888/jobhistory

1.6.4.配置日志的聚集
日志聚集概念:应用运行完成以后,将程序运行日志信息上传到HDFS系统上。
日志聚集功能好处:可以方便的查看到程序运行详情,方便开发调试。
// 注意:开启日志聚集功能,需要重新启动NodeManager 、ResourceManager和HistoryServer。(以下均在hadoop100上操作,包括服务开启,访问)
1、开启日志聚集功能具体步骤如下:
(1)配置yarn-site.xml
cd /opt/module/hadoop/etc/hadoop
sudo vim yarn-site.xml

    <!-- 开启日志聚集功能 -->
    <property>
       <name>yarn.log-aggregation-enable</name>
       <value>true</value>
    </property>
    <!-- 设置日志聚集服务器地址 -->
    <property>
       <name>yarn.log.server.url</name>
       <value>http://hadoop100:19888/jobhistory/logs</value>
    </property>
    <!-- 设置日志保留时间为7天 -->
    <property>
       <name>yarn.log-aggregation.retain-seconds</name>
       <value>604800</value>
    </property>

(2)分发配置
xsync /opt/module/hadoop/etc/hadoop/yarn-site.xml

(3)关闭NodeManager 、ResourceManager和HistoryServer
stop-yarn.sh
mapred --daemon stop historyserver
(4)启动NodeManager 、ResourceManage和HistoryServer
start-yarn.sh
mapred --daemon start historyserver
(5)执行WordCount程序,
集群默认有WordCount程序在/opt/module/hadoop/share/hadoop/mapreduce/路径下;先在本地创建个文件,然后上传到hdfs上,再执行WordCount程序。
touch /test
hadoop fs -put /test /input/
hadoop jar /opt/module/hadoop/share/hadoop/mapreduce/hadoop-mapreduce-examples-3.1.3.jar wordcount /input/ /output
2、历史任务列表(http://192.168.216.100:19888/jobhistory)

3、查看任务运行日志

4、运行日志详情

更多推荐


 33
 0
- 0


 已为社区贡献1条内容

所有评论(0)