
使用 PEFT 和 LoRa 技术微调(fine-tuning)大语言模型指南
目录
附加说明:此文为译文,原文链接:原文
像 GPT 这样的大型语言模型(LLMs)规模越来越大。即使是像 MPT 和 Falcon 这样的开源模型,参数也分别达到了 300 亿和 400 亿。随着规模的增大,这些模型的能力和复杂性也在增加。但这种增加的复杂性和模型大小也会带来挑战。训练更大的模型需要更广泛的数据集,并且随着模型的增长,需要调整的参数也更多。这可能会非常耗费计算资源,成本也很高。这就是微调发挥作用的地方。微调是一种允许重新利用预训练模型的技术,可以帮助降低构建更大模型的复杂性。
在本博客中,我们将讨论像 PEFT(参数高效微调)这样的高级微调技术,并看看它们如何在训练大规模大语言模型时为您节省大量时间和金钱。
什么是微调?
微调是获取一个已经在某些任务上进行过训练的模型,然后对其进行调整以执行类似任务的过程。当一个新的数据集或任务需要模型进行一些修改时,或者当模型在特定任务上表现不佳时,通常会使用微调。
例如,一个经过训练生成故事的模型可以被微调来生成诗歌。这是可能的,因为模型已经学会了如何生成自然语言和编写故事,如果对模型进行适当的调整,这种技能也可以用于生成诗歌。
微调是如何工作的?
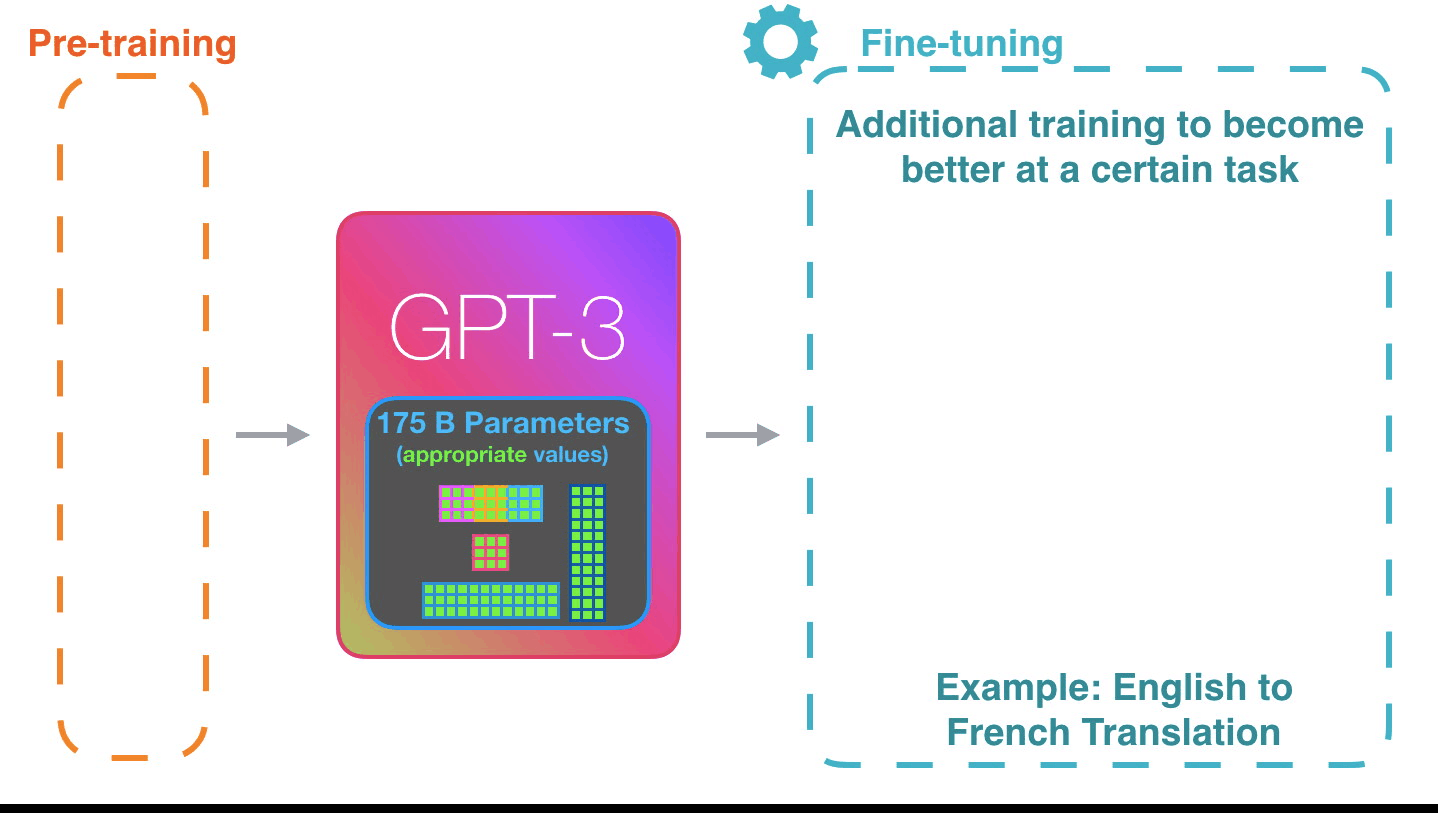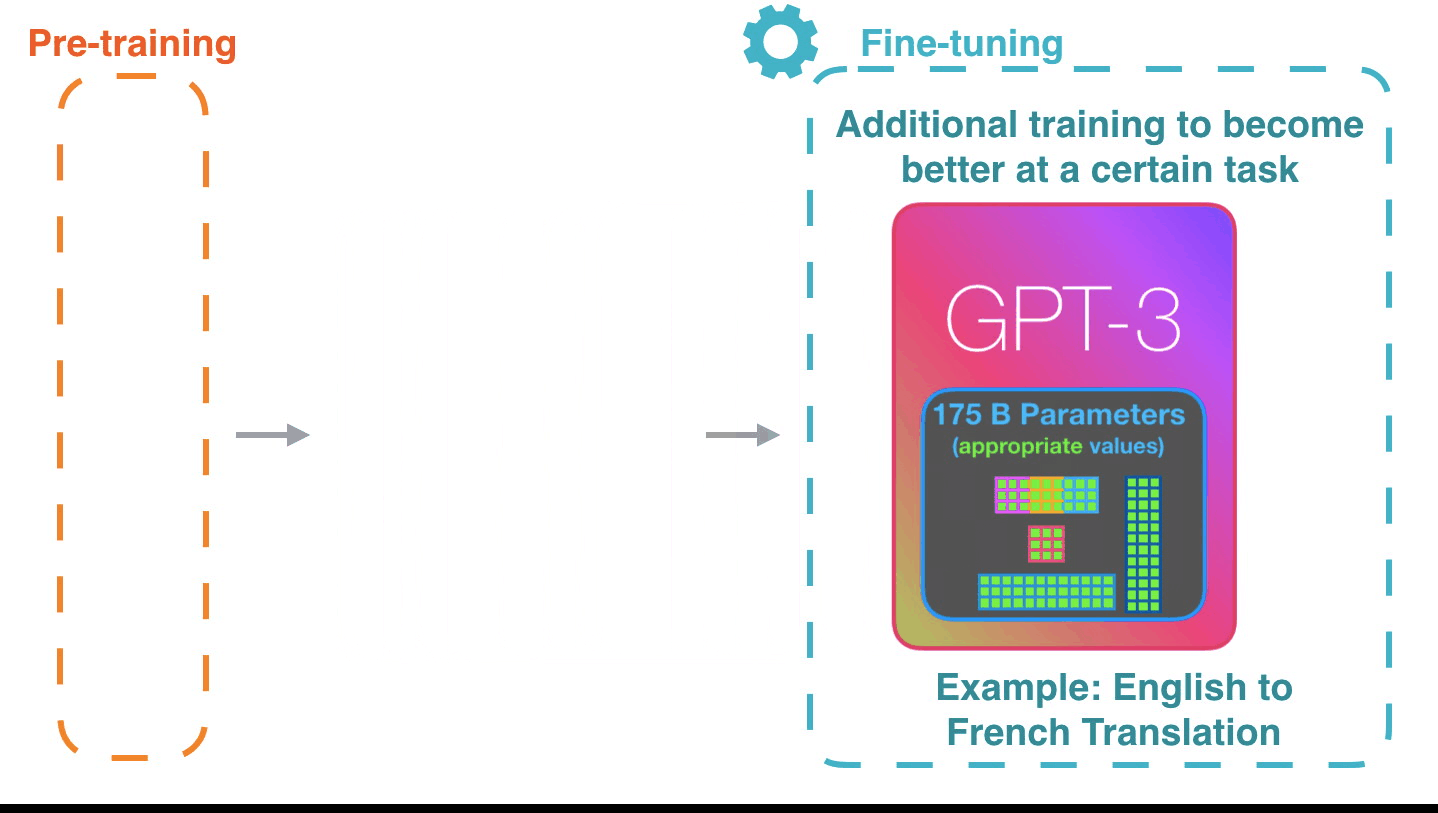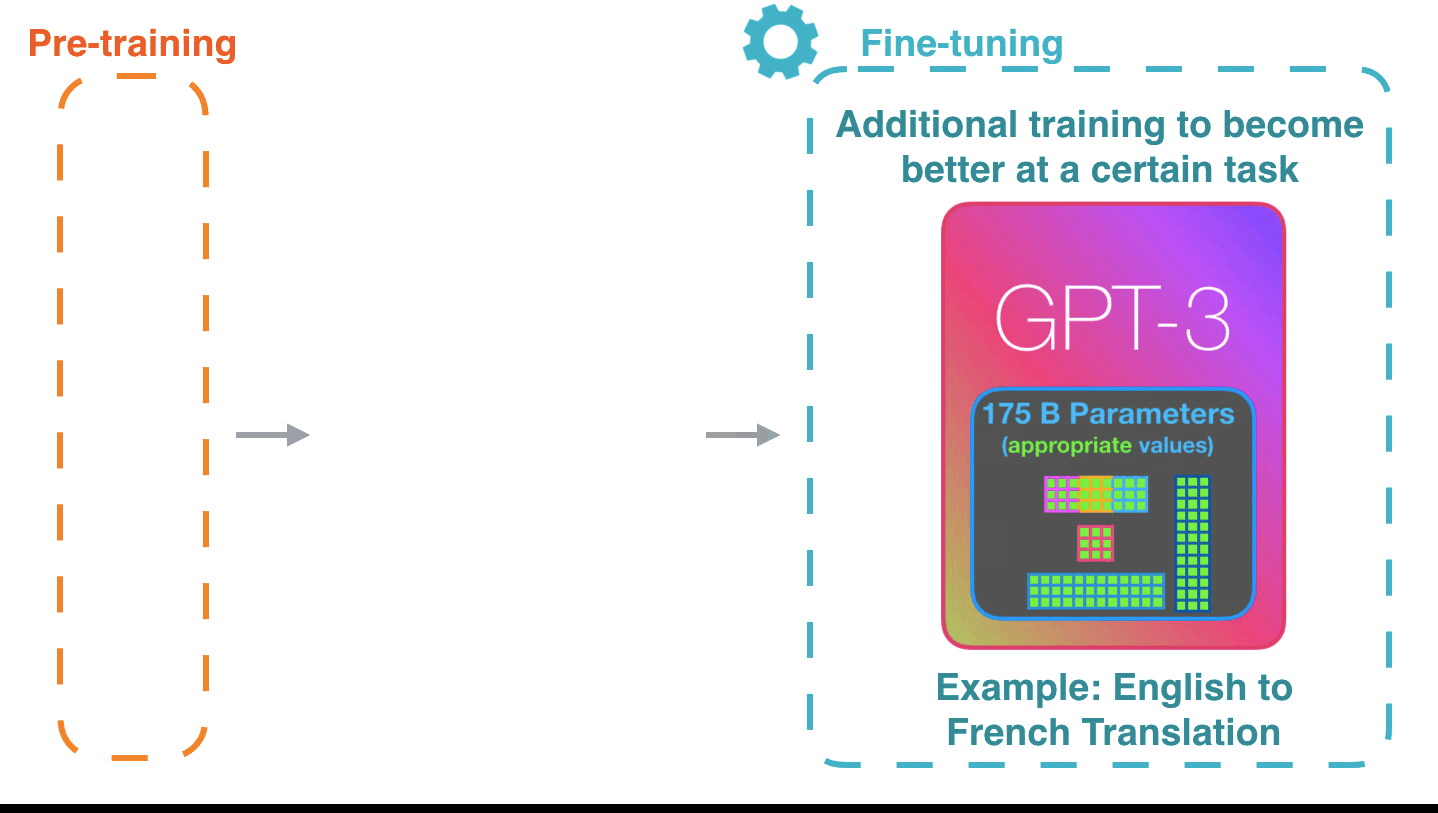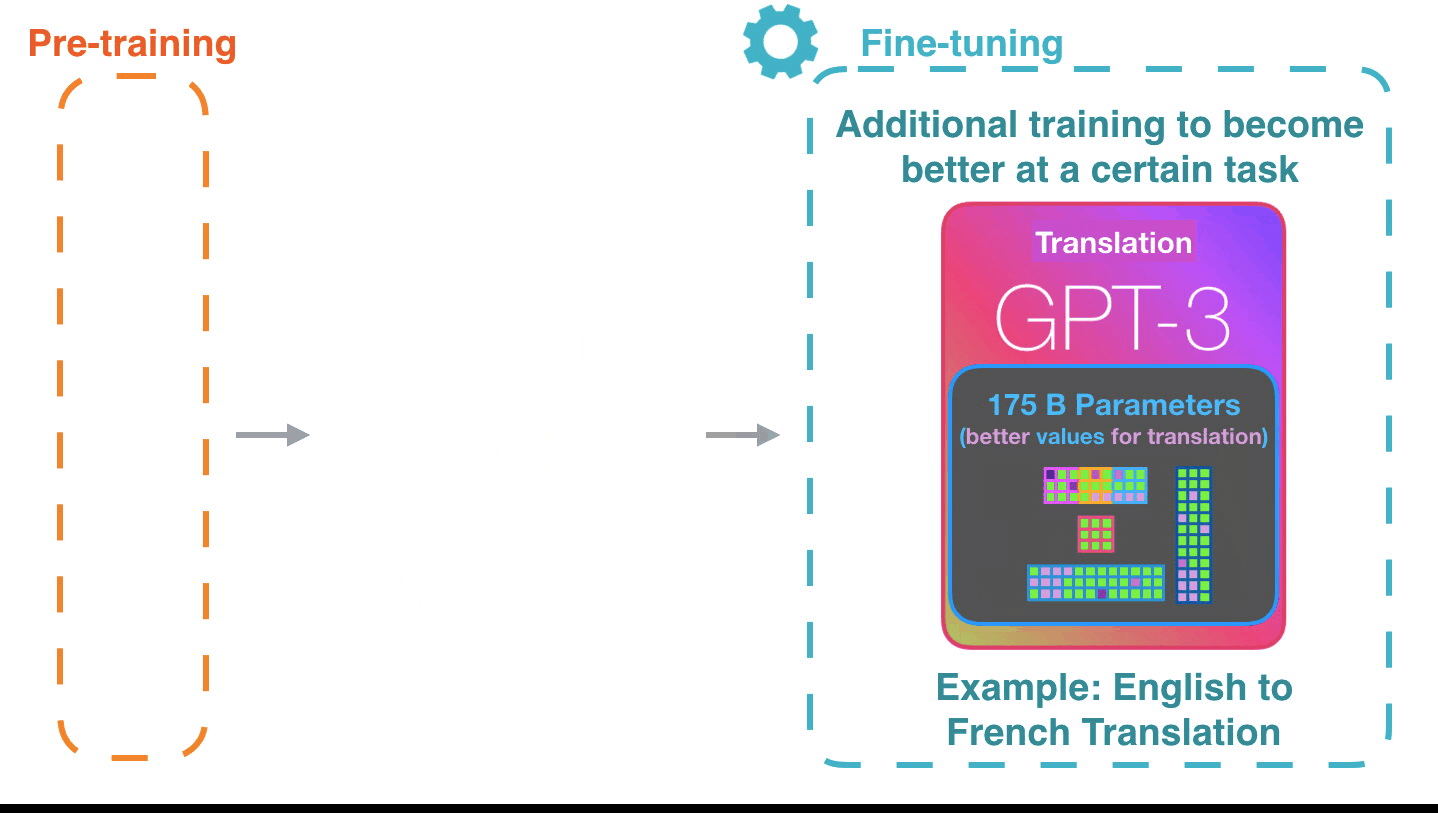
如前所述,微调是针对其他任务对已经训练过的模型进行调整。其工作方式是获取原始模型的权重并对其进行调整以适应新任务。
模型在训练时学会执行某些特定任务,例如,GPT - 3 在大规模数据集上进行了训练,因此它学会了生成故事、诗歌、歌曲、信件和许多其他内容。人们可以利用 GPT - 3 的这种能力,并针对特定任务(如以特定方式生成客户查询的答案)对其进行微调。
有不同的方法和技术来微调模型,最流行的是迁移学习。迁移学习源自计算机视觉领域,它是冻结网络初始层的权重,只更新后面层的权重的过程。这是因为较低层(更接近输入的层)负责学习训练数据集的一般特征。而较高层(更接近输出的层)学习更具体的信息,这些信息与生成正确输出直接相关。
以下是微调工作原理的简要图示:
Alammar, J (2018). The Illustrated Transformer [Blog post].
为什么要使用微调?
随着模型规模的增加,训练它变得更加昂贵和耗时。并且随着规模的增大,需要更多的训练数据,否则模型通常会过拟合,并在生产环境中产生较差的结果。微调允许我们通过有效地利用预训练模型来避免这些问题。以下是您应该考虑微调而不是从头开始训练模型的一些原因:
- 更大的模型能很好地泛化到下游任务:我们都知道像 GPT - 3 和 GPT - 4 这样的大型模型在复杂任务上表现非常出色。这是因为它们具有非常复杂的架构,并在大规模数据集上进行了训练,这有助于它们在许多任务上很好地泛化。这些模型理解语言的潜在属性,这有助于它们以最小的努力学习任何新任务,如提示工程。
但是,如果我们想将这些模型用于一些非常具体的任务,如构建法律合同生成器,您可能应该对模型进行微调,而不是使用提示工程。这是因为在像语言生成这样的
非常通用的任务中表现良好的模型,在生成法律合同这样的下游任务中也会表现良好。
-
比训练整个模型更便宜:如前所述,从头开始训练这些大型模型可能非常昂贵,而且耗时很长。训练一个已经训练过的模型总是更便宜的。这也允许您利用已有的成果,而不是自己做所有的事情。大多数时候,构建良好的数据集可能非常困难且耗时。像 MPT 和 LLaMA 这样的开源模型已经由一些顶尖的研究人员进行了训练并确保它们能良好运行。在云基础设施中加载并训练它们是很容易的。
-
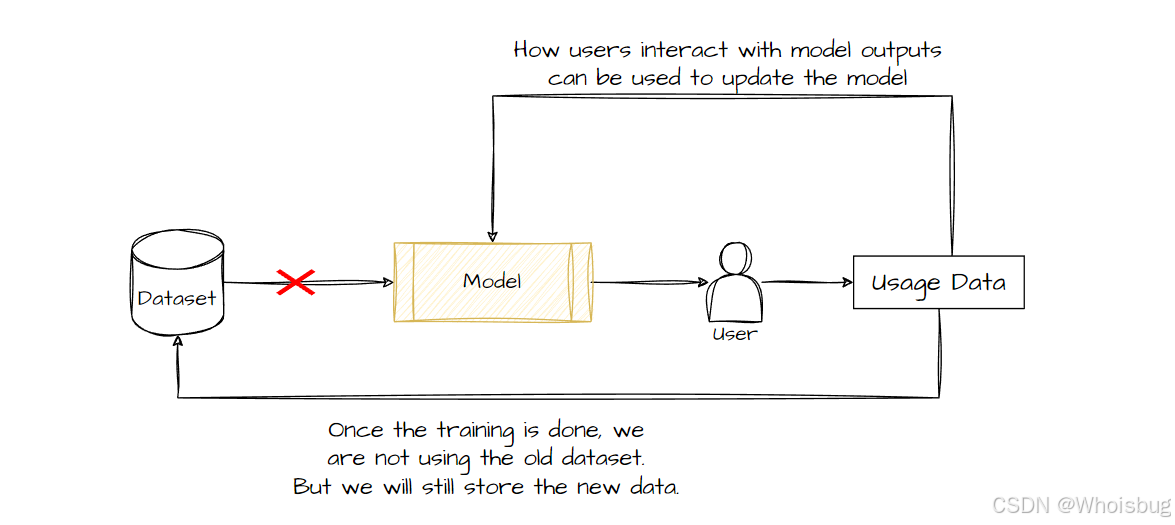
有利于在线训练:人工智能面临的最大挑战之一是让模型与最新数据保持同步。如果模型在生产环境中部署后没有定期更新,其性能可能会开始下降。例如,如果您部署一个人工智能模型来预测商店中顾客的行为,一旦商店重新进货,商品价格发生变化或者引入了新产品,该模型可能就不再表现良好了。这是数据变化如何极大地改变模型性能的一个典型例子。
微调可以帮助您使用最新数据不断更新模型,而无需重新训练整个模型。这使得在生产环境中部署模型变得更容易且成本更低。这被称为在线学习或在线训练,对于任何生产环境中的模型来说都是绝对必要的。
什么是 PEFT?
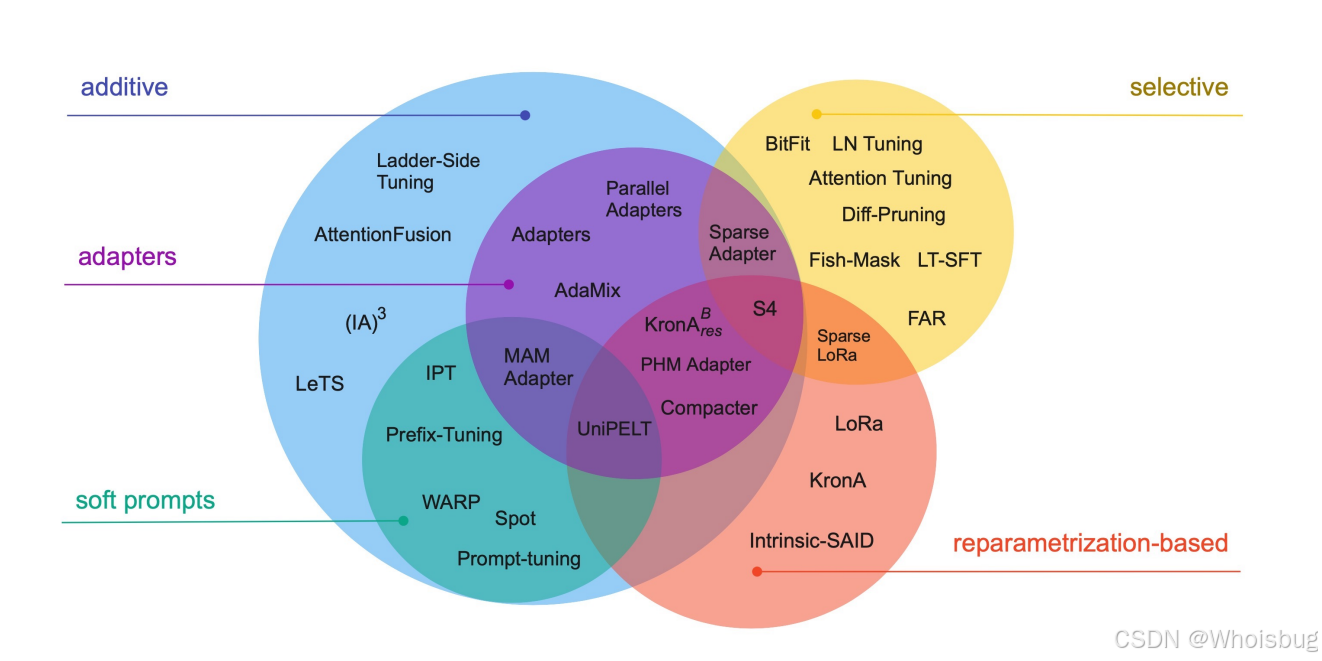
PEFT(参数高效微调)是一组技术或方法,旨在以最节省计算资源和时间的方式微调大型模型,同时又不会损失完全微调所能达到的性能。之所以需要这样做,是因为随着像 BLOOM 这样拥有多达 1760 亿参数的模型越来越大,如果不花费数万美元,几乎不可能对它们进行微调。但有时为了获得更好的性能,使用这样的大型模型几乎是必要的。这就是 PEFT 发挥作用的地方,它有助于解决在使用这类大型模型时面临的问题。
以下是一些 PEFT 技术:
为什么选择 PEFT?
如上文所述,在涉及生产级应用时,对更大的模型进行微调和使用已成为一种必要。PEFT 技术允许您高效地微调模型,从而节省资金和时间。这是通过仅微调神经网络中最重要和最相关的参数来实现的。这些技术会在网络中引入新参数,或者冻结整个模型的部分内容,以使模型更容易训练。
迁移学习
迁移学习是指我们获取一个模型已经学习到的一些参数,并将它们用于其他任务。这听起来与微调相似,但实则不同。在微调中,我们重新调整模型的所有参数,或者冻结一些权重并调整其余参数。但在迁移学习中,我们使用从一个模型中学到的一些参数,并将它们用于其他网络。这在我们能做的事情方面给了我们更多的灵活性。例如,在微调时我们不能改变模型的架构,这在很多方面限制了我们。但在使用迁移学习时,我们只使用已训练模型的一部分,然后可以将其附加到任何具有任何架构的其他模型上。
迁移学习是如何工作的?
迁移学习在计算机视觉领域已经是一种常见做法很长时间了。这是由于视觉模型的性质以及它们的学习方式。在卷积神经网络(CNN)模型中,早期层提取更通用的特征,如边缘和曲线,而后期层提取更复杂的特征,如完整的眼睛和面部。这是因为卷积神经网络的感受野随着它们相互堆叠而增大。

例如,假设您正在尝试训练一个神经网络来判断您面前的车辆是汽车还是摩托车。这是一个非常基础的任务。但假设您的数据非常有限,并且不想对模型进行过多训练。下面是一个基本的卷积神经网络的样子。

这个网络有两个主要部分,即卷积神经网络头部和后面的全连接层。如前所述,卷积神经网络层提取数据的表示形式,然后全连接网络利用这些表示来对图像进行分类。在这里,我们可以使用在类似分类问题上训练过的任何其他卷积神经网络,并将其用作这个新问题的卷积神经网络头部。

在这里,正如您所看到的,我们通过使用一个预训练的用于对汽车类型进行分类的网络的权重来进行迁移学习。我们只冻结卷积神经网络的前两层,而让后两层在训练过程中可以自由更新。这确保了模型的卷积神经网络头部能从图像中学习到新任务可能需要的新特征。
迁移学习在自然语言处理(NLP)任务中也经常出现在大语言模型中,人们会使用像 T5 这样的预训练模型中 Transformer 网络的编码器部分,并训练后面的层。
适配器
适配器是最早发布的参数高效微调技术之一。在相关论文中,作者展示了可以在现有的 Transformer 架构中添加更多层,并只对这些新增层进行微调,而不是对整个模型进行微调。他们表明,与完全微调相比,这种技术能产生相近的性能。

在左侧,是添加了适配器层的修改后的 Transformer 架构。您可以看到适配器层添加在注意力堆栈和前馈堆栈之后。在右侧,您可以看到适配器层本身的架构。适配器层包含一个瓶颈架构,它接收输入并将其缩小为维度更小的表示形式,然后将其通过一个非线性激活函数,再将其缩放回输入的维度。这确保了 Transformer 堆栈中的下一层能够接收适配器层生成的输出。
在论文中,作者表明这种微调方法与完全微调相当,同时消耗的计算资源和训练时间要少得多。他们在 GLUE 基准测试中能够达到完全微调性能的 0.4%,而只增加了 3.6% 的参数。

LoRA - 低秩适应
LoRA 是一种与适配器层类似的策略,但它旨在进一步减少可训练参数的数量,采取了一种更具数学严谨性的方法。LoRA 通过修改神经网络中可更新参数的训练和更新方式来发挥作用。
从数学角度来解释一下(如果您不感兴趣,可以跳过这一段)。我们知道预训练神经网络的权重矩阵是满秩的,这意味着每个权重都是唯一的,不能通过组合其他权重来得到。但在这篇论文中,作者表明当预训练语言模型针对新任务进行调整时,权重具有更低的 “内在维度”。也就是说,权重可以用一个更小的矩阵来表示,或者说它具有更低的秩。这反过来意味着在反向传播过程中,权重更新矩阵具有更低的秩,因为预训练过程已经捕获了大部分必要信息,在微调期间只进行特定于任务的调整。
一个更简单的解释是,在微调过程中,只有极少数权重会有大量更新,因为大部分学习是在神经网络的预训练阶段完成的。LoRA 利用这一信息来减少可训练参数的数量。

上面的图片直观地展示了 LoRA 的作用。ΔWAxB 是权重更新矩阵,这些是为了让神经网络学习新任务需要应用到网络上的变化。这个矩阵可以分解为两个矩阵,然后我们只训练这两个矩阵,并利用它们来还原我们的权重更新矩阵。正如您在图片中看到的,矩阵被分解为列数和行数为 r 的矩阵,可以将其理解为如果实际训练权重更新矩阵时它的秩。秩越大,训练期间更新的参数就越多。
LoRA 的效率
论文中的作者表明,LoRA 仅使用总可训练参数的 2% 就能优于完全微调。

就其训练的参数数量而言,我们可以在很大程度上使用秩 r 参数来控制它。例如,假设权重更新矩阵有 100,000 个参数,A 为 200,B 为 500。权重更新矩阵可以分解为维度更小的子矩阵,A 为 200×3,B 为 3×500。这样我们就只有 200×3 + 3×500 = 2100 个可训练参数,仅占总参数数量的 2.1%。而且我们还可以决定只将 LoRA 应用于特定的层,从而进一步减少参数数量。
由于训练和应用的参数数量比实际模型的参数数量少得多,文件大小可以小到 8MB。这使得加载、应用和传输已学习的模型变得更加容易和快速。
如果您想了解更多并深入研究这个主题,可以阅读 LoRA 相关论文。
LoRA 在稳定扩散中的应用
LoRA 最有趣的应用案例之一可以体现在图像生成应用中。图像具有一种可以直观看到的固有风格。现在,用户无需训练庞大的模型来从模型中获取特定风格的图像,而是可以只训练 LoRA 权重,并结合 Dreambooth 等技术来生成具有高度可定制性的高质量图像。
LoRA 权重还可以与其他 LoRA 权重相结合,并以加权组合的方式用于生成具有多种风格的图像。您可以在 CivitAI 网站上找到大量的 LoRA 适配器并将它们加载到您的模型中。

IA3 - 通过抑制和放大内部激活注入的适配器
IA3 是一种基于适配器的技术,与 LoRA 有些相似。作者的目标是复制上下文学习(ICL,即少样本提示)的优势,同时避免其带来的问题。上下文学习在成本和推理方面可能会变得很复杂,因为它需要用示例来提示模型。更长的提示需要更多的时间和计算来处理。但上下文学习也许是开始使用模型的最简单方式。
IA3 通过引入针对模型激活的缩放向量来发挥作用。总共引入了 3 个向量,即 lv、ik 和 lff。这些向量分别针对注意力层中的值、键以及密集层中的非线性层。这些向量与模型中的默认值按元素相乘。一旦注入,这些参数就在训练过程中进行学习,而模型的其余部分保持冻结。这些学习到的向量本质上是为手头的任务对目标预训练模型权重进行重新缩放或优化。

到目前为止,这看起来像是一种基本的基于适配器类型的 PEFT 方法。但不止如此,作者还使用 3 个损失项来增强学习过程。这 3 个损失项分别是 LLM、LUL 和 LLN。LLM 是标准的交叉熵损失,它增加了生成正确响应的可能性。然后是 LUL,即非似然损失。这个损失项通过排序分类来降低错误输出的概率。最后是 LLN,即长度归一化损失,它对所有输出选择的长度归一化对数概率应用 softmax 交叉熵损失。在这里使用多个损失是为了确保模型能更快、更好地学习。因为我们试图通过少量样本示例进行学习,所以这些损失是必要的。
现在让我们谈谈 IA3 中的两个非常重要的概念:排序分类和长度归一化。
在排序分类中,模型被要求根据正确性对一组响应进行排序。这是通过计算潜在响应的概率分数来完成的。然后使用非似然损失(LUL)来降低错误响应的概率,从而增加正确响应的概率。但在排序分类中,我们面临一个关键问题,即由于概率的计算方式,包含较少标记的响应会排名更高。生成的标记数量越少,概率就越高,因为每个生成标记的概率都小于 1。为了解决这个问题,作者建议将响应的分数除以响应中的标记数量。这样做可以对分数进行归一化。这里需要注意的一个非常重要的点是,归一化是针对对数概率进行的,而不是原始概率。对数概率是负数,且取值在 0 到 1 之间。
IA3 的效率
IA3 与 LoRA 一样,会减少可训练参数的数量。但 IA3 不是使用低秩矩阵,而是使用缩放向量。对于论文中训练的 T0 模型,它将可训练参数减少到约 0.01%,而 LoRA 的比例大于 0.1%。大语言模型的冻结状态也为我们提供了针对多个用例使用多个适配器的选择。此外,由于作者使用了按元素相乘的方式,由于乘法的交换律,将适配器与大语言模型权重合并非常容易。

上面的图表显示,IA3 的性能优于 LoRA,并且对浮点运算次数(FLOPs)几乎没有影响。这使得 IA3 成为一种高效且理想的技术。而且由于 IA3 是一种加法适配器技术,就像 LoRA 一样,我们可以针对模型的特定部分进行操作,并决定在哪里引入缩放向量。这有助于我们进一步减少训练时间。
P - 调优
P - 调优方法旨在优化传递给模型的提示的表示形式。在 P - 调优相关论文中,作者强调了在使用大型语言模型时提示工程是一种非常强大的技术。P - 调优方法建立在提示工程的基础之上,并试图进一步提高优质提示的有效性。
P - 调优的工作方式是为您的提示创建一个小型编码器网络,该网络为您传递的提示创建一个软提示。要使用 P - 调优来微调您的大语言模型,您应该创建一个表示您提示的提示模板,以及在模板中用于获取标签 y 的上下文 x。这是论文中提到的方法。用于提示模板的标记是可训练和可学习的参数,这些被称为伪标记。我们还添加一个提示编码器,它随后帮助我们针对手头的特定任务更新伪标记。提示编码器通常是一个双向长短期记忆网络(bi - LSTM),它学习提示对于模型的最优表示形式,然后将该表示传递给模型。LSTM 网络连接到原始模型上。在这里,只有编码器网络和伪标记被训练,原始网络的权重不受影响。一旦训练完成,由于我们已经有了可以直接使用的表示,就可以丢弃 LSTM 头。
简而言之,提示编码器只是改变传递提示的嵌入表示,以更好地表示任务,其他一切都保持不变。

P - 调优的效率
在效率方面,P - 调优与其他任何方法一样出色。在论文中,作者表明 P - 调优在大多数基准测试中能够比完全微调表现更好。可以说,P - 调优与大型语言模型的完全微调相当。

但 P - 调优存在一个核心问题。P - 调优是一种提示优化技术,它优化传递给更大模型的提示。这意味着在能力方面,我们在很大程度上仍然依赖于大型模型。如果一个模型没有针对情感分类进行过训练,那么使用 P - 调优来优化情感分类提示对该模型不会有太大帮助。P - 调优是一种辅助技术。选择一个通过一些提示工程就能 “很好地” 完成所需任务的模型,然后再进一步对其进行优化,这一点始终非常重要。
前缀调优
前缀调优可以被视为 P - 调优的下一个版本。P - 调优的作者发表了一篇关于 P - 调优 V - 2 的论文,解决了 P - 调优存在的问题。在这篇论文中,他们实现了本文所介绍的前缀调优。前缀调优和 P - 调优没有太多差异,但仍可能导致不同的结果。让我们深入解释一下。

在 P - 调优中,我们只将可学习参数添加到输入嵌入中,但在前缀调优中,我们将它们添加到网络的所有层中。这确保了模型本身能更多地了解它正在被微调的任务。我们将可学习参数附加到提示以及 Transformer 层的每一层激活上。与 P - 调优的区别在于,我们不是完全修改提示嵌入,而是在每一层提示的开头只添加极少数的可学习参数。以下是一个直观的解释:
在 Transformer 的每一层,我们将一个带有可学习参数的软提示与输入进行拼接。这些可学习参数使用一个非常小的多层感知机(MLP,只有 2 个全连接层)进行调优。这样做是因为在论文中作者指出,直接更新这些提示标记对学习率和初始化非常敏感。软提示增加了可训练参数的数量,但也极大地提高了模型的学习能力。多层感知机(MLP)或全连接层在之后可以被舍弃,因为我们只关心软提示,在推理过程中它将被附加到输入序列上并引导模型。

前缀调优的效率
前缀调优相对于 P - 调优有显著的优势。而且随着模型规模的增大,这些优势也会增加。这可能是因为对于更大的模型来说有更多的可训练参数。在图表中,您可以看到作者对比了 P - 调优、完全微调和前缀调优的性能。前缀调优在几乎所有任务中表现都优于或等同于 P - 调优。在许多情况下,它甚至比完全微调的表现还要好!
前缀调优效果很好的一个重要原因是可训练参数的数量不限于输入序列。可学习参数添加到了每一层,使得模型更加灵活。前缀调优与 P - 调优不同,它不仅影响提示标记,还影响模型本身。这使得模型能够学习到更多内容。但这种方法仍然在很大程度上依赖于提示。仍然建议先选择一个能够执行任务的模型,然后再对其进行优化,这样会产生更好的结果。至于参数的大小,训练参数的数量大幅增加,从 0.01% 到 0.1% 再到 3% 的参数。但参数的大小仍然足够小,以便能够轻松快速地进行传输和加载。
提示调优
提示调优是最早基于仅使用软提示进行微调这一想法的论文之一。P - 调优和前缀调优的想法都源于这篇论文。提示调优是一个非常简单且易于实现的想法。它涉及在输入前添加一个特定提示,并为该特定提示使用虚拟标记或新的可训练标记。这些新的虚拟标记可以在过程中进行微调,以学习提示的更好表示形式。这意味着模型经过调整后能更好地理解提示。以下是论文中提示调优与完全微调的对比:

在这里您可以看到,如果我们想将模型用于多个任务,完全模型微调需要存在多个模型副本。但使用提示调优时,您只需要存储提示标记学习到的虚拟标记即可。例如,如果您使用像 “对这条推文进行分类:{推文内容}” 这样的提示,目标就是为该提示学习新的、更好的嵌入表示。在推理过程中,只有这些新的嵌入表示将被用于生成输出。这允许模型对提示进行调整,以便在推理过程中帮助自己生成更好的输出。
提示调优的效率
使用提示调优的最大优势在于学习到的参数规模很小,文件大小可能只有几千字节(KB)。由于我们可以自行确定新标记的维度大小以及参数数量,所以能够很好地控制要学习的参数数量。在相关论文中,作者展示了即便使用数量非常少的可训练标记,该方法也能有很好的表现,而且随着使用更大的模型,其性能还会提升。你可以阅读相关论文来了解详情。

另一个显著优势是,我们可以在不对模型本身做任何更改的情况下,将同一个模型用于多个任务,因为唯一更新的内容就是提示标记的嵌入表示。也就是说,如果模型足够庞大且复杂,能够执行那些任务,你就可以将其用于推文分类任务以及语言生成任务等,而无需对模型本身进行改动。但一个较大的局限在于,模型自身并没有学到新的内容,这纯粹是一个提示优化任务。这意味着如果模型从未在情感分类数据集上进行过训练,提示调优可能就没什么帮助。需要着重注意的是,这种方法优化的是提示,而非模型本身。所以,如果无法手工构建一个能较好完成任务的硬提示,那么尝试使用提示优化技术对软提示进行优化也就没什么意义了。
LoRA 与提示调优的对比
现在我们已经探讨了各种 PEFT 技术,接下来的问题就是,是使用像适配器和 LoRA 这样的添加式技术,还是使用像 P - 调优和前缀调优这类基于提示的技术。
对比 LoRA 与 P - 调优和前缀调优时,可以肯定地说,就最大限度发挥模型性能而言,LoRA 是最佳策略。但根据你的需求,它可能不是效率最高的选择。如果你想让模型训练的任务与它之前所训练的任务差异很大,那么毫无疑问,LoRA 是高效调整模型的最佳策略。但如果模型或多或少已经理解你的任务,只是面临如何恰当地给模型提示的挑战,那么你就应该使用提示调优技术。提示调优并不会修改模型中的很多参数,主要侧重于所传递的提示。
需要注意的一个重要点是,LoRA 会将权重更新矩阵分解为低秩的小矩阵,并利用它们来更新模型的权重。尽管可训练参数数量较少,但 LoRA 会更新神经网络目标部分中的所有参数。然而在提示调优技术中,只是向模型添加了少量可训练参数,这通常有助于模型更好地适应和理解任务,但并不能很好地帮助模型学习新的特性。
LoRA 和 PEFT 与完全微调的比较
PEFT(参数高效微调)是作为完全微调的替代方案被提出的。在大多数任务中,相关论文已经表明,像 LoRA 这样的 PEFT 技术即便不比完全微调更好,也与完全微调相当。但是,如果希望模型适应的新任务与它之前所训练的任务完全不同,那么 PEFT 可能对你来说就不够用了。在这种情况下,有限的可训练参数数量可能会导致重大问题。
例如,如果你试图使用像 LLaMA 或 Alpaca 这样基于文本的模型来构建一个代码生成模型,你可能应该考虑对整个模型进行微调,而不是使用 LoRA 来调整模型。这是因为该任务与模型已经了解并训练过的内容差异太大了。另一个很好的例子是,训练一个只懂英语的模型去生成尼泊尔语的文本。
为什么要为业务用例微调模型?
对于任何希望充分利用机器学习应用的企业来说,微调模型都是一个重要步骤。它允许你根据特定的用例对模型进行定制,这能够提高准确性和性能。通过消除从头构建新模型的需求,它节省了时间、金钱和资源。微调让你能够优化对自有数据的使用,根据可用数据对模型进行调整,必要时甚至可以整合新数据。这确保了模型更加准确,能更好地服务于企业需求。以下是更多好处:
- 定制化:微调使你能够根据特定需求定制模型,提高准确性和性能
- 资源效率:通过消除从头构建新模型的需求,节省了时间、金钱和资源
- 性能提升:利用独特的数据集对预训练模型进行微调,可增强其性能
- 数据优化:让你充分利用数据,根据可用数据调整模型,必要时还能纳入新数据
但随着模型参数规模增长到数十亿,微调本身也可能成为一项挑战。我们在本博客中讨论的 PEFT 技术有助于减少微调模型所需的时间和资源。它通过利用预训练的权重和参数来加快训练过程,使你能够更高效地微调模型。此外,使用 PEFT,你可以轻松地在互联网上传输模型,甚至将同一个模型用于多种用途。PEFT 为希望充分利用机器学习应用的企业开辟了全新的可能性。
更多推荐


 50
 0
- 0


 已为社区贡献1条内容

所有评论(0)