
Hive数据仓库搭建与使用
1. 前期安装Hadoop集群,确保HDFS和YARN服务正常运行。
确保 Hadoop 集群正常运行:
启动 Hadoop 集群所有节点上的 HDFS 和 YARN 服务。
格式化HDFS(如果您是第一次启动Hadoop集群或者在更改配置后需要重新格式化):
hdfs namenode -format
然后,启动HDFS服务:
start-dfs.sh
2. 启动YARN服务
启动YARN服务:
start-yarn.sh
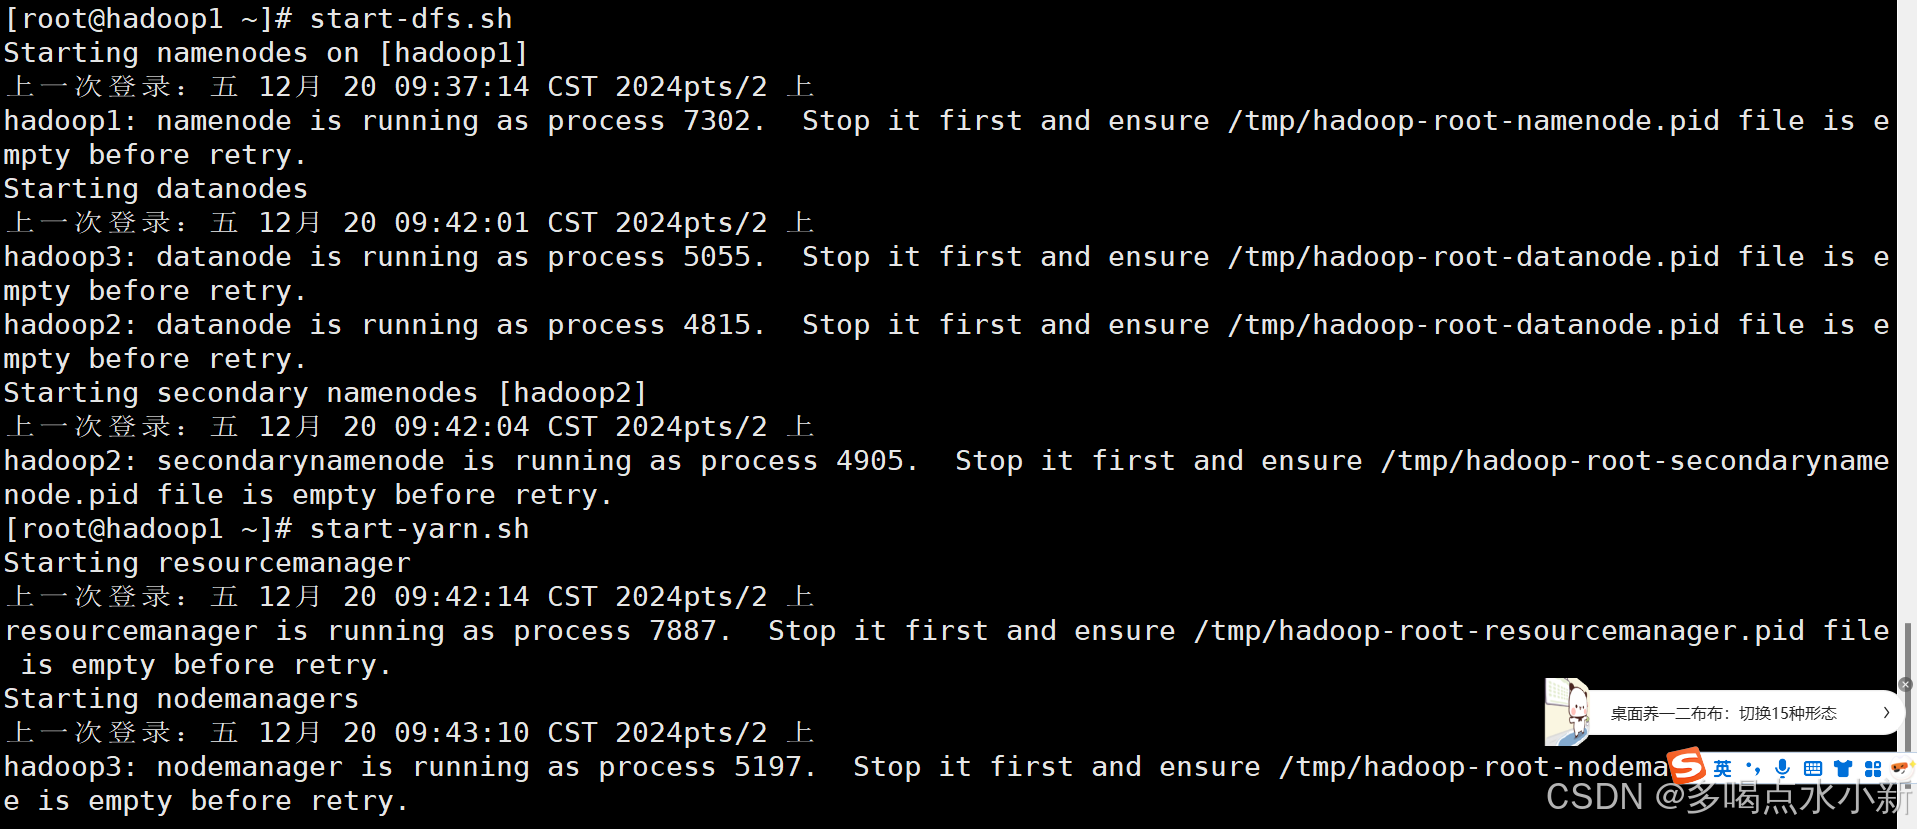
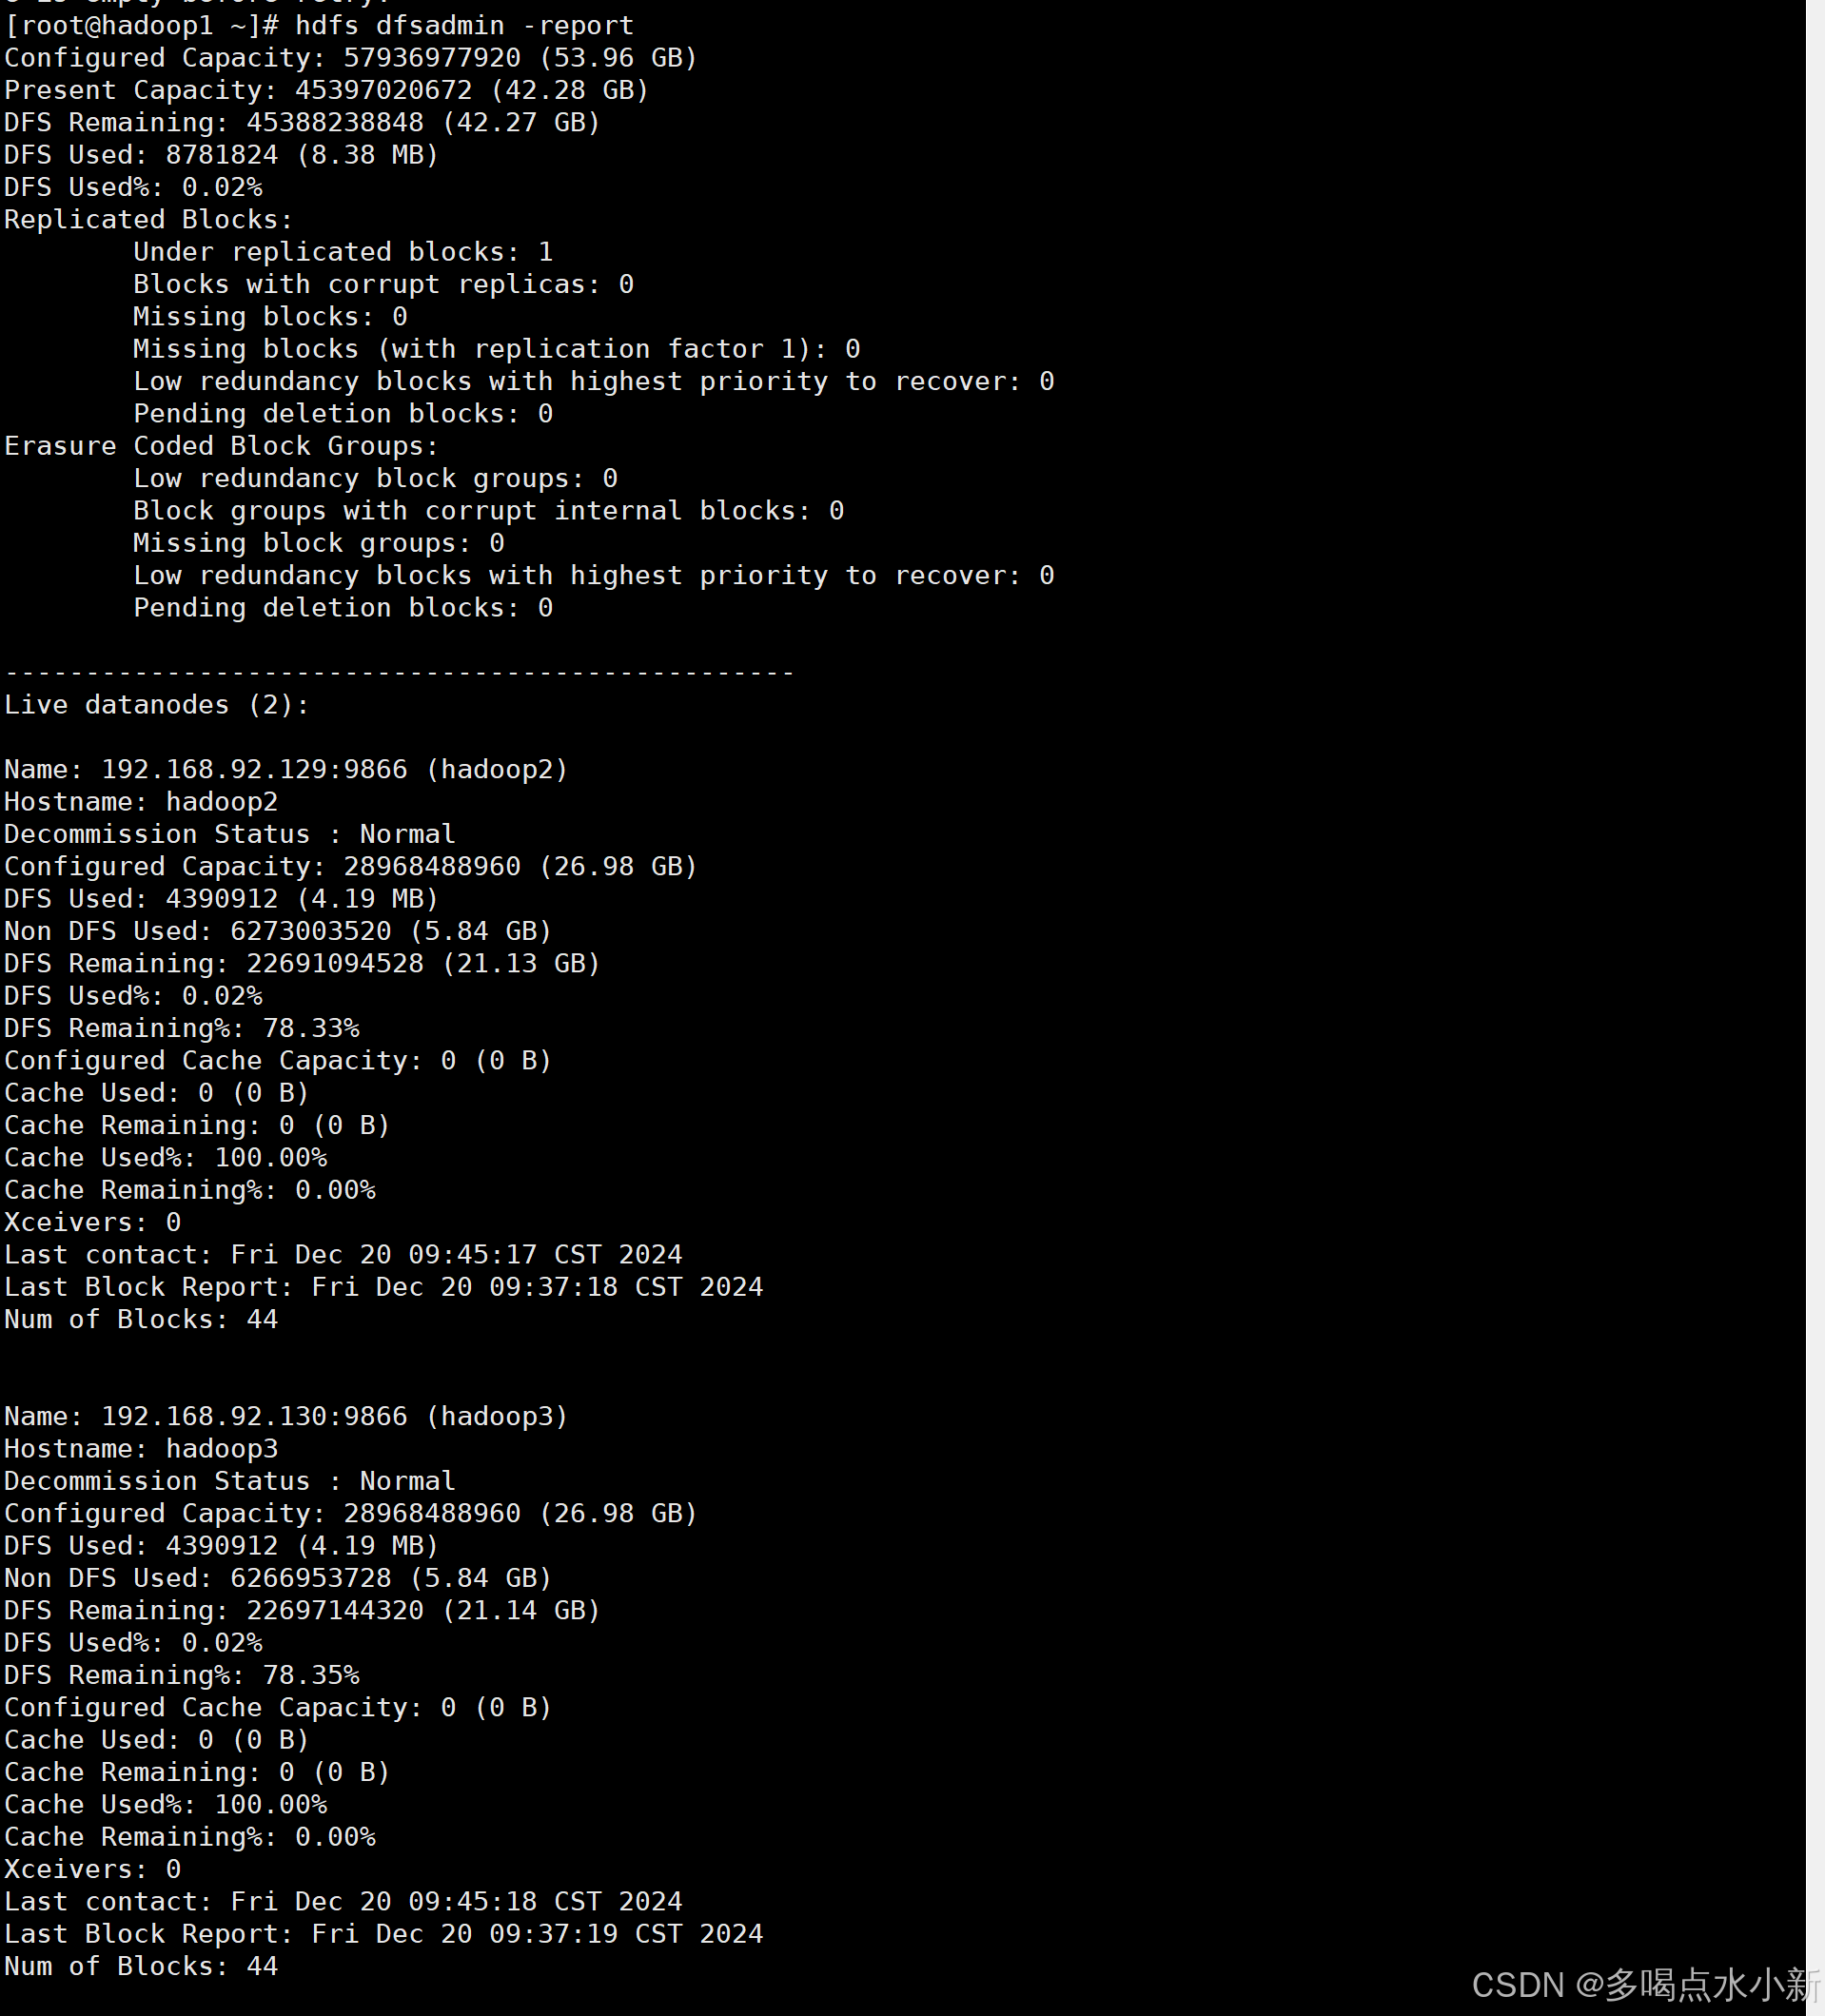
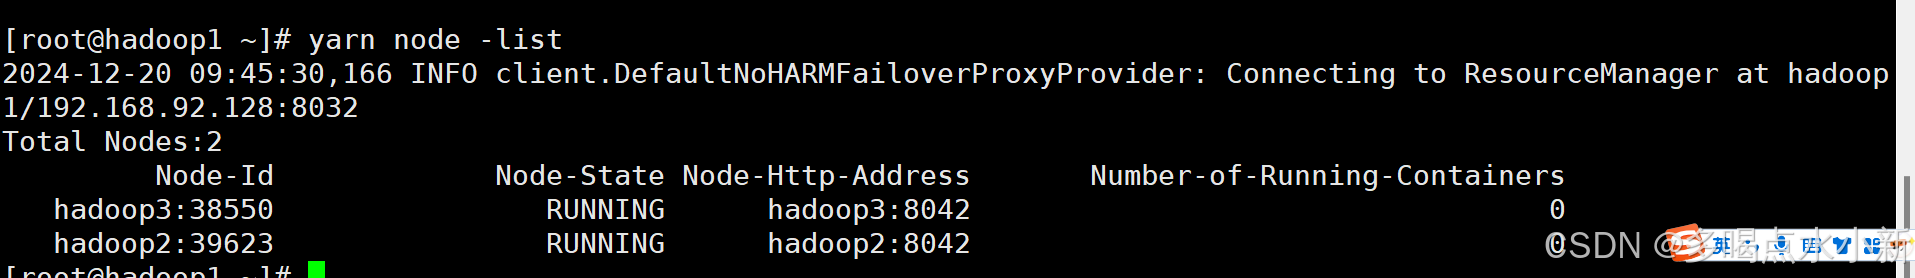
启动服务后,您可以使用以下命令来验证HDFS和YARN服务的状态:
对于HDFS:
hdfs dfsadmin -report
对于YARN:
yarn node -list
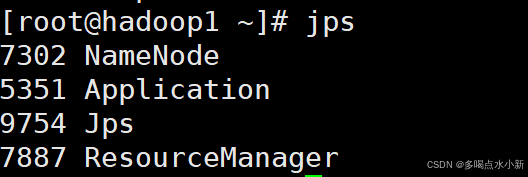
或者使用jps命令查看Java进程,确认NameNode、DataNode、ResourceManager和NodeManager是否都在运行:
jps
配置 Hadoop 环境变量:
编辑 /etc/profile 文件,添加以下内容:
export HADOOP_HOME=/export/servers/hadoop-3.3.1
export PATH=$PATH:$HADOOP_HOME/bin:$HADOOP_HOME/sbin
2.下载并安装Hive,配置Hive的环境变量。
上传Hive的压缩包
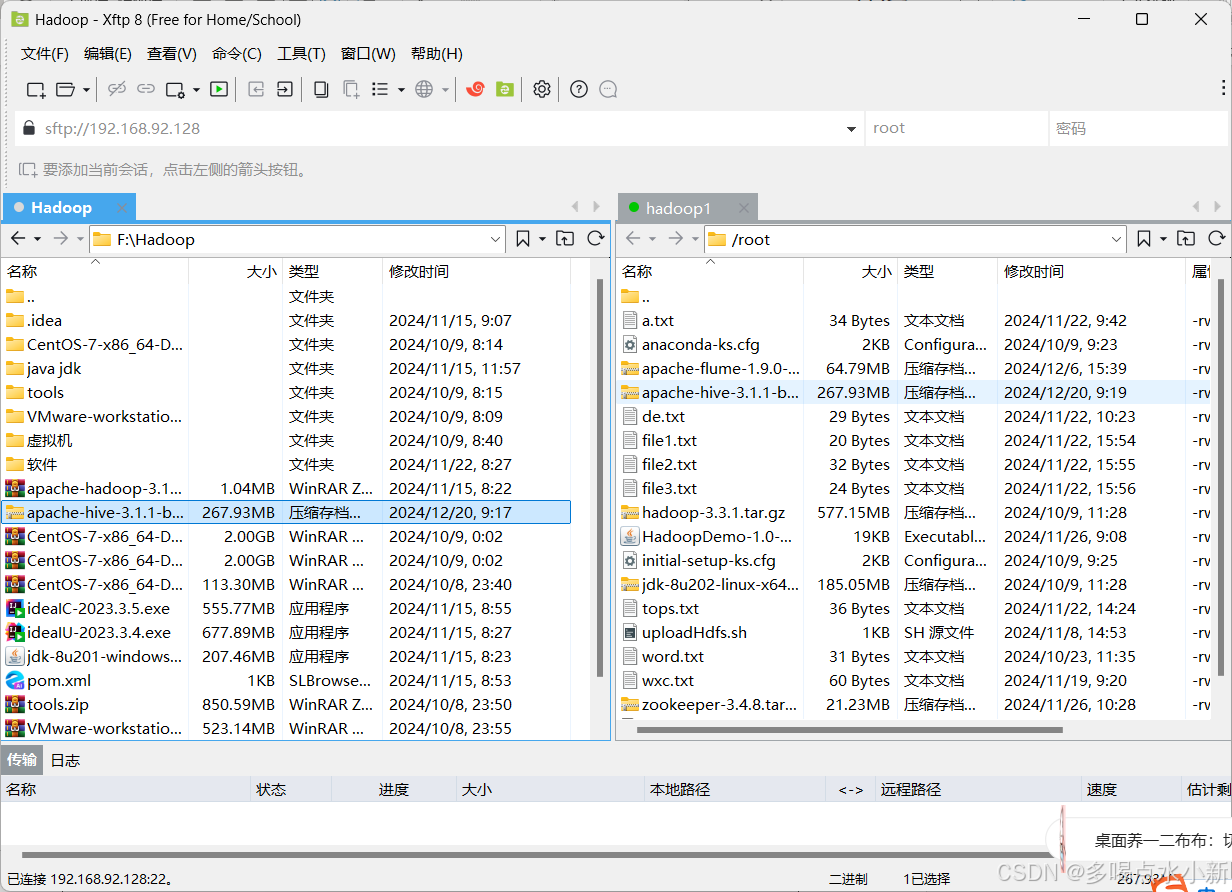
使用 Xftp 将 apache-hive-3.1.1-bin.tar.gz 上传到服务器。P1
解压文件:
tar -zxvf /root/apache-hive-3.1.1-bin.tar.gz -C /exporrt/servers/
cd /exporrt/servers/
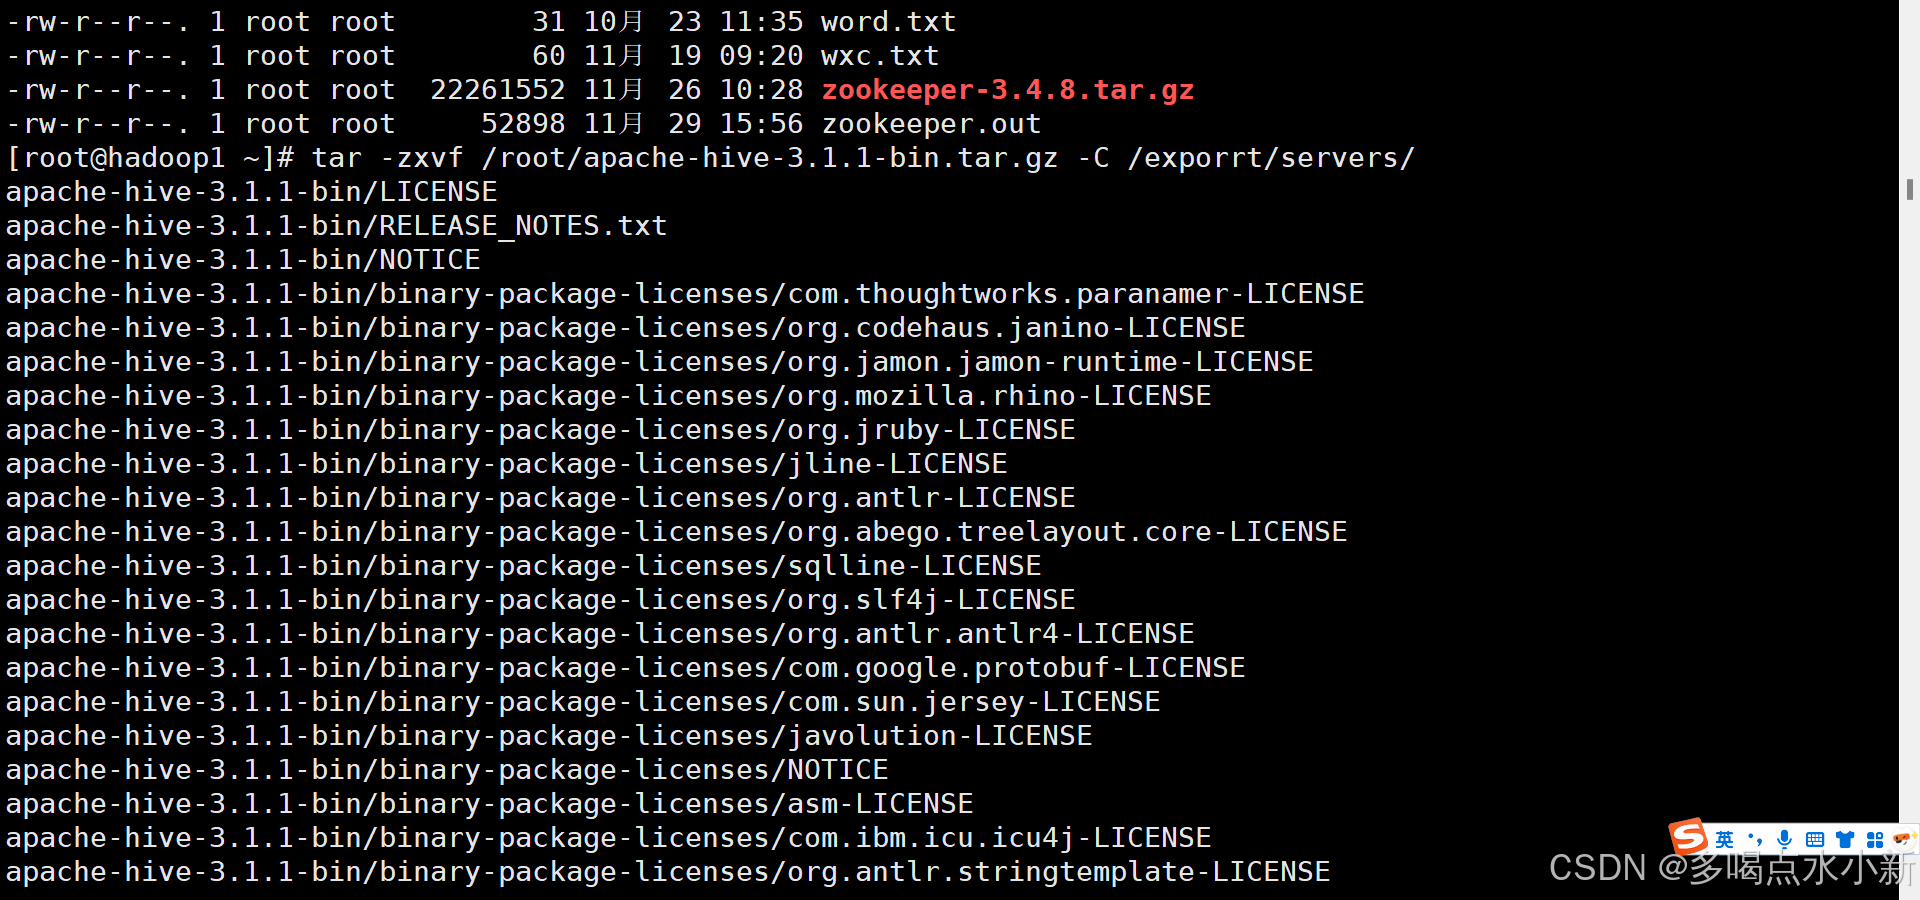
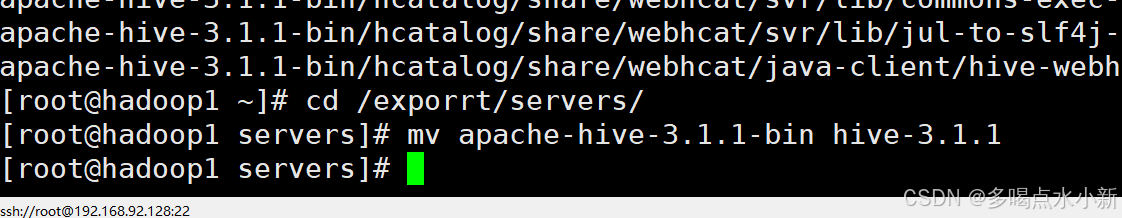
重命名 Hive 目录:
mv apache-hive-3.1.1-bin hive-3.1.1
同步 jar 包:
将 Hadoop 中的 guava-27.0-jre.jar 替换 Hive 中的 guava-19.0.jar:
cd /exporrt/servers/hadoop-3.3.1/share/hadoop/common/lib/
cp guava-27.0-jre.jar /exporrt/servers/hive-3.1.1/lib/
rm /exporrt/servers/hive-3.1.1/lib/guava-19.0.jar

配置环境变量:
编辑 /etc/profile 文件,添加以下内容:
export HIVE_HOME=/exporrt/servers/hive-3.1.1
export PATH=$PATH:$HIVE_HOME/bin
使配置生效:
source /etc/profile


初始化 Hive 元数据存储:
使用 Derby 作为元数据存储:
schematool -initSchema -dbType derby


连接 Hive 服务:
启动 Hadoop 集群:
start-all.sh

启动 Hive 命令行界面:
hive

3.配置Hive与Hadoop的集成,包括hive-site.xml等配置文件的设置。
安装 MySQL
卸载 MariaDB:
rpm -e --nodeps mariadb-libs-5.5.68-1.el7.x86_64

使用 rpm 安装 MySQL:
rpm -ivh mysql-community-common-5.7.36-1.el7.x86_64.rpm
rpm -ivh mysql-community-libs-5.7.36-1.el7.x86_64.rpm
rpm -ivh mysql-community-client-5.7.36-1.el7.x86_64.rpm
rpm -ivh mysql-community-server-5.7.36-1.el7.x86_64.rpm
rpm -qa | grep mysql

添加中文支持:
编辑 /etc/my.cnf 文件,添加以下内容:
default-storage-engine=innodb
innodb_file_per_table
collation-server=utf8_general_ci
init-connect='SET NAMES utf8'
character-set-server=utf8

启动 MySQL 服务:
systemctl start mysqld
查看状态:
systemctl status mysqld

获取初始密码:

cat /var/log/mysqld.log | grep password
登录 MySQL 并修改密码:
mysql
alter user 'root'@'localhost' identified by 'Password@123';
Flush privileges;

修改 hive-site.xml 配置文件:
编辑 /export/servers/hive-3.1.1/conf/hive-site.xml 文件,添加以下内容:
<configuration>
<property>
<name>javax.jdo.option.ConnectionURL</name>
<value>jdbc:mysql://localhost:3306/hive?createDatabaseIfNotExist=true</value>
</property>
<property>
<name>javax.jdo.option.ConnectionDriverName</name>
<value>com.mysql.jdbc.Driver</value>
</property>
<property>
<name>javax.jdo.option.ConnectionUserName</name>
<value>root</value>
</property>
<property>
<name>javax.jdo.option.ConnectionPassword</name>
<value>Password@123</value>
</property>
</configuration>


上传 MySQL 连接器:
cp /root/mysql-connector-java-5.1.46.jar /export/servers/hive-3.1.1/lib/
初始化 MySQL 数据库:
schematool -initSchema -dbType mysql

4.Hive数据库的操作
连接 Hive:
hive

Hive基本操作

5.Hive表的操作
创建/查看/使用数据库:
创建数据库:
CREATE DATABASE school;
查看数据库:
SHOW DATABASES;
使用数据库:
USE school;
创建表:
CREATE TABLE students (
id INT COMMENT "学生 ID",
name STRING COMMENT "学生姓名",
gender STRING COMMENT "性别",
birth STRING COMMENT "出生日期",
class_id INT COMMENT "班级 ID"
) ROW FORMAT DELIMITED
FIELDS TERMINATED BY ',';
插入数据:
INSERT INTO students VALUES
(1, "张三", "男", "1999-01-01", 1),
(2, "李四", "女", "2000-02-02", 2),
(3, "王五", "男", "2001-03-03", 1);

创建另一个表:
CREATE TABLE grades (
student_id INT COMMENT "学生 ID",
subject STRING COMMENT "科目",
score INT COMMENT "分数"
) ROW FORMAT DELIMITED
FIELDS TERMINATED BY ',';

插入成绩数据:
INSERT INTO grades VALUES
(1, "数学", 90),
(1, "英语", 85),
(2, "语文", 80),
(3, "物理", 95);
查询所有学生的姓名和他们的成绩:
SELECT s.name, g.subject, g.score
FROM students s
JOIN grades g ON s.id = g.student_id;

6.总结(含错误分析)
在实验过程中,遇到了几个潜在的问题点,以下是对这些问题的分析:
- Hadoop服务启动失败:
- 如果systemctl start mysqld命令失败,并提示Unit not found,可能是因为MySQL服务未正确安装或服务名称不正确。需要确认MySQL是否已安装,并检查服务名称是否为mysqld。
- RPM包安装失败:
- 如果rpm -ivh命令失败,并提示找不到文件,可能是因为RPM包未在指定目录或系统中。需要确认RPM包的下载路径,并确保它们存在于系统中。
- Hive数据插入性能问题:
- 数据插入操作耗时204.924秒,可能存在性能瓶颈。需要分析MapReduce作业的配置和执行计划,检查是否有优化空间,比如调整Hive的配置参数或优化Hadoop集群的资源分配。
- HDFS读写性能:
- HDFS的读写操作可能受到网络带宽或存储性能的影响。需要监控HDFS的I/O性能,并根据需要进行调优。
- MapReduce作业失败:
- 如果MapReduce作业失败,需要检查Hadoop的日志文件,定位失败的原因。可能的原因包括配置错误、资源不足、数据格式问题等。
- Hive版本与Hadoop版本不兼容:
- 如果Hive操作失败,可能是因为Hive版本与Hadoop版本不兼容。需要确认Hive和Hadoop的版本兼容性,并在必要时升级或降级。
- 环境变量配置错误:
- 如果遇到JAVA_HOME未设置或路径错误的问题,需要检查环境变量的配置,并确保它们指向正确的Java安装路径。
- 网络配置问题:
- 如果Hadoop集群的节点间通信出现问题,需要检查网络配置,确保所有节点都能相互通信。
通过这些分析,我们可以更好地理解实验中可能遇到的问题,并为未来的实验和生产环境提供解决方案。
更多推荐

 29
 0
- 0


 已为社区贡献1条内容

所有评论(0)