
Java实现Dijkstra最短路径算法探索

简介:Dijkstra算法,由荷兰计算机科学家艾兹格·迪科斯彻于1956年提出,用于计算图中两节点间最短路径。本文详细解析了该算法的核心思想与Java实现方法,包括优先队列的使用和节点距离的更新。通过分析"ShortestPath.java"文件,掌握图的表示、算法逻辑以及主函数的代码细节。Dijkstra算法在路由选择、网络调度等领域的应用对于软件开发非常重要,通过本教程,读者可以将算法理论应用到实际编程中,提高解决问题的能力。 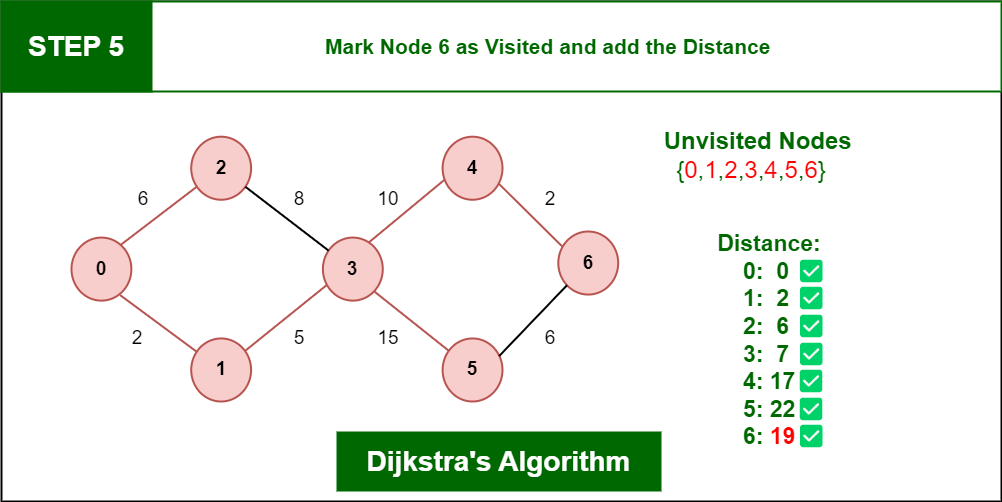
1. 图论和Dijkstra算法基础
图论是计算机科学中的一个重要领域,它使用数学的图形和网络来描述复杂问题中的对象和它们之间的关系。在图论中,图由节点(顶点)和边组成,边可以是有向的或无向的,还可以带有权重表示连接两个节点的成本或距离。Dijkstra算法是图论中用于寻找加权图中单源最短路径的经典算法之一。该算法由荷兰计算机科学家艾兹赫尔·戴克斯特拉于1956年提出,能够有效地找到某一节点到其他所有节点的最短路径。
算法的核心思想是贪心策略,它从起点出发,逐步扩展最短路径树,直至包含所有节点。Dijkstra算法的优点在于简单直观,易于实现,适用于没有负权重边的图。为了更好地理解这一算法,我们首先需要掌握图论的基础知识,并熟悉算法的基本流程,为深入探讨其优化和实际应用打下坚实的基础。接下来的章节将详细介绍如何用Java实现Dijkstra算法,并分析其在不同场景下的应用与优化。
2. Java实现Dijkstra算法的步骤
Dijkstra算法是图论中非常经典的单源最短路径算法,它能够计算出给定源点到图中所有其他节点的最短路径。本章节我们将一步步详细介绍如何用Java实现Dijkstra算法。
2.1 算法的初始化处理
2.1.1 图的结构定义
为了实现Dijkstra算法,首先要定义图的数据结构。在Java中,图可以通过邻接矩阵或邻接表来表示。在这里,我们选择使用邻接矩阵的方式,因为其适合稠密图的表示,并且方便查询任意两点之间的距离。
public class Graph {
    private final int vertices; // 顶点的数量
    private int[][] adjacencyMatrix; // 邻接矩阵

    public Graph(int vertices) {
        this.vertices = vertices;
        adjacencyMatrix = new int[vertices][vertices];
    }

    public void addEdge(int source, int destination, int weight) {
        adjacencyMatrix[source][destination] = weight;
        // 如果是无向图,还需要添加下面这行代码:
        // adjacencyMatrix[destination][source] = weight;
    }

    // 其他方法实现省略...
}
2.1.2 距离数组的初始化
初始化距离数组是算法开始的第一步,它负责记录从源点到各个顶点的初始距离。通常情况下,我们用一个足够大的数表示这两个顶点之间不存在路径,例如 Integer.MAX_VALUE 。
int[] distances = new int[vertices];
Arrays.fill(distances, Integer.MAX_VALUE);
distances[source] = 0;
2.2 算法的迭代过程
2.2.1 当前节点的选择
算法的每一步都需要从未处理的顶点中选择一个距离源点最近的顶点,这可以通过优先队列来实现。
// 使用优先队列来存储和选择当前距离最小的节点
PriorityQueue<Integer> queue = new PriorityQueue<>(vertices, ***paringInt(v -> distances[v]));
queue.add(source);
2.2.2 节点间距离的更新
对于当前顶点,更新其所有邻接顶点的距离。如果通过当前顶点到达邻接顶点的距离更短,就更新这个距离。
while (!queue.isEmpty()) {
    int current = queue.poll(); // 取出当前最小距离的顶点

    for (int i = 0; i < vertices; i++) {
        if (adjacencyMatrix[current][i] > 0) { // 如果存在一条边
            int distanceThroughCurrent = distances[current] + adjacencyMatrix[current][i];
            if (distanceThroughCurrent < distances[i]) {
                distances[i] = distanceThroughCurrent;
            }
        }
    }
}
2.2.3 标记节点为已处理
一旦一个节点的距离被更新,它就被认为是已处理的,其在优先队列中的次序就会固定。
boolean[] visited = new boolean[vertices];
visited[current] = true;
接下来,通过检查队列中剩余的元素来继续这个过程。
2.3 完整的Java实现
以下是一个完整的Java实现示例,它包含了初始化和迭代更新的完整过程:
import java.util.Arrays;
import java.util.PriorityQueue;
***parator;

public class DijkstraAlgorithm {

    public static void calculateShortestPath(Graph graph, int source) {
        int vertices = graph.getVertices();
        int[] distances = new int[vertices];
        boolean[] visited = new boolean[vertices];

        Arrays.fill(distances, Integer.MAX_VALUE);
        distances[source] = 0;

        PriorityQueue<Integer> queue = new PriorityQueue<>(vertices, ***paringInt(v -> distances[v]));
        queue.add(source);

        while (!queue.isEmpty()) {
            int current = queue.poll();
            if (visited[current]) continue;
            visited[current] = true;

            for (int i = 0; i < vertices; i++) {
                if (graph.getAdjacencyMatrix()[current][i] > 0) {
                    int distanceThroughCurrent = distances[current] + graph.getAdjacencyMatrix()[current][i];
                    if (distanceThroughCurrent < distances[i]) {
                        distances[i] = distanceThroughCurrent;
                    }
                }
            }
        }

        printDistances(distances);
    }

    private static void printDistances(int[] distances) {
        for (int i = 0; i < distances.length; i++) {
            System.out.println("Distance from source to vertex " + i + ": " + distances[i]);
        }
    }
}
以上代码中,我们定义了一个 Graph 类来表示图,并用一个整型数组 distances 来记录源点到每个顶点的距离。我们利用优先队列 PriorityQueue 来保证每次迭代能获取到当前距离最小的顶点。
在完成上述算法步骤之后,我们便实现了Dijkstra算法的基本逻辑。接下来的章节将对优先队列进行详细讲解,并深入讨论算法中的节点距离更新机制。
3. 优先队列在Dijkstra算法中的应用
3.1 优先队列的基本原理
3.1.1 优先队列的定义和性质
在计算机科学中,优先队列是一种抽象数据类型,它支持以下操作:插入一个新的对象到队列中;从队列中移除并返回具有最高优先级的对象;以及可选的,查询而不移除队列中优先级最高的对象。优先队列通常实现为堆结构,特别是二叉堆,这是因为它们能够在对数时间内完成插入和删除操作。
优先队列的核心特性是它维护了元素之间的优先级关系,使得每次移除的都是队列中优先级最高的元素。在图论问题中,特别是寻找最短路径的问题中,优先队列可以用来高效地选择下一个要处理的节点。其操作允许算法专注于尚未处理的、且距离源点最近的节点,这对优化Dijkstra算法至关重要。
3.1.2 Java中优先队列的实现
在Java中, PriorityQueue 类是优先队列的实现。这个类通过维持元素的自然顺序或者通过 Comparator 来定义元素的优先级。其基本用法非常简单,例如,我们可以这样定义一个优先队列:
PriorityQueue<Node> pq = new PriorityQueue<>(***paringInt(Node::getDistance));
这段代码定义了一个优先队列,其内部元素是 Node 类型的对象,队列按照节点的距离(从源点开始的最短距离)排序。
3.2 优先队列与Dijkstra算法的结合
3.2.1 优先队列优化选择当前节点
在Dijkstra算法中,节点的处理顺序非常关键。传统的Dijkstra算法使用一个队列来存储所有待处理的节点,并在每次迭代中选择队首节点进行处理。然而,这种方法的时间复杂度较高,因为它需要O(V)的时间来选择当前的节点,其中V是图中顶点的数量。
当结合了优先队列后,我们可以使用 poll() 方法来高效地选择当前距离最小的节点,这个操作的时间复杂度降低到O(log V)。这是因为优先队列在内部使用堆结构,能够快速调整堆结构来保持优先级顺序。
3.2.2 时间复杂度的降低
使用优先队列后,Dijkstra算法的时间复杂度得以降低。在不使用优先队列的情况下,Dijkstra算法的时间复杂度为O(V^2),其中V是顶点的数量。若使用邻接矩阵表示图,则总的时间复杂度为O(V^2)。但如果使用邻接表表示图,并结合优先队列,算法的时间复杂度可以降低到O((V+E)logV),其中E是边的数量。
这是因为优先队列的加入使得我们不需要遍历所有未处理的节点来找到距离最小的节点,而是可以在对数时间内完成这一操作。对于稠密图,这可以显著提高算法的效率。
优先队列在Dijkstra算法中的实际应用
优先队列在Dijkstra算法中的应用是现代实现中的一个关键优化点。由于它优化了节点的选择过程,使得算法能够以更高效的方式找到下一个要处理的节点。这种优化显著减少了算法的执行时间,特别是在处理大规模图时。
在实际的Java代码中,我们可以使用 PriorityQueue 类来实现这一功能。下面是一个简单的代码示例,展示了如何在Dijkstra算法中使用优先队列:
PriorityQueue<Node> pq = new PriorityQueue<>(***paringInt(Node::getDistance));
pq.add(startNode); // 添加起始节点

while (!pq.isEmpty()) {
    Node currentNode = pq.poll(); // 弹出距离最小的节点
    for (Edge edge : currentNode.getEdges()) {
        Node neighbor = edge.getNeighbor();
        // 更新邻居节点的距离
        double newDistance = currentNode.getDistance() + edge.getWeight();
        if (newDistance < neighbor.getDistance()) {
            neighbor.setDistance(newDistance);
            neighbor.setPrevious(currentNode);
            pq.add(neighbor);
        }
    }
}
在这个示例中,我们使用优先队列来存储所有节点,并在每次迭代中选择距离最小的节点进行处理。这种做法不仅简化了算法,而且减少了不必要的节点处理,从而提高了效率。
优先队列的优化效果
通过使用优先队列,Dijkstra算法可以实现更高效的节点处理。传统的Dijkstra算法通过顺序遍历来选择节点,这在节点数量较多时会非常耗时。而优先队列通过堆数据结构保持了最小元素始终位于队列的前端,使得每次取出最小元素的操作仅需对数时间复杂度。
在实践中,结合优先队列的Dijkstra算法在处理如地图上的路径搜索等问题时,其性能提升尤为明显。它不仅减少了算法的整体运行时间,而且也提高了算法对复杂网络的适应能力。
优先队列在Dijkstra算法中的应用不仅限于理论上的讨论,其在现实世界中的应用也是广泛而深远的。从导航系统到网络路由算法,再到各种优化问题的求解,优先队列和Dijkstra算法的组合已经成为很多解决方案的核心。
4. 节点距离更新机制
4.1 距离更新的必要性
4.1.1 最短路径的理论基础
最短路径问题在图论中是一个核心问题,其目标是找到两个节点之间的最小权重路径。Dijkstra算法利用贪心策略,不断选择当前认为最短的路径进行探索,来寻找最终的最短路径。为了实现这一点,算法需要一个有效的方式来更新节点间的距离。每当探索一条边时,算法必须评估通过这条边是否能获得更短的路径。如果可以,就需要更新距离值。
4.1.2 更新机制在算法中的作用
更新机制是Dijkstra算法的核心环节,它保证了算法能够逐步逼近真实的最短路径。在每次迭代中,算法选择一个未处理的节点,并更新从起点到其他所有未处理节点的距离。通过这种方式,算法逐步改进路径估计,直到找到所有节点的最短路径为止。理解更新机制如何工作,对于理解Dijkstra算法的整体过程至关重要。
4.2 距离更新策略详解
4.2.1 更新规则的数学解释
更新规则可由以下不等式描述:设 d[u] 是从起点 s 到节点 u 的当前估计最短距离, d[v] 是从起点 s 到节点 v 的当前估计最短距离, (u, v) 是图中的一条边,且其权值为 w(u, v) 。如果 d[u] + w(u, v) < d[v] ,则表示通过节点 u 到达节点 v 的路径比当前记录的从 s 到 v 的路径更短。此时,算法更新 d[v] 为 d[u] + w(u, v) 。
4.2.2 代码中的距离更新实现
让我们看一个Java代码示例,实现距离更新逻辑:
// Java代码段
for (Edge edge : graph.getEdges(source)) {
    int destination = edge.getDestination();
    int weight = edge.getWeight();
    if (distanceToSource[destination] > distanceToSource[source] + weight) {
        distanceToSource[destination] = distanceToSource[source] + weight;
    }
}
代码逻辑解读分析: - for 循环遍历从当前节点 source 出发的所有边。 - destination 是边的终点。 - weight 是边的权重。 - 条件判断语句检查是否可以通过当前节点 source 来更新到终点 destination 的最短路径估计。如果当前路径估计更短,就执行更新操作。
参数说明: - distanceToSource :一个数组,用来存储从起点到每个节点的最短路径估计值。 - graph :图的邻接表或邻接矩阵表示。 - source :当前正在处理的节点。
通过这种方式,算法能够逐步构建出从起点到图中所有其他节点的最短路径。每次更新都基于当前的最短路径估计,并在找到更短路径时进行更新,这样保证了算法在每一步的决策都是基于局部最优的选择。
5. 图的表示方法(邻接矩阵或邻接表)
5.1 邻接矩阵的定义和使用
5.1.1 邻接矩阵的特点
邻接矩阵是图论中用于表示图的一种方法,它用一个二维数组来存储图中各顶点之间的连接信息。具体来说,一个图的邻接矩阵表示形式为一个n×n的矩阵,其中n是图中顶点的数量。如果顶点i与顶点j之间有边,则矩阵的第i行第j列的元素为1(或者边的权重),否则为0。
邻接矩阵有几个显著特点:
- 直观性 :由于邻接矩阵将图的结构直观地表现为数组形式,因此它的构建和理解较为直观,适合于稠密图(即边数接近顶点数平方的图)。
- 固定大小 :不管图中边的多少,邻接矩阵的大小始终是n×n,这意味着它适合用于顶点数量固定的场景。
- 计算便利 :使用邻接矩阵进行图的遍历(如深度优先搜索或广度优先搜索)时较为方便。
- 空间复杂度高 :对于稀疏图(边数较少的图),邻接矩阵的空间复杂度较高,因为它存储了大量的无用信息(即0值)。
5.1.2 Java中邻接矩阵的构建和使用
在Java中,我们可以使用二维数组来实现邻接矩阵。以下是一个简单的例子,展示了如何构建一个无权图的邻接矩阵:
int[][] adjacencyMatrix = new int[n][n]; // 假设n是图中顶点的数量

// 初始化邻接矩阵,所有值为0
for (int i = 0; i < n; i++) {
    for (int j = 0; j < n; j++) {
        adjacencyMatrix[i][j] = 0;
    }
}

// 假设存在边(i, j),则将对应位置设置为1
adjacencyMatrix[1][2] = 1;
adjacencyMatrix[2][3] = 1;
// ... 其他边的设置
为了表示有权图,只需将初始化的0值替换为相应的权重值即可。使用邻接矩阵时,可以快速查询任意两个顶点之间的连接情况。
5.2 邻接表的定义和使用
5.2.1 邻接表的特点
邻接表是图的另一种表示方法,它用数组和链表的组合来存储图。每个顶点都有一个链表,链表中包含所有与该顶点直接相连的顶点。在无向图中,每条边在邻接表中出现两次,一次对应两个顶点。
邻接表的特点包括:
- 空间效率 :对于稀疏图来说,邻接表的空间效率比邻接矩阵更高。
- 动态数据结构 :邻接表能够有效地动态添加或删除边。
- 实现复杂度 :相对于邻接矩阵,邻接表的实现略显复杂,因为需要管理链表结构。
- 查询效率 :查询特定顶点的邻接点时,邻接表的效率较低,需要遍历链表。
5.2.2 Java中邻接表的构建和使用
在Java中,我们通常使用 ArrayList 或者 LinkedList 来构建邻接表。下面是一个无权图的邻接表构建示例:
List<List<Integer>> adjacencyList = new ArrayList<>(n); // 假设n是顶点的数量

// 初始化邻接表,每个顶点的链表
for (int i = 0; i < n; i++) {
    adjacencyList.add(new ArrayList<>());
}

// 添加边,例如添加边(i, j)
adjacencyList.get(i).add(j);
adjacencyList.get(j).add(i);
对于有权图,可以使用 Map<Integer, Integer> 来存储每个邻接点及其对应的权重。
总结来说,邻接矩阵适合稠密图,其访问速度快,而邻接表适合稀疏图,更加节省空间。在实际应用中,应根据图的性质和需求选择合适的表示方法。
6. Java代码实现与分析("ShortestPath.java"文件)
6.1 Java代码框架概览
6.1.1 代码结构的组织
在Java中实现Dijkstra算法的代码结构,首先包含了图的表示方法(邻接矩阵或邻接表),其次定义了算法的主要流程。Java代码框架通常会以类的形式进行组织,其中包括数据成员用于存储图的结构、距离数组和标记数组,以及方法成员用于执行初始化过程和主循环迭代。
class ShortestPath {
    int[] distances; // 存储节点间的最短距离
    boolean[] visited; // 标记节点是否已被处理
    int[][] graph; // 邻接矩阵表示图

    public ShortestPath(int[][] graph) {
        this.graph = graph;
        this.distances = new int[graph.length];
        this.visited = new boolean[graph.length];
    }

    public void dijkstra(int startVertex) {
        // 初始化处理
        // 主循环迭代
    }

    private void initializeDistances(int startVertex) {
        // 初始化距离数组
    }

    private void updateDistances(int currentVertex, int[] minDistances) {
        // 更新节点间的最短距离
    }

    private void processVertex(int vertex) {
        // 处理节点逻辑
    }

    private void printSolution() {
        // 打印最短路径结果
    }
}
6.1.2 主要函数和类的作用
-
ShortestPath类:用于封装Dijkstra算法实现的主体逻辑。 -
dijkstra(int startVertex)方法:算法入口,执行从起始顶点到其他所有顶点的最短路径计算。 -
initializeDistances(int startVertex)方法:负责距离数组的初始化,并将起始顶点到自身的距离设置为0。 -
updateDistances(int currentVertex, int[] minDistances)方法:用于更新距离数组中各顶点到起始顶点的最短距离。 -
processVertex(int vertex)方法:执行处理当前顶点的逻辑。 -
printSolution()方法:输出计算结果,即所有顶点到起始顶点的最短路径。
6.2 关键代码段解读
6.2.1 初始化过程的实现
初始化是Dijkstra算法的第一步。初始化过程中需要将所有距离设置为无穷大,除了起点到自己的距离,这个距离为0。同时,将所有节点标记为未处理状态。
private void initializeDistances(int startVertex) {
    for (int i = 0; i < distances.length; i++) {
        distances[i] = Integer.MAX_VALUE;
    }
    distances[startVertex] = 0;
    visited[startVertex] = true;
}
6.2.2 主循环的逻辑分析
主循环是算法的核心部分,它反复从距离数组中选择最小距离的未处理节点作为当前节点,然后更新其邻接节点的距离,并将当前节点标记为已处理。
public void dijkstra(int startVertex) {
    initializeDistances(startVertex);
    for (int i = 1; i < graph.length; i++) {
        int currentVertex = findMinDistanceVertex(minDistances);
        processVertex(currentVertex);
    }
}

private int findMinDistanceVertex(int[] minDistances) {
    int minDistance = Integer.MAX_VALUE;
    int minDistanceIndex = -1;
    for (int i = 0; i < distances.length; i++) {
        if (!visited[i] && minDistances[i] <= minDistance) {
            minDistance = minDistances[i];
            minDistanceIndex = i;
        }
    }
    return minDistanceIndex;
}
6.2.3 结果输出和验证
在算法执行完毕后,需要验证算法的正确性。输出每个节点到起始节点的最短距离,可以进一步与已知的解决方案或预期结果进行比较。
private void printSolution() {
    for (int i = 0; i < distances.length; i++) {
        System.out.println("The shortest distance from vertex " + 0 + " to vertex " + i + " is " + distances[i]);
    }
}
上述代码段是Dijkstra算法实现的核心,通过详细解释每个步骤,我们可以看到算法如何从初始化开始,经过反复的主循环迭代,最终得到每个节点到起始节点的最短路径,并将结果输出以供验证。这种分析方式不仅有助于理解算法的逻辑,而且对于发现潜在的问题或优化点也非常有用。
简介:Dijkstra算法,由荷兰计算机科学家艾兹格·迪科斯彻于1956年提出,用于计算图中两节点间最短路径。本文详细解析了该算法的核心思想与Java实现方法,包括优先队列的使用和节点距离的更新。通过分析"ShortestPath.java"文件,掌握图的表示、算法逻辑以及主函数的代码细节。Dijkstra算法在路由选择、网络调度等领域的应用对于软件开发非常重要,通过本教程,读者可以将算法理论应用到实际编程中,提高解决问题的能力。
更多推荐

 24
 0
- 0


 已为社区贡献10条内容

所有评论(0)