
leetcode LRU 缓存
leetcode: LRU 缓存
时间和空间结合了起来。使用双向链表的典型案例。
LRU 全称为 Least Recently Used,最近最少使用,常常用于缓存机制,比如 cpu 的 cache 缓存,使用了 LRU 算法。为什么要使用LRU算法,因为缓存的空间是有限的,LRU 用于缓存机制时,关键的是当缓存满的时候有新数据需要加载到缓存时,这个时候需要淘汰谁的问题。
如下图所示,表示 LRU 算法的过程。假如有一个缓存,共有 4 个存储空间,按访问时间进行排序,最左边的存储空间存储的是最近访问的数据,最右边的存储空间存储的是最长时间没有访问的数据。
(1)一开始,缓存是空的,这个时候向缓存中放入一个数据 100,100 放到最左边的存储空间
(2)向缓存中放入一个数据 50,此时缓存有空余空间,所以将已有的数据向后移动,将 50 放到缓存的最左边
(3)向缓存中放入数据 500, 步骤与上一步相同
(4)向缓存中放入数据 1000,步骤与上一步相同
(5)读取数据 100,读取之后 100 就是最后访问的数据了,所以将 100 移到缓存的最左边,其它数据依次向后移动
(6)向缓存中放入数据 1,此时缓存是满的,所以需要先淘汰一个数据,从访问时间来看,最后一次访问 50 的间隔时间最长,也就是排在最右边的数据,所以将 50 淘汰,其它数据向后移动,将新数据 1 放入最左边的位置

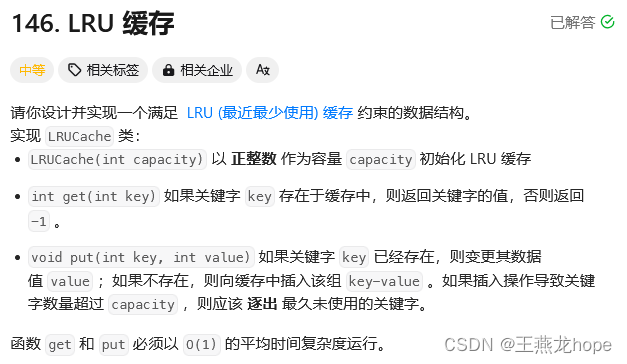
如下是题目描述,题目的最后要求 get和 put的时间复杂度都要是 O(1) 的。使用数组来表示缓存难以满足 O(1) 的要求,因为在 put 或者 get 的时候,会引起数组数据的移动,数组中数据的移动时间复杂度是 O(n) 的,所以需要使用链表来表示缓存。当访问一个数据的时候需要将当前这个数据从原来的位置上删除,然后加到链表的头部,删除一个节点的话,需要将这个节点的前一个节点和下一个节点连接起来,如果使用单向链表的话,那么只能找到这个节点的下一个节点,找不到上一个节点,所以需要使用双向链表。

(1)使用双向循环链表来表示缓存
(2)为了满足时间复杂度是 O(1) 的要求,使用 data_addr_ 数组来保存节点的地址,数组的下标是 key,题目中说明了 key 的取值范围是 [0, 10000],所以可以使用一个数组来表示。使用 map 也不能保证时间复杂度是 O(1) 的,map 一般使用红黑树来实现,时间复杂度是 O(logn) 的。把数组的下标当 key,数组元素的值就是值,数组本身也可以看做一个简单的 map。题目中如果说明了元素的取值范围,并且不是很大,那么这种题目往往就可以使用数组来表示数据,将数组的下标赋予实际的意义。
(3)当 put 数据时,要进行判断现在缓存是不是满了,如果满的话需要删除最久没有访问的数据,head_->next 保存最新访问的数据,head_->prev 保存最久没有访问的数据。head专门用于管理,head中不保存数据。
struct Node {
    int key;
    int value;
    //结构体内部成员可以使用结构体自己,有时候这么写会吓自己一跳
    struct Node *next;
    struct Node *prev;
};

class LRUCache {
public:
    LRUCache(int capacity) {
      capacity_ = capacity;
      head_ = new Node();
      // 初始化环形链表
      head_->next = head_;
      head_->prev = head_;
    }

    int get(int key) {
        Node *node = data_addr_[key];
        if (node == nullptr) {
            return -1;
        }

        ListUnLink(node);
        ListLinkHead(node);
        return node->value;
    }

    void put(int key, int value) {
      if (data_addr_[key] != nullptr) {
        // key是已经存在的,更新数据,然后将数据放到缓存的头部
        Node *node = data_addr_[key];
        ListUnLink(node);
        node->value = value;
        ListLinkHead(node);
      } else {
        Node *new_node = new Node();
        new_node->key = key;
        new_node->value = value;
        new_node->next = nullptr;
        new_node->prev = nullptr;

        // 缓存已经满了,需要删除最长时间没有访问的数据
        if (count_ == capacity_) {
            Node *to_delete = head_->prev;
            ListUnLink(to_delete);
            data_addr_[to_delete->key] = nullptr;
            delete to_delete;
            count_--;
        }

        ListLinkHead(new_node);
        data_addr_[key] = new_node;
        count_++;
      }
    }

    void ListLinkHead(struct Node *ele) {
        ele->next = head_->next;
        ele->next->prev = ele;

        head_->next = ele;
        ele->prev = head_;
    }

    void ListUnLink(struct Node *ele) {
        ele->prev->next = ele->next;
        ele->next->prev = ele->prev;
    }

private:
    int capacity_ = 0;
    int count_ = 0;
    Node *data_addr_[10001] = {nullptr};
    struct Node *head_ = nullptr;

};更多推荐
 5
 0
- 0


 已为社区贡献5条内容

所有评论(0)