
Python 蜻蜓fm有声书批量下载 支持账号登录 原创源码,大厂算法面试
message = data.encode(‘utf-8’)
key = “fpMn12&38f_2e”.encode(‘utf-8’)
sign = hmac.new(key, message, digestmod=‘MD5’).hexdigest()
whole_url = base_url+data+“&sign=”+sign
print(whole_url)
得到一个音频可以做到了剩下的就是得到一堆了,其实我们得到每个音频的id就可以了
我请求的是这个接口
info_api = ‘https://i.qingting.fm/capi/channel/{self.bookid}/programs/{self.version}?curpage={str(page)}&pagesize=30&order=asc’
version在声书主页的源代码中,只要改curpage就可以翻页了
完整源码
import requests
import re
import hmac
import time
from tqdm import tqdm
from bs4 import BeautifulSoup
import os
import json
import sys
import urllib3
urllib3.disable_warnings()
class QingTing():
def init(self,user_id,password,bookurl,ifLogin):
self.ifLogin = ifLogin
self.user_id = user_id
self.password = password
self.session = requests.session()
self.session.headers.update({‘user-agent’: ‘Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/79.0.3945.130 Safari/537.36’})
self.login_url = “https://u2.qingting.fm/u2/api/v4/user/login”
self.qingting_id = ‘’
self.access_token = ‘’
self.bookurl = bookurl
self.bookurl = ‘https://www.qingting.fm/channels/257790’
self.bookid = self.bookurl.split(‘/’)[-1]
self.version = ‘’
self.qingtinghost = ‘https://audio.qingting.fm’
self.save_path = ‘’
self.bookname = ‘’
def login(self,user_id,password):
data = {
‘account_type’: ‘5’,
‘device_id’: ‘web’,
‘user_id’: user_id,
‘password’: password
}
response = self.session.post(self.login_url,data=data,verify=False)
if response.status_code==200:
temp = response.json()
errorno = temp[‘errorno’]
errormsg = temp[‘errormsg’]
if errorno == 0:
print(‘login successful!’,‘登录成功!’)
data = temp[‘data’]
self.qingting_id = data[‘qingting_id’]
self.access_token = data[‘access_token’]
else:
print(‘Login failed’,‘登录失败’)
print(errormsg)
time.sleep(10)
sys.exit(0)
def __get_version(self):
response = self.session.get(url=self.bookurl,verify=False)
if response.status_code==200:
soup = BeautifulSoup(response.text,‘lxml’)
temp_bookname = soup.select(‘div.album-info-root > div.top > div.info.right > h1’)[0].string
replaced_pattern = ‘[\/😗?"<>|]’
self.bookname = re.sub(replaced_pattern,’ ',temp_bookname,flags=re.M +re.S)
if not os.path.exists(self.bookname):
os.makedirs(self.bookname)
matched = re.search(‘“version”:“(\w+)”’,response.text,re.S)
if matched:
version = matched.group(1)
self.version = version
return version
def __get_total_page(self):
self.__get_version()
page = 1
info_api = f’https://i.qingting.fm/capi/channel/{self.bookid}/programs/{self.version}?curpage={str(page)}&pagesize=30&order=asc’
response = self.session.get(info_api,verify=False)
if response.status_code==200:
temp = response.json()
total = temp[‘data’][‘total’]
total_page = int(int(total)/30)+1
return total,total_page
def get_book_info(self):
total,total_page = self.__get_total_page()
print(self.bookname,‘共{}集’.format(total))
for page in range(1,total_page+1):
info_api = f’https://i.qingting.fm/capi/channel/{self.bookid}/programs/{self.version}?curpage={str(page)}&pagesize=30&order=asc’
response = self.session.get(info_api,verify=False)
programs = response.json()[‘data’][‘programs’]
for program in programs:
print(program[‘id’],program[‘title’])
yield program
def get_src(self,id):
bookid = self.bookid
access_token = self.access_token
qingting_id =self.qingting_id
timestamp = str(round(time.time()*1000))
data = f"/audiostream/redirect/{bookid}/{id}?access_token={access_token}&device_id=MOBILESITE&qingting_id={qingting_id}&t={timestamp}"
message = data.encode(‘utf-8’)
key = “fpMn12&38f_2e”.encode(‘utf-8’)
sign = hmac.new(key, message, digestmod=‘MD5’).hexdigest()
whole_url = self.qingtinghost+data+“&sign=”+sign
return whole_url
def downloadFILE(self,url,name):
resp = self.session.get(url=url,stream=True,verify=False)
if resp.headers[‘Content-Type’] ==‘audio/mpeg’:
content_size = int(int(resp.headers[‘Content-Length’])/1024)
with open(name, “wb”) as f:
print(“Pkg total size is:”,content_size,‘k,start…’)
for data in tqdm(iterable=resp.iter_content(1024),total=content_size,unit=‘k’,desc=name):
f.write(data)
print(name , “download finished!”)
else:
errorno = resp.json()[‘errorno’]
errormsg = resp.json()[‘errormsg’]
print(‘没有权限下载,请登录已购此音频的账号。’)
print(‘errorno:’,errorno,errormsg)
def run(self):
if self.ifLogin:
self.login(self.user_id,self.password)
programs = self.get_book_info()
count = 0
for program in programs:
count+=1
try:
id = program[‘id’]
title = str(count).zfill(4)+’ ‘+program[‘title’]+’.m4a’
if not self.bookname ==‘’:
title = os.path.join(self.bookname,title)
whole_url = self.get_src(id)
self.downloadFILE(whole_url,title)
except Exception as e:
print(e)
with open(‘log.txt’,‘a’,encoding=‘utf-8’) as f:
f.write(str(count)+str(e)+‘\n’)
def get_config_info():
with open(‘config.json’,‘r’,encoding=‘utf-8’) as f:
自我介绍一下,小编13年上海交大毕业,曾经在小公司待过,也去过华为、OPPO等大厂,18年进入阿里一直到现在。
深知大多数Python工程师,想要提升技能,往往是自己摸索成长或者是报班学习,但对于培训机构动则几千的学费,着实压力不小。自己不成体系的自学效果低效又漫长,而且极易碰到天花板技术停滞不前!
因此收集整理了一份《2024年Python开发全套学习资料》,初衷也很简单,就是希望能够帮助到想自学提升又不知道该从何学起的朋友,同时减轻大家的负担。


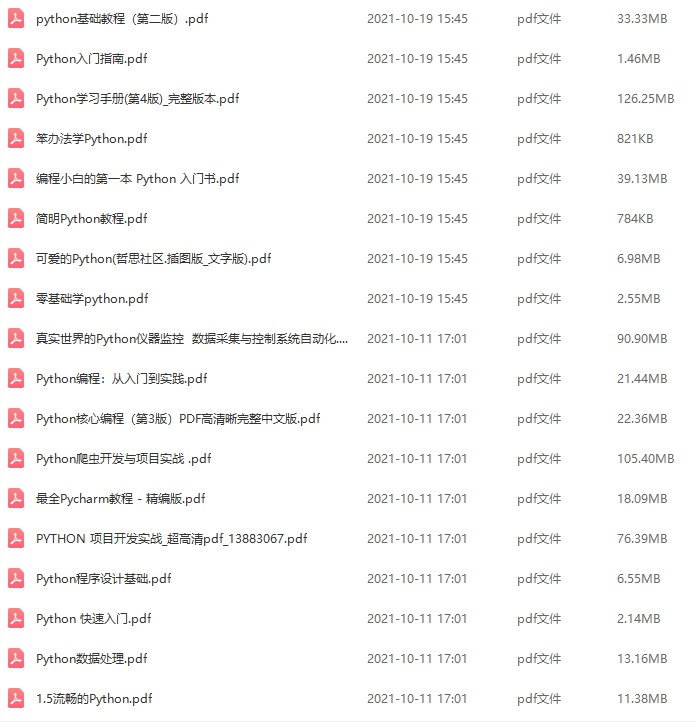
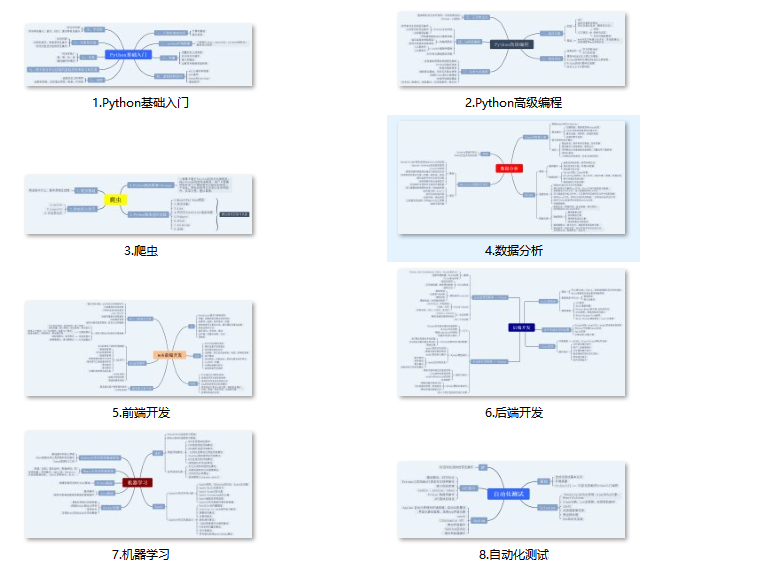
既有适合小白学习的零基础资料,也有适合3年以上经验的小伙伴深入学习提升的进阶课程,基本涵盖了95%以上Python开发知识点,真正体系化!
由于文件比较大,这里只是将部分目录大纲截图出来,每个节点里面都包含大厂面经、学习笔记、源码讲义、实战项目、讲解视频,并且后续会持续更新
如果你觉得这些内容对你有帮助,可以添加V获取:vip1024c (备注Python)

一、Python所有方向的学习路线
Python所有方向路线就是把Python常用的技术点做整理,形成各个领域的知识点汇总,它的用处就在于,你可以按照上面的知识点去找对应的学习资源,保证自己学得较为全面。
二、学习软件
工欲善其事必先利其器。学习Python常用的开发软件都在这里了,给大家节省了很多时间。

三、入门学习视频
我们在看视频学习的时候,不能光动眼动脑不动手,比较科学的学习方法是在理解之后运用它们,这时候练手项目就很适合了。

一个人可以走的很快,但一群人才能走的更远。不论你是正从事IT行业的老鸟或是对IT行业感兴趣的新人,都欢迎扫码加入我们的的圈子(技术交流、学习资源、职场吐槽、大厂内推、面试辅导),让我们一起学习成长!

它们,这时候练手项目就很适合了。
一个人可以走的很快,但一群人才能走的更远。不论你是正从事IT行业的老鸟或是对IT行业感兴趣的新人,都欢迎扫码加入我们的的圈子(技术交流、学习资源、职场吐槽、大厂内推、面试辅导),让我们一起学习成长!
[外链图片转存中…(img-X86j3NZY-1712698769955)]
更多推荐


 7
 0
- 0


 已为社区贡献4条内容

所有评论(0)