
一零三四、spark读取保存csv,并指定其参数
·
原数据
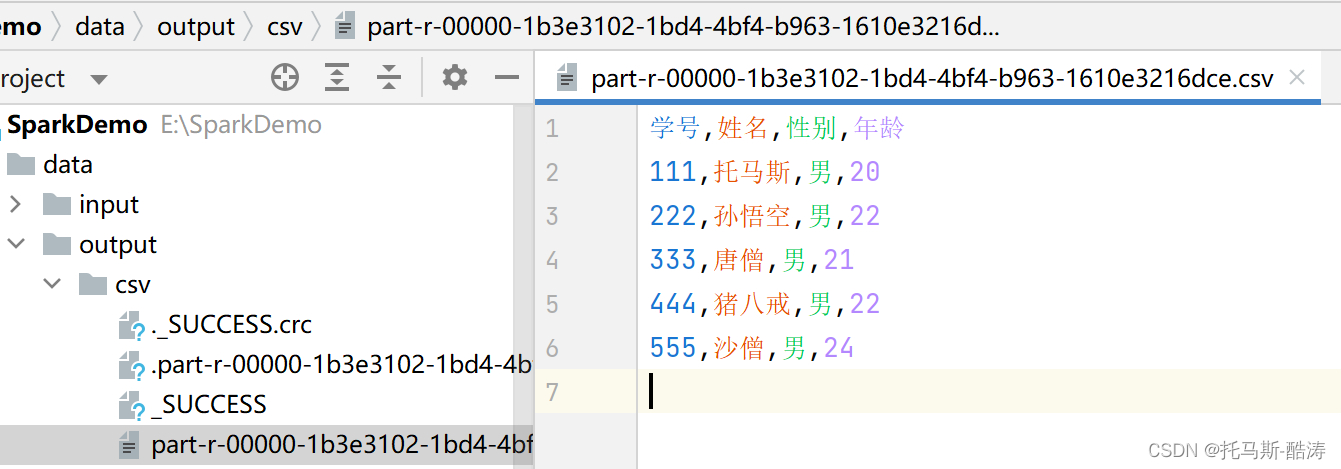
学号,姓名,性别,年龄
111,托马斯,男,20
222,孙悟空,男,22
333,唐僧,男,21
444,猪八戒,男,22
555,沙僧,男,24
代码
package org.example.test

import org.apache.log4j.{Level, Logger}
import org.apache.spark.sql.{DataFrame, SparkSession}

object RDD_saveAsTestFile {
  def main(args: Array[String]): Unit = {
    val spark: SparkSession = SparkSession.builder().appName("rdd_saveastestfile").master("local[*]").config("spark.sql.warehouse.dir", "C:/").getOrCreate()

    Logger.getLogger("org").setLevel(Level.ERROR)
    //方式一
    val value1 = spark.read
      .option("header", true)
      .option("encoding", "gbk")
      .option("multiLine", true)
      .csv("data/input/jd_example.csv")
    //方式二
    val value2: DataFrame = spark.read
      .format("csv")
      .option("header", true)
      .option("encoding", "gbk")
      .option("multiLine", true)
      .load("data/input/jd_example.csv")

    value1.show()
    value2.show()

    value1.repartition(1).write.option("header", true).csv("data/output/csv")
  }
}
指定参数
format:指定读取csv文件。
header:是否指定头部行作为schema。
multiLine:在单元格中可能因为字数多有换行,但是不指定这个参数,处理数据时可能会报错。指定这个参数为true,可以将换行的单元格合并为1行。
encoding:指定编码格式如gbk或utf-8
| 参数 | 解释 |
| header | 默认是false,将第一行作为列名 |
| encoding | 默认是uft-8通过给定的编码类型进行解码 |
| sep | 默认是, 指定单个字符分割字段和值 |
| inferSchema | inferSchema(默认为false`):从数据自动推断输入模式。 *需要对数据进行一次额外的传递 |
| multiLine | 默认是false,解析一条记录,该记录可能跨越多行 |
| inferSchema | inferSchema(默认为false`):从数据自动推断输入模式。 *需要对数据进行一次额外的传递。如:option("inferSchema", true.toString) //这是自动推断属性列的数据类型 |
| nullValue | 默认是空的字符串,设置null值的字符串表示形式。从2.0.1开始,这适用于所有支持的类型,包括字符串类型 |
| emptyValue |
默认是空字符串,设置一个空值的字符串表示形式 |
控制台
+---+---+---+---+
| 学号| 姓名| 性别| 年龄|
+---+---+---+---+
|111|托马斯|  男| 20|
|222|孙悟空|  男| 22|
|333| 唐僧|  男| 21|
|444|猪八戒|  男| 22|
|555| 沙僧|  男| 24|
+---+---+---+---+

+---+---+---+---+
| 学号| 姓名| 性别| 年龄|
+---+---+---+---+
|111|托马斯|  男| 20|
|222|孙悟空|  男| 22|
|333| 唐僧|  男| 21|
|444|猪八戒|  男| 22|
|555| 沙僧|  男| 24|
+---+---+---+---+
输出文件
更多推荐


 0
 0
- 0


 已为社区贡献3条内容

所有评论(0)