
hadoop spark环境搭建及idea scala maven集成开发spark任务
1.项目背景
公司目前已经部署了分布式文件存储和计算平台(已经上线hadoop,spark,hbase等),业务数据已经以文件的形式存储在hdfs中,业务部门经常提出各种数据需求,因此需要基于spark计算平台开发各种计算任务。公司目前的分布式平台只有一套线上环境,为了避免在学习、测试spark开发的过程中对线上环境造成污染,经过运维同事的规划,提供一台配置较高的pc用于搭建单机(standalone模式)的hadoop + spark测试环境,希望通过该环境 了解和熟悉 hadoop,spark的运行模块,机制,流程以及常用操作命令;通过ide开发spark的经典例子WordCount向spark平台提交计算和查看结果。(个人qq:498676231欢迎同仁交流和指正下面博客内容中的问题和错误)
2.主要技术和工具清单 ref-software-list.1
os:Linux-centos-6.5
maven:ver-3.1.0
jvm:ver-jdk-1.7.0_79(不要使用1.8.x,会导致编译失败)
scala:ver-2.10.5
hadoop:ver-2.6.0-cdh5.12.0
spark:ver-1.6.0
idea:ver-2016.3
3.hadoop + spark 环境搭建简单说明
安装过程中的工具清单见 ref-software-list.1,maven,jdk,scala的安装过程比较简单,去各自官网下载对应版本的软件然后解压并配置环境变量即可正常使用了。下面简单介绍一下hadoop,spark的standalone模式的安装(安装在单台主机,伪集群模式),安装方式一般有两种:
q3. 需要修改的相关配置文件
a3.
/etc/hosts 中追加 172.168.xx.xx cdh1 #172.168.xx.xx是当前安装主机的ip,cdh1是hostname产生的网络名称
/etc/sysconfig/network 中内容如下:
NETWORKING=YES
HOSTNAME=cdh1
GATEWAY=172.168.xx.xx
/etc/hadoop/conf 目录下hdfs相关配置文件如下:
core-site.xml
<?xml version="1.0"?>
<?xml-stylesheet type="text/xsl" href="configuration.xsl"?>
<configuration>
    <property>
	<name>fs.defaultFS</name>
	<value>hdfs://cdh1:8020</value>
    </property>
    <!--
    <property>
   	<name>fs.default.name</name>
    	<value>hdfs://cdh1:8020/</value>
    </property>
    -->
</configuration>cdh1:8020/</value>
    </property>
    -->
</configuration>
hdfs-site.xml
<?xml version="1.0"?>
<?xml-stylesheet type="text/xsl" href="configuration.xsl"?>
<configuration>
  <property>
     <name>dfs.namenode.name.dir</name>
     <value>file:///var/lib/hadoop-hdfs/cache/hdfs/dfs/name</value>
  </property>
  <property>
     <name>dfs.datanode.data.dir</name>
     <value>file:///var/lib/hadoop-hdfs/cache/hdfs/dfs/data</value>
  </property>
  <property>
     <name>dfs.permissions.superusergroup</name>
     <value>hadoop</value>
  </property>
  <property>
	<name>dfs.replication</name>
	<value>1</value>
  </property>
</configuration>
mapred-site.xml
<?xml version="1.0"?>
<?xml-stylesheet type="text/xsl" href="configuration.xsl"?>
<configuration>
    <property>
	<name>mapred.job.tracker</name>
	<value>cdh1:9001</value>
    </property>
</configuration>
/etc/spark/conf 目录下相关配置文件
spark-defaults.conf
spark.master                     spark://cdh1:7077
spark.eventLog.enabled           true
spark.eventLog.dir               /user/spark/applicationHistory
spark.history.provider		   org.apache.spark.deploy.history.FsHistoryProvider
spark.yarn.historyServer.address	http://cdh1:18080
spark-env.sh中添加修改:
export SPARK_HISTORY_OPTS="-Dspark.history.ui.port=18080 -Dspark.history.retainedApplications=10 -Dspark.history.fs.logDirectory=/user/spark/applicationHistory"
/etc/profile中添加spark的环境变量
export SPARK_HOME=/usr/lib/spark
q4. 启动相关的组件服务
a4.
首先启动hdfs的namenode服务,(第一次)启动前先格式化namenode
hadoop namenode -format
然后执行启动hdfs namenode的命令
/etc/init.d/hadoop-hdfs-namenode restart
#抛出/var/lib/hadoop-hdfs/cache/hdfs/dfs/name/current/VERSION 权限不够的问题
#因为hadoop安装完成之后,hdfs对文件的处理是hdfs用户,该用户没有/var/lib/hadoop-hdfs目录的操作权限
执行如下命令给hdfs分配/var/lib/hadoop-hdfs目录的操作权限
chown hdfs.hdfs /var/lib/hadoop-hdfs -R
依次执行以下命令:
/etc/init.d/hadoop-hdfs-namenode restart
/etc/init.d/hadoop-hdfs-datanode restart
/etc/init.d/spark-master restart
/etc/init.d/spark-worker restart
/etc/init.d/spark-history-server restart
所有服务启动之后,执行jps,查看所有相关的已经正常启动的服务
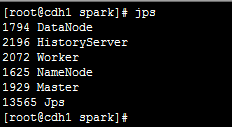
运行一个spark自带的例子检验一切是ok的。
$SPARK_HOME/bin/run-example SparkPi 10,输出如下(无异常抛出):

到目前为止hadoop和spark的安装基本完成!!!
4.scala + spark 项目集成与打包
hadoop,spark搭建完成之后,接下来就是基于spark(目前支持java,scala,python,r等开发语言)写一个"hello world"了。选择scala作为开发语言(spark是基于scala开发的开源框架,先前版本似乎是不支持java的,最近两年发布的版本已经提供了相关的java api开发接口)。使用scala开发spark 官网推荐的标配是idea+sbt(个人之前一直习惯使用eclipse + maven开发,做这个例子的时候,开始使用的ide是scala-IDE,就是普通eclipse中安装了一个开发scala的插件。在本地安装完scala之后配置scala-IDE的全局scala-library,工程里面的代码通过按住ctrl链接过去的源码是乱的,另外工程中常报一些奇怪的错误,其原因要么是个人配置有问题要么是eclipse 和 scala-plugin的兼容性不好,于是放弃了scala-IDE;另外maven是良好支持scala相关的包资源管理的,因此个人还是选择了idea + maven 作为开发环境),示例选择了idea + maven,idea里不直接支持scala的开发,也需要安装插件。
idea + scala + maven 环境的配置参考 利用IntelliJ IDEA与Maven开始你的Scala之旅
两点容易出问题的地方:

<project>
  <groupId>com.oreilly.learningsparkexamples.mini</groupId>
  <artifactId>learning-spark-mini-example</artifactId>
  <modelVersion>4.0.0</modelVersion>
  <name>example</name>
  <packaging>jar</packaging>
  <version>0.0.1</version>
	<repositories>
		<repository>
			<id>jboss</id>
			<name>Maven of jboss.org</name>
			<url>http://repository.jboss.org/nexus/content/groups/public/</url>
			<releases>
				<enabled>true</enabled>
			</releases>
			<snapshots>
				<enabled>true</enabled>
			</snapshots>
			<layout>default</layout>
		</repository>

		<repository>
			<id>oschina</id>
			<name>Maven of oschina.net</name>
			<url>http://maven.oschina.net/content/groups/public/</url>
			<releases>
				<enabled>true</enabled>
			</releases>
			<snapshots>
				<enabled>true</enabled>
			</snapshots>
			<layout>default</layout>
		</repository>

		<repository>
			<id>spring-libs-snapshot</id>
			<url>http://repo.spring.io/libs-snapshot</url>
			<snapshots>
				<enabled>true</enabled>
			</snapshots>
		</repository>

		<repository>
			<id>Akka repository</id>
			<url>http://repo.akka.io/releases</url>
		</repository>
		<repository>
			<id>scala-tools</id>
			<url>https://oss.sonatype.org/content/groups/scala-tools</url>
		</repository>
		<repository>
			<id>apache</id>
			<url>https://repository.apache.org/content/repositories/releases</url>
		</repository>
		<repository>
			<id>twitter</id>
			<url>http://maven.twttr.com/</url>
		</repository>
		<repository>
			<id>central2</id>
			<url>http://central.maven.org/maven2/</url>
		</repository>
		<repository>
			<id>central</id>
			<name>Maven Repository Switchboard</name>
			<layout>default</layout>
			<url>http://repo2.maven.org/maven2</url>
			<snapshots>
				<enabled>false</enabled>
			</snapshots>
		</repository>
	</repositories>

	<properties>
		<project.build.sourceEncoding>UTF-8</project.build.sourceEncoding>
		<spark.version>1.6.3</spark.version>
		<scala.version>2.10</scala.version>
		<hadoop.version>2.6.0</hadoop.version>
	</properties>

	<dependencies>
		<dependency>
			<groupId>org.apache.spark</groupId>
			<artifactId>spark-core_2.10</artifactId>
			<version>1.6.3</version>
		</dependency>
	</dependencies>

	<build>
		<sourceDirectory>src/main</sourceDirectory>
			<resources>
				<resource>
					<filtering>true</filtering>
					<directory>src/main/java</directory>
					<includes>
						<include>*.*</include>
					</includes>
				</resource>
				<resource>
					<filtering>true</filtering>
					<directory>src/main/scala</directory>
					<includes>
						<include>*.*</include>
					</includes>
				</resource>
			</resources>
		<plugins>
			<plugin>
				<!-- 这是个编译java代码的 -->
				<groupId>org.apache.maven.plugins</groupId>
				<artifactId>maven-compiler-plugin</artifactId>
				<version>3.2</version>
				<configuration>
					<source>1.7</source>
					<target>1.7</target>
					<encoding>UTF-8</encoding>
				</configuration>
				<executions>
					<execution>
						<phase>compile</phase>
						<goals>
							<goal>compile</goal>
						</goals>
					</execution>
				</executions>
			</plugin>
			<plugin>
				<!-- 这是个编译scala代码的 -->
				<groupId>net.alchim31.maven</groupId>
				<artifactId>scala-maven-plugin</artifactId>
				<version>3.2.1</version>
				<executions>
					<execution>
						<id>scala-compile-first</id>
						<phase>process-resources</phase>
						<goals>
							<goal>add-source</goal>
							<goal>compile</goal>
						</goals>
					</execution>
				</executions>
			</plugin>

			<!--
			<plugin>
				<groupId>org.apache.maven.plugins</groupId>
				<artifactId>maven-shade-plugin</artifactId>
				<version>3.0.0</version>
				<configuration>
				</configuration>
				<executions>
					<execution>
						<phase>package</phase>
						<goals>
							<goal>shade</goal>
						</goals>
					</execution>
				</executions>
			</plugin>
			-->
			<plugin>
				<groupId>org.apache.maven.plugins</groupId>
				<artifactId>maven-shade-plugin</artifactId>
				<version>1.4</version>
				<executions>
					<execution>
						<phase>package</phase>
						<goals>
							<goal>shade</goal>
						</goals>
						<configuration>
							<filters>
								<filter>
									<artifact>*:*</artifact>
									<excludes>
										<exclude>META-INF/*.SF</exclude>
										<exclude>META-INF/*.DSA</exclude>
										<exclude>META-INF/*.RSA</exclude>
									</excludes>
								</filter>
							</filters>
							<transformers>
								<transformer
										implementation="org.apache.maven.plugins.shade.resource.ManifestResourceTransformer">
									<mainClass>com.oreilly.learningsparkexamples.mini.scala.WordCount</mainClass>
								</transformer>
								<!--
								<transformer
										implementation="org.apache.maven.plugins.shade.resource.AppendingTransformer">
									<resource>META-INF/spring.handlers</resource>
								</transformer>
								<transformer
										implementation="org.apache.maven.plugins.shade.resource.AppendingTransformer">
									<resource>META-INF/spring.schemas</resource>
								</transformer>
								-->
							</transformers>
						</configuration>
					</execution>
				</executions>
			</plugin>

		</plugins>
	</build>
</project>
在该工程的根目录下执行
5.向spark 提交任务与执行
演示程序是通过map-reduce的方式统计文本中的word数量,为此先用一个数据生产程序生成包含若干数据行的若干文件(本例中产生100个文件每个文件1000000。以目前spark的计算能力,测试集完全可以更大,考虑是单机伪集群,这个测试集合只作为展示,不考察其实际计算能力)。文件集合在本地,需要上传到hadoop-hdfs中,在hadoop-hdfs中构建如下目录:
hdfs dfs -mkdir -p /user/hadoop/data #构建hdfs内部文件目录
hdfs dfs -mkdir -p /user/spark#spark相关的路径spart-history-server 中eventLog.dir配置该目录的applicationHistory中
将learning-spark-mini-example-0.0.1.jar拷贝到服务器,通过spark-submit命令提交任务:
./bin/spark-submit \
  --class <main-class> \
  --master <master-url> \
  --deploy-mode <deploy-mode> \
  --conf <key>=<value> \
  ... # other options
  <application-jar> \
[application-arguments]spark-submit --class com.oreilly.learningsparkexamples.mini.scala.WordCount --master spark://cdh1:7077 /user/spark/learning-spark-mini-example-0.0.1.jar hdfs://cdh1:8020/user/hadoop/data/sample_age_data1*.txt /user/spark/stat_rs.txt--master spark://cdh1:7077 /user/spark/learning-spark-mini-example-0.0.1.jar hdfs://cdh1:8020/user/hadoop/data/sample_age_data1*.txt /user/spark/stat_rs.txt执行截图(没有异常抛出,执行成功)

stat_rs.txt文件输出结果

spark监控页面的历史任务提交记录(spark-history-server的配置是有效的,能记录到历史的任务提交记录)

6.参考文章
9. https://www.zybuluo.com/sasaki/note/242142
12.http://dataunion.org/10345.html
更多推荐


 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)